
Transformers documentation
النص إلى كلام
النص إلى كلام
تحويل النص إلى كلام (TTS) هو مهمة إنشاء كلام طبيعي السماع من النص، حيث يمكن توليد الكلام بعدة لغات ولعدة متحدثين. تتوفر حاليًا عدة نماذج لتحويل النص إلى كلام في 🤗 Transformers، مثل Dia وCSM وBark وMMS وVITS وSpeechT5.
يمكنك بسهولة توليد الصوت باستخدام خط أنابيب "text-to-audio" (أو الاسم المستعار له - "text-to-speech").
فيما يلي مثال على كيفية استخدام خط أنابيب "text-to-speech" مع CSM:
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-audio", model="sesame/csm-1b")
>>> output = pipe("Hello from Sesame.")
إليك مقتطف كود يمكنك استخدامه للاستماع إلى الصوت الناتج في دفتر ملاحظات:
>>> from IPython.display import Audio
>>> Audio(output["audio"], rate=output["sampling_rate"])
يستخدم CSM صوتاً عشوائياً افتراضياً. يمكنك تنفيذ استنساخ الصوت من خلال توفير ملف صوتي مرجعي كجزء من قاموس قالب المحادثة:
>>> import soundfile as sf
>>> import torch
>>> from datasets import Audio, load_dataset
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-audio", model="sesame/csm-1b")

>>> ds = load_dataset("hf-internal-testing/dailytalk-dummy", split="train")
>>> ds = ds.cast_column("audio", Audio(sampling_rate=24000))
>>> conversation = [
...     {
...         "role": "0",
...         "content": [
...             {"type": "text", "text": "What are you working on?"},
...             {"type": "audio", "path": ds[0]["audio"]["array"]},
...         ],
...     },
...     {"role": "0", "content": [{"type": "text", "text": "How much money can you spend?"}]},
... ]
>>> output = pipe(conversation)
يمكن لبعض النماذج، مثل Dia، أن تُشترط أيضاً لتوليد اتصالات غير لفظية مثل الضحك والزفير والبكاء، أو حتى إضافة موسيقى. فيما يلي مثال على ذلك:
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-speech", model="nari-labs/Dia-1.6B-0626")
>>> text = "[S1] (clears throat) Hello! How are you? [S2] I'm good, thanks! How about you?"
>>> output = pipe(text)
لاحظ أن Dia يقبل أيضًا وسوم المتكلمين مثل [S1] و [S2] لتوليد محادثة بين أصوات فريدة.
لمزيد من الأمثلة على ما يمكن أن تفعله نماذج CSM ونماذج TTS المُسبقة التدريب الأخرى، يُرجى الرجوع إلى دورة الصوت.
إذا كنتَ تبحث عن ضبط نموذج TTS، فإن نماذج تحويل النص إلى كلام المتاحة حاليًا في 🤗 Transformers هي SpeechT5 وFastSpeech2Conformer وDia وCSM، مع العلم أنه سيتم إضافة المزيد في المستقبل. تم تدريب SpeechT5 مسبقًا على مزيج من بيانات تحويل الكلام إلى نص وبيانات تحويل النص إلى كلام، مما يتيح له تعلم مساحة موحدة من التمثيلات الخفية المشتركة بين النص والكلام. وهذا يعني أن نفس النموذج المدرَّب مسبقًا يمكن ضبطه لمهام مختلفة. علاوة على ذلك، يدعم SpeechT5 متحدثين متعددين من خلال تضمينات المتحدث x-vector.
يوضح بقية هذا الدليل كيفية:
- قُم بتدريب SpeechT5، الذي تم تدريبه في الأصل على الكلام باللغة الإنجليزية، على مجموعة اللغة الهولندية (
nl) من مجموعة بيانات VoxPopuli. - استخدم النموذج المُحسَّن لديك للاستدلال بأحد طريقتين: باستخدام خط أنابيب أو بشكل مباشر.
قبل أن تبدأ، تأكد من تثبيت جميع المكتبات اللازمة:
pip install transformers datasets soundfile librosa torchcodec speechbrain accelerate
قم بتثبيت 🤗Transformers من المصدر، إذ لم يتم دمج جميع ميزات SpeechT5 في إصدار رسمي بعد:
pip install git+https://github.com/huggingface/transformers.git
للتقدم في هذا الدليل، ستحتاج إلى وحدة معالجة رسومية (GPU). إذا كنت تعمل في دفتر ملاحظات (notebook)، فنفّذ السطر التالي للتحقق من توفر وحدة معالجة رسومية:
!nvidia-smiأو بديلًا لذلك، لبطاقات الرسوميات من AMD:
!rocm-smi
ننصحك بتسجيل الدخول إلى حسابك على Hugging Face لرفع نموذجك ومشاركته مع المجتمع. عند الطلب، أدخل رمزك (token) لتسجيل الدخول:
>>> from huggingface_hub import notebook_login

>>> notebook_login()
تحميل مجموعة البيانات
VoxPopuli هو مجموعة بيانات صوتية متعددة اللغات واسعة النطاق تتكون من بيانات مستمدة من تسجيلات أحداث البرلمان الأوروبي بين عامي 2009 و2020. يحتوي على بيانات صوتية-نصية موسومة لـ 15 لغة أوروبية. في هذا الدليل، نستخدم مجموعة البيانات الفرعية للغة الهولندية، ويمكنك اختيار مجموعة فرعية أخرى إذا رغبت.
يُرجى ملاحظة أن VoxPopuli أو أي مجموعة بيانات أخرى للتعرف التلقائي على الكلام (ASR) قد لا تكون الخيار الأنسب لتدريب نماذج TTS. فمزايا تجعلها مفيدة في ASR، مثل الضوضاء الخلفية المفرطة، تكون عادةً غير مرغوبة في TTS. ومع ذلك، قد يكون العثور على مجموعات بيانات TTS عالية الجودة، متعددة اللغات، ومتعددة المتحدثين تحديًا كبيرًا.
لنقم بتحميل البيانات:
>>> from datasets import load_dataset, Audio

>>> dataset = load_dataset("qmeeus/voxpopuli", "nl", split="train")
>>> len(dataset)
20968
20968 مثالًا يجب أن يكون كافيًا للضبط الدقيق. يتوقع نموذج SpeechT5 أن تكون بيانات الصوت بمعدل أخذ عينات قدره 16 kHz، لذا تأكد من أن الأمثلة في مجموعة البيانات تلبي هذا المتطلب:
dataset = dataset.cast_column("audio", Audio(sampling_rate=16000))معالجة البيانات مسبقًا
لنبدأ بتعريف نقطة التفتيش للنموذج التي سنستخدمها وتحميل المعالج المناسب:
>>> from transformers import SpeechT5Processor

>>> checkpoint = "microsoft/speecht5_tts"
>>> processor = SpeechT5Processor.from_pretrained(checkpoint)
تنظيف النص لتجزئة SpeechT5
ابدأ بتنظيف بيانات النص. ستحتاج إلى جزء المُرمِّز (tokenizer) من المُعالِج (processor) لمعالجة النص:
>>> tokenizer = processor.tokenizerتحتوي أمثلة مجموعة البيانات على ميزة text تحتوي على النص المنقول. لاحظ أن مُجزِّع SpeechT5 لا يحتوي على أي رموز للأرقام، لذا سيتم تحويل أي أرقام في النص إلى رموز <unk>. إذا كانت مجموعة بياناتك تحتوي على أرقام، ففكّر في تطبيعها إلى صيغتها المكتوبة.
بما أن SpeechT5 تم تدريبه على اللغة الإنجليزية، فقد لا يتعرف على بعض الأحرف في مجموعة البيانات الهولندية. إذا تُركت هذه الأحرف كما هي، فسيتم تحويلها إلى رموز <unk>. ومع ذلك، في اللغة الهولندية، تُستخدم أحرف معينة مثل à لتأكيد المقاطع. ولحفظ معنى النص، يمكننا استبدال هذا الحرف بالحرف العادي a.
لتحديد الرموز غير المدعومة، استخرج جميع الأحرف الفريدة في مجموعة البيانات باستخدام SpeechT5Tokenizer الذي
يعمل مع الأحرف كرموز. للقيام بذلك، اكتب دالة التحويل extract_all_chars التي تدمج
النصوص المنقولة من جميع الأمثلة في سلسلة واحدة وتحوّلها إلى مجموعة من الأحرف.
تأكد من تعيين batched=True وbatch_size=-1 في dataset.map() بحيث تكون جميع النصوص المنقولة متاحة دفعة واحدة لدالة
التحويل.
>>> def extract_all_chars(batch):
...     all_text = " ".join(batch["text"])
...     vocab = list(set(all_text))
...     return {"vocab": [vocab], "all_text": [all_text]}


>>> vocabs = dataset.map(
...     extract_all_chars,
...     batched=True,
...     batch_size=-1,
...     keep_in_memory=True,
...     remove_columns=dataset.column_names,
... )

>>> dataset_vocab = set(vocabs["vocab"][0])
>>> tokenizer_vocab = {k for k, _ in tokenizer.get_vocab().items()}
الآن لديك مجموعتان من الأحرف: واحدة تحتوي على مفردات مجموعة البيانات، والأخرى تحتوي على مفردات المُجزّئ. لتحديد أي أحرف غير مدعومة في مجموعة البيانات، يمكنك أخذ الفرق بين هاتين المجموعتين. ستحتوي المجموعة الناتجة على الأحرف الموجودة في مجموعة البيانات ولكن ليس في المُجزّئ.
>>> dataset_vocab - tokenizer_vocab
{' ', 'à', 'ç', 'è', 'ë', 'í', 'ï', 'ö', 'ü'}
لمعالجة الأحرف غير المدعومة التي تم تحديدها في الخطوة السابقة، عرّف دالة تُخضع هذه الأحرف إلى رموز صالحة. لاحظ أن المسافات تم استبدالها بالفعل بـ ▁ في مُجزّئ النص، ولا حاجة إلى معالجتها بشكل منفصل.
>>> replacements = [
...     ("à", "a"),
...     ("ç", "c"),
...     ("è", "e"),
...     ("ë", "e"),
...     ("í", "i"),
...     ("ï", "i"),
...     ("ö", "o"),
...     ("ü", "u"),
... ]


>>> def cleanup_text(inputs):
...     for src, dst in replacements:
...         inputs["text"] = inputs["text"].replace(src, dst)
...     return inputs


>>> dataset = dataset.map(cleanup_text)
الآن، بعد أن تعاملت مع الأحرف الخاصة في النص، حان الوقت لتحويل التركيز إلى بيانات الصوت.
المتحدثون
يتضمّن مجموعة بيانات VoxPopuli تسجيلات صوتية من متحدثين متعددين، لكن كم عدد المتحدثين الممثلين في هذه المجموعة؟ لتحديد ذلك، يمكننا عدّ عدد المتحدثين الفريدين وعدد الأمثلة التي يساهم بها كل متحدث في مجموعة البيانات. وبما أن إجمالي عدد الأمثلة في مجموعة البيانات يبلغ 20,968، فإن هذه المعلومات ستمنحنا فهماً أفضل لتوزيع المتحدثين والأمثلة في البيانات.
>>> from collections import defaultdict

>>> speaker_counts = defaultdict(int)

>>> for speaker_id in dataset["speaker_id"]:
...     speaker_counts[speaker_id] += 1
من خلال رسم مخطط تواتر، يمكنك الحصول على فكرة عن كمية البيانات المتاحة لكل متحدث.
>>> import matplotlib.pyplot as plt

>>> plt.figure()
>>> plt.hist(speaker_counts.values(), bins=20)
>>> plt.ylabel("Speakers")
>>> plt.xlabel("Examples")
>>> plt.show()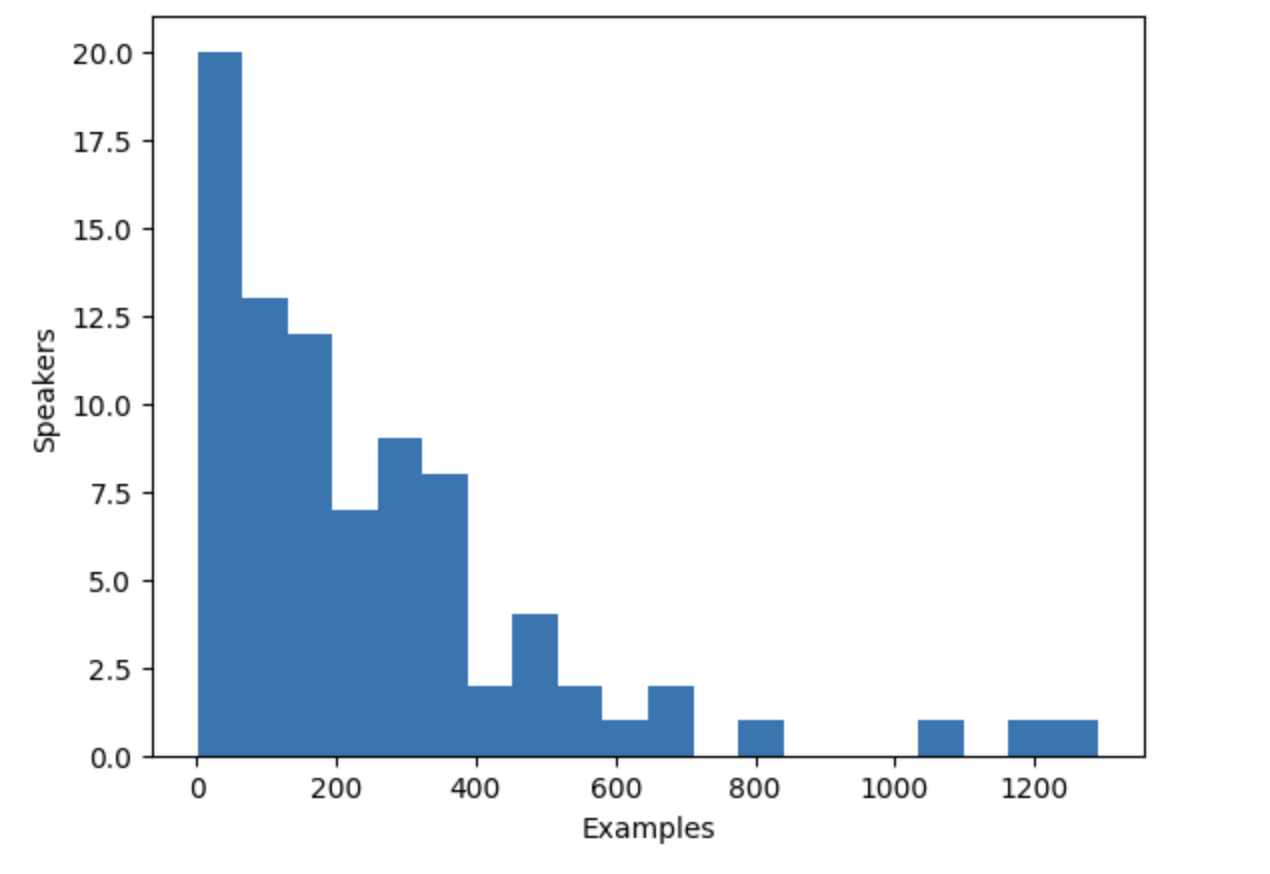
يكشف المخطط التكراري أن ثلث المتحدّثين تقريبًا في مجموعة البيانات لديهم أقل من 100 أمثلة، بينما يمتلك حوالي عشرة متحدثين أكثر من 500 مثال. لتحسين كفاءة التدريب وتوازن مجموعة البيانات، يمكننا تقييد البيانات بالمتحدثين الذين لديهم ما بين 100 و400 مثال.
>>> def select_speaker(speaker_id):
...     return 100 <= speaker_counts[speaker_id] <= 400


>>> dataset = dataset.filter(select_speaker, input_columns=["speaker_id"])
لنتحقق من عدد المتحدّثين المتبقّين:
>>> len(set(dataset["speaker_id"]))
42
لنرَ كم من الأمثلة المتبقية:
>>> len(dataset)
9973
تبقى لديك أقل بقليل من 10,000 مثال من حوالي 40 متحدثًا فريدًا، وهو ما ينبغي أن يكون كافيًا.
لاحظ أن بعض المتحدّثين الذين لديهم أمثلة قليلة قد يكون لديهم في الواقع المزيد من الصوت المتاح إذا كانت الأمثلة طويلة. ومع ذلك، فإن تحديد إجمالي كمية الصوت لكل متحدث يتطلب مسح مجموعة البيانات بأكملها، وهو عملية تستغرق وقتاً طويلاً تتضمن تحميل وفك ترميز كل ملف صوتي. لذلك، اخترنا تخطي هذه الخطوة هنا.
تضمينات المتحدث
لتتمكن نموذج TTS من التمييز بين عدة متحدثين، ستحتاج إلى إنشاء تضمين (embedding) للمتحدث لكل مثال. يُعد تضمين المتحدث مدخلاً إضافياً إلى النموذج يلتقط خصائص صوت المتحدث المعني. ولتوليد هذه التضمينات الخاصة بالمتحدثين، استخدم النموذج المُدرَّب مسبقاً spkrec-xvect-voxceleb من SpeechBrain.
أنشئ دالة create_speaker_embedding() تستقبل موجة صوتية مدخلة وتُخرج متجهًا مكونًا من 512 عنصرًا يحتوي على تضمين المتحدِّث المقابل.
>>> import os
>>> import torch
>>> from speechbrain.inference.classifiers import EncoderClassifier
>>> from accelerate import Accelerator

>>> spk_model_name = "speechbrain/spkrec-xvect-voxceleb"
>>> device = Accelerator().device
>>> speaker_model = EncoderClassifier.from_hparams(
...     source=spk_model_name,
...     run_opts={"device": device},
...     savedir=os.path.join("/tmp", spk_model_name),
... )


>>> def create_speaker_embedding(waveform):
...     with torch.no_grad():
...         speaker_embeddings = speaker_model.encode_batch(torch.tensor(waveform))
...         speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2)
...         speaker_embeddings = speaker_embeddings.squeeze().cpu().numpy()
...     return speaker_embeddings
من المهم الإشارة إلى أن نموذج speechbrain/spkrec-xvect-voxceleb تم تدريبه على الكلام الإنجليزي من مجموعة بيانات VoxCeleb، في حين أن أمثلة التدريب في هذا الدليل باللغة الهولندية. وعلى الرغم من أننا نعتقد أن هذا النموذج سيظل يولّد تمثيلات متحدثين معقولة لمجموعة البيانات الهولندية لدينا، إلا أن هذا الافتراض قد لا يكون صحيحاً في جميع الحالات.
للحصول على أفضل النتائج، نوصي بتدريب نموذج X-vector على الكلام المستهدف أولاً. سيضمن ذلك أن يكون النموذج أكثر قدرة على التقاط خصائص الصوت الفريدة الموجودة في اللغة الهولندية.
معالجة مجموعة البيانات
أخيراً، لنعالج البيانات إلى الصيغة التي يتوقعها النموذج. أنشئ دالة prepare_dataset تستقبل مثالاً واحداً وتستخدم كائن SpeechT5Processor لتجزئة النص المدخل وتحميل الصوت المستهدف في طيف لوج-ميل. كما يجب أن تضيف تضمينات المتحدث كمدخل إضافي.
>>> def prepare_dataset(example):
...     audio = example["audio"]

...     example = processor(
...         text=example["text"],
...         audio_target=audio["array"],
...         sampling_rate=audio["sampling_rate"],
...         return_attention_mask=False,
...     )

...     # strip off the batch dimension
...     example["labels"] = example["labels"][0]

...     # use SpeechBrain to obtain x-vector
...     example["speaker_embeddings"] = create_speaker_embedding(audio["array"])

...     return example
تحقق من صحة المعالجة بالنظر إلى مثال واحد:
>>> processed_example = prepare_dataset(dataset[0])
>>> list(processed_example.keys())
['input_ids', 'labels', 'stop_labels', 'speaker_embeddings']
يجب أن تكون تمثيلات المتحدث (Speaker embeddings) متجهًا مكونًا من 512 عنصرًا:
>>> processed_example["speaker_embeddings"].shape
(512,)
يجب أن تكون التسميات عبارة عن طيف لوجاريتمي-ميل (log-mel spectrogram) يحتوي على 80 من دلاء الميل (mel bins).
>>> import matplotlib.pyplot as plt

>>> plt.figure()
>>> plt.imshow(processed_example["labels"].T)
>>> plt.show()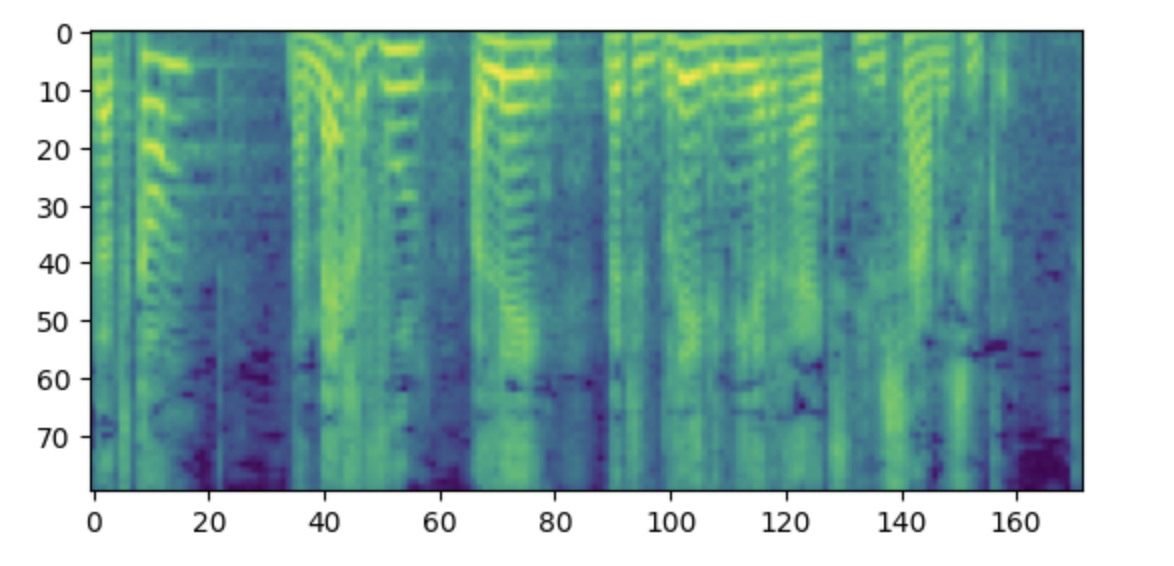
ملاحظة جانبية: إذا وجدت أن هذا الطيف الصوتي مربك، فقد يكون ذلك بسبب اعتيادك على وضع الترددات المنخفضة في الأسفل والترددات العالية في أعلى الرسم البياني. ومع ذلك، عند رسم الأطياف الصوتية على شكل صورة باستخدام مكتبة matplotlib، يتم عكس محور الصادات (y-axis) فتظهر الأطياف الصوتية مقلوبة رأساً على عقب.
الآن، طبّق دالة المعالجة على مجموعة البيانات بأكملها. سيستغرق هذا ما بين 5 و10 دقائق.
>>> dataset = dataset.map(prepare_dataset, remove_columns=dataset.column_names)ستظهر لك تحذير يشير إلى أن بعض الأمثلة في مجموعة البيانات أطول من الحد الأقصى لطول الإدخال الذي يمكن للنموذج التعامل معه (600 رمز). احذف تلك الأمثلة من مجموعة البيانات. هنا نذهب أبعد من ذلك، ولتسمح بحجم دفعات أكبر، نحذف أي شيء يتجاوز 200 رمز.
>>> def is_not_too_long(input_ids):
...     input_length = len(input_ids)
...     return input_length < 200


>>> dataset = dataset.filter(is_not_too_long, input_columns=["input_ids"])
>>> len(dataset)
8259
بعد ذلك، أنشئ تقسيمًا أساسيًا للتدريب/الاختبار:
>>> dataset = dataset.train_test_split(test_size=0.1)منسّق البيانات
لدمج أمثلة متعددة في دفعة واحدة، يجب عليك تحديد مُجمِّع بيانات مخصص. سيقوم هذا المُجمِّع بتعبئة التسلسلات الأقصر برموز تعبئة، مما يضمن أن جميع الأمثلة لها نفس الطول. بالنسبة لتسميات الطيف الصوتي، تُستبدل الأجزاء المعبأة بالقيمة الخاصة -100. تُوجِّه هذه القيمة الخاصة النموذج إلى تجاهل ذلك الجزء من الطيف الصوتي عند حساب خسارة الطيف الصوتي.
>>> from dataclasses import dataclass
>>> from typing import Any, Dict, List, Union


>>> @dataclass
... class TTSDataCollatorWithPadding:
...     processor: Any

...     def __call__(self, features: list[dict[str, Union[list[int], torch.Tensor]]]) -> dict[str, torch.Tensor]:
...         input_ids = [{"input_ids": feature["input_ids"]} for feature in features]
...         label_features = [{"input_values": feature["labels"]} for feature in features]
...         speaker_features = [feature["speaker_embeddings"] for feature in features]

...         # collate the inputs and targets into a batch
...         batch = processor.pad(input_ids=input_ids, labels=label_features, return_tensors="pt")

...         # replace padding with -100 to ignore loss correctly
...         batch["labels"] = batch["labels"].masked_fill(batch.decoder_attention_mask.unsqueeze(-1).ne(1), -100)

...         # not used during fine-tuning
...         del batch["decoder_attention_mask"]

...         # round down target lengths to multiple of reduction factor
...         if model.config.reduction_factor > 1:
...             target_lengths = torch.tensor([len(feature["input_values"]) for feature in label_features])
...             target_lengths = target_lengths.new(
...                 [length - length % model.config.reduction_factor for length in target_lengths]
...             )
...             max_length = max(target_lengths)
...             batch["labels"] = batch["labels"][:, :max_length]

...         # also add in the speaker embeddings
...         batch["speaker_embeddings"] = torch.tensor(speaker_features)

...         return batch
في SpeechT5، يُقلَّل مدخل الجزء الخاص بالمفكك (decoder) في النموذج بمعامل 2. بمعنى آخر، يتخلّى عن كل خطوة زمنية ثانية من التسلسل المستهدف. ثم يتنبأ المفكك بتسلسل يكون طوله ضعف الطول الأصلي. وبما أن طول التسلسل المستهدف الأصلي قد يكون فرديًا، يحرص مُجمِّع البيانات (data collator) على تقريب الطول الأقصى للدفعة (batch) إلى الأسفل ليكون مضاعفًا للعدد 2.
>>> data_collator = TTSDataCollatorWithPadding(processor=processor)تدريب النموذج
حمّل النموذج المُدرَّب مسبقًا من نفس نقطة الفحص التي استخدمتها لتحميل المعالج:
>>> from transformers import SpeechT5ForTextToSpeech

>>> model = SpeechT5ForTextToSpeech.from_pretrained(checkpoint)
خيار use_cache=True غير متوافق مع نقطة التفتيش للتدرج. قم بتعطيله للتدريب.
>>> model.config.use_cache = Falseحدّد حُجج التدريب. هنا لا نحسب أي مقاييس تقييم أثناء عملية التدريب. بدلاً من ذلك، سنكتفي بمراقبة loss:
>>> from transformers import Seq2SeqTrainingArguments

>>> training_args = Seq2SeqTrainingArguments(
...     output_dir="speecht5_finetuned_voxpopuli_nl",  # change to a repo name of your choice
...     per_device_train_batch_size=4,
...     gradient_accumulation_steps=8,
...     learning_rate=1e-5,
...     warmup_steps=500,
...     max_steps=4000,
...     gradient_checkpointing=True,
...     fp16=True,
...     eval_strategy="steps",
...     per_device_eval_batch_size=2,
...     save_steps=1000,
...     eval_steps=1000,
...     logging_steps=25,
...     report_to="trackio",
...     load_best_model_at_end=True,
...     greater_is_better=False,
...     label_names=["labels"],
...     push_to_hub=True,
... )
أنشئ كائن Trainer ومرّر النموذج ومجموعة البيانات وجامع البيانات إليه.
>>> from transformers import Seq2SeqTrainer

>>> trainer = Seq2SeqTrainer(
...     args=training_args,
...     model=model,
...     train_dataset=dataset["train"],
...     eval_dataset=dataset["test"],
...     data_collator=data_collator,
...     processing_class=processor,
... )
وبذلك، تكون مستعداً لبدء التدريب! سيستغرق التدريب عدة ساعات. اعتماداً على وحدة معالجة الرسوميات (GPU) الخاصة بك، من الممكن أن تواجه خطأ CUDA "نفاد الذاكرة" عند بدء التدريب. في هذه الحالة، يمكنك تقليل per_device_train_batch_size تدريجياً بمعامل 2، وزيادة gradient_accumulation_steps بمقدار الضعف لتعويض ذلك.
>>> trainer.train()لتمكينك من استخدام نقطة التفتيش الخاصة بك مع خط أنابيب، تأكد من حفظ المعالج مع نقطة التفتيش:
>>> processor.save_pretrained("YOUR_ACCOUNT_NAME/speecht5_finetuned_voxpopuli_nl")ادفع النموذج النهائي إلى 🤗 Hub:
>>> trainer.push_to_hub()الاستدلال
الاستدلال باستخدام خط أنابيب
ممتاز، والآن بعد أن قمت بضبط نموذج، يمكنك استخدامه للاستدلال!
أولاً، دعنا نرى كيف يمكنك استخدامه مع خط أنابيب (pipeline) مطابق. دعنا ننشئ خط أنابيب "text-to-speech" باستخدام نقطة التفتيش (checkpoint) الخاصة بك:
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-speech", model="YOUR_ACCOUNT_NAME/speecht5_finetuned_voxpopuli_nl")
اختر نصًا باللغة الهولندية ترغب في سرده، على سبيل المثال:
>>> text = "hallo allemaal, ik praat nederlands. groetjes aan iedereen!"للاستخدام مع pipeline، ستحتاج إلى تضمين متحدث. لنجلبه من مثال في مجموعة بيانات الاختبار:
>>> example = dataset["test"][304]
>>> speaker_embeddings = torch.tensor(example["speaker_embeddings"]).unsqueeze(0)
الآن يمكنك تمرير نصوص التضمين (embeddings) والمتحدث إلى خط الأنابيب، وسيتولى هو الباقي:
>>> forward_params = {"speaker_embeddings": speaker_embeddings}
>>> output = pipe(text, forward_params=forward_params)
>>> output
{'audio': array([-6.82714235e-05, -4.26525949e-04,  1.06134125e-04, ...,
        -1.22392643e-03, -7.76011671e-04,  3.29112721e-04], dtype=float32),
 'sampling_rate': 16000}
يمكنك بعد ذلك الاستماع إلى النتيجة:
>>> from IPython.display import Audio
>>> Audio(output['audio'], rate=output['sampling_rate'])
تشغيل الاستدلال يدويًا
يمكنك تحقيق نتائج الاستدلال نفسها دون استخدام خط الأنابيب، ومع ذلك، سيتطلب الأمر خطوات أكثر.
حمّل النموذج من 🤗 Hub:
>>> model = SpeechT5ForTextToSpeech.from_pretrained("YOUR_ACCOUNT/speecht5_finetuned_voxpopuli_nl")اختر مثالًا من مجموعة الاختبار واحصل على تضمين للمتحدث.
>>> example = dataset["test"][304]
>>> speaker_embeddings = torch.tensor(example["speaker_embeddings"]).unsqueeze(0)
حدّد النصّ المُدخل وقسّمه إلى رموز.
>>> text = "hallo allemaal, ik praat nederlands. groetjes aan iedereen!"
>>> inputs = processor(text=text, return_tensors="pt")
أنشئ طيفاً طيفياً (Spectrogram) باستخدام نموذجك:
>>> spectrogram = model.generate_speech(inputs["input_ids"], speaker_embeddings)قم بتصور الطيف الترددي، إن أردت:
>>> plt.figure()
>>> plt.imshow(spectrogram.T)
>>> plt.show()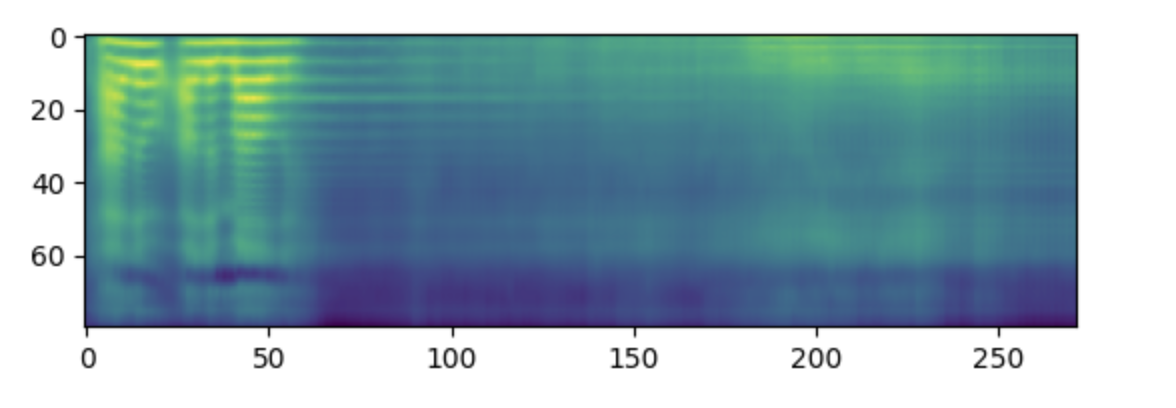
أخيراً، استخدم مُصنِّع الصوت (vocoder) لتحويل الطيف الصوتي إلى صوت.
>>> with torch.no_grad():
...     speech = vocoder(spectrogram)

>>> from IPython.display import Audio

>>> Audio(speech.numpy(), rate=16000)
من واقع تجربتنا، قد يكون الحصول على نتائج مرضية من هذا النموذج أمراً صعباً. يبدو أن جودة تمثيلات المتحدثين (speaker embeddings) عاملاً مهماً. نظراً لأن SpeechT5 تم تدريبه مسبقاً باستخدام متجهات x-vectors باللغة الإنجليزية، فإنه يقدم أفضل أداء عند استخدام تمثيلات متحدثين باللغة الإنجليزية. إذا كانت جودة الكلام المُصنَّع ضعيفة، فحاول استخدام تمثيل متحدث مختلف.
من المرجح أيضاً أن يؤدي زيادة مدة التدريب إلى تحسين جودة النتائج. ومع ذلك، فإن الكلام بوضوح باللغة الهولندية بدلاً من الإنجليزية، كما أنه يلتقط خصائص صوت المتحدث (قارن ذلك بالتسجيل الصوتي الأصلي في المثال).
أمر آخر يمكن تجربته هو إعدادات النموذج. على سبيل المثال، جرّب استخدام config.reduction_factor = 1 لمعرفة ما إذا كان هذا يحسّن النتائج.
أخيراً، من الضروري مراعاة الاعتبارات الأخلاقية. على الرغم من أن تقنية TTS لديها العديد من التطبيقات المفيدة، إلا أنه يمكن أيضاً استخدامها لأغراض خبيثة، مثل انتحال صوت شخص ما دون علمه أو موافقته. يرجى استخدام TTS بحكمة ومسؤولية.
Update on GitHub