
Transformers documentation
GLM-4.5、GLM-4.6、GLM-4.7
このモデルは2025年8月8日にHF papersで公開され、2025年7月21日にHugging Face Transformersに貢献されました。
GLM-4.5、GLM-4.6、GLM-4.7
概要
GLM-4.7、GLM-4.6、GLM-4.5の言語モデルはこのクラスを使用しています。transformersでの実装にはMTPレイヤーは含まれていません。
GLM-4.7
GLM-4.7は、あなたの新しいコーディングパートナーとして、以下の機能とともに登場します。
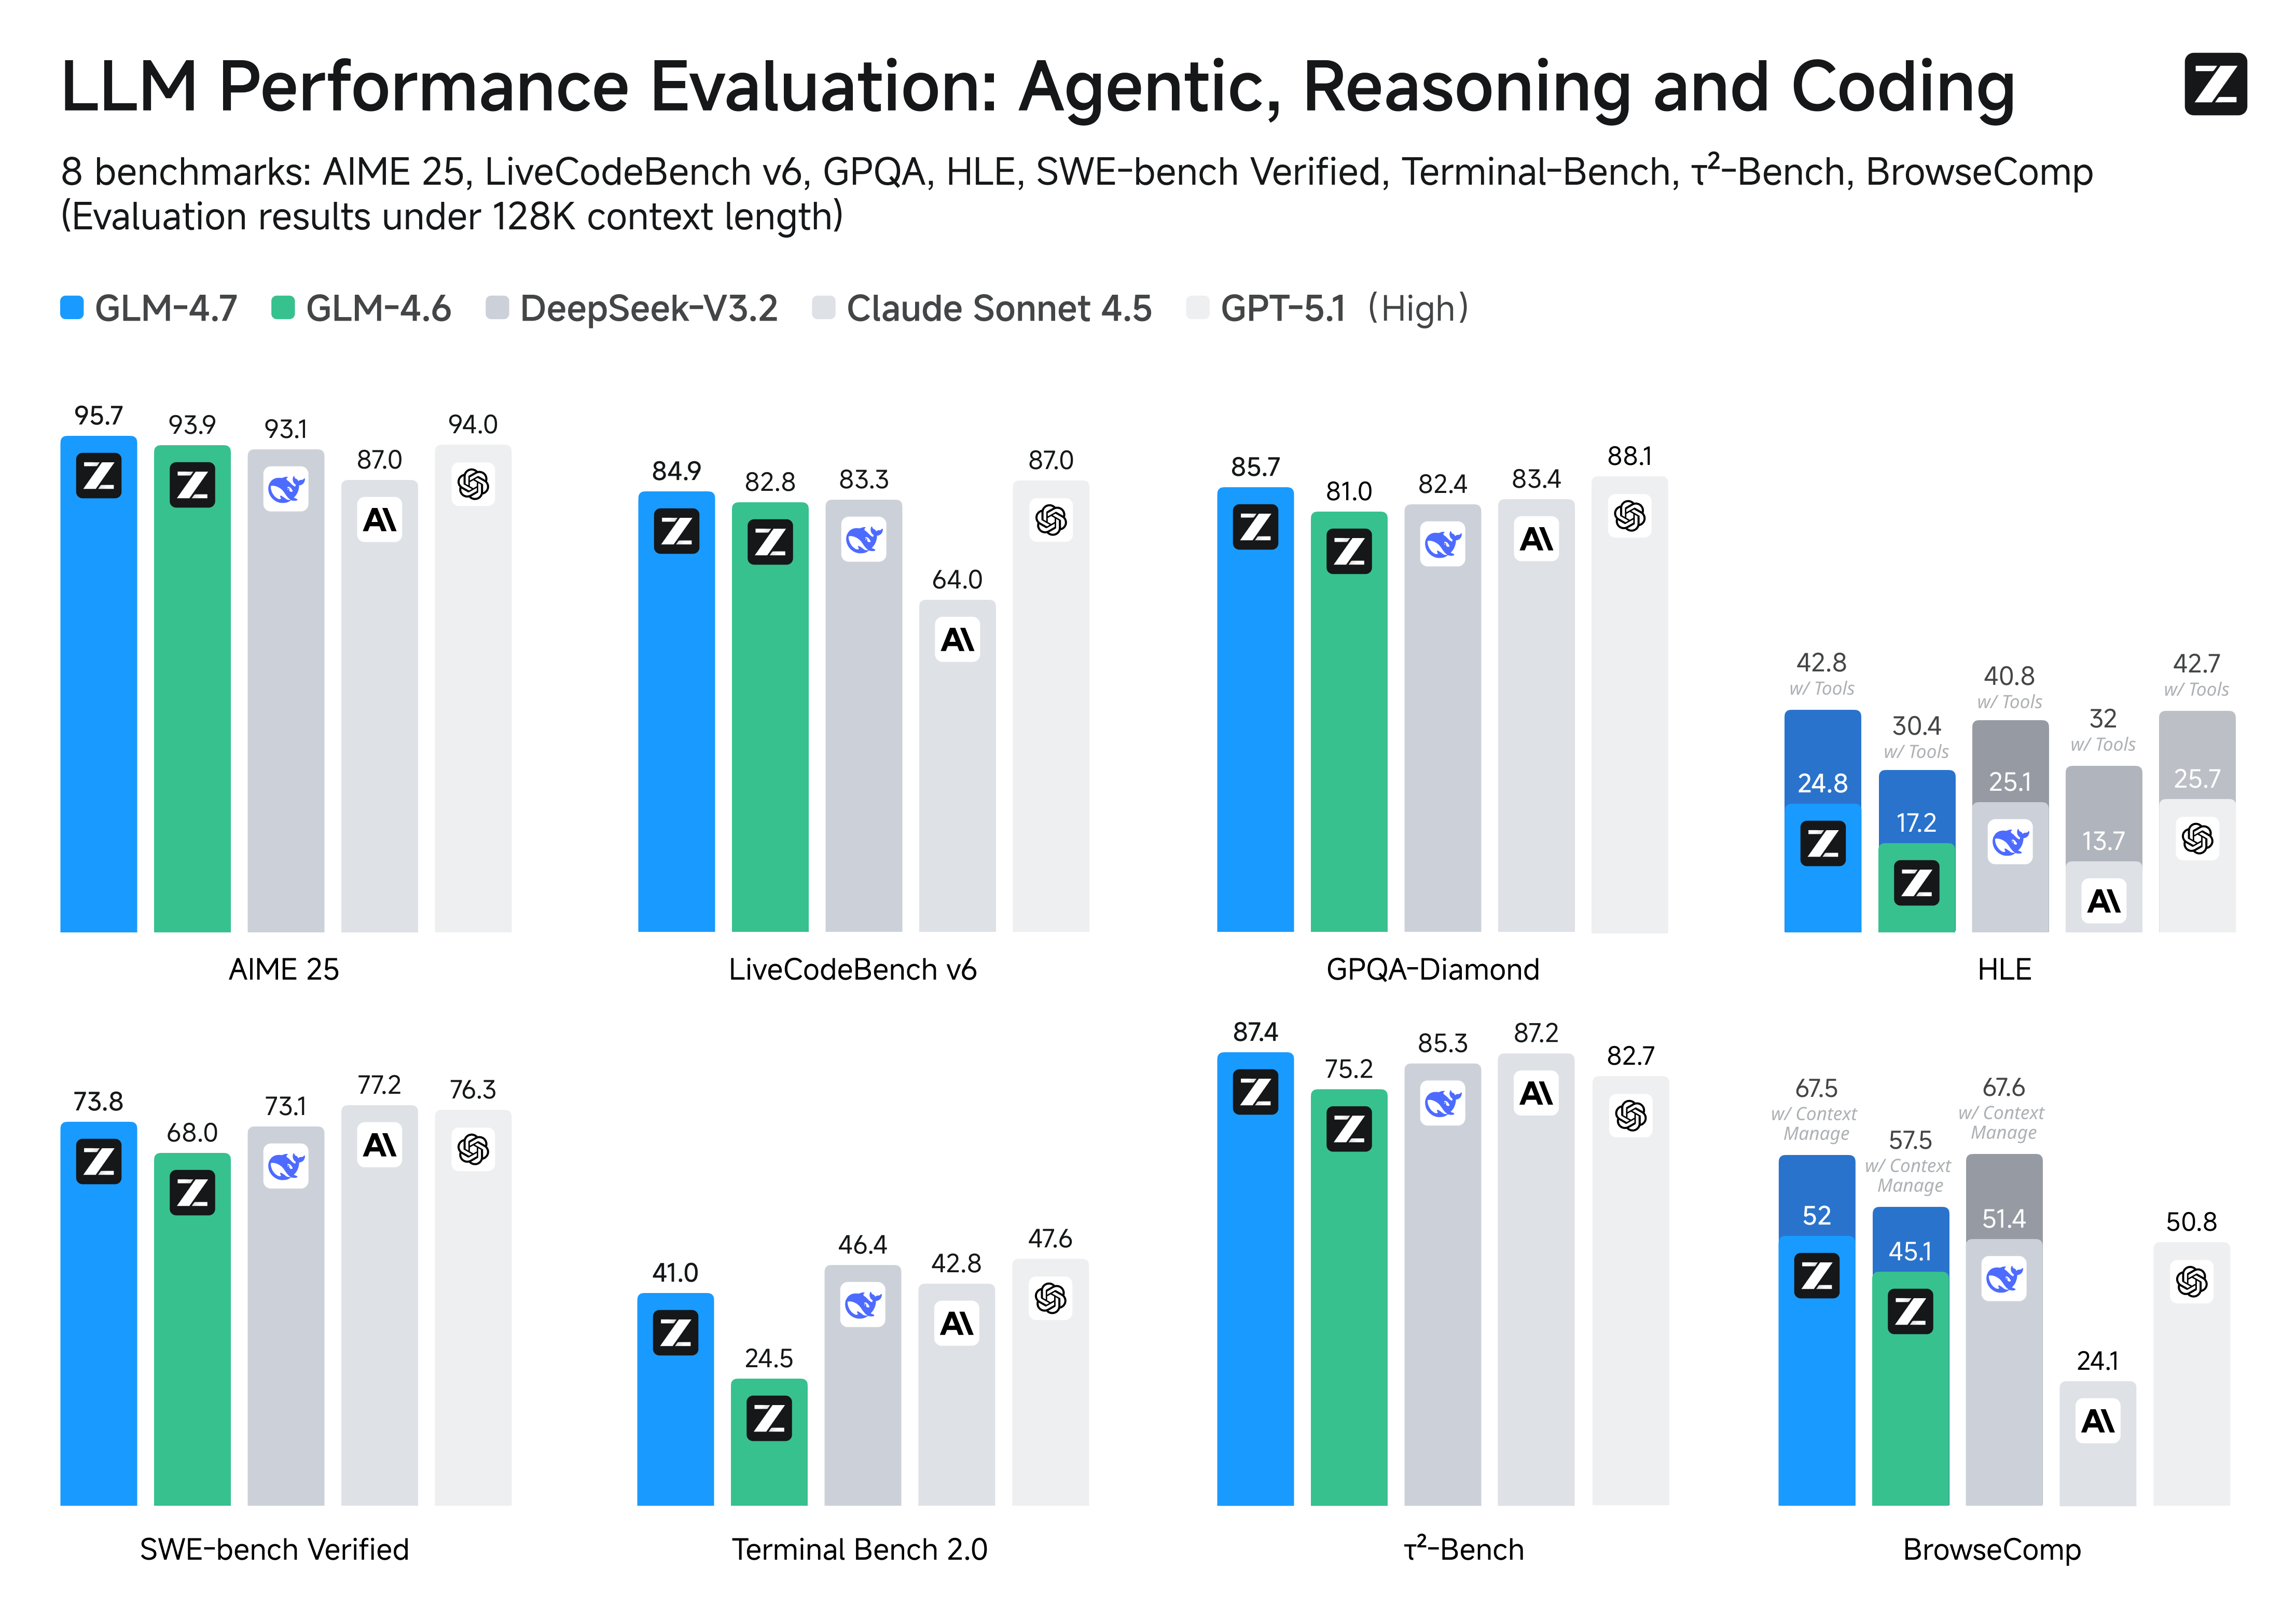
- コアコーディング: GLM-4.7 は、先行モデルである GLM-4.6 と比較して、多言語エージェントコーディングやターミナルベースのタスクにおいて明確な性能向上を実現しました。具体的には、SWE-bench で (73.8%, +5.8%)、SWE-bench Multilingual で (66.7%, +12.9%)、Terminal Bench 2.0 で (41%, +16.5%) を記録しています。また、GLM-4.7 はアクション実行前の思考(thinking before acting)に対応しており、Claude Code、Kilo Code、Cline、Roo Code などの主要なエージェントフレームワークにおける複雑なタスクの性能が大幅に向上しています。
- Vibe Coding: GLM-4.7は、UIの品質向上において大きな一歩を踏み出しました。よりクリーンでモダンなWebページを生成し、レイアウトやサイズがより正確な、見た目が優れたスライドを作成します。
- ツール使用: GLM-4.7 は、ツール使用において大幅な改善を達成しました。τ^2-Bench や、BrowseComp による Web ブラウジングなどのベンチマークにおいて、より優れたパフォーマンスが確認できます。
- 複雑な推論: GLM-4.7は、数学および推論能力を大幅に向上させ、GLM-4.6と比較してHLE(Humanity’s Last Exam)ベンチマークで(42.8%、+12.4%)を達成しました。
より一般的には、チャット、クリエイティブライティング、ロールプレイなどの多くのシナリオにおいても、大幅な改善が見込まれます。
インターリーブ思考と保持された思考
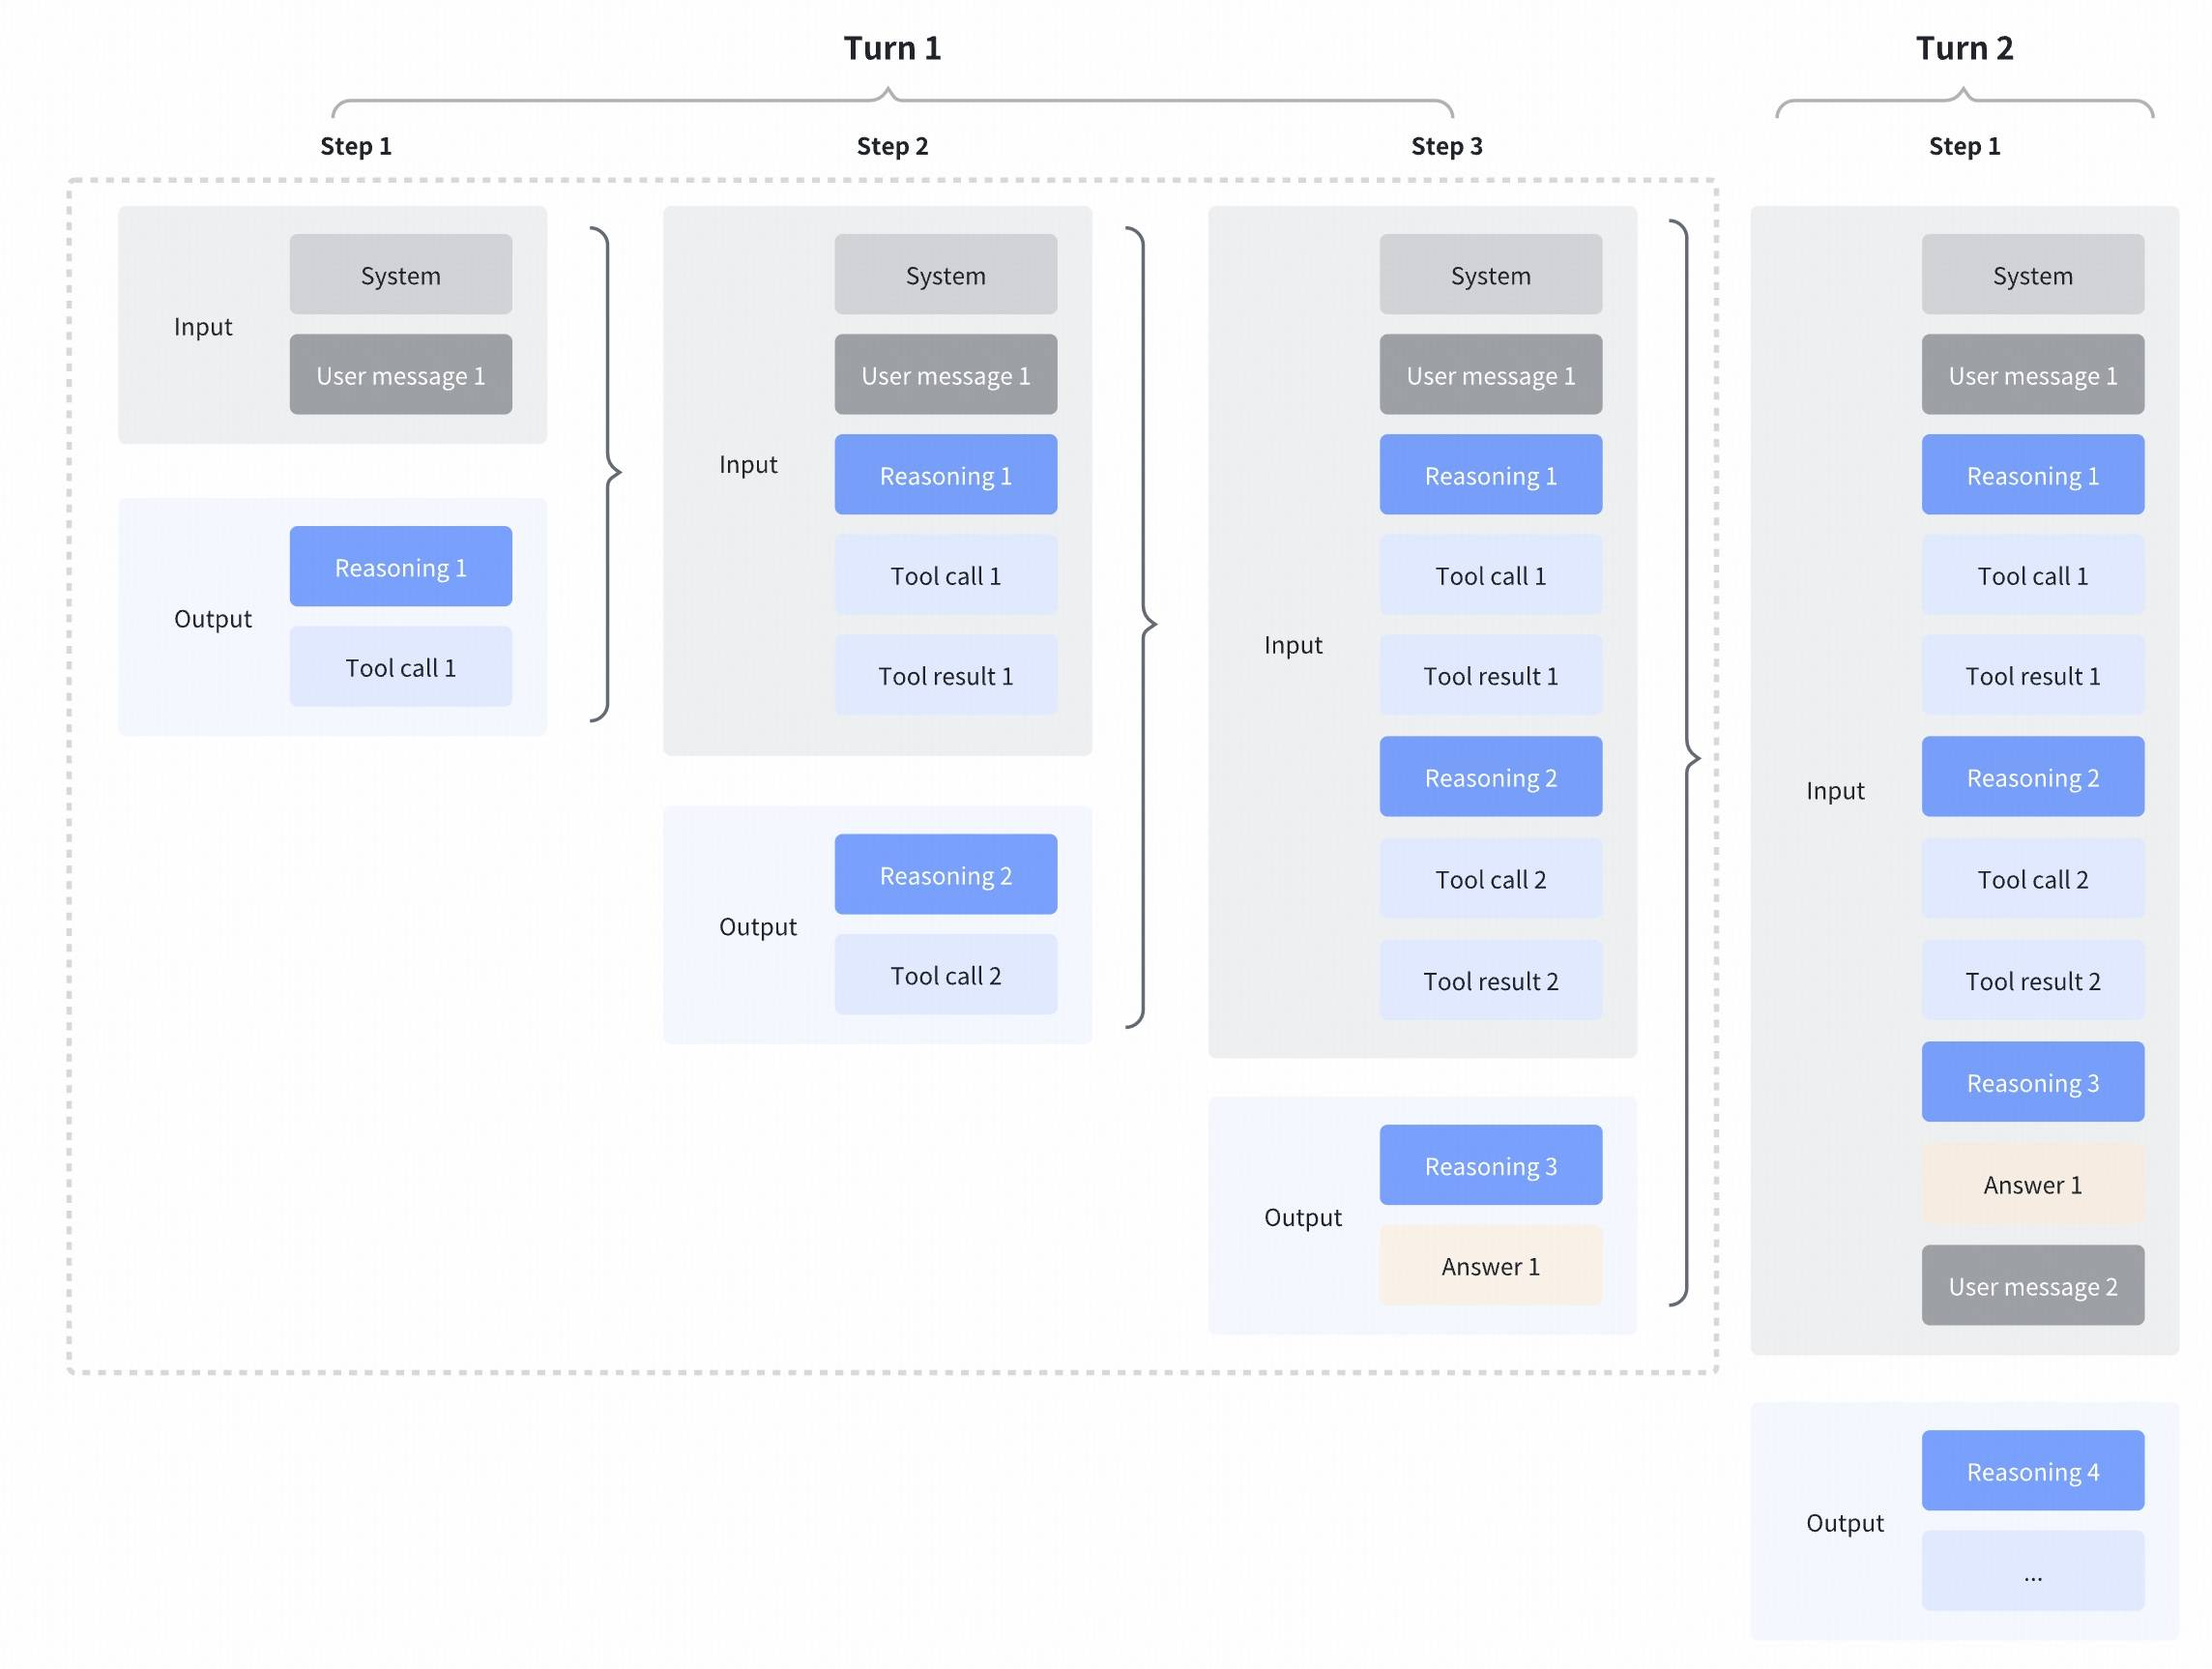
GLM-4.7 は、GLM-4.5 以降に導入された機能である Interleaved Thinking をさらに強化し、Preserved Thinking と Turn-level Thinking を新たに導入しました。アクションの間に思考を行い、ターン間で一貫性を保つことで、複雑なタスクをより安定かつ制御しやすくします。
- インターリーブドシンキング: モデルは、すべての応答やツール呼び出しの前に思考を行うことで、指示の追従性や生成の品質を向上させます。
- 思考の保持: コーディングエージェントのシナリオでは、モデルはマルチターン会話にわたってすべての思考ブロックを自動的に保持し、ゼロから再導出するのではなく、既存の推論を再利用します。これにより、情報の損失や不整合が軽減され、長期にわたる複雑なタスクに適しています。
- ターン単位の思考: モデルはセッション内の推論をターンごとに制御できます。軽量なリクエストでは思考を無効にしてレイテンシやコストを削減し、複雑なタスクでは有効にして精度と安定性を向上させることができます。
詳細: https://docs.z.ai/guides/capabilities/thinking-mode
GLM-4.7 技術ブログにアクセスして、さらに多くの評価結果、ユースケース、技術的な詳細をご確認ください。
GLM-4.6
GLM-4.5と比較して、GLM-4.6にはいくつかの重要な改善が加えられています。
- より長いコンテキストウィンドウ: コンテキストウィンドウは128Kトークンから200Kトークンに拡張され、モデルにより複雑なエージェントタスクを処理できるようになりました。
- 優れたコーディング性能: このモデルは、コードベンチマークでより高いスコアを達成し、Claude Code、Cline、Roo Code、Kilo Code などのアプリケーションにおいて、視覚的に洗練されたフロントエンドページの生成を含む、より優れた実世界でのパフォーマンスを示します。
- 高度な推論: GLM-4.6は推論性能が明確に向上しており、推論中のツール使用に対応しているため、総合的な能力が強化されています。
- より高機能なエージェント: GLM-4.6は、ツール利用や検索ベースのエージェントにおいてより優れたパフォーマンスを発揮し、エージェントフレームワーク内での統合もより効果的に行えます。
- ライティングの洗練: スタイルと読みやすさの面で人間の嗜好によりよく適合し、ロールプレイのシナリオでもより自然に動作します。
エージェント、推論、コーディングをカバーする8つの公開ベンチマークでGLM-4.6を評価しました。結果はGLM-4.5からの明確な性能向上を示しており、DeepSeek-V3.1-TerminusやClaude Sonnet 4といった国内外の主要モデルに対しても競争優位性を維持しています。
詳細な評価結果、ユースケース、技術的な詳細については、GLM-4.6 技術ブログをご覧ください。
GLM-4.5
GLM-4.5 シリーズのモデルは、インテリジェントエージェント向けに設計された基盤モデルであり、MoE 変種は Glm4Moe としてここにドキュメント化されています。
GLM-4.5は総パラメータ数が355億、アクティブパラメータ数が32億であるのに対し、GLM-4.5-Airはよりコンパクトな設計を採用し、総パラメータ数が106億、アクティブパラメータ数が12億です。GLM-4.5モデルは、推論、コーディング、インテリジェントエージェントの機能を統合し、インテリジェントエージェントアプリケーションの複雑な要求に対応します。
GLM-4.5 と GLM-4.5-Air はどちらもハイブリッド推論モデルであり、複雑な推論やツール使用のための思考モード、および即時応答のための非思考モードという2つのモードを提供します。
GLM-4.5 と GLM-4.5-Air 両方について、ベースモデル、ハイブリッド推論モデル、およびハイブリッド推論モデルの FP8 バージョンをオープンソース化しました。これらは MIT オープンソースライセンスの下で公開されており、商用利用および二次開発が可能です。
12の業界標準ベンチマークにわたる包括的な評価で示されたように、GLM-4.5は63.2というスコアを記録し、プロプライエタリモデルおよびオープンソースモデル全体の中で3位という優れたパフォーマンスを達成しました。特に、GLM-4.5-Airは優れた効率性を維持しながら、59.8という競争力のある結果を提示しています。
詳細な評価結果、ユースケース、技術的な詳細については、技術レポートまたは技術ブログをご覧ください。
モデルコード、ツールパーサー、推論パーサーは、transformers、vLLM、SGLangの実装内で確認できます。
Glm4MoeConfig
クラス transformers.Glm4MoeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 151552hidden_size: int = 4096intermediate_size: int = 10944num_hidden_layers: int = 46num_attention_heads: int = 96num_key_value_heads: int = 8hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truetie_word_embeddings: bool = Falserope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0moe_intermediate_size: int = 1408num_experts_per_tok: int = 8output_router_logits: bool = Falsen_shared_experts: int = 1n_routed_experts: int = 128routed_scaling_factor: float = 1.0n_group: int = 1topk_group: int = 1first_k_dense_replace: int = 1norm_topk_prob: bool = Trueuse_qk_norm: bool = Falsebos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepad_token_id: int | None = Nonenum_mtp_layers: int = 1 )
パラメータ
- vocab_size (
int、任意、デフォルトは151552) — モデルの語彙サイズです。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは4096) — 隠れ表現の次元数。 - intermediate_size (
int、任意、デフォルトは10944) — MLP 表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは46) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは96) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - num_key_value_heads (
int、任意、デフォルトは8) — Grouped Query Attention の実装に使用する key_value ヘッドの数を指定します。num_key_value_heads=num_attention_headsの場合、モデルは Multi Head Attention (MHA) を使用し、num_key_value_heads=1の場合は Multi Query Attention (MQA) を使用し、それ以外の場合は GQA が使用されます。 マルチヘッドのチェックポイントを GQA のチェックポイントに変換する際は、各グループの key ヘッドと value ヘッドを、そのグループ内の元のすべてのヘッドの平均プーリングによって構築する必要があります。詳細については、この論文を参照してください。指定しない場合、デフォルトでnum_attention_headsが使用されます。 - hidden_act (
str、任意、デフォルトはsilu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - max_position_embeddings (
int、任意、デフォルトは131072) — このモデルが使用される可能性のある最大シーケンス長です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - rms_norm_eps (
float、任意、デフォルト値は1e-05) — RMS正規化レイヤーで使用するepsilonです。 - use_cache (
bool、任意、デフォルトはTrue) — モデルが最後のキー/バリューの注意を返すかどうか(すべてのモデルで利用されるわけではありません)。config.is_decoder=Trueの場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。 - tie_word_embeddings (
bool、任意、デフォルトはFalse) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。 - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], 省略可) — RoPE 埋め込みの設定パラメータを含む辞書です。この辞書にはrope_thetaの値が含まれており、より長いmax_position_embeddingsで RoPE を使用する場合にスケーリングに使用されるパラメータが任意で含まれます。 - attention_bias (
bool、任意、デフォルトはFalse) — 自己注意機構において、クエリ、キー、バリュー、出力の投影層にバイアスを使用するかどうかを指定します。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - moe_intermediate_size (
int、任意、デフォルトは1408) — ルーティングされたエキスパートのMLPの中間サイズです。 - num_experts_per_tok (
int、任意、デフォルトは8) — 各トークンをルーティングするエキスパートの数です。これは、トークン選択ルーティングにおける top-k の値です。 - output_router_logits (
bool、任意、デフォルトはFalse) — モデルがルーターのロジツを返すかどうかを指定します。これを有効にすると、モデルは補助損失(ロードバランシング損失とルーターのz損失を含む)を出力できるようになります。 - n_shared_experts (
int、任意、デフォルトは1) — 共有エキスパートの数。 - n_routed_experts (
int、任意、デフォルトは128) — ルーティング対象のエクスパートの数。 - routed_scaling_factor (
float、任意、デフォルトは1.0) — ルーティングされたエキスパートのスケール係数。 - n_group (
int、任意、デフォルトは 1) — ルーティングされたエキスパートのグループ数。 - topk_group (
int、任意、デフォルトは1) — 各トークンについて選択されるグループの数(各トークンにおいて、選択されるエキスパートがtopk_group個のグループ内にのみ含まれることを保証します)。 - first_k_dense_replace (
int、任意、デフォルト値は 1)— 浅い層における dense 層の数(embed->dense->dense->…->dense->moe->moe…->lm_head)。 --k dense 層—/ - norm_topk_prob (
bool、任意、デフォルトはTrue) — ルーティングされたエキスパートの重みを正規化するかどうかを指定します。 - use_qk_norm (
bool、省略可、デフォルトはFalse) — アテンションでクエリ・キー正規化を使用するかどうか。 - bos_token_id (
int, 省略可) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]], 省略可) — 語彙内でストリーム終了に使用されるトークン ID。 - pad_token_id (
int, 任意) — 語彙内でパディングに使用されるトークン ID。 - num_mtp_layers (
int、任意、デフォルトは 1) — ベースの Transformer モデルの後に追加できる Multi-Token Prediction (MTP) モジュールの数。0の場合、モデルは標準的なデコーダーとして動作します。>0の場合、各追加モジュールは推論時に 1 つの追加の未来トークンを予測できます(generate(..., use_mtp=True)による投機的デコーディング)。
これは Glm4MoeModel の設定を保存するための設定クラスです。指定された引数に基づいて Glm4 Moe モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、zai-org/GLM-4.5 と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import Glm4MoeModel, Glm4MoeConfig

>>> # Initializing a Glm4Moe style configuration
>>> configuration = Glm4MoeConfig()

>>> # Initializing a model from the GLM-4-MOE-100B-A10B style configuration
>>> model = Glm4MoeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Glm4MoeModel
class transformers.Glm4MoeModel
< source >( config: Glm4MoeConfig )
パラメータ
- config (Glm4MoeConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
裸の Glm4 Moe Modelは、特定のヘッドを上に載せず、生の hidden-states を出力します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
MoeModelOutputWithPast または tuple(torch.FloatTensor)
MoeModelOutputWithPast または、torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(Glm4MoeConfig)や入力に応じて、さまざまな要素で構成されます。
Glm4MoeModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
router_logits (
tuple(torch.FloatTensor)、optional、output_router_probs=Trueとconfig.add_router_probs=Trueが渡された場合、またはconfig.output_router_probs=Trueの場合に返されます) — 各層ごとに1つずつ含まれるtorch.FloatTensorのタプルで、形状は(batch_size, sequence_length, num_experts)です。MoE ルーターによって計算される生(raw)のルーター logits(softmax 適用後)であり、Mixture of Experts モデルの補助損失を計算するためにこれらの用語が使用されます。
Glm4MoeForCausalLM
クラス transformers.Glm4MoeForCausalLM
< source >( config: Glm4MoeConfig )
パラメータ
- config (Glm4MoeConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
因果言語モデリング用の Glm4 Moe モデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[0, ..., config.vocab_size]の範囲内であるか、-100 である必要があります(input_idsの docstring を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲内のラベルを持つトークンに対してのみ計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - logits_to_keep (
Union[int, torch.Tensor]、省略可、デフォルトは0) —intの場合、最後のlogits_to_keepトークンについて logits を計算します。0の場合、すべてのinput_idsについて logits を計算します(特殊ケース)。生成には最後のトークンの logits だけで十分であり、そのトークンのみについて計算することでメモリを節約できます。これは、長いシーケンスや大規模な語彙サイズの場合に特に顕著な効果があります。torch.Tensorの場合、シーケンス長次元で保持するインデックスに対応する 1 次元テンソルである必要があります。これは、パックされたテンソル形式(バッチとシーケンス長を単一の次元にまとめた形式)を使用する場合に有用です。
戻り値
MoeCausalLMOutputWithPast または tuple(torch.FloatTensor)
MoeCausalLMOutputWithPast、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)です。設定(Glm4MoeConfig)や入力に応じて、さまざまな要素で構成されます。
Glm4MoeForCausalLM の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 言語モデリングの損失(次のトークン予測用)。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。aux_loss (
torch.FloatTensor、optional、output_router_logits=Trueが渡された場合、またはconfig.output_router_logits=Trueの場合、かつモデルがロードバランシング損失でルーターを学習する場合に返されます) — スパースモジュールのロードバランシング用の補助損失。ルーターバイアスによってエキスパートをバランスさせるモデル(DeepSeek-V3 とそこから派生したアーキテクチャ)は、router_logitsを返しながらも、ここではNoneを返します。router_logits (
tuple(torch.FloatTensor)、任意、output_router_logits=Trueが渡された場合またはconfig.output_router_logits=Trueの場合に返されます) — 各スパース層に対応するtorch.FloatTensorのタプルで、形状は(batch_size * sequence_length, num_experts)です。MoEルーターによって計算される生のルーターロジットです。ロードバランシング損失の計算や、トークンがどのようにエキスパートにディスパッチされるかの確認に使用できます。
past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。逐次デコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, Glm4MoeForCausalLM

>>> model = Glm4MoeForCausalLM.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."