
Transformers documentation
GPTBigCode
このモデルは2023年1月9日にHF papersで公開され、2023年4月10日にHugging Face Transformersに貢献されました。
GPTBigCode


概要
GPTBigCodeモデルは、BigCodeによるSantaCoder: don’t reach for the stars!で提案されました。著者名は以下の通りです: Loubna Ben Allal, Raymond Li, Denis Kocetkov, Chenghao Mou, Christopher Akiki, Carlos Munoz Ferrandis, Niklas Muennighoff, Mayank Mishra, Alex Gu, Manan Dey, Logesh Kumar Umapathi, Carolyn Jane Anderson, Yangtian Zi, Joel Lamy Poirier, Hailey Schoelkopf, Sergey Troshin, Dmitry Abulkhanov, Manuel Romero, Michael Lappert, Francesco De Toni, Bernardo García del Río, Qian Liu, Shamik Bose, Urvashi Bhattacharyya, Terry Yue Zhuo, Ian Yu, Paulo Villegas, Marco Zocca, Sourab Mangrulkar, David Lansky, Huu Nguyen, Danish Contractor, Luis Villa, Jia Li, Dzmitry Bahdanau, Yacine Jernite, Sean Hughes, Daniel Fried, Arjun Guha, Harm de Vries, Leandro von Werra。
論文の抄録は以下の通りです。
The BigCode プロジェクトは、コード向けの大型言語モデルの責任ある開発に取り組むオープンサイエンスの共同研究プロジェクトです。本技術レポートでは、2022 年 12 月までの共同研究の進捗を記述し、個人識別可能情報 (PII) 除去パイプラインの現状、モデルアーキテクチャのリスク低減のために実施した実験、および学習データのより良い前処理手法を調査した実験について概説します。The Stack の Java、JavaScript、Python サブセットで 11 億パラメータのモデルを学習し、MultiPL-E テキストからコード生成ベンチマークで評価しました。近似重複のより積極的なフィルタリングによりパフォーマンスがさらに向上することがわかり、また驚くべきことに、GitHub スター数が 5 以上のリポジトリからファイルを選択するとパフォーマンスが大幅に低下することがわかりました。私たちの最良のモデルは、はるかに小さいモデルであるにもかかわらず、MultiPL-E の Java、JavaScript、Python 部分において、左から右への生成とインフィルの両方で、従来のオープンソースの多言語コード生成モデル (InCoder-6.7B および CodeGen-Multi-2.7B) を上回りました。すべてのモデルは、この https URL で OpenRAIL ライセンスの下で公開されています。
このモデルは、Multi-Query Attentionに対応した最適化されたGPT2モデルです。
実装の詳細
GPT2との主な違い。
- Multi-Query Attention のサポートを追加しました。
- 従来の
geluではなく、gelu_pytorch_tanhを使用してください。 - 不要な同期を回避してください(これはその後、#20061でGPT2に追加されましたが、リファレンスコードベースには含まれていませんでした)。
- Conv1D の代わりに Linear レイヤーを使用します(速度が向上しますが、チェックポイントが互換性を失います)。
_attnと_upcast_and_reordered_attnを統合します。スケーリングとのmatmulは常に統合してください。reorder_and_upcast_attnをattention_softmax_in_fp32に名前変更します。- 毎回再生成することを避けるため、attention mask の値をキャッシュします。
- jit を使用して、attention の fp32 キャスティング、マスキング、softmax、スケーリングを融合します。
- アテンションマスクと因果マスクを1つに統合し、各レイヤーごとではなくモデル全体に対して事前計算します。
- キーとバリューのキャッシュを1つに統合します(これによりlayer_past/presentの形式が変更されますが、問題を引き起こすリスクはありますか?)
- MHA における QKV テンソルには、
(3, self.num_heads, self.head_dim)ではなく、メモリレイアウトとして (self.num_heads, 3, self.head_dim) を使用します。(マージされたキーとバリューによるオーバーヘッドを防ぎますが、元の openai-community/gpt2 モデルとのチェックポイントの互換性がなくなります)。
元のプルリクエストで、これらの最適化について詳しく読むことができます。
StarcoderとFlash Attention 2の組み合わせ
まず、スライディングウィンドウアテンション機能を含む最新のFlash Attention 2をインストールしてください。
pip install -U flash-attn --no-build-isolation
Flash-Attention 2 と互換性のあるハードウェアを使用していることも確認してください。詳細については、flash-attn リポジトリの公式ドキュメントを参照してください。また、モデルを半精度(例: torch.float16)で読み込むことも確認してください。
Flash Attention 2 を使用してモデルを読み込み、実行するには、以下のスニペットを参照してください。
from transformers import AutoModelForCausalLM, AutoTokenizer


model = AutoModelForCausalLM.from_pretrained("bigcode/gpt_bigcode-santacoder", device_map="auto", attn_implementation="flash_attention_2")
tokenizer = AutoTokenizer.from_pretrained("bigcode/gpt_bigcode-santacoder")

prompt = "def hello_world():"

model_inputs = tokenizer([prompt], return_tensors="pt").to(model.device)
model.to(model.device)

generated_ids = model.generate(**model_inputs, max_new_tokens=30, do_sample=False)
tokenizer.batch_decode(generated_ids)[0]
'def hello_world():\n    print("hello world")\n\nif __name__ == "__main__":\n    print("hello world")\n<|endoftext|>'
期待される高速化
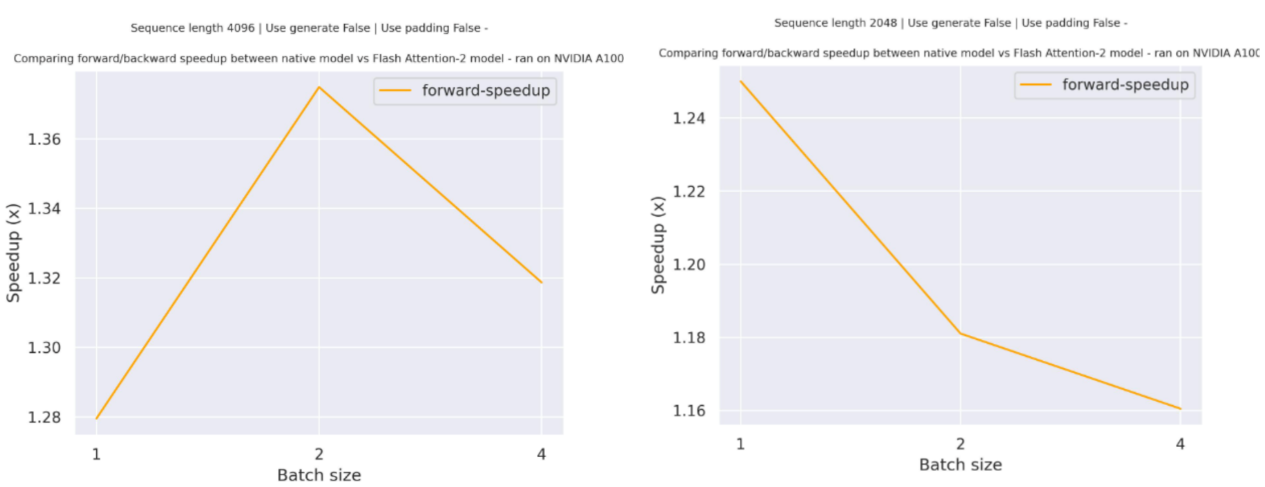
以下は、bigcode/starcoder チェックポイントを用いた transformers のネイティブ実装と、Flash Attention 2 版のモデルの純粋な推論時間を、2 種類の異なるシーケンス長で比較した、期待される高速化の図です。
GPTBigCodeConfig
class transformers.GPTBigCodeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 50257n_positions: int = 1024n_embd: int = 768n_layer: int = 12n_head: int = 12n_inner: int | None = Noneactivation_function: str = 'gelu_pytorch_tanh'resid_pdrop: float | int = 0.1embd_pdrop: float | int = 0.1attn_pdrop: float | int = 0.1layer_norm_epsilon: float = 1e-05initializer_range: float = 0.02scale_attn_weights: bool = Trueuse_cache: bool = Truebos_token_id: int | None = 50256eos_token_id: int | list[int] | None = 50256pad_token_id: int | None = Noneattention_softmax_in_fp32: bool = Truescale_attention_softmax_in_fp32: bool = Truemulti_query: bool = Trueadd_cross_attention: bool = Falsetie_word_embeddings: bool = True )
パラメータ
- vocab_size (
int、任意、デフォルトは50257) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - n_positions (
int、任意、デフォルトは1024) — このモデルが使用される可能性のある最大シーケンス長です。 - n_embd (
int、任意、デフォルトは768) — 埋め込みおよび隠れ状態の次元数。 - n_layer (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - n_head (
int、任意、デフォルトは12) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - n_inner (
int, 省略可) — MLP 表現の次元数。 - activation_function (
str、任意、デフォルトはgelu_pytorch_tanh) — デコーダーで使用する非線形活性化関数(関数または文字列)です。例えば、"gelu"、"relu"、"silu"などです。 - resid_pdrop (
Union[float, int]、任意、デフォルト値は0.1) — embeddings、encoder、pooler 内のすべての全結合層における dropout 確率です。 - embd_pdrop (
Union[float, int]、任意、デフォルトは0.1) — 埋め込みのドロップアウト率です。 - attn_pdrop (
Union[float, int]、任意、デフォルトは0.1) — アテンション確率のドロップアウト率です。 - layer_norm_epsilon (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - scale_attn_weights (
bool、任意、デフォルトはTrue) — アテンション重みを sqrt(hidden_size) で割ることでスケーリングします。 - use_cache (
bool、任意、デフォルトはTrue) — モデルが最後のキー/バリューの注意を返すかどうか(すべてのモデルで利用されるわけではありません)。config.is_decoder=Trueの場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。 - bos_token_id (
int、任意、デフォルトは50256) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]]、任意、デフォルトは50256) — 語彙内でストリーム終了に使用されるトークン ID。 - pad_token_id (
int, 任意) — 語彙内でパディングに使用されるトークン ID。 - attention_softmax_in_fp32 (
bool、省略可、デフォルトはTrue) — float32 で融合 softmax を呼び出すかどうかを指定します。 - scale_attention_softmax_in_fp32 (
bool、任意、デフォルトはTrue) — アテンションの softmax を float32 でスケーリングするかどうか。 - multi_query (
bool、任意、デフォルトはTrue) — デコーダーでマルチクエリアテンションを使用するかどうか。new_decoder_architectureがTrueの場合、無視されます。 - add_cross_attention (
bool、任意、デフォルトはFalse) — モデルにクロスアテンション層を追加するかどうか。 - tie_word_embeddings (
bool、任意、デフォルトはTrue) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。
これは GPTBigCodeModel の設定を保存するための設定クラスです。指定された引数に基づいて Gpt Bigcode モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、bigcode/gpt_bigcode-santacoder と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import GPTBigCodeConfig, GPTBigCodeModel

>>> # Initializing a GPTBigCode configuration
>>> configuration = GPTBigCodeConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = GPTBigCodeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
GPTBigCodeModel
クラス transformers.GPTBigCodeModel
< source >( config: GPTBigCodeConfig )
パラメータ
- config (GPTBigCodeConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを上に載せずに、生のhidden-statesを出力する素のGpt Bigcode Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPastAndCrossAttentions or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, input_ids_length)) —input_ids_length=sequence_lengthの場合past_key_valuesがNoneそれ以外の場合past_key_values.get_seq_length()(sequence_lengthの input past key value states の長さ)。語彙における入力シーケンスのトークンのインデックス。past_key_valuesを使用する場合、過去が計算されていないinput_idsのみをinput_idsとして渡す必要があります。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - encoder_hidden_states (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) — エンコーダーの最終層の出力における隠れ状態のシーケンスです。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。 - encoder_attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — エンコーダー入力のパディングトークンインデックスに対するアテンションを回避するためのマスク。モデルがデコーダーとして設定されている場合、このマスクはクロスアテンションで使用されます。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
BaseModelOutputWithPastAndCrossAttentions または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または BaseModelOutputWithPastAndCrossAttentions。設定(GPTBigCodeConfig)や入力に応じて、さまざまな要素で構成されます。
GPTBigCodeModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_valuesが使用されている場合、出力されるのは、形状(batch_size, 1, hidden_size)のシーケンスの最後の隠れ状態のみです。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合、またはconfig.add_cross_attention=Trueが渡された場合、またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
GPTBigCodeForCausalLM
クラス transformers.GPTBigCodeForCausalLM
< source >( config: GPTBigCodeConfig )
パラメータ
- config (GPTBigCodeConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
GPT_BIGCODE モデルの transformer で、上部に言語モデリングヘッド(入力埋め込みの重みと共有される線形層)を備えています。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CausalLMOutputWithCrossAttentions or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, input_ids_length)) —input_ids_length=sequence_lengthの場合past_key_valuesがNoneそれ以外の場合past_key_values.get_seq_length()(sequence_lengthの input past key value states の長さ)。語彙における入力シーケンスのトークンのインデックス。past_key_valuesを使用する場合、過去が計算されていないinput_idsのみをinput_idsとして渡す必要があります。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - encoder_hidden_states (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) — エンコーダーの最終層の出力における隠れ状態のシーケンスです。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。 - encoder_attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — エンコーダー入力のパディングトークンインデックスに対するアテンションを回避するためのマスク。モデルがデコーダーとして設定されている場合、このマスクはクロスアテンションで使用されます。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- labels (
torch.Tensor、shape(batch_size, input_ids_length)、任意) — 言語モデリング用のラベル。モデル内部でラベルはシフトされるため、labels = input_idsと設定できます。インデックスは[-100, 0, ..., config.vocab_size]から選択されます。-100に設定されたすべてのラベルは無視(マスク)され、損失は[0, ..., config.vocab_size]のラベルに対してのみ計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - logits_to_keep (
Union[int, torch.Tensor]、省略可、デフォルトは0) —intの場合、最後のlogits_to_keepトークンについて logits を計算します。0の場合、すべてのinput_idsについて logits を計算します(特殊ケース)。生成には最後のトークンの logits だけで十分であり、そのトークンのみについて計算することでメモリを節約できます。これは、長いシーケンスや大規模な語彙サイズの場合に特に顕著な効果があります。torch.Tensorの場合、シーケンス長次元で保持するインデックスに対応する 1 次元テンソルである必要があります。これは、パックされたテンソル形式(バッチとシーケンス長を単一の次元にまとめた形式)を使用する場合に有用です。
戻り値
CausalLMOutputWithCrossAttentions または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または CausalLMOutputWithCrossAttentions。設定(GPTBigCodeConfig)や入力に応じて、さまざまな要素で構成されます。
GPTBigCodeForCausalLM の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 言語モデリングの損失(次のトークン予測用)。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のクロスアテンションの重み。クロスアテンションヘッドにおける加重平均の計算に使用されます。
past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。シーケンシャルなデコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの hidden-states(アテンションブロック内のキーとバリュー)が含まれます。
GPTBigCodeForSequenceClassification
class transformers.GPTBigCodeForSequenceClassification
< source >( config: GPTBigCodeConfig )
パラメータ
- config (GPTBigCodeConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
シーケンス分類ヘッド(線形層)を上部に備えたGPTBigCodeモデルのtransformerです。
GPTBigCodeForSequenceClassification は、他の causal モデル(GPT-1 など)と同様に、最後のトークンを使用して分類を行います。
最後のトークンに対して分類を行うため、最後のトークンの位置を知る必要があります。pad_token_idが設定に定義されている場合、各行でパディングトークンではない最後のトークンを探します。pad_token_idが定義されていない場合、バッチの各行の最後の値をそのまま採用します。inputs_embedsがinput_idsの代わりに渡された場合、パディングトークンを推測できないため、同様にバッチの各行の最後の値を採用します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SequenceClassifierOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, input_ids_length)) —input_ids_length=sequence_lengthの場合past_key_valuesがNoneそれ以外の場合past_key_values.get_seq_length()(sequence_lengthの input past key value states の長さ)。語彙における入力シーケンスのトークンのインデックス。past_key_valuesを使用する場合、過去が計算されていないinput_idsのみをinput_idsとして渡す必要があります。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — シーケンス分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
SequenceClassifierOutputWithPast または tuple(torch.FloatTensor)
SequenceClassifierOutputWithPast または、torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(GPTBigCodeConfig)や入力に応じて、さまざまな要素で構成されます。
GPTBigCodeForSequenceClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。逐次デコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
単一ラベル分類の例:
>>> import torch
>>> from transformers import AutoTokenizer, GPTBigCodeForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("bigcode/gpt_bigcode-santacoder")
>>> model = GPTBigCodeForSequenceClassification.from_pretrained("bigcode/gpt_bigcode-santacoder")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = GPTBigCodeForSequenceClassification.from_pretrained("bigcode/gpt_bigcode-santacoder", num_labels=num_labels)

>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
マルチラベル分類の例:
>>> import torch
>>> from transformers import AutoTokenizer, GPTBigCodeForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("bigcode/gpt_bigcode-santacoder")
>>> model = GPTBigCodeForSequenceClassification.from_pretrained("bigcode/gpt_bigcode-santacoder", problem_type="multi_label_classification")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = GPTBigCodeForSequenceClassification.from_pretrained(
...     "bigcode/gpt_bigcode-santacoder", num_labels=num_labels, problem_type="multi_label_classification"
... )

>>> labels = torch.sum(
...     torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
GPTBigCodeForTokenClassification
クラス transformers.GPTBigCodeForTokenClassification
< source >( config: GPTBigCodeConfig )
パラメータ
- config (GPTBigCodeConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Gpt Bigcode transformerの上部にトークン分類ヘッド(hidden-states出力の上部に配置された線形層)を備えたモデル。例として、固有表現抽出(NER)タスクに使用できます。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → TokenClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, input_ids_length)) —input_ids_length=sequence_lengthの場合past_key_valuesがNoneそれ以外の場合past_key_values.get_seq_length()(sequence_lengthの input past key value states の長さ)。語彙における入力シーケンスのトークンのインデックス。past_key_valuesを使用する場合、過去が計算されていないinput_idsのみをinput_idsとして渡す必要があります。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.Tensor、shape(batch_size, sequence_length)、任意) — シーケンス分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(Mean-Square loss)が計算され、config.num_labels > 1の場合は分類損失(Cross-Entropy)が計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
TokenClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または TokenClassifierOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(GPTBigCodeConfig)や入力に応じて、さまざまな要素で構成されます。
GPTBigCodeForTokenClassification の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.num_labels)) — SoftMax 適用前の分類スコア。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, GPTBigCodeForTokenClassification
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("bigcode/gpt_bigcode-santacoder")
>>> model = GPTBigCodeForTokenClassification.from_pretrained("bigcode/gpt_bigcode-santacoder")

>>> inputs = tokenizer(
...     "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_token_class_ids = logits.argmax(-1)

>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...

>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...