
Transformers documentation
Mixtral
このモデルは2024年1月8日にHF papersで公開され、2023年12月11日にHugging Face Transformersに貢献されました。
Mixtral



概要
Mixtral-8x7B は、Albert Jiang、Alexandre Sablayrolles、Arthur Mensch、Chris Bamford、Devendra Singh Chaplot、Diego de las Casas、Florian Bressand、Gianna Lengyel、Guillaume Lample、Lélio Renard Lavaud、Lucile Saulnier、Marie-Anne Lachaux、Pierre Stock、Teven Le Scao、Thibaut Lavril、Thomas Wang、Timothée Lacroix、William El Sayed による Mixtral of Experts ブログ記事で紹介されました。
ブログ記事の導入部には次のように記載されています:
本日、チームはオープンウェイトの高品質なスパースなエキスパートの混合モデル(SMoE)である Mixtral 8x7B のリリースを誇りに思います。ライセンスは Apache 2.0 です。Mixtral は、ほとんどのベンチマークで Llama 2 70B を上回り、推論速度は 6 倍速いです。寛容なライセンスを持つオープンウェイトモデルの中で最も強力であり、コストとパフォーマンスのトレードオフを考慮した全体的なモデルとしても最良です。特に、ほとんどの標準ベンチマークで GPT3.5 に匹敵するか、それを上回る性能を発揮します。
Mixtral-8x7B は、Mistral-7B に続き、mistral.ai によってリリースされた2番目の大規模言語モデル(LLM)です。
アーキテクチャの詳細
Mixtral-8x7Bは、以下のアーキテクチャの選択を持つ、デコーダーのみのTransformerです。
- Mixtral is a Mixture of Experts (MoE) model with 8 experts per MLP, with a total of 45 billion parameters. To learn more about mixture-of-experts, refer to the blog post.
- モデルのパラメータ数が450億に達するにもかかわらず、1回のフォワードパスに必要な計算量は、140億パラメータのモデルと同等です。これは、各エキスパートをRAMにロードする必要があるため(70B相当のRAM要件)、しかし隠れ状態からの各トークンは2回ディスパッチされる(top 2ルーティング)ため、計算量(各フォワード計算で必要な演算)は単に2 X sequence_lengthとなるからです。
以下の実装詳細は、Mistral AIの最初のモデルであるMistral-7Bと共通しています:
- スライディングウィンドウアテンション - 8kのコンテキスト長と固定されたキャッシュサイズで学習されており、理論上のアテンション範囲は128Kトークンです
- GQA (Grouped Query Attention) - より高速な推論と、より小さいキャッシュサイズを可能にします。
- Byte-fallback BPE トークナイザー - 文字が語彙外トークンにマッピングされることを防ぎます。
詳細については、リリースブログ記事を参照してください。
ライセンス
Mixtral-8x7BはApache 2.0ライセンスの下で公開されています。
使用のコツ
Mistralチームは2つのチェックポイントをリリースしました:
- インターネット規模のデータで次のトークンを予測するように事前学習されたベースモデル、Mixtral-8x7B-v0.1。
- 指示チューニング済みモデルであるMixtral-8x7B-Instruct-v0.1は、教師ありファインチューニング (SFT) と直接選好最適化 (DPO) を用いてチャット用途向けに最適化されたベースモデルです。
ベースモデルは次のように使用できます:
from transformers import AutoModelForCausalLM, AutoTokenizer


model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x7B-v0.1", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-v0.1")

prompt = "My favourite condiment is"

model_inputs = tokenizer([prompt], return_tensors="pt").to(model.device)

generated_ids = model.generate(**model_inputs, max_new_tokens=100, do_sample=True)
tokenizer.batch_decode(generated_ids)[0]
"My favourite condiment is to ..."
指示チューニング済みモデルは、次のように使用できます。
from transformers import AutoModelForCausalLM, AutoTokenizer


model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1")

messages = [
    {"role": "user", "content": "What is your favourite condiment?"},
    {"role": "assistant", "content": "Well, I'm quite partial to a good squeeze of fresh lemon juice. It adds just the right amount of zesty flavour to whatever I'm cooking up in the kitchen!"},
    {"role": "user", "content": "Do you have mayonnaise recipes?"}
]

model_inputs = tokenizer.apply_chat_template(messages, return_tensors="pt").to(model.device)

generated_ids = model.generate(model_inputs, max_new_tokens=100, do_sample=True)
tokenizer.batch_decode(generated_ids)[0]
"Mayonnaise can be made as follows: (...)"ご覧のとおり、指示チューニング済みモデルでは、入力が正しい形式で準備されることを保証するために、チャットテンプレートを適用する必要があります。
Flash Attention を使用して Mixtral を高速化
上記のコードスニペットは、最適化テクニックを一切使わない推論を示しています。しかし、モデル内で使用されるアテンションメカニズムのより高速な実装であるFlash Attentionを活用することで、モデルを大幅に高速化できます。
まず、スライディングウィンドウアテンション機能を含む最新のFlash Attention 2をインストールしてください。
pip install -U flash-attn --no-build-isolation
Flash-Attention 2 と互換性のあるハードウェアを使用していることも確認してください。詳細については、flash attention リポジトリの公式ドキュメントを参照してください。また、モデルを半精度(例: torch.float16)で読み込むことも確認してください。
Flash Attention-2を使用してモデルを読み込み、実行するには、以下のスニペットを参照してください。
from transformers import AutoModelForCausalLM, AutoTokenizer


model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x7B-v0.1", attn_implementation="flash_attention_2", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-v0.1")

prompt = "My favourite condiment is"

model_inputs = tokenizer([prompt], return_tensors="pt").to(model.device)

generated_ids = model.generate(**model_inputs, max_new_tokens=100, do_sample=True)
tokenizer.batch_decode(generated_ids)[0]
"The expected output"
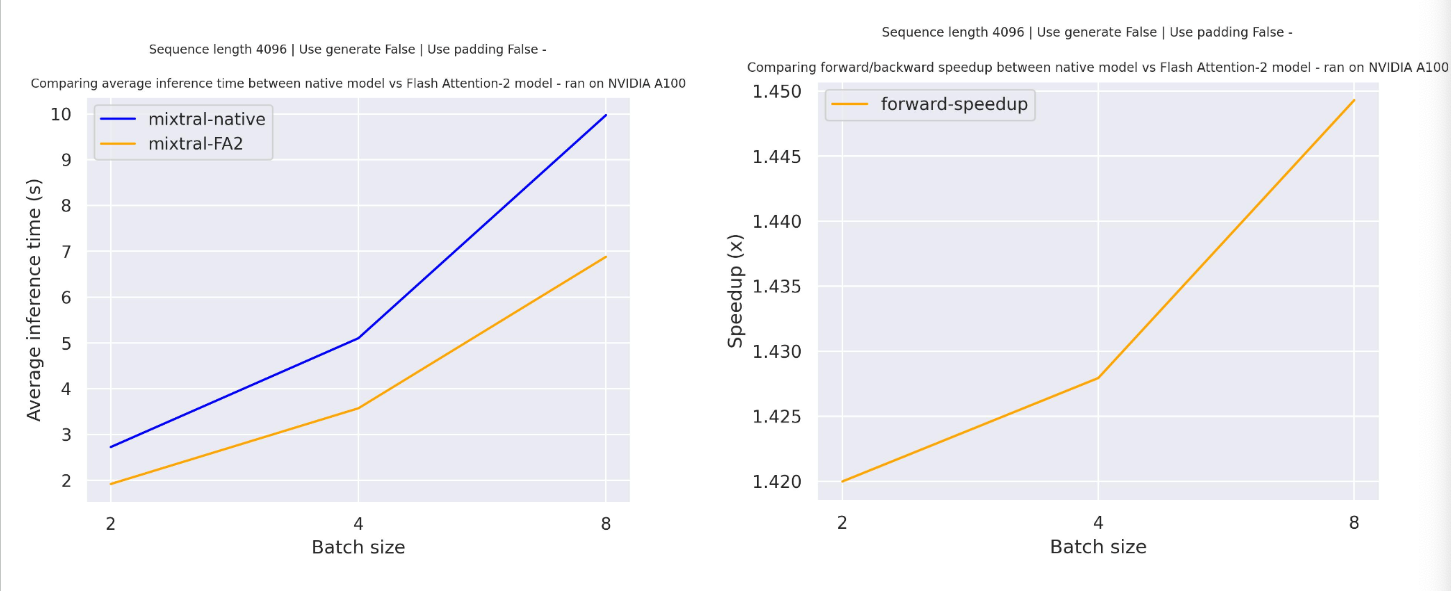
期待される高速化
以下は、mistralai/Mixtral-8x7B-v0.1 チェックポイントを用いた transformers のネイティブ実装と、Flash Attention 2 版モデルの純粋な推論時間を比較した、期待される高速化の図です。
スライディングウィンドウAttention
現在の実装では、スライディングウィンドウアテンション機構とメモリ効率の高いキャッシュ管理に対応しています。
スライディングウィンドウアテンションを有効にするには、スライディングウィンドウアテンションと互換性のある flash-attn のバージョン(>=2.3.0)を使用していることを確認してください。
Flash Attention-2 モデルは、よりメモリ効率の高いキャッシュのスライシング機構も使用します。Mistral モデルの公式実装で推奨されているローリングキャッシュ機構に従い、キャッシュサイズを固定(self.config.sliding_window)にし、padding_side="left" の場合のみバッチ生成をサポートし、現在のトークンの絶対位置を用いて位置埋め込みを計算します。
量子化による Mixtral のサイズ縮小
Mixtralモデルは450億のパラメータを持つため、各パラメータが2バイトで保存される半精度(float16)では、約90GBのGPU RAMが必要です。ただし、量子化を用いてモデルのサイズを縮小できます。モデルを4ビット(パラメータあたり半バイト)に量子化すると、必要なRAMは約27GBに減るため、40GBのRAMを備えた単一のA100でモデル全体を収容できます。
モデルの量子化は、モデルにquantization_configを渡すだけで簡単に実行できます。以下では、bitsandbytes量子化ライブラリを利用しますが(他の量子化方法については、このページを参照してください):
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig


# specify how to quantize the model
quantization_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype="torch.float16",
)

model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1", quantization_config=True, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1")

prompt = "My favourite condiment is"

messages = [
    {"role": "user", "content": "What is your favourite condiment?"},
    {"role": "assistant", "content": "Well, I'm quite partial to a good squeeze of fresh lemon juice. It adds just the right amount of zesty flavour to whatever I'm cooking up in the kitchen!"},
    {"role": "user", "content": "Do you have mayonnaise recipes?"}
]

model_inputs = tokenizer.apply_chat_template(messages, return_tensors="pt").to(model.device)

generated_ids = model.generate(model_inputs, max_new_tokens=100, do_sample=True)
tokenizer.batch_decode(generated_ids)[0]
"The expected output"このモデルは、Younes Belkada 氏と Arthur Zucker 氏によって提供されました。 元のコードはこちらで確認できます。
リソース
Mixtral の入門を支援するための、Hugging Face 公式およびコミュニティ(🌎 で示されます)のリソース一覧です。ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しい内容をデモンストレーションするものが望ましいです。
- Mixtral-8x7Bの教師ありファインチューニング(SFT)を行うデモノートブックは、こちらで確認できます。🌎
- PEFTを使用してMixtral-8x7Bをファインチューニングするブログ記事。🌎
- Hugging Face による Alignment Handbook には、Mistral-7B での教師ありファインチューニング (SFT) と直接選好最適化を実行するためのスクリプトとレシピが含まれています。これには、フルファインチューニング、単一アクセラレーターでの QLoRa、および複数アクセラレーターでのファインチューニングのスクリプトが含まれます。
- 因果言語モデリングタスクのガイド
MixtralConfig
クラス transformers.MixtralConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 32000hidden_size: int = 4096intermediate_size: int = 14336num_hidden_layers: int = 32num_attention_heads: int = 32num_key_value_heads: int = 8head_dim: int | None = Nonehidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truepad_token_id: int | None = Nonebos_token_id: int | None = 1eos_token_id: int | list[int] | None = 2tie_word_embeddings: bool = Falsesliding_window: int | None = Noneattention_dropout: float | int = 0.0num_experts_per_tok: int = 2num_local_experts: int = 8output_router_logits: bool = Falserouter_aux_loss_coef: float = 0.001router_jitter_noise: float = 0.0rope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = None )
パラメータ
- vocab_size (
int、任意、デフォルトは32000) — モデルの語彙サイズです。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは4096) — 隠れ表現の次元数。 - intermediate_size (
int、任意、デフォルトは14336) — MLP 表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは32) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは32) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - num_key_value_heads (
int、任意、デフォルトは8) — Grouped Query Attention の実装に使用する key_value ヘッドの数を指定します。num_key_value_heads=num_attention_headsの場合、モデルは Multi Head Attention (MHA) を使用し、num_key_value_heads=1の場合は Multi Query Attention (MQA) を使用し、それ以外の場合は GQA が使用されます。 マルチヘッドのチェックポイントを GQA のチェックポイントに変換する際は、各グループの key ヘッドと value ヘッドを、そのグループ内の元のすべてのヘッドの平均プーリングによって構築する必要があります。詳細については、この論文を参照してください。指定しない場合、デフォルトでnum_attention_headsが使用されます。 - head_dim (
int、省略可) — アテンションヘッドの次元です。None の場合、hidden_size // num_attention_heads がデフォルトとして使用されます。 - hidden_act (
str、任意、デフォルトはsilu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - max_position_embeddings (
int、任意、デフォルトは131072) — このモデルが使用される可能性のある最大シーケンス長です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - rms_norm_eps (
float、任意、デフォルト値は1e-05) — RMS正規化レイヤーで使用するepsilonです。 - use_cache (
bool、任意、デフォルトはTrue) — モデルが最後のキー/バリューの注意を返すかどうか(すべてのモデルで利用されるわけではありません)。config.is_decoder=Trueの場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。 - pad_token_id (
int, 任意) — 語彙内でパディングに使用されるトークン ID。 - bos_token_id (
int、任意、デフォルトは1) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]]、任意、デフォルトは2) — 語彙内でストリーム終了に使用されるトークン ID。 - tie_word_embeddings (
bool、任意、デフォルトはFalse) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。 - sliding_window (
int, 省略可) — スライディングウィンドウアテンションのウィンドウサイズ。Noneの場合、スライディングウィンドウは適用されません。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - num_experts_per_tok (
int、任意、デフォルトは2) — 各トークンをルーティングするエキスパートの数です。これは、トークン選択ルーティングにおける top-k の値です。 - num_local_experts (
int、任意、デフォルトは8) — 各デバイス上のローカルエキスパートの数。num_expertsはnum_local_expertsで割り切れる必要があります。 - output_router_logits (
bool、任意、デフォルトはFalse) — モデルがルーターのロジツを返すかどうかを指定します。これを有効にすると、モデルは補助損失(ロードバランシング損失とルーターのz損失を含む)を出力できるようになります。 - router_aux_loss_coef (
float、任意、デフォルト値は0.001) — 補助的なロードバランシング損失の係数です。MoEモデルにおける不均一なエキスパートルーティングをペナルティするために使用されます。 - router_jitter_noise (
float、任意、デフォルト値は0.0) — トレーニング中にルーターのロジットに追加するノイズの量。負荷分散を改善するために使用します。 - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], 省略可) — RoPE 埋め込みの設定パラメータを含む辞書です。この辞書にはrope_thetaの値が含まれており、より長いmax_position_embeddingsで RoPE を使用する場合にスケーリングに使用されるパラメータが任意で含まれます。
これは MixtralModel の設定を保存するための設定クラスです。指定された引数に基づいて Mixtral モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、mistralai/Mixtral-8x7B-v0.1 と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import MixtralModel, MixtralConfig

>>> # Initializing a Mixtral 7B style configuration
>>> configuration = MixtralConfig()

>>> # Initializing a model from the Mixtral 7B style configuration
>>> model = MixtralModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MistralCommonBackend
クラス transformers.MistralCommonBackend
< source >( tokenizer_path: str | os.PathLike | pathlib.Pathmode: str | ValidationMode = 'test'model_max_length: int = 1000000000000000019884624838656padding_side: str = 'left'truncation_side: str = 'right'model_input_names: list[str] | None = Noneclean_up_tokenization_spaces: bool = False**kwargs )
mistral-common のトークナイザをラップするためのクラスです。
mistral-common は、Mistral AI モデル用の公式トークナイザライブラリです。使用するには、以下でインストールする必要があります。
pip install transformers[mistral-common]
それ以外の場合、tokenizer は Transformers による tokenizer の実装にフォールバックします。
mistral-commonの詳細については、mistral-commonを参照してください。
このクラスは、mistral_common.tokens.tokenizers.mistral.MistralTokenizer のラッパーです。
公式の mistral-common トークナイザーを使用してトークン化するための Hugging Face 互換インターフェースを提供し、PreTrainedTokenizerBase クラスを継承しています。
PythonBackend クラスとの主な動作上の違いは以下の通りです:
- シーケンスのペアはサポートされていません。互換性のためにシグネチャは維持されていますが、シーケンスのペアに関連するすべての引数は無視されます。ペアの戻り値は
Noneとして返されます。 is_split_into_words引数はサポートされていません。- トークナイザーに新しいトークンを追加することはできません。特殊トークンの扱いは Transformers と異なります。
mistral-commonでは、特殊トークンは直接エンコードされません。つまり、tokenizer.encode("<s>")は<s>トークンの ID を返しません。代わりに、文字列"<s>"のトークン化に対応する ID のリストを返します。詳細については、mistral-common のドキュメントを参照してください。
このクラスの改善に関するご提案がある場合は、トークナイザーに関連する場合はmistral-common GitHub リポジトリに、Hugging Face インターフェースに関連する場合はTransformers GitHub リポジトリに、それぞれ issue を作成してください。
add_special_tokens
< source >( special_tokens_dict: dictreplace_extra_special_tokens: bool = True )
MistralCommonBackend は、設計上 add_special_tokens を実装していません。
この動作の実装を希望される場合は、Transformersまたはmistral-commonリポジトリでissueを作成してご依頼ください。
MistralCommonBackend は、設計上 add_special_tokens を実装していません。
この動作の実装を希望される場合は、Transformersまたはmistral-commonリポジトリでissueを作成してご依頼ください。
apply_chat_template
< source >( conversation: list[dict[str, str]] | list[list[dict[str, str]]]tools: list[dict | collections.abc.Callable] | None = Noneadd_generation_prompt: bool = Falsecontinue_final_message: bool = Falsetokenize: bool = Truepadding: bool | str | transformers.utils.generic.PaddingStrategy = Falsetruncation: bool = Falsemax_length: int | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonereturn_dict: bool = Truereasoning_effort: ReasoningEffort | None = None**kwargs ) → Union[str, list[int], list[str], list[list[int]], BatchEncoding]
パラメータ
- conversation (Union[List[Dict[str, str]], List[List[Dict[str, str]]]]) — “role”キーと“content”キーを持つ辞書のリストで、これまでに蓄積されたチャット履歴を表します。
- tools (
List[Union[Dict, Callable]]、任意) — モデルからアクセス可能なツール(呼び出し可能な関数)のリストです。テンプレートが関数呼び出しをサポートしていない場合、この引数は無効になります。各ツールは、ツールの名前、説明、引数の型を指定した JSON Schema として渡す必要があります。詳細については、チャットテンプレートガイドを参照してください。 - add_generation_prompt (
bool, 省略可) — この引数はMistralCommonBackendに対しては何もせず(no-op)です。ただし、API の一貫性を保つため、continue_final_messageと同時に使用することはできません。 会話の最後にアシスタントのメッセージがある場合、エラーが発生します。そのような場合は、代わりにcontinue_final_messageを使用してください。 - continue_final_message (bool, 省略可) —
これを設定すると、チャットは最終メッセージがオープンエンドになるようにフォーマットされ、EOS トークンが付きません。モデルは新しいメッセージを開始するのではなく、このメッセージを続けます。これにより、モデルの応答の一部を「プリフィル」できます。
add_generation_promptと同時に使用することはできません。 - tokenize (
bool、デフォルトはTrue) — 出力をトークン化するかどうかを指定します。Falseの場合、出力は文字列になります。 - padding (
bool,strまたは PaddingStrategy, 省略可, デフォルトはFalse) — 返されるシーケンスのパディング戦略(モデルのパディング側およびパディングインデックスに従う)として、以下から選択します:Trueまたは'longest': バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。'max_length': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。Falseまたは'do_not_pad'(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
- truncation (
bool、デフォルトはFalse) — 最大長でシーケンスを切り詰めるかどうか。tokenize がFalseの場合は無効です。 - max_length (
int, 省略可) — パディングや切り詰めのために使用する最大長(トークン数)。tokenize がFalseの場合は無効です。指定しない場合、デフォルトとしてトークナイザーのmax_length属性が使用されます。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、特定のフレームワークのテンソルを返します。tokenize がFalse. 指定可能な値は次のとおりです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。
- return_dict (
bool、デフォルトはFalse) — 名前付きの出力を含む辞書を返すかどうかを指定します。Falseの場合、この引数は無効になります。 少なくとも1つの会話に画像が含まれている場合、そのピクセル値はpixel_valuesキーに、画像サイズはimage_sizesキーに返されます。 - reasoning_effort (
ReasoningEffort, 省略可能) — 対応するモデルのチャット補完に使用する推論の努力度。指定可能な値は以下の通りです:ReasoningEffort.none: モデルは推論を行いません。ReasoningEffort.high: モデルは推論アプローチを使用します。 指定しない場合、デフォルトの推論努力度が使用されます。
- kwargs (追加のキーワード引数、省略可) —
mistral-common の
ChatCompletionRequest.from_openaiメソッドに渡される追加の引数。
戻り値
Union[str, list[int], list[str], list[list[int]], BatchEncoding]
これまでにトークン化されたチャット(制御トークンを含む)です。この出力は、モデルに直接渡すか、generate()などのメソッドを介して渡す準備ができています。
"role"キーと"content"キーを持つ辞書のリストを、トークンIDのリストに変換します。
batch_decode
< source >( sequences: typing.Union[list[int], list[list[int]], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
パラメータ
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — トークン化された入力 ID のリスト。__call__メソッドを使用して取得できます。 - skip_special_tokens (
bool、省略可、デフォルトはFalse) — デコーディング時に特殊トークンを除去するかどうかを指定します。 - clean_up_tokenization_spaces (
bool、任意) — トークン化のスペースを整理するかどうか。Noneの場合、self.clean_up_tokenization_spacesがデフォルトとして使用されます。 - kwargs(追加のキーワード引数、任意) —
MistralCommonBackend.batch_decodeではサポートされていません。使用するとエラーが発生します。
戻り値
list[str]
デコードされた文のリスト。
decode を呼び出して、トークン ID のリストのリストを文字列のリストに変換します。
このメソッドは後方互換性のために提供されています。decodeメソッドは現在、バッチ入力をネイティブで処理するため、batch_decodeの代わりにdecodeを直接使用できます。
build_inputs_with_special_tokens
< source >( token_ids_0: listtoken_ids_1: None = None ) → list[int]
特殊トークンを追加して、シーケンスからモデルの入力を構築します。
このメソッドは、トークナイザーのmodeに基づいて入力を動的に構築します。
"test": seq0 [EOS]"finetuning": [BOS] seq0
convert_added_tokens
< source >( obj: tokenizers.AddedToken | typing.Anysave: bool = Falseadd_type_field: bool = True )
MistralCommonBackend は、設計上 convert_added_tokens を実装していません。
この動作の実装を希望される場合は、Transformersまたはmistral-commonリポジトリでissueを作成してご依頼ください。
create_token_type_ids_from_sequences
< source >( token_ids_0: listtoken_ids_1: None = None ) → list[int]
…
Transformersの実装に合わせて維持されています。
decode
< source >( token_ids: typing.Union[int, list[int], list[list[int]], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → Union[str, list[str]]
パラメータ
- token_ids (
Union[int, list[int], list[list[int]], np.ndarray, torch.Tensor]) — トークン化された入力 ID の単一シーケンスまたはバッチ(シーケンスのリスト)です。__call__メソッドを使用して取得できます。 - skip_special_tokens (
bool、省略可、デフォルトはFalse) — デコーディング時に特殊トークンを除去するかどうかを指定します。 - clean_up_tokenization_spaces (
bool、任意) — トークン化のスペースを整理するかどうか。Noneの場合、self.clean_up_tokenization_spacesがデフォルトとして使用されます。 - kwargs(追加のキーワード引数、任意) —
MistralCommonBackend.decodeではサポートされていません。使用するとエラーが発生します。
戻り値
Union[str, list[str]]
単一のシーケンスに対するデコード済み文字列、またはシーケンスのバッチに対するデコード済み文字列のリスト。
トークナイザーと語彙を使用して、文字列内のIDのシーケンスを変換します。特殊トークンの削除や、トークン化スペースのクリーンアップなどのオプションが利用できます。
encode
< source >( text: str | list[int]text_pair: None = Noneadd_special_tokens: bool = Truepadding: bool | str | transformers.utils.generic.PaddingStrategy = Falsetruncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0pad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Noneverbose: bool = Truereturn_offsets_mapping: typing.Literal[False] = Falsesplit_special_tokens: typing.Literal[False] = False**kwargs ) → list[int], torch.Tensor
パラメータ
- text (
strまたはlist[int]) — エンコードする最初のシーケンスです。文字列または整数のリスト(トークン化された文字列 ID)を指定できます。 - text_pair (
None, 任意) —MistralCommonBackend.encodeではサポートされていません。PreTrainedTokenizerBase.encodeのシグネチャに合わせるために保持されています。 - add_special_tokens (
bool、省略可、デフォルトはTrue) — シーケンスをエンコードする際に特殊トークンを追加するかどうかを指定します。これは、入力 ID に自動的に追加されるトークンを定義するPretrainedTokenizerBase.build_inputs_with_special_tokens関数を使用します。bosやeosトークンを自動的に追加したい場合に便利です。Tokenizer がfinetuningモードで読み込まれる場合、bosとeosの両方が追加されます。それ以外の場合、つまり “test” モードでは、bosのみが追加されます。 - padding (
bool,strまたは PaddingStrategy, 省略可, デフォルトはFalse) — パディングの有効化と制御を行います。以下の値を受け入れます:Trueまたは'longest': バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。'max_length': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。Falseまたは'do_not_pad'(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
- truncation (
bool,strまたは TruncationStrategy, 省略可能, デフォルトはFalse) — 切り詰めを有効化し、制御します。以下の値を受け取ります:Trueまたは'longest_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れることのできる最大入力長まで切り詰めます。Falseまたは'do_not_truncate'(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
- max_length (
int, 省略可能) — truncation/padding パラメータのいずれかによって使用される最大長を制御します。未設定のまま、または
Noneに設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。 - stride (
int、省略可能、デフォルトは 0) —max_lengthとともに数値が設定されている場合、return_overflowing_tokens=Trueで返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複を確保します。この引数の値は、重複するトークンの数を定義します。 - pad_to_multiple_of (
int, 任意) — 設定すると、指定された値の倍数にシーケンスをパディングします。paddingが有効になっている必要があります。 これは、計算能力が>= 7.5(Volta) の NVIDIA ハードウェア上で Tensor Cores を使用可能にするために特に有用です。 - padding_side (
str, 省略可) — モデルにパディングを適用する側です。[‘right’, ‘left’] のいずれかを選択してください。 デフォルト値は、同名のクラス属性から取得されます。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。
- **kwargs —
MistralCommonBackend.encodeではサポートされていません。使用するとエラーが発生します。
戻り値
list[int], torch.Tensor
テキストのトークン化されたIDです。
トークナイザーと語彙を使用して、文字列をid(整数)のシーケンスに変換します。
from_pretrained
< source >( pretrained_model_name_or_path: str | os.PathLike*init_inputsmode: str | ValidationMode = 'test'cache_dir: str | os.PathLike | None = Noneforce_download: bool = Falselocal_files_only: bool = Falsetoken: str | bool | None = Nonerevision: str = 'main'model_max_length: int = 1000000000000000019884624838656padding_side: str = 'left'truncation_side: str = 'right'model_input_names: list[str] | None = Noneclean_up_tokenization_spaces: bool = False**kwargs )
パラメータ
- pretrained_model_name_or_path (
strまたはos.PathLike) — 以下のいずれかです:- huggingface.co上のモデルリポジトリにホストされている事前定義されたトークナイザーのmodel idを表す文字列。
- トークナイザー設定を含むディレクトリへのパスです。例えば、
MistralCommonBackend.tokenization_mistral_common.save_pretrainedメソッドを使用して保存されたもの、./my_model_directory/などです。
- mode (
Union[str, ValidationMode], 省略可, デフォルトはValidationMode.test) — の検証モードMistralTokenizer。指定可能な値は以下の通りです:"finetuning"またはValidationMode.finetuning: ファインチューニングモードです。"test"またはValidationMode.test: テストモードです。 トークナイザーが入力を検証し、モデルへのリクエストを準備する方法を変更します。
- cache_dir (
strまたはos.PathLike、省略可) — 標準のキャッシュを使用しない場合、ダウンロードされた事前定義されたトークナイザの語彙ファイルをキャッシュするディレクトリのパス。 - force_download (
bool、任意、デフォルトはFalse) — 語彙ファイルの(再)ダウンロードを強制し、キャッシュされたバージョンが存在する場合にそれを上書きするかどうかを指定します。 - token (
strまたは bool、省略可) — リモートファイルの HTTP ベアラ認証に使用するトークン。Trueの場合、hf auth loginを実行した際に生成されたトークン(~/.huggingfaceに保存)を使用します。 - local_files_only (
bool、省略可、デフォルトはFalse) — ローカルファイルのみを使用し、ファイルのダウンロードを試みないかどうかを指定します。 - revision (
str、任意、デフォルトは"main") — 使用する特定のモデルのバージョンです。huggingface.co 上でモデルやその他の成果物を保存するために git ベースのシステムを使用しているため、ブランチ名、タグ名、コミット ID のいずれかを指定できます。したがって、revisionには git で許可される任意の識別子を指定できます。 - max_length (
int, 省略可能) — truncation/padding パラメータのいずれかによって使用される最大長を制御します。未設定のまま、または
Noneに設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。 - padding_side (
str、任意、デフォルトは"left") — モデルにパディングを適用する側です。[‘right’, ‘left’] から選択してください。 デフォルト値は、同名のクラス属性から取得されます。 - truncation_side (
str、任意、デフォルトは"right") — モデルに切り詰めを適用する側です。[‘right’, ‘left’] から選択してください。 - model_input_names (
List[str]、省略可) — モデルの forward pass が受け入れる入力のリスト("token_type_ids"や"attention_mask"など)です。デフォルト値は、同名のクラス属性から選択されます。 - clean_up_tokenization_spaces (
bool、任意、デフォルトはFalse) — トークン化処理中にテキストを分割する際に追加されたスペースを、モデルがクリーンアップすべきかどうかを指定します。 - kwargs(追加のキーワード引数、任意) —
MistralCommonBackend.from_pretrainedではサポートされていません。使用するとエラーが発生します。
事前定義されたトークナイザーからMistralCommonBackendをインスタンス化します。
MistralCommonBackend は、mistral-common がチャットテンプレートを使用しないため、get_chat_template を実装していません。
get_special_tokens_mask
< source >( token_ids_0: listtoken_ids_1: None = Nonealready_has_special_tokens: bool = False ) → A list of integers in the range [0, 1]
特殊トークンが追加されていないトークンリストからシーケンスIDを取得します。このメソッドは、トークナイザーのprepare_for_modelまたはencode_plusメソッドを使用して特殊トークンを追加する際に呼び出されます。
トークンからインデックスへの辞書として語彙を返します。
これは有損変換です。部分的な UTF-8 バイトシーケンスが � に変換されるため、同じ文字列にデコードされるトークン ID が複数存在する可能性があります。
num_special_tokens_to_add
< source >( pair: typing.Literal[False] = False ) → int
特殊トークン付きでシーケンスをエンコードする際に追加されるトークンの数を返します。
これはダミー入力をエンコードし、追加されたトークンの数をチェックするため、効率的ではありません。この処理をトレーニングループ内に配置しないでください。
prepare_for_model
< source >( ids: listpair_ids: None = Noneadd_special_tokens: bool = Truepadding: bool | str | transformers.utils.generic.PaddingStrategy = Falsetruncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0pad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_length: bool = Falseverbose: bool = Trueprepend_batch_axis: bool = Falsereturn_offsets_mapping: typing.Literal[False] = Falsesplit_special_tokens: typing.Literal[False] = False**kwargs ) → BatchEncoding
パラメータ
- ids (
list[int]) — 最初のシーケンスのトークン化された入力 ID です。 - pair_ids (
None、任意) —MistralCommonBackendではサポートされていません。PreTrainedTokenizerBaseのインターフェースと一致させるために保持されています。 - add_special_tokens (
bool、省略可、デフォルトはTrue) — シーケンスをエンコードする際に特殊トークンを追加するかどうかを指定します。これは、入力 ID に自動的に追加されるトークンを定義するPretrainedTokenizerBase.build_inputs_with_special_tokens関数を使用します。bosやeosトークンを自動的に追加したい場合に便利です。Tokenizer がfinetuningモードで読み込まれる場合、bosとeosの両方が追加されます。それ以外の場合、つまり “test” モードでは、bosのみが追加されます。 - padding (
bool,strまたは PaddingStrategy, 省略可, デフォルトはFalse) — パディングの有効化と制御を行います。以下の値を受け入れます:Trueまたは'longest': バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。'max_length': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。Falseまたは'do_not_pad'(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
- truncation (
bool,strまたは TruncationStrategy, 省略可能, デフォルトはFalse) — 切り詰めを有効化し、制御します。以下の値を受け取ります:Trueまたは'longest_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れることのできる最大入力長まで切り詰めます。Falseまたは'do_not_truncate'(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
- max_length (
int, 省略可能) — truncation/padding パラメータのいずれかによって使用される最大長を制御します。未設定のまま、または
Noneに設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。 - stride (
int、省略可能、デフォルトは 0) —max_lengthとともに数値が設定されている場合、return_overflowing_tokens=Trueで返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複を確保します。この引数の値は、重複するトークンの数を定義します。 - pad_to_multiple_of (
int, 任意) — 設定すると、指定された値の倍数にシーケンスをパディングします。paddingが有効になっている必要があります。 これは、計算能力が>= 7.5(Volta) の NVIDIA ハードウェア上で Tensor Cores を使用可能にするために特に有用です。 - padding_side (
str, 省略可) — モデルにパディングを適用する側です。[‘right’, ‘left’] のいずれかを選択してください。 デフォルト値は、同名のクラス属性から取得されます。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。
- return_token_type_ids (
bool, 省略可能) — トークンタイプIDを返すかどうか。MistralCommonBackendでは、シーケンス長分のゼロのリストを返します。1つのシーケンスのみサポートされるためです。 - return_attention_mask (
bool, 省略可能) — attention mask を返すかどうか。デフォルトのままにすると、return_outputs属性によって定義される、特定の tokenizer のデフォルトに従って attention mask を返します。 - return_overflowing_tokens (
bool、任意、デフォルトはFalse) — 溢れ出したトークンシーケンスを返すかどうかを指定します。入力 ID のシーケンスのペア(またはペアのバッチ)がtruncation_strategy = longest_firstまたはTrueとともに提供された場合、溢れ出したトークンを返す代わりにエラーが発生します。 - return_special_tokens_mask (
bool、省略可能、デフォルトはFalse) — 特殊トークンのマスク情報を返すかどうかを指定します。 - return_length (
bool、任意、デフォルトはFalse) — エンコードされた入力の長さを返すかどうかを指定します。 - verbose (
bool、任意、デフォルトはTrue) — より多くの情報や警告を表示するかどうかを指定します。 - return_offsets_mapping (
Literal[False]、省略可能) — Transformers のシグネチャに合わせるため、False に固定されています。 - split_special_tokens (
Literal[False]、省略可) — Transformers のシグネチャに合わせるため、False に固定されています。 - **kwargs —
self.tokenize()メソッドに渡されます
戻り値
以下のフィールドを持つBatchEncoding:
-
input_ids — モデルに与えるトークン ID のリスト。
-
attention_mask — モデルがどのトークンに注意を向けるべきかを指定するインデックスのリスト(
return_attention_mask=Trueの場合、またはself.model_input_namesに “attention_mask” が含まれている場合)。 -
overflowing_tokens — 溢れ出したトークンシーケンスのリスト(
max_lengthが指定され、return_overflowing_tokens=Trueの場合)。 -
num_truncated_tokens — トークンが切り詰められた数(
max_lengthが指定され、return_overflowing_tokens=Trueの場合)。 -
special_tokens_mask — 0 と 1 のリスト。1 は追加された特殊トークンを、0 は通常のシーケンストークンを示します(
add_special_tokens=Trueかつreturn_special_tokens_mask=Trueの場合)。 -
length — 入力データの長さ(
return_length=Trueの場合)
モデルで使用できるように、入力 ID のシーケンスを準備します。特殊トークンを追加し、特殊トークンを考慮しながら、オーバーフローが発生した場合はシーケンスを切り詰めます。また、オーバーフローしたトークンに対して、ユーザーが定義したストライド付きの移動ウィンドウを管理します。
save_chat_templates
< source >( save_directory: str | os.PathLiketokenizer_config: dictfilename_prefix: str | Nonesave_jinja_files: bool )
MistralCommonBackend は、mistral-common がチャットテンプレートを使用しないため、save_chat_templates を実装していません。
save_pretrained
< source >( save_directory: str | os.PathLike | pathlib.Pathpush_to_hub: bool = Falsetoken: str | bool | None = Nonecommit_message: str | None = Nonerepo_id: str | None = Noneprivate: bool | None = Nonesave_format: str | None = None**kwargs ) → tuple[str, ...]
パラメータ
- save_directory (
str | os.PathLike | Path) — トークナイザーを保存するディレクトリ。 - push_to_hub (
bool、任意、デフォルトはFalse) — 保存後に HF Hub にプッシュします。 - token (
strまたはbool、省略可) — Hub 認証用のトークン。 - commit_message (
str, 任意) — プッシュ時のコミットメッセージ。 - repo_id (
str, 省略可) — Hub リポジトリの ID。 - private (
bool、任意) — リポジトリがプライベートかどうかを示します。 - save_format (
str, 省略可) —"mistral"を指定するとネイティブの tekken 形式で保存し、"hf"を指定すると HuggingFace 形式で保存します。 None の場合は元の形式を保持します。 - kwargs (
dict、省略可) — サポートされていません。エラーが発生します。
戻り値
tuple[str, ...]
保存されたファイルのパス。
トークナイザーの完全な状態を保存します。
save_format が "mistral"(tekken トークナイザーの場合は None)の場合、元のトークナイザーファイル(例: tekken.json)が save_directory に書き込まれます。 save_format が "hf" の場合、代わりに HF 形式のファイル(tokenizer.json + tokenizer_config.json)が生成されます。
MistralCommonBackend は、設計上 save_vocabulary を実装していません。
これは、mistral-commonが1つのトークナイザーファイルで構成されているためです。語彙を保存したい場合は、代わりにsave_pretrainedメソッドの使用をご検討ください。
tokenize
< source >( text: strreturn_offsets_mapping: typing.Literal[False] = Falsesplit_special_tokens: typing.Literal[False] = False**kwargs ) → list[str]
パラメータ
- text (
str) — エンコード対象のシーケンス。 - return_offsets_mapping (
Literal[False]、省略可能) — Transformers のシグネチャに合わせるため、False に固定されています。 - split_special_tokens (
Literal[False]、省略可) — Transformers のシグネチャに合わせるため、False に固定されています。 - **kwargs (追加のキーワード引数) —
MistralCommonBackend.tokenizeではサポートされていません。使用するとエラーが発生します。
戻り値
list[str]
トークンのリスト。
トークナイザーを使用して、文字列をトークンのシーケンスに変換します。
単語ベースの語彙の場合は単語に、サブワードベースの語彙の場合はサブワードに分割します。
truncate_sequences
< source >( ids: listpair_ids: None = Nonenum_tokens_to_remove: int = 0truncation_strategy: str | transformers.tokenization_utils_base.TruncationStrategy = 'longest_first'stride: int = 0**kwargs ) → Tuple[list[int], None, list[int]]
パラメータ
- ids (
list[int]) — トークン化された入力 ID です。tokenizeメソッドとconvert_tokens_to_idsメソッドをチェーンすることで、文字列から取得できます。 - pair_ids (
None、任意) —MistralCommonBackendではサポートされていません。PreTrainedTokenizerBase.truncate_sequencesのシグネチャと一致させるために保持されています。 - num_tokens_to_remove (
int、任意、デフォルトは 0) — 切り詰め戦略を使用して削除するトークンの数。 - truncation_strategy (
strまたは TruncationStrategy, 省略可, デフォルトは'longest_first') — 切り詰め (truncation) に適用する戦略です。以下のいずれかを指定できます:'longest_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れることのできる最大入力長まで切り詰めます。'do_not_truncate'(デフォルト):切り詰めを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
- stride (
int、省略可能、デフォルトは 0) — 正の値に設定すると、返されるオーバーフローのトークンには、返されるメインシーケンスの一部のトークンも含まれます。この引数の値は、追加されるトークンの数を定義します。
戻り値
Tuple[list[int], None, list[int]]
切り詰められたidsと、オーバーフローしたトークンのリスト。Noneが返され、Transformersのシグネチャに一致します。
シーケンスのペアを、戦略に従ってインプレースで切り詰めます。
MixtralModel
クラス transformers.MixtralModel
< source >( config: MixtralConfig )
パラメータ
- config (MixtralConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せずに、生のhidden-statesを出力する素のMixtral Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
MoeModelOutputWithPast または tuple(torch.FloatTensor)
MoeModelOutputWithPast または、torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(MixtralConfig)や入力に応じて、さまざまな要素で構成されます。
MixtralModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
router_logits (
tuple(torch.FloatTensor)、optional、output_router_probs=Trueとconfig.add_router_probs=Trueが渡された場合、またはconfig.output_router_probs=Trueの場合に返されます) — 各層ごとに1つずつ含まれるtorch.FloatTensorのタプルで、形状は(batch_size, sequence_length, num_experts)です。MoE ルーターによって計算される生(raw)のルーター logits(softmax 適用後)であり、Mixture of Experts モデルの補助損失を計算するためにこれらの用語が使用されます。
MixtralForCausalLM
クラス transformers.MixtralForCausalLM
< source >( config: MixtralConfig )
パラメータ
- config (MixtralConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
因果言語モデリング用の Mixtral モデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Noneoutput_router_logits: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[0, ..., config.vocab_size]の範囲内であるか、-100 である必要があります(input_idsの docstring を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲内のラベルを持つトークンに対してのみ計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - output_router_logits (
bool, 省略可) — すべてのルーターの logits を返すかどうか。ルーター損失の計算に有用ですが、推論時には返すべきではありません。 - logits_to_keep (
Union[int, torch.Tensor]、省略可、デフォルトは0) —intの場合、最後のlogits_to_keepトークンについて logits を計算します。0の場合、すべてのinput_idsについて logits を計算します(特殊ケース)。生成には最後のトークンの logits だけで十分であり、そのトークンのみについて計算することでメモリを節約できます。これは、長いシーケンスや大規模な語彙サイズの場合に特に顕著な効果があります。torch.Tensorの場合、シーケンス長次元で保持するインデックスに対応する 1 次元テンソルである必要があります。これは、パックされたテンソル形式(バッチとシーケンス長を単一の次元にまとめた形式)を使用する場合に有用です。
戻り値
MoeCausalLMOutputWithPast または tuple(torch.FloatTensor)
MoeCausalLMOutputWithPast、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(MixtralConfig)や入力に応じて、さまざまな要素で構成されます。
MixtralForCausalLM の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 言語モデリングの損失(次のトークン予測用)。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。aux_loss (
torch.FloatTensor、optional、output_router_logits=Trueが渡された場合、またはconfig.output_router_logits=Trueの場合、かつモデルがロードバランシング損失でルーターを学習する場合に返されます) — スパースモジュールのロードバランシング用の補助損失。ルーターバイアスによってエキスパートをバランスさせるモデル(DeepSeek-V3 とそこから派生したアーキテクチャ)は、router_logitsを返しながらも、ここではNoneを返します。router_logits (
tuple(torch.FloatTensor)、任意、output_router_logits=Trueが渡された場合またはconfig.output_router_logits=Trueの場合に返されます) — 各スパース層に対応するtorch.FloatTensorのタプルで、形状は(batch_size * sequence_length, num_experts)です。MoEルーターによって計算される生のルーターロジットです。ロードバランシング損失の計算や、トークンがどのようにエキスパートにディスパッチされるかの確認に使用できます。
past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。逐次デコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, MixtralForCausalLM

>>> model = MixtralForCausalLM.from_pretrained("mistralai/Mixtral-8x7B-v0.1")
>>> tokenizer = AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-v0.1")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."
MixtralForSequenceClassification
forward
< source >( input_ids: torch.LongTensor | None = Noneattention_mask: torch.Tensor | None = Noneposition_ids: torch.LongTensor | None = Nonepast_key_values: Cache | None = Noneinputs_embeds: torch.FloatTensor | None = Nonelabels: torch.LongTensor | None = Noneuse_cache: bool | None = None**kwargs: Unpack[TransformersKwargs] ) → SequenceClassifierOutputWithPast
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — シーケンス分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
SequenceClassifierOutputWithPast
GenericForSequenceClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
MixtralForTokenClassification
forward
< source >( input_ids: torch.LongTensor | None = Noneattention_mask: torch.Tensor | None = Noneposition_ids: torch.LongTensor | None = Nonepast_key_values: Cache | None = Noneinputs_embeds: torch.FloatTensor | None = Nonelabels: torch.LongTensor | None = Noneuse_cache: bool | None = None**kwargs: Unpack[TransformersKwargs] ) → TokenClassifierOutput
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、形状(batch_size, sequence_length)、任意) — トークン分類の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
TokenClassifierOutput
GenericForTokenClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
MixtralForQuestionAnswering
forward
< source >( input_ids: torch.LongTensor | None = Noneattention_mask: torch.Tensor | None = Noneposition_ids: torch.LongTensor | None = Nonepast_key_values: Cache | None = Noneinputs_embeds: torch.FloatTensor | None = Nonestart_positions: torch.LongTensor | None = Noneend_positions: torch.LongTensor | None = None**kwargs: Unpack[TransformersKwargs] ) → QuestionAnsweringModelOutput
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - past_key_values (
Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - start_positions (
torch.LongTensor、shape(batch_size,)、任意) — トークン分類損失の計算に使用する、ラベル付きスパンの開始位置(インデックス)のラベルです。 位置はシーケンスの長さ(sequence_length)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。 - end_positions (
torch.LongTensor、形状(batch_size,)、任意) — トークン分類損失の計算に使用する、ラベル付きスパンの終了位置(インデックス)のラベルです。 位置はシーケンスの長さ(sequence_length)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。
戻り値
QuestionAnsweringModelOutput
GenericForQuestionAnsweringのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。