
Transformers documentation
GPT-NeoX
このモデルは2022年4月14日にHF papersで公開され、2022年5月24日にHugging Face Transformersに貢献されました。
GPT-NeoX

概要
GPT-NeoX-20Bは、Pileで学習された200億パラメータの自己回帰型言語モデルであり、その重みは寛容なライセンスの下で一般に自由かつ公開的に提供されます。私たちの知る限り、提出時点において、公開されている重みを備えた最大の密な自己回帰型モデルです。本稿では、GPT-NeoX-20Bのアーキテクチャと学習について説明し、言語理解、数学、知識ベースのタスクにおける性能を評価します。その結果、GPT-NeoX-20Bは特に強力なファウショット推論者であり、同規模のGPT-3やFairSeqモデルと比較して、ファイブショットで評価した場合に大幅な性能向上が見られることがわかりました。学習および評価コード、ならびにモデルの重みをhttps://github.com/EleutherAI/gpt-neoxでオープンソース化しています。
モデルの開発はSid Black、Stella Biderman、Eric Hallahanが主導し、CoreWeaveの多大なご支援のもとでモデルが学習されました。
GPT-NeoX-20B は fp16 で学習されているため、モデルは次のように初期化することをお勧めします:
model = GPTNeoXForCausalLM.from_pretrained("EleutherAI/gpt-neox-20b", device_map="auto")GPT-NeoX-20B は、GPT-J-6B や GPT-Neo で使用されているものとは異なるトークナイザーを備えています。新しいトークナイザーは空白文字に追加のトークンを割り当てるため、コード生成などの特定のタスクに対してモデルがより適したものになります。
使用例
generate() メソッドは、GPT Neo モデルを使用してテキストを生成するために使用できます。
from transformers import GPTNeoXForCausalLM, GPTNeoXTokenizerFast


model = GPTNeoXForCausalLM.from_pretrained("EleutherAI/gpt-neox-20b", device_map="auto")
tokenizer = GPTNeoXTokenizerFast.from_pretrained("EleutherAI/gpt-neox-20b")

prompt = "GPTNeoX20B is a 20B-parameter autoregressive Transformer model developed by EleutherAI."

input_ids = tokenizer(prompt, return_tensors="pt").to(model.device).input_ids

gen_tokens = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.9,
    max_length=100,
)
gen_text = tokenizer.batch_decode(gen_tokens)[0]
Flash Attention 2 の使用
Flash Attention 2 は、モデルのより高速で最適化されたバージョンです。
インストール
まず、お使いのハードウェアが Flash Attention 2 と互換性があるかどうかを確認してください。互換性のあるハードウェアの最新リストは、公式ドキュメントで確認できます。
次に、Flash Attention 2 の最新バージョンをインストールします:
pip install -U flash-attn --no-build-isolation
使用方法
Flash Attention 2 を使用してモデルを読み込むには、from_pretrained() に引数 attn_implementation="flash_attention_2" を渡します。また、音声品質への劣化はほぼないものの、メモリ使用量が大幅に削減され、推論が高速になるため、モデルは半精度(例: torch.float16)で読み込みます。
from transformers import GPTNeoXForCausalLM


model = GPTNeoXForCausalLM.from_pretrained("EleutherAI/gpt-neox-20b", attn_implementation="flash_attention_2", device_map="auto")
...
期待される高速化
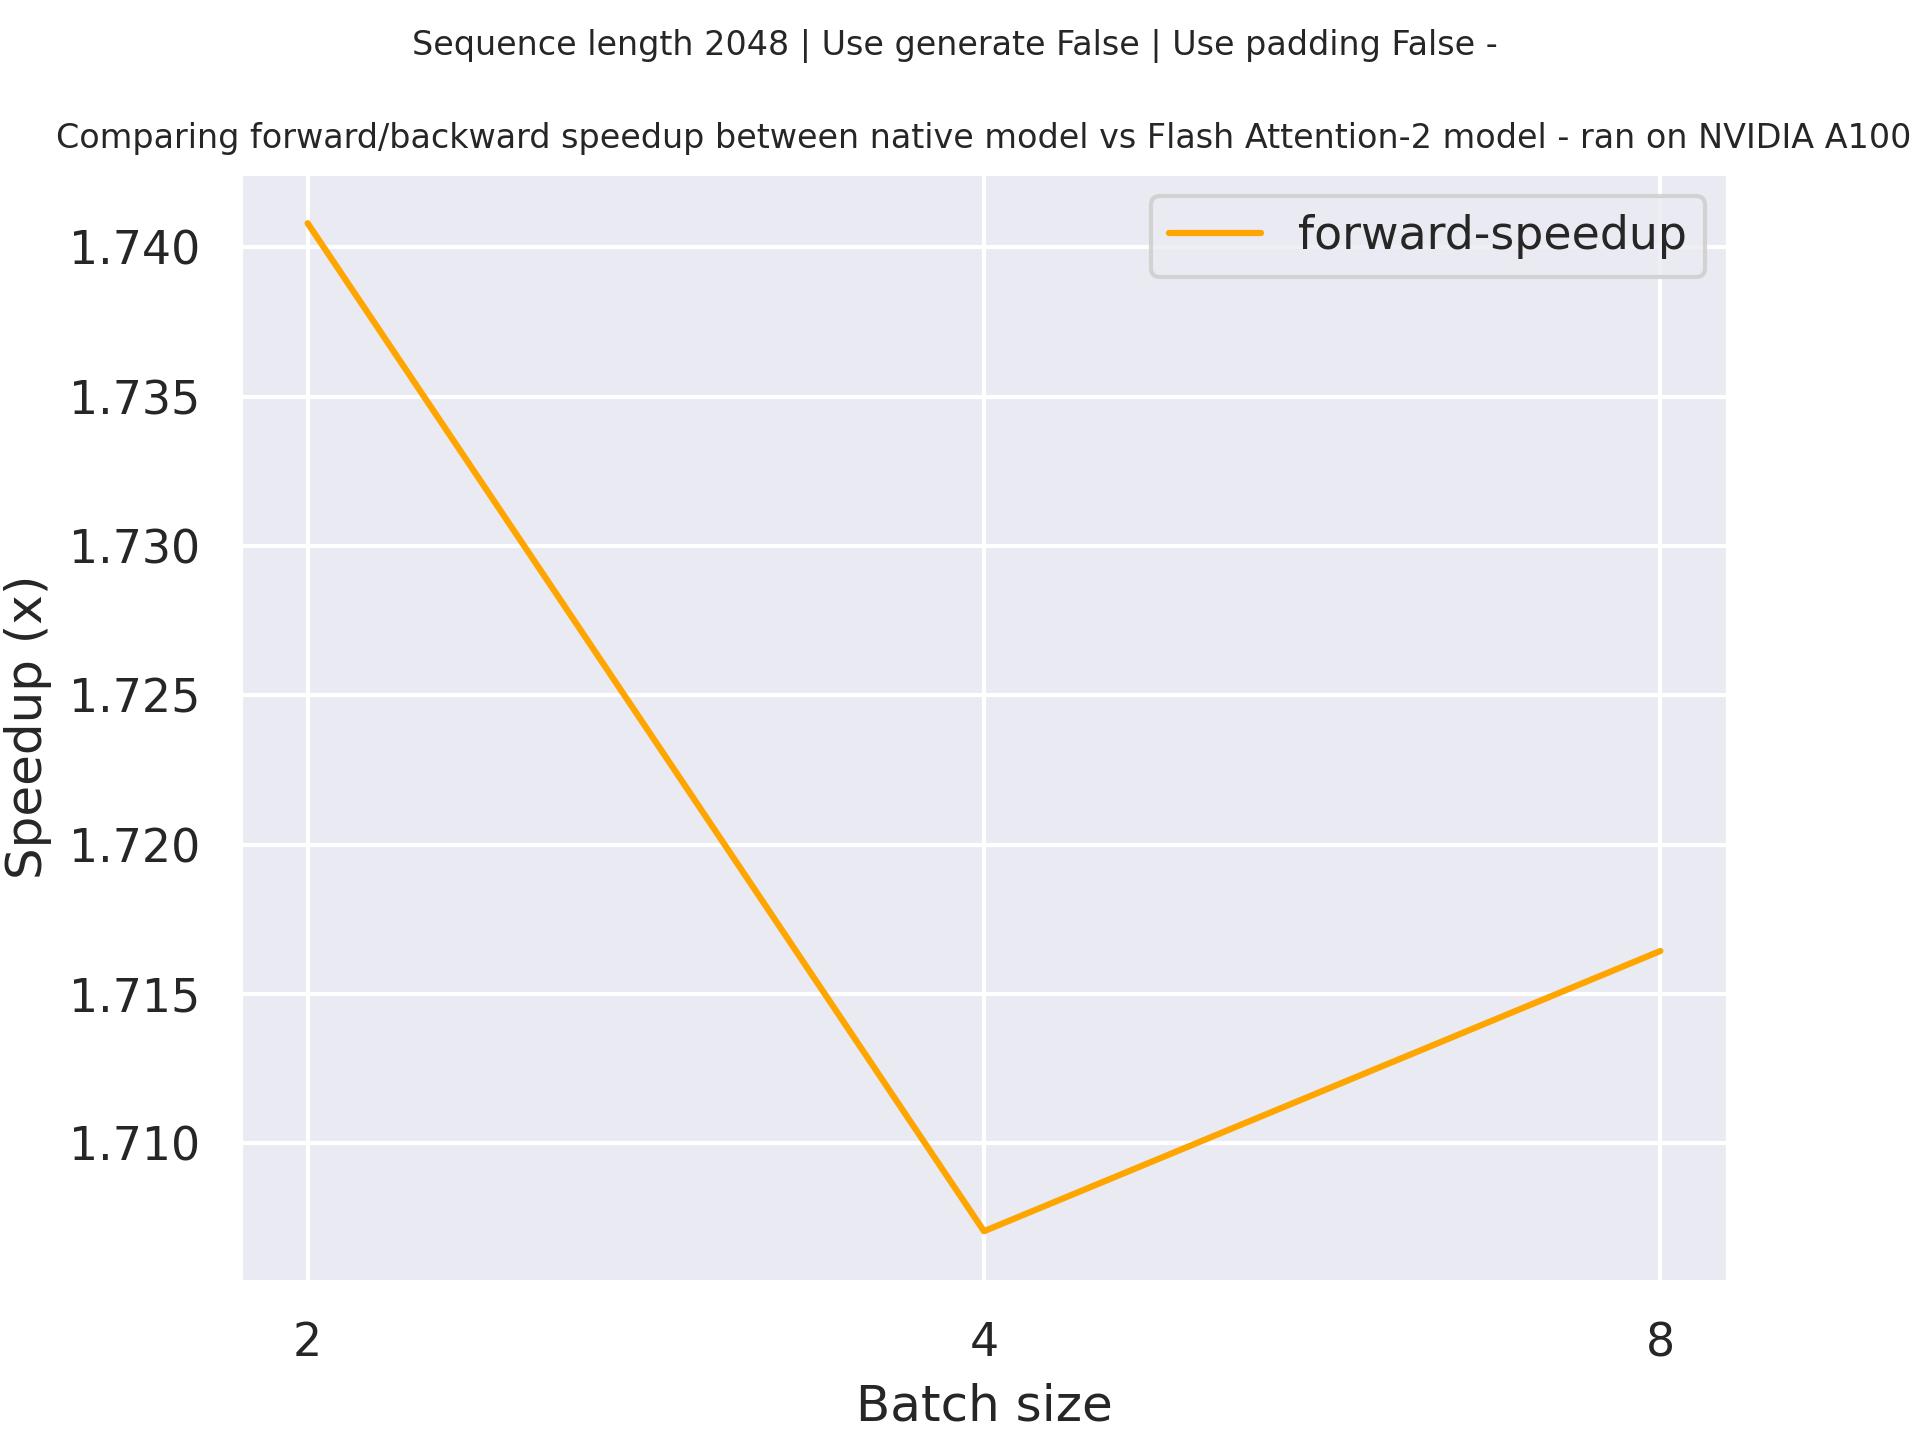
以下は、stockmark/gpt-neox-japanese-1.4b チェックポイントを使用する transformers のネイティブ実装と、シーケンス長 2048 でモデルの Flash Attention 2 バージョンを比較した、期待される高速化の図です。
Scaled Dot Product Attention (SDPA) の使用
PyTorchには、torch.nn.functionalの一部として、ネイティブのスケーリングドットプロダクトアテンション(SDPA)オペレーターが含まれています。この関数は、入力や使用しているハードウェアに応じて適用できる複数の実装を備えています。詳細については、公式ドキュメントまたはGPU推論ページを参照してください。
torch>=2.1.1 の場合、実装が利用可能な場合はデフォルトで SDPA が使用されますが、from_pretrained() で attn_implementation="sdpa" を設定することで、SDPA の使用を明示的に指定することもできます。
from transformers import GPTNeoXForCausalLM


model = GPTNeoXForCausalLM.from_pretrained("EleutherAI/gpt-neox-20b", attn_implementation="sdpa", device_map="auto")
...
最大限の高速化を実現するには、モデルを半精度(例: torch.float16 または torch.bfloat16)で読み込むことをお勧めします。
ローカル環境(rtx3080ti-16GB、PyTorch 2.2.1、OS Ubuntu 22.04)でfloat16を使用し、pythia-410m-dedupedを用いたベンチマークでは、トレーニングおよび推論時に以下の高速化を確認しました。
トレーニング
| バッチサイズ | シーケンス長 | バッチあたりの時間 (Eager - 秒) | バッチあたりの時間 (SDPA - s) | 高速化率 (%) | Eager ピークメモリ (MB) | SDPA ピークメモリ (MB) | メモリ削減率(%) |
|---|---|---|---|---|---|---|---|
| 1 | 128 | 0.024 | 0.019 | 28.945 | 1789.95 | 1789.95 | 0 |
| 1 | 256 | 0.039 | 0.031 | 23.18 | 1845.83 | 1844.84 | 0.053 |
| 1 | 512 | 0.08 | 0.055 | 45.524 | 2278.38 | 1953.76 | 16.615 |
| 1 | 1024 | 0.19 | 0.102 | 86.777 | 4772.36 | 2408.35 | 98.159 |
| 1 | 2048 | 0.565 | 0.204 | 177.098 | 13484.1 | 3882.01 | 247.348 |
| 2 | 128 | 0.037 | 0.032 | 15.121 | 1843.86 | 1844.78 | -0.05 |
| 2 | 256 | 0.067 | 0.055 | 21.706 | 1999.72 | 1951.67 | 2.462 |
| 2 | 512 | 0.144 | 0.096 | 50.046 | 3613.16 | 2406.77 | 50.125 |
| 2 | 1024 | 0.366 | 0.193 | 89.666 | 8707.55 | 3878.86 | 124.487 |
| 2 | 2048 | OOM | 0.379 | / | OOM | 6825.13 | SDPAはOOMになりません |
| 4 | 128 | 0.06 | 0.054 | 11.539 | 1947.6 | 1952.06 | -0.228 |
| 4 | 256 | 0.119 | 0.093 | 28.072 | 3008.39 | 2405.99 | 25.038 |
| 4 | 512 | 0.275 | 0.187 | 47.145 | 6290.58 | 3877.29 | 62.242 |
| 4 | 1024 | OOM | 0.36 | / | OOM | 6821.98 | SDPAはOOMになりません |
| 4 | 2048 | OOM | 0.731 | / | OOM | 12705.1 | SDPAはOOMになりません |
推論
| バッチサイズ | シーケンス長 | トークンごとのレイテンシー Eager (ms) | トークンごとのレイテンシー SDPA (ms) | 高速化率 (%) | Mem Eager (MB) | Mem SDPA (MB) | メモリ削減率 (%) |
|---|---|---|---|---|---|---|---|
| 1 | 128 | 6.569 | 5.858 | 12.14 | 974.831 | 974.826 | 0 |
| 1 | 256 | 7.009 | 5.863 | 19.542 | 1029.01 | 1028.08 | 0.09 |
| 1 | 512 | 7.157 | 5.965 | 19.983 | 1137.54 | 1137.52 | 0.001 |
| 1 | 1024 | 7.523 | 6.506 | 15.637 | 1329.3 | 1329.26 | 0.003 |
| 1 | 2048 | 9.271 | 9.205 | 0.713 | 1752.47 | 1734.51 | 1.036 |
| 2 | 128 | 7.239 | 5.959 | 21.493 | 1044.8 | 1028.37 | 1.597 |
| 2 | 256 | 7.228 | 6.036 | 19.757 | 1167.32 | 1137.73 | 2.601 |
| 2 | 512 | 7.538 | 6.693 | 12.628 | 1352.93 | 1329.55 | 1.758 |
| 2 | 1024 | 8.916 | 8.632 | 3.291 | 1752.56 | 1734.62 | 1.034 |
| 2 | 2048 | 12.628 | 12.606 | 0.181 | 2558.72 | 2545.8 | 0.508 |
| 4 | 128 | 7.278 | 6.046 | 20.373 | 1168.41 | 1137.79 | 2.691 |
| 4 | 256 | 7.614 | 6.588 | 15.574 | 1353.1 | 1329.79 | 1.753 |
| 4 | 512 | 8.798 | 8.144 | 8.028 | 1752.76 | 1734.85 | 1.032 |
| 4 | 1024 | 11.765 | 11.303 | 4.09 | 2558.96 | 2546.04 | 0.508 |
| 4 | 2048 | 19.568 | 17.735 | 10.33 | 4175.5 | 4165.26 | 0.246 |
リソース
GPTNeoXConfig
クラス transformers.GPTNeoXConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 50432hidden_size: int = 6144num_hidden_layers: int = 44num_attention_heads: int = 64intermediate_size: int = 24576hidden_act: str = 'gelu'attention_dropout: float | int = 0.0hidden_dropout: float | int = 0.0classifier_dropout: float | int = 0.1max_position_embeddings: int = 2048initializer_range: float = 0.02layer_norm_eps: float = 1e-05use_cache: bool = Truebos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2pad_token_id: int | None = Nonetie_word_embeddings: bool = Falseuse_parallel_residual: bool = Truerope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneattention_bias: bool = Trueis_decoder: bool = False )
パラメータ
- vocab_size (
int、任意、デフォルトは50432) — モデルの語彙サイズです。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは6144) — 隠れ表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは44) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは64) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - intermediate_size (
int、任意、デフォルトは24576) — MLP 表現の次元数。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - hidden_dropout (
Union[float, int]、任意、デフォルト値は0.0) — embeddings、encoder、pooler 内のすべての全結合層における dropout 確率です。 - classifier_dropout (
Union[float, int]、省略可、デフォルトは0.1) — 分類器の dropout 率です。 - max_position_embeddings (
int、任意、デフォルトは2048) — このモデルが使用される可能性のある最大シーケンス長です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - use_cache (
bool、任意、デフォルトはTrue) — モデルが最後のキー/バリューの注意を返すかどうか(すべてのモデルで利用されるわけではありません)。config.is_decoder=Trueの場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。 - bos_token_id (
int、任意、デフォルトは0) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]]、任意、デフォルトは2) — 語彙内でストリーム終了に使用されるトークン ID。 - pad_token_id (
int, 任意) — 語彙内でパディングに使用されるトークン ID。 - tie_word_embeddings (
bool、任意、デフォルトはFalse) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。 - use_parallel_residual (
bool、任意、デフォルトはTrue) — 各 Transformer レイヤーで「並列」な定式化を使用するかどうか。大規模モデル(例: 20B)では、わずかな訓練速度の向上が期待できます。 - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], 省略可) — RoPE 埋め込みの設定パラメータを含む辞書です。この辞書にはrope_thetaの値が含まれており、より長いmax_position_embeddingsで RoPE を使用する場合にスケーリングに使用されるパラメータが任意で含まれます。 - attention_bias (
bool、任意、デフォルトはTrue) — 自己注意機構において、クエリ、キー、バリュー、および出力の投影層にバイアスを使用するかどうかを指定します。 - is_decoder (
bool、任意、デフォルトはFalse) — モデルがデコーダーとして使用されるかどうかを示します。Falseの場合、モデルはエンコーダーとして使用されます。
これはGPTNeoXModelの設定を保存するための設定クラスです。指定された引数に基づいてGpt Neoxモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、EleutherAI/gpt-neox-20bと類似した設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import GPTNeoXConfig, GPTNeoXModel

>>> # Initializing a GPTNeoX gpt-neox-20b style configuration
>>> configuration = GPTNeoXConfig()

>>> # Initializing a model (with random weights) from the gpt-neox-20b style configuration
>>> model = GPTNeoXModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
GPTNeoXTokenizer
クラス transformers.GPTNeoXTokenizer
< source >( vocab: str | dict[str, int] | None = Nonemerges: str | list[str] | None = Noneerrors: str = 'replace'unk_token: str = '<|endoftext|>'bos_token: str = '<|endoftext|>'eos_token: str = '<|endoftext|>'pad_token: str = '<|padding|>'add_prefix_space: bool = Falsetrim_offsets: bool = True**kwargs )
パラメータ
- vocab_file (
str, 任意) — 語彙ファイルへのパス。 - merges_file (
str, 省略可) — merges ファイルへのパス。 - tokenizer_file (
str, 省略可) — トークナイザーのシリアライズを含む tokenizers JSON ファイルへのパス。 - errors (
str、省略可能、デフォルトは"replace") — バイト列を UTF-8 にデコードする際に従うパラダイム。詳細は bytes.decode を参照してください。 - unk_token (
str、任意、デフォルトは"<|endoftext|>") — 不明トークンです。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。 - bos_token (
str, 任意、デフォルトは"<|endoftext|>") — シーケンスの開始トークンです。 - eos_token (
str, 任意、デフォルトは"<|endoftext|>") — シーケンスの終了トークンです。 - pad_token (
str、任意、デフォルトは"<|padding|>") — シーケンスのパディングに使用するトークンです。 - add_prefix_space (
bool、任意、デフォルトはFalse) — 入力に先頭スペースを追加するかどうか。これにより、先頭の単語を他の単語と同様に扱うことができます。(GPTNeoX トークナイザーは、先行するスペースによって単語の開始を検出します)。 - add_bos_token (
bool、省略可能、デフォルトはFalse) — シーケンスの先頭にbos_tokenを追加するかどうか。 - add_eos_token (
bool、任意、デフォルトはFalse) — シーケンスの末尾にeos_tokenを追加するかどうか。 - trim_offsets (
bool、省略可、デフォルトはTrue) — 後処理ステップでオフセットをトリムし、空白文字が含まれないようにするかどうかを指定します。 - vocab (
strまたはdict[str, int]、省略可) — カスタム語彙辞書です。指定しない場合、vocab_fileから語彙が読み込まれます。 - merges (
strまたはlist[str]、省略可) — カスタムマージリスト。指定しない場合、merges_fileからマージが読み込まれます。
GPT-NeoX-20Bのトークナイザーを構築します(HuggingFaceのtokenizersライブラリをバックエンドとして使用)。バイトレベルのByte-Pair-Encodingに基づいています。
このトークナイザーは、スペースをトークンの一部として扱うように学習されています(sentencepieceに少し似ています)。そのため、単語は
文の先頭(スペースなし)にある場合と、そうでない場合とで、エンコードの仕方が異なります。
>>> from transformers import GPTNeoXTokenizer

>>> tokenizer = GPTNeoXTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
>>> tokenizer("Hello world")["input_ids"]
[15496, 995]

>>> tokenizer(" Hello world")["input_ids"]
[18435, 995]この動作を回避するには、このトークナイザーをインスタンス化する際にadd_prefix_space=Trueを渡すことができますが、モデルはこの方式で事前学習されていないため、パフォーマンスが低下する可能性があります。
is_split_into_words=Trueと併用する場合、このトークナイザーはadd_prefix_space=Trueを指定してインスタンス化する必要があります。
このトークナイザーは、主要なメソッドの大部分を含む TokenizersBackend を継承しています。これらのメソッドに関する詳細については、このスーパークラスを参照してください。
GPTNeoXModel
クラス transformers.GPTNeoXModel
< source >( config: GPTNeoXConfig )
パラメータ
- config (GPTNeoXConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Gpt Neox Modelは、特定のヘッドを上に配置せずに生のhidden-statesを出力する、素のモデルです。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
BaseModelOutputWithPast または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または BaseModelOutputWithPast。設定(GPTNeoXConfig)や入力に応じて、さまざまな要素で構成されます。
GPTNeoXModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_valuesが使用されている場合、出力されるのは、形状(batch_size, 1, hidden_size)のシーケンスの最後の隠れ状態のみです。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
GPTNeoXForCausalLM
クラス transformers.GPTNeoXForCausalLM
< source >( config: GPTNeoXConfig )
パラメータ
- config (GPTNeoXConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
CLMファインチューニング用に、language modelingヘッドを上部に備えたGPTNeoXモデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CausalLMOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — 左から右への言語モデリング損失(次の単語の予測)を計算するためのラベルです。インデックスは[-100, 0, ..., config.vocab_size]の範囲である必要があります(input_idsの docstring を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲のラベルを持つトークンに対してのみ計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - logits_to_keep (
Union[int, torch.Tensor]、省略可、デフォルトは0) —intの場合、最後のlogits_to_keepトークンについて logits を計算します。0の場合、すべてのinput_idsについて logits を計算します(特殊ケース)。生成には最後のトークンの logits だけで十分であり、そのトークンのみについて計算することでメモリを節約できます。これは、長いシーケンスや大規模な語彙サイズの場合に特に顕著な効果があります。torch.Tensorの場合、シーケンス長次元で保持するインデックスに対応する 1 次元テンソルである必要があります。これは、パックされたテンソル形式(バッチとシーケンス長を単一の次元にまとめた形式)を使用する場合に有用です。
戻り値
CausalLMOutputWithPast または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または CausalLMOutputWithPast。設定(GPTNeoXConfig)や入力に応じて、さまざまな要素で構成されます。
GPTNeoXForCausalLM の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 言語モデリングの損失(次のトークン予測用)。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。逐次デコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, GPTNeoXForCausalLM, GPTNeoXConfig
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
>>> config = GPTNeoXConfig.from_pretrained("EleutherAI/gpt-neox-20b")
>>> config.is_decoder = True
>>> model = GPTNeoXForCausalLM.from_pretrained("EleutherAI/gpt-neox-20b", config=config)

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> outputs = model(**inputs)

>>> prediction_logits = outputs.logits
GPTNeoXForQuestionAnswering
クラス transformers.GPTNeoXForQuestionAnswering
< source >( config: GPTNeoXConfig )
パラメータ
- config (GPTNeoXConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
SQuAD などの抽出型質問応答タスクに対応するため、span start logits と span end logits を計算するために隠れ状態の出力上に線形層を配置したスパン分類ヘッドを備えた Gpt Neox トランスフォーマー。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonestart_positions: typing.Optional[torch.LongTensor] = Noneend_positions: typing.Optional[torch.LongTensor] = None**kwargs ) → QuestionAnsweringModelOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - start_positions (
torch.LongTensor、shape(batch_size,)、任意) — トークン分類損失の計算に使用する、ラベル付きスパンの開始位置(インデックス)のラベルです。 位置はシーケンスの長さ(sequence_length)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。 - end_positions (
torch.LongTensor、形状(batch_size,)、任意) — トークン分類損失の計算に使用する、ラベル付きスパンの終了位置(インデックス)のラベルです。 位置はシーケンスの長さ(sequence_length)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。
戻り値
QuestionAnsweringModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または QuestionAnsweringModelOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(GPTNeoXConfig)や入力に応じて、さまざまな要素で構成されます。
GPTNeoXForQuestionAnswering の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます)— 総スパン抽出損失は、開始位置と終了位置に対する Cross-Entropy の和です。start_logits (
torch.FloatTensor、shape(batch_size, sequence_length)) — SoftMax 適用前のスパン開始スコア。end_logits (
torch.FloatTensor、shape(batch_size, sequence_length)) — スパンの終了スコア(SoftMax 適用前)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, GPTNeoXForQuestionAnswering
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
>>> model = GPTNeoXForQuestionAnswering.from_pretrained("EleutherAI/gpt-neox-20b")

>>> question, text = "Who was Jim Henson?", "Jim Henson was a nice puppet"

>>> inputs = tokenizer(question, text, return_tensors="pt")
>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()

>>> predict_answer_tokens = inputs.input_ids[0, answer_start_index : answer_end_index + 1]
>>> tokenizer.decode(predict_answer_tokens, skip_special_tokens=True)
...

>>> # target is "nice puppet"
>>> target_start_index = torch.tensor([14])
>>> target_end_index = torch.tensor([15])

>>> outputs = model(**inputs, start_positions=target_start_index, end_positions=target_end_index)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
...
GPTNeoXForSequenceClassification
class transformers.GPTNeoXForSequenceClassification
< source >( config: GPTNeoXConfig )
パラメータ
- config (GPTNeoXConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
シーケンス分類ヘッド(線形層)を上部に備えたGPTNeoXモデルのtransformerです。
GPTNeoXForSequenceClassification は、他の causal モデル(GPT-1 など)と同様に、最後のトークンを使用して分類を行います。
最後のトークンに対して分類を行うため、最後のトークンの位置を知る必要があります。pad_token_idが設定に定義されている場合、各行でパディングトークンではない最後のトークンを探します。pad_token_idが定義されていない場合、バッチの各行の最後の値をそのまま採用します。inputs_embedsがinput_idsの代わりに渡された場合、パディングトークンを推測できないため、同様にバッチの各行の最後の値を採用します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = None**kwargs ) → SequenceClassifierOutputWithPast or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — シーケンス分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
SequenceClassifierOutputWithPast または tuple(torch.FloatTensor)
SequenceClassifierOutputWithPast または、torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(GPTNeoXConfig)や入力に応じて、さまざまな要素で構成されます。
GPTNeoXForSequenceClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。逐次デコーディングを高速化するために使用できる(
past_key_values入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
単一ラベル分類の例:
>>> import torch
>>> from transformers import AutoTokenizer, GPTNeoXForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
>>> model = GPTNeoXForSequenceClassification.from_pretrained("EleutherAI/gpt-neox-20b")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = GPTNeoXForSequenceClassification.from_pretrained("EleutherAI/gpt-neox-20b", num_labels=num_labels)

>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
マルチラベル分類の例:
>>> import torch
>>> from transformers import AutoTokenizer, GPTNeoXForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
>>> model = GPTNeoXForSequenceClassification.from_pretrained("EleutherAI/gpt-neox-20b", problem_type="multi_label_classification")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = GPTNeoXForSequenceClassification.from_pretrained(
...     "EleutherAI/gpt-neox-20b", num_labels=num_labels, problem_type="multi_label_classification"
... )

>>> labels = torch.sum(
...     torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
GPTNeoXForTokenClassification
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = None**kwargs ) → TokenClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — シーケンス分類/回帰の損失を計算するためのラベルです。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(Mean-Square loss)が計算され、config.num_labels > 1の場合は分類損失(Cross-Entropy)が計算されます。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
TokenClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または TokenClassifierOutput を返します(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(GPTNeoXConfig)と入力に応じて、さまざまな要素が含まれます。
GPTNeoXForTokenClassification の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.num_labels)) — SoftMax 適用前の分類スコア。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, GPTNeoXForTokenClassification
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
>>> model = GPTNeoXForTokenClassification.from_pretrained("EleutherAI/gpt-neox-20b")

>>> inputs = tokenizer(
...     "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_token_class_ids = logits.argmax(-1)

>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...

>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...