
Transformers documentation
SAM
Este modelo foi publicado no HF papers em 2023-04-05 e contribuído para o Hugging Face Transformers em 2023-04-19.
SAM
Visão geral
O SAM (Segment Anything Model) foi proposto em Segment Anything por Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar e Ross Girshick.
O modelo pode ser usado para prever máscaras de segmentação de qualquer objeto de interesse, dado uma imagem de entrada.
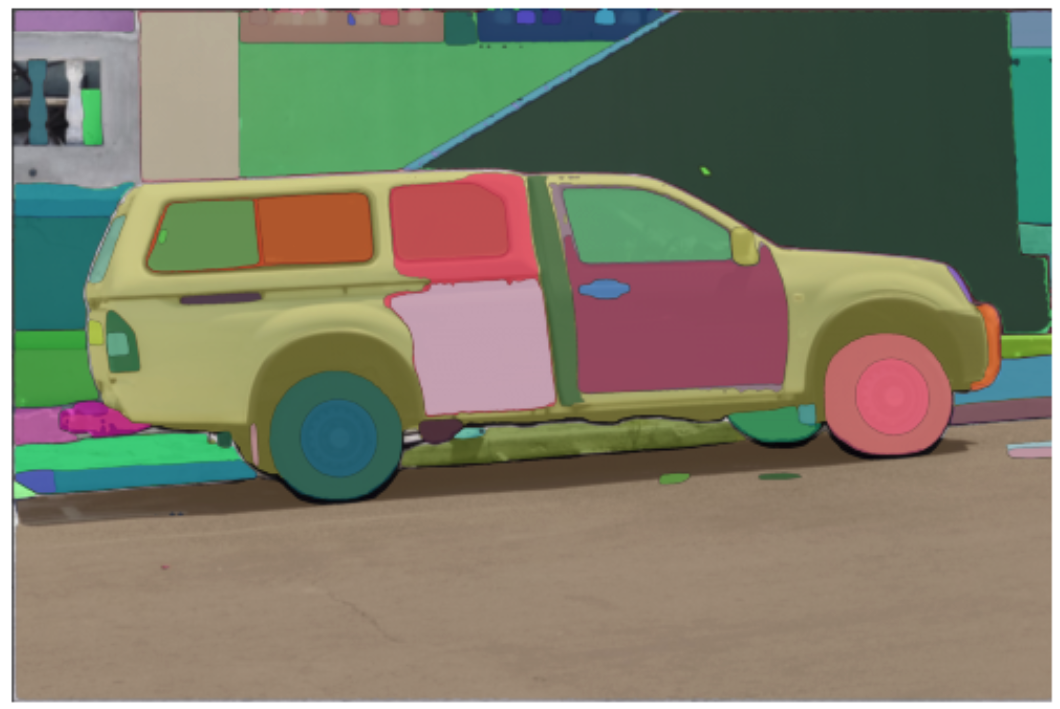
O resumo do artigo é o seguinte:
Apresentamos o projeto Segment Anything (SA): uma nova tarefa, modelo e conjunto de dados para segmentação de imagens. Utilizando nosso modelo eficiente em um loop de coleta de dados, construímos o maior conjunto de dados de segmentação até o momento (de longe), com mais de 1 bilhão de máscaras em 11M de imagens licenciadas e que respeitam a privacidade. O modelo foi projetado e treinado para ser acionável por prompts, permitindo que ele se transfira de forma zero-shot para novas distribuições de imagens e tarefas. Avaliamos suas capacidades em diversas tarefas e constatamos que seu desempenho zero-shot é impressionante — frequentemente competitivo ou até superior a resultados totalmente supervisionados anteriores. Estamos disponibilizando o Segment Anything Model (SAM) e o conjunto de dados correspondente (SA-1B), com 1 bilhão de máscaras e 11M de imagens, em https://segment-anything.com para fomentar a pesquisa em modelos de fundação para visão computacional.
Dicas:
- O modelo prevê máscaras binárias que indicam a presença ou não do objeto de interesse a partir de uma imagem.
- O modelo prevê resultados muito melhores se pontos 2D de entrada e/ou caixas delimitadoras de entrada forem fornecidos
- Você pode inserir múltiplos pontos para a mesma imagem e prever uma única máscara.
- O ajuste fino do modelo ainda não é suportado
- De acordo com o artigo, a entrada textual também deveria ser suportada. No entanto, no momento da redação deste texto, isso não parece ser suportado, conforme o repositório oficial.
Este modelo foi contribuído por ybelkada e ArthurZ. O código original pode ser encontrado aqui.
Abaixo, há um exemplo de como executar a geração de máscaras a partir de uma imagem e de um ponto 2D:
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Você também pode processar suas próprias máscaras junto com as imagens de entrada no processador, para que sejam passadas ao modelo.
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o SAM.
- Nota de demonstração para usar o modelo.
- Nota de demonstração para usar o pipeline de geração automática de máscaras.
- Nota de demonstração para inferência com MedSAM, uma versão ajustada do SAM no domínio médico. 🌎
- Nota de demonstração para ajuste fino do modelo em dados personalizados. 🌎
SlimSAM
SlimSAM, uma versão podada do SAM, foi proposta em 0.1% Data Makes Segment Anything Slim por Zigeng Chen et al. O SlimSAM reduz consideravelmente o tamanho dos modelos SAM, mantendo o mesmo desempenho.
Os checkpoints podem ser encontrados no hub e podem ser usados como substituto direto do SAM.
Grounded SAM
É possível combinar Grounding DINO com SAM para geração de máscaras baseadas em texto, conforme introduzido em Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks. Consulte este notebook de demonstração 🌍 para mais detalhes.
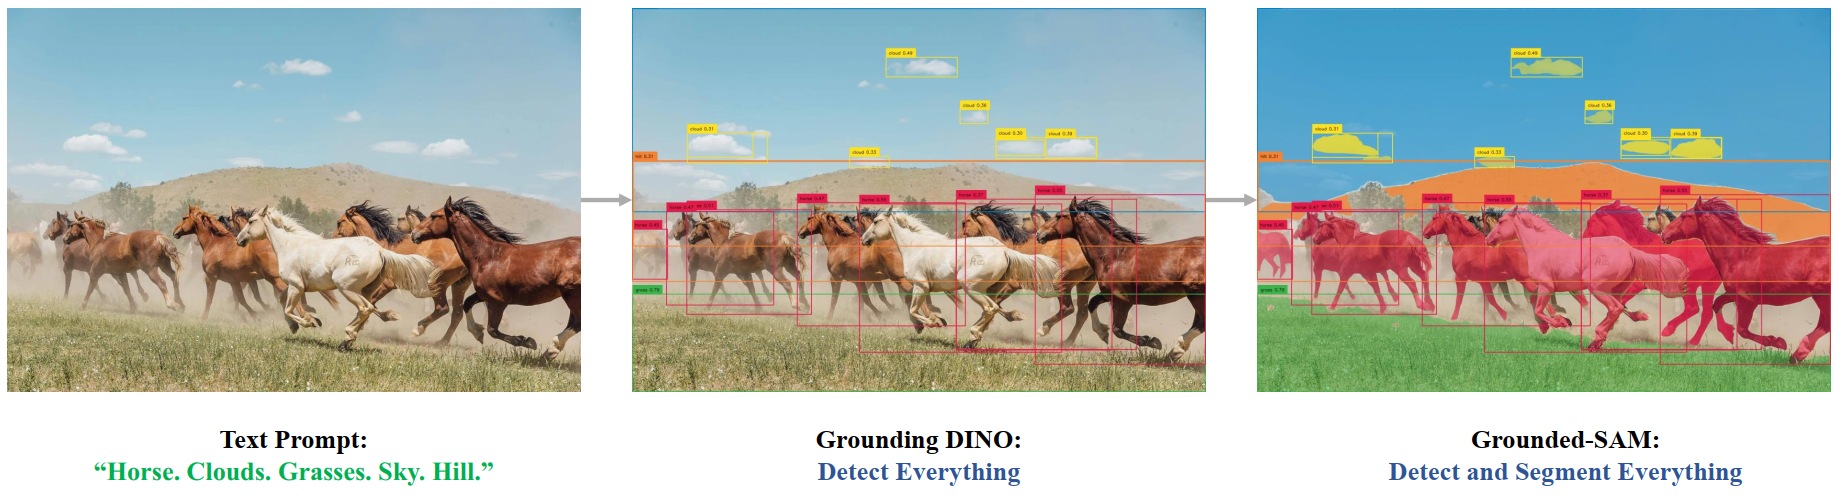 Grounded SAM overview. Taken from the original repository.
SamConfig
classe transformers.SamConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
Parâmetros
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — O objeto de configuração ou dicionário do backbone de visão. - prompt_encoder_config (Union[
dict,SamPromptEncoderConfig], opcional) — Dicionário de opções de configuração usado para inicializar SamPromptEncoderConfig. - mask_decoder_config (Union[
dict,SamMaskDecoderConfig], opcional) — Dicionário de opções de configuração usado para inicializar SamMaskDecoderConfig. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/sam-vit-huge
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import (
...     SamVisionConfig,
...     SamPromptEncoderConfig,
...     SamMaskDecoderConfig,
...     SamModel,
... )

>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()

>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig

>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()

>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
SamVisionConfig
classe transformers.SamVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
Parâmetros
- hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - output_channels (
int, opcional, padrão 256) — Dimensão dos canais de saída no Patch Encoder. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão1024) — O tamanho (resolução) de cada imagem. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão16) — O tamanho (resolução) de cada patch. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - initializer_range (
float, opcional, padrão1e-10) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - qkv_bias (
bool, opcional, padrãoTrue) — Se deve adicionar um viés às queries, keys e values. - mlp_ratio (
float, opcional, padrão4.0) — Proporção entre a dimensão oculta do MLP e a dimensão de incorporação. - use_abs_pos (
bool, opcional, padrãoTrue) — Se deve usar embeddings de posição absoluta. - use_rel_pos (
bool, opcional, padrãoTrue) — Se deve usar incorporação de posição relativa. - window_size (
int, opcional, padrão 14) — Tamanho da janela para posição relativa. - global_attn_indexes (
list[int], opcional, padrão[2, 5, 8, 11]) — Os índices das camadas de atenção global. - num_pos_feats (
int, opcional, padrão 128) — A dimensionalidade do embedding de posição. - mlp_dim (
int, opcional) — A dimensionalidade da camada MLP no codificador Transformer. SeNone, o valor padrão émlp_ratio * hidden_size.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/sam-vit-huge
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import (
...     SamVisionConfig,
...     SamVisionModel,
... )

>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()

>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamMaskDecoderConfig
classe transformers.SamMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06 )
Parâmetros
- hidden_size (
int, opcional, padrão256) — Dimensão das representações ocultas. - hidden_act (
str, opcional, padrãorelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - mlp_dim (
int, opcional, padrão 2048) — Dimensão da camada “intermediária” (ou seja, feed-forward) no codificador Transformer. - num_hidden_layers (
int, opcional, padrão2) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - attention_downsample_rate (
int, opcional, padrão 2) — A taxa de redução de amostragem da camada de atenção. - num_multimask_outputs (
int, opcional, padrão 3) — O número de saídas do móduloSamMaskDecoder. No paper do Segment Anything, esse valor é definido como 3. - iou_head_depth (
int, opcional, padrão 3) — O número de camadas no módulo de cabeçalho de IoU. - iou_head_hidden_dim (
int, opcional, padrão 256) — A dimensionalidade dos estados ocultos no módulo de cabeçalho de IoU. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/sam-vit-huge
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
SamPromptEncoderConfig
classe transformers.SamPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
Parâmetros
- hidden_size (
int, opcional, padrão256) — Dimensão das representações ocultas. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão1024) — O tamanho (resolução) de cada imagem. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão16) — O tamanho (resolução) de cada patch. - mask_input_channels (
int, opcional, padrão 16) — O número de canais a serem fornecidos ao móduloMaskDecoder. - num_point_embeddings (
int, opcional, padrão 4) — O número de incorporações de pontos a serem usadas. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/sam-vit-huge
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
SamProcessor
classe transformers.SamProcessor
< source >( image_processor )
Constrói um SamProcessor que encapsula um processador de imagem em um único processador.
SamProcessor oferece todas as funcionalidades de SamImageProcessor. Consulte ~SamImageProcessor para mais informações.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = None**kwargs ) → ~tokenization_utils_base.BatchEncoding
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], opcional) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - text (
Union[str, list[str], list[list[str]]], opcional) — A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se você passar uma entrada pré-tokenizada, definais_split_into_words=Truepara evitar ambiguidade com entradas em lote. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
Retorna
~tokenization_utils_base.BatchEncoding
- data (
dict, opcional) — Dicionário de listas/arrays/tensors retornados pelos métodos__call__/encode_plus/batch_encode_plus(‘input_ids’, ‘attention_mask’, etc.). - encoding (
tokenizers.EncodingouSequence[tokenizers.Encoding], opcional) — Se o tokenizer for um fast tokenizer que fornece informações adicionais, como o mapeamento do espaço de palavras/caracteres para o espaço de tokens, a instânciatokenizers.Encodingou a lista de instâncias (para lotes) armazena essas informações. - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização. - prepend_batch_axis (
bool, opcional, padrãoFalse) — Indica se deve ou não adicionar um eixo de lote ao converter para tensores (vejatensor_typeacima). Observe que este parâmetro tem efeito se o parâmetrotensor_typeestiver definido, caso contrário, não tem efeito. - n_sequences (
int, opcional) — O número de sequências de entrada representadas por cada codificação (Nonepara desconhecido,1para uma única sequência e2para um par de sequências).
SamImageProcessor
classe transformers.SamImageProcessor
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'longest_edge' -- 1024}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoTrue) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'height' -- 1024, 'width': 1024}): O tamanho em{"height": int, "width" int}para o preenchimento (padding) das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - mask_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"longest_edge": int}para redimensionar os mapas de segmentação. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"height": int, "width": int}para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para o pré-processamento.
Constrói um processador de imagem SamImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação a serem pré-processados. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - mask_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"longest_edge": int}para redimensionar os mapas de segmentação. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"height": int, "width": int}para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para o pré-processamento.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
SamImageProcessorPil
classe transformers.SamImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'longest_edge' -- 1024}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoTrue) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'height' -- 1024, 'width': 1024}): O tamanho em{"height": int, "width" int}para o preenchimento (padding) das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - mask_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"longest_edge": int}para redimensionar os mapas de segmentação. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"height": int, "width": int}para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para o pré-processamento.
Constrói um processador de imagem SamImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação a serem pré-processados. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - mask_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"longest_edge": int}para redimensionar os mapas de segmentação. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — O tamanho{"height": int, "width": int}para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para o pré-processamento.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
SamVisionModel
classe transformers.SamVisionModel
< source >( config: SamVisionConfig )
Parâmetros
- config (SamVisionConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo de visão do Sam, sem nenhum cabeçalho ou projeção no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamVisionEncoderOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SamImageProcessor. Consulte SamImageProcessor.call() para detalhes (SamProcessor usa SamImageProcessor para processar imagens).
Retorna
SamVisionEncoderOutput ou tuple(torch.Tensor)
Uma SamVisionEncoderOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (SamConfig) e das entradas.
O método forward do SamVisionModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
image_embeds (
torch.Tensorde forma(batch_size, output_dim)opcional retornado quando o modelo é inicializado comwith_projection=True) — Os embeddings de imagem obtidos ao aplicar a camada de projeção ao pooler_output.last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do modelo.hidden_states (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
SamModel
classe transformers.SamModel
< source >( config: SamConfig )
Parâmetros
- config (SamConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Segment Anything Model (SAM) para gerar máscaras de segmentação, dado uma imagem de entrada e pontos e rótulos, caixas ou máscaras de entrada.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Trueattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamImageSegmentationOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SamImageProcessor. Consulte SamImageProcessor.call() para detalhes (SamProcessor usa SamImageProcessor para processar imagens). - input_points (
torch.Tensorde forma(batch_size, num_points, 2)) — Pontos espaciais 2D de entrada, usados pelo codificador de prompt para codificar o prompt. Geralmente, isso resulta em muito melhores resultados. Os pontos podem ser obtidos passando uma lista de listas de listas para o processador, que criará os correspondentes tensorestorchde dimensão 4. A primeira dimensão é o tamanho do lote de imagens, a segunda dimensão é o tamanho do lote de pontos (ou seja, quantas máscaras de segmentação desejamos que o modelo preveja por ponto de entrada), a terceira dimensão é o número de pontos por máscara de segmentação (é possível passar múltiplos pontos para uma única máscara) e a última dimensão são as coordenadas x (vertical) e y (horizontal) do ponto. Se um número diferente de pontos for passado para cada imagem ou para cada máscara, o processador criará pontos “PAD” que corresponderão à coordenada (0, 0) e o cálculo do embedding será ignorado para esses pontos usando os rótulos. - input_labels (
torch.LongTensorde forma(batch_size, point_batch_size, num_points)) — Rótulos de entrada para os pontos, usados pelo codificador de prompt para codificar o prompt. De acordo com a implementação oficial, existem 3 tipos de rótulos1: o ponto é um ponto que contém o objeto de interesse0: o ponto é um ponto que não contém o objeto de interesse-1: o ponto corresponde ao fundo
Adicionamos o rótulo:
-10: o ponto é um ponto de preenchimento, portanto deve ser ignorado pelo codificador de prompt
Os rótulos de preenchimento devem ser feitos automaticamente pelo processador.
- input_boxes (
torch.Tensorde forma(batch_size, num_boxes, 4)) — Caixas de entrada para os pontos, usadas pelo prompt encoder para codificar o prompt. Geralmente, isso resulta em máscaras geradas muito melhores. As caixas podem ser obtidas passando uma lista de listas de listas para o processor, que gerará umtorchtensor, em que cada dimensão corresponde, respectivamente, ao tamanho do lote de imagens, ao número de caixas por imagem e às coordenadas do ponto superior esquerdo e do ponto inferior direito da caixa. Na ordem (x1,y1,x2,y2):x1: a coordenada x do ponto superior esquerdo da caixa de entraday1: a coordenada y do ponto superior esquerdo da caixa de entradax2: a coordenada x do ponto inferior direito da caixa de entraday2: a coordenada y do ponto inferior direito da caixa de entrada
- input_masks (
torch.Tensorde forma(batch_size, image_size, image_size)) — O modelo SAM também aceita máscaras de segmentação como entrada. A máscara será incorporada pelo codificador de prompt para gerar uma incorporação correspondente, que será fornecida posteriormente ao decodificador de máscara. Essas máscaras precisam ser fornecidas manualmente pelo usuário e precisam ter a forma (batch_size,image_size,image_size). - image_embeddings (
torch.Tensorde forma(batch_size, output_channels, window_size, window_size)) — Incorporações de imagem, usadas pelo decodificador de máscara para gerar máscaras e pontuações de iou. Para um cálculo mais eficiente em termos de memória, os usuários podem primeiro recuperar as incorporações de imagem usando o métodoget_image_embeddingse, em seguida, fornecê-las ao métodoforwardem vez de fornecer ospixel_values. - multimask_output (
bool, opcional) — Na implementação e no artigo originais, o modelo sempre produz 3 máscaras por imagem (ou por ponto / por bounding box, quando aplicável). No entanto, é possível produzir apenas uma única máscara, que corresponde à máscara “melhor”, especificandomultimask_output=False. - attention_similarity (
torch.Tensor, opcional) — Tensor de similaridade de atenção, a ser fornecido ao decodificador de máscara para atenção guiada por alvo, caso o modelo seja usado para personalização, conforme introduzido em PerSAM. - target_embedding (
torch.Tensor, opcional) — Embedding do conceito alvo, a ser fornecido ao decodificador de máscara para prompting semântico do alvo, caso o modelo seja usado para personalização, conforme introduzido em PerSAM.
Retorna
SamImageSegmentationOutput ou tuple(torch.Tensor)
Um SamImageSegmentationOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (SamConfig) e das entradas.
O método forward da SamModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
iou_scores (
torch.Tensorde forma(batch_size, num_masks)) — As pontuações iou das máscaras previstas.pred_masks (
torch.Tensorde forma(batch_size, num_masks, height, width)) — As máscaras de baixa resolução previstas. Precisam ser pós-processadas pelo processadorvision_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo de visão na saída de cada camada, além das saídas opcionais do embedding inicial.
vision_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
mask_decoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")

>>> # Get segmentation mask
>>> outputs = model(**inputs)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )