
Transformers documentation
ZoeDepth
Este modelo foi publicado no HF papers em 2023-02-23 e contribuído para o Hugging Face Transformers em 2024-07-08.
ZoeDepth
ZoeDepth é um modelo de estimativa de profundidade que combina o desempenho de generalização da estimativa de profundidade relativa (a distância entre os objetos) e da estimativa de profundidade métrica (medição precisa de profundidade em escala métrica) a partir de uma única imagem. Ele é pré-treinado em 12 conjuntos de dados usando profundidade relativa e 2 conjuntos de dados (NYU Depth v2 e KITTI) para precisão métrica. Um cabeçalho leve com um módulo de bin métrico para cada domínio é utilizado e, durante a inferência, ele seleciona automaticamente o cabeçalho apropriado para cada imagem de entrada com um classificador latente.
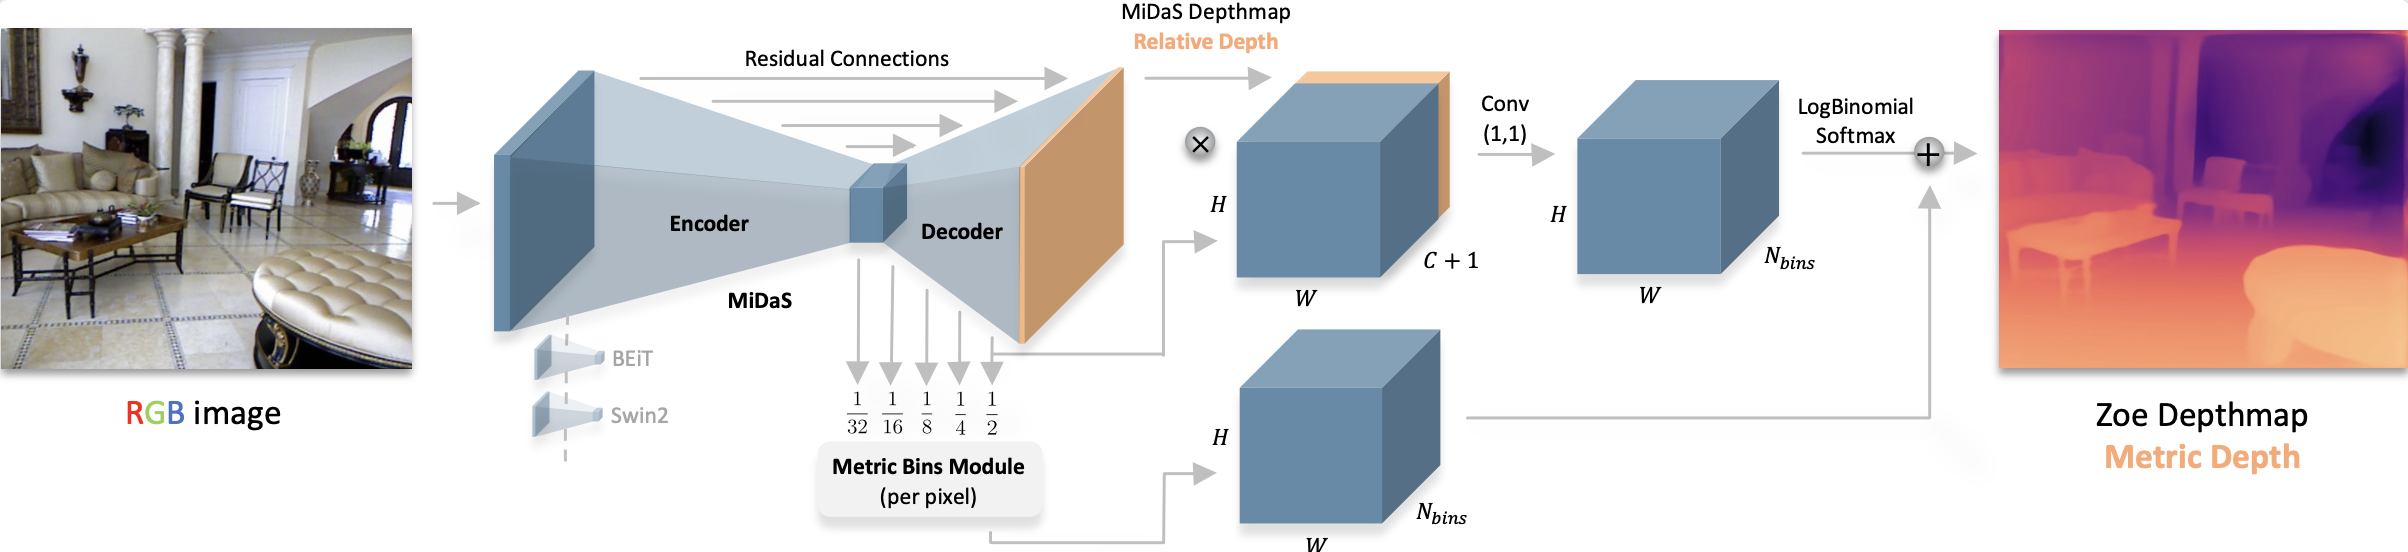
Você pode encontrar todos os checkpoints originais do ZoeDepth na organização Intel.
O exemplo abaixo demonstra como estimar profundidade com Pipeline ou a classe AutoModel.
import requests
from PIL import Image

from transformers import pipeline


url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
pipeline = pipeline(
    task="depth-estimation",
    model="Intel/zoedepth-nyu-kitti",
    device=0
)
results = pipeline(image)
results["depth"]import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForDepthEstimation
image_processor = AutoImageProcessor.from_pretrained(
"Intel/zoedepth-nyu-kitti"
)
model = AutoModelForDepthEstimation.from_pretrained(
"Intel/zoedepth-nyu-kitti",
device_map="auto"
)
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
inputs = image_processor(image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(inputs)
# interpolate to original size and visualize the prediction
## ZoeDepth dynamically pads the input image, so pass the original image size as argument
## to `post_process_depth_estimation` to remove the padding and resize to original dimensions.
post_processed_output = image_processor.post_process_depth_estimation(
outputs,
source_sizes=[(image.height, image.width)],
)
predicted_depth = post_processed_output[0]["predicted_depth"]
depth = (predicted_depth - predicted_depth.min()) / (predicted_depth.max() - predicted_depth.min())
depth = depth.detach().cpu().numpy() * 255
Image.fromarray(depth.astype("uint8"))Observações
Na implementação original, o ZoeDepth executa a inferência tanto nas imagens originais quanto nas imagens espelhadas e calcula a média dos resultados. A função
post_process_depth_estimationtrata isso passando as saídas espelhadas para o argumento opcionaloutputs_flipped, conforme mostrado abaixo.with torch.no_grad(): outputs = model(pixel_values) outputs_flipped = model(pixel_values=torch.flip(inputs.pixel_values, dims=[3])) post_processed_output = image_processor.post_process_depth_estimation( outputs, source_sizes=[(image.height, image.width)], outputs_flipped=outputs_flipped, )
Recursos
- Consulte este notebook para um exemplo de inferência.
ZoeDepthConfig
classe transformers.ZoeDepthConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonehidden_act: str = 'gelu'initializer_range: float = 0.02batch_norm_eps: float = 1e-05readout_type: typing.Literal['ignore', 'add', 'project'] = 'project'reassemble_factors: list[int | float] | tuple[int | float, ...] = (4, 2, 1, 0.5)neck_hidden_sizes: list[int] | tuple[int, ...] = (96, 192, 384, 768)fusion_hidden_size: int = 256head_in_index: int = -1use_batch_norm_in_fusion_residual: bool = Falseuse_bias_in_fusion_residual: bool | None = Nonenum_relative_features: int = 32add_projection: bool = Falsebottleneck_features: int = 256num_attractors: list[int] | tuple[int, ...] = (16, 8, 4, 1)bin_embedding_dim: int = 128attractor_alpha: int = 1000attractor_gamma: int = 2attractor_kind: typing.Literal['mean', 'sum'] = 'mean'min_temp: float = 0.0212max_temp: float = 50.0bin_centers_type: str = 'softplus'bin_configurations: list[dict] | None = Nonenum_patch_transformer_layers: int | None = Nonepatch_transformer_hidden_size: int | None = Nonepatch_transformer_intermediate_size: int | None = Nonepatch_transformer_num_attention_heads: int | None = None )
Parâmetros
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — A configuração do modelo backbone. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - batch_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de lote. - readout_type (
str, opcional, padrão é"project") — O tipo de readout a ser usado ao processar o token de readout (token CLS) dos estados ocultos intermediários do backbone ViT. Pode ser um dos valores ["ignore","add","project"].- “ignore” simplesmente ignora o token CLS.
- O modo add transmite as informações do token CLS para todos os outros tokens por meio da adição das representações.
- O “project” transmite informações para os outros tokens concatenando o readout a todos os outros tokens antes de projetar a representação para a dimensão de recurso original D usando uma camada linear seguida de uma não linearidade GELU.
- reassemble_factors (
list[int], opcional, padrão[4, 2, 1, 0.5]) — Fatores de up/downsampling das camadas de reassemble. - neck_hidden_sizes (
list[str], opcional, padrão[96, 192, 384, 768]) — Os tamanhos ocultos para os quais as feature maps do backbone devem ser projetadas. - fusion_hidden_size (
int, opcional, padrão 256) — O número de canais antes da fusão. - head_in_index (
int, opcional, padrão -1) — O índice dos recursos a serem usados nos heads. - use_batch_norm_in_fusion_residual (
bool, opcional, padrãoFalse) — Se deve usar normalização de lote nas unidades residuais pré-ativação dos blocos de fusão. - use_bias_in_fusion_residual (
bool, opcional, padrãoTrue) — Se deve usar viés nas unidades residuais pré-ativação dos blocos de fusão. - num_relative_features (
int, opcional, padrão 32) — O número de recursos a serem usados na cabeça de estimativa de profundidade relativa. - add_projection (
bool, opcional, padrãoFalse) — Indica se uma camada de projeção deve ser adicionada antes da cabeça de estimativa de profundidade. - bottleneck_features (
int, opcional, padrão 256) — O número de recursos na camada de gargalo. - num_attractors (
list[int], *optional*, defaults to[16, 8, 4, 1]`) — O número de atratores a serem usados em cada etapa. - bin_embedding_dim (
int, opcional, padrão 128) — A dimensão dos embeddings de bin. - attractor_alpha (
int, opcional, padrão 1000) — O valor de alpha a ser usado no atrator. - attractor_gamma (
int, opcional, padrão 2) — O valor de gamma a ser usado no atrator. - attractor_kind (
str, opcional, padrão"mean") — O tipo de atrator a ser usado. Pode ser um de ["mean","sum"]. - min_temp (
float, opcional, padrão 0.0212) — O valor mínimo de temperatura a ser considerado. - max_temp (
float, opcional, padrão 50.0) — O valor máximo de temperatura a ser considerado. - bin_centers_type (
str, opcional, padrão"softplus") — Tipo de ativação usado para os centros dos bins. Pode ser “normed” ou “softplus”. Para centros de bin “normed”, é aplicado o truque de normalização linear. Isso resulta em centros de bin limitados. Para “softplus”, a ativação softplus é usada e, portanto, são ilimitados. - bin_configurations (
list[dict], opcional, padrão é[{'n_bins' -- 64, 'min_depth': 0.001, 'max_depth': 10.0}]): Configuração para cada um dos bin heads. Cada configuração deve consistir das seguintes chaves:- name (
str): O nome da cabeça de bin - apenas necessário em caso de múltiplas configurações de bin. n_bins(int): O número de bins a serem usados.min_depth(float): O valor mínimo de profundidade a ser considerado.max_depth(float): O valor máximo de profundidade a ser considerado. Caso apenas uma configuração seja passada, o modelo usará um único cabeçalho com a configuração especificada. Caso múltiplas configurações sejam passadas, o modelo usará múltiplos cabeçalhos com as configurações especificadas.
- name (
- num_patch_transformer_layers (
int, opcional) — O número de camadas de transformer a serem usadas no patch transformer. Usado apenas no caso de múltiplas configurações de bin. - patch_transformer_hidden_size (
int, opcional) — O tamanho oculto a ser usado no patch transformer. Usado apenas em caso de múltiplas configurações de bin. - patch_transformer_intermediate_size (
int, opcional) — O tamanho intermediário a ser usado no patch transformer. Usado apenas em caso de múltiplas configurações de bin. - patch_transformer_num_attention_heads (
int, opcional) — O número de cabeças de atenção a serem usadas no patch transformer. Usado apenas em caso de múltiplas configurações de bin.
Esta é a classe de configuração para armazenar a configuração de um ZoedepthModel. Ela é usada para instanciar um modelo Zoedepth de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do Intel/zoedepth-nyu
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import ZoeDepthConfig, ZoeDepthForDepthEstimation

>>> # Initializing a ZoeDepth zoedepth-large style configuration
>>> configuration = ZoeDepthConfig()

>>> # Initializing a model from the zoedepth-large style configuration
>>> model = ZoeDepthForDepthEstimation(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ZoeDepthImageProcessor
classe transformers.ZoeDepthImageProcessor
< source >( **kwargs: *<class 'transformers.models.zoedepth.image_processing_zoedepth.ZoeDepthImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'height' -- 384, 'width': 512}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoTrue) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.5, 0.5, 0.5]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.5, 0.5, 0.5]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - keep_aspect_ratio (
bool, kwargs, opcional, padrãoself.keep_aspect_ratio) — SeTrue, a imagem é redimensionada escolhendo o menor entre os fatores de escala de altura e largura e usando-o para ambas as dimensões. Isso garante que a imagem seja reduzida o mínimo possível, mantendo-se ainda assim dentro do tamanho de saída desejado. Casoensure_multiple_oftambém esteja definido, a imagem é redimensionada para um tamanho que seja um múltiplo desse valor, arredondando a altura e a largura para o múltiplo mais próximo inferior. Pode ser sobrescrito porkeep_aspect_ratioempreprocess. - ensure_multiple_of (
int, kwargs, opcional, padrãoself.ensure_multiple_of) — Sedo_resizeforTrue, a imagem é redimensionada para um tamanho que seja um múltiplo deste valor. Funciona arredondando para baixo a altura e a largura para o múltiplo mais próximo deste valor. Funciona tanto com quanto semkeep_aspect_ratiodefinido comoTrue. Pode ser sobrescrito porensure_multiple_ofempreprocess.
Constrói um processador de imagem ZoeDepthImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.zoedepth.image_processing_zoedepth.ZoeDepthImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - keep_aspect_ratio (
bool, kwargs, opcional, padrãoself.keep_aspect_ratio) — SeTrue, a imagem é redimensionada escolhendo o menor entre os fatores de escala de altura e largura e usando-o para ambas as dimensões. Isso garante que a imagem seja reduzida o mínimo possível, mantendo-se ainda assim dentro do tamanho de saída desejado. Casoensure_multiple_oftambém esteja definido, a imagem é redimensionada para um tamanho que seja um múltiplo desse valor, arredondando a altura e a largura para o múltiplo mais próximo inferior. Pode ser sobrescrito porkeep_aspect_ratioempreprocess. - ensure_multiple_of (
int, kwargs, opcional, padrãoself.ensure_multiple_of) — Sedo_resizeforTrue, a imagem é redimensionada para um tamanho que seja um múltiplo deste valor. Funciona arredondando para baixo a altura e a largura para o múltiplo mais próximo deste valor. Funciona tanto com quanto semkeep_aspect_ratiodefinido comoTrue. Pode ser sobrescrito porensure_multiple_ofempreprocess.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
ZoeDepthImageProcessorPil
classe transformers.ZoeDepthImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.zoedepth.image_processing_pil_zoedepth.ZoeDepthImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'height' -- 384, 'width': 512}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoTrue) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.5, 0.5, 0.5]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.5, 0.5, 0.5]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - keep_aspect_ratio (
bool, kwargs, opcional, padrãoself.keep_aspect_ratio) — SeTrue, a imagem é redimensionada escolhendo o menor entre os fatores de escala de altura e largura e usando-o para ambas as dimensões. Isso garante que a imagem seja reduzida o mínimo possível, mantendo-se ainda assim dentro do tamanho de saída desejado. Casoensure_multiple_oftambém esteja definido, a imagem é redimensionada para um tamanho que seja um múltiplo desse valor, arredondando a altura e a largura para o múltiplo mais próximo inferior. Pode ser sobrescrito porkeep_aspect_ratioempreprocess. - ensure_multiple_of (
int, kwargs, opcional, padrãoself.ensure_multiple_of) — Sedo_resizeforTrue, a imagem é redimensionada para um tamanho que seja um múltiplo deste valor. Funciona arredondando para baixo a altura e a largura para o múltiplo mais próximo deste valor. Funciona tanto com quanto semkeep_aspect_ratiodefinido comoTrue. Pode ser sobrescrito porensure_multiple_ofempreprocess.
Constrói um processador de imagem ZoeDepthImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.zoedepth.image_processing_pil_zoedepth.ZoeDepthImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - keep_aspect_ratio (
bool, kwargs, opcional, padrãoself.keep_aspect_ratio) — SeTrue, a imagem é redimensionada escolhendo o menor entre os fatores de escala de altura e largura e usando-o para ambas as dimensões. Isso garante que a imagem seja reduzida o mínimo possível, mantendo-se ainda assim dentro do tamanho de saída desejado. Casoensure_multiple_oftambém esteja definido, a imagem é redimensionada para um tamanho que seja um múltiplo desse valor, arredondando a altura e a largura para o múltiplo mais próximo inferior. Pode ser sobrescrito porkeep_aspect_ratioempreprocess. - ensure_multiple_of (
int, kwargs, opcional, padrãoself.ensure_multiple_of) — Sedo_resizeforTrue, a imagem é redimensionada para um tamanho que seja um múltiplo deste valor. Funciona arredondando para baixo a altura e a largura para o múltiplo mais próximo deste valor. Funciona tanto com quanto semkeep_aspect_ratiodefinido comoTrue. Pode ser sobrescrito porensure_multiple_ofempreprocess.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
ZoeDepthForDepthEstimation
classe transformers.ZoeDepthForDepthEstimation
< source >( config: ZoeDepthConfig )
Parâmetros
- config (ZoeDepthConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo ZoeDepth com uma ou várias cabeças de estimativa de profundidade métrica no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorlabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DepthEstimatorOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ZoeDepthImageProcessor. Consulte ZoeDepthImageProcessor.call() para mais detalhes (processor_classusa ZoeDepthImageProcessor para processar as imagens). - labels (
torch.LongTensorde forma(batch_size, height, width), opcional) — Mapas de estimativa de profundidade reais para o cálculo da perda. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
DepthEstimatorOutput ou tuple(torch.Tensor)
Um DepthEstimatorOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (ZoeDepthConfig) e das entradas.
O método forward de ZoeDepthForDepthEstimation substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).predicted_depth (
torch.Tensorde forma(batch_size, height, width)) — Profundidade prevista para cada pixel.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, num_channels, height, width).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, patch_size, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import AutoImageProcessor, ZoeDepthForDepthEstimation
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("Intel/zoedepth-nyu-kitti")
>>> model = ZoeDepthForDepthEstimation.from_pretrained("Intel/zoedepth-nyu-kitti")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> # interpolate to original size
>>> post_processed_output = image_processor.post_process_depth_estimation(
...     outputs,
...     source_sizes=[(image.height, image.width)],
... )

>>> # visualize the prediction
>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = predicted_depth * 255 / predicted_depth.max()
>>> depth = depth.detach().cpu().numpy()
>>> depth = Image.fromarray(depth.astype("uint8"))