
Transformers documentation
الإجابة على أسئلة المستندات
الإجابة على أسئلة المستندات
إجابة الأسئلة على المستندات، ويُشار إليها أيضاً باسم إجابة الأسئلة البصرية على المستندات، هي مهمة تتضمن تقديم إجابات عن الأسئلة المطروحة حول صور المستندات. يكون مدخل النماذج الداعمة لهذه المهمة عادةً مزيجاً من صورة وسؤال، ويكون المخرج إجابة معبّراً عنها بلغة طبيعية. تستفيد هذه النماذج من عدة أوضاع (modalities)، بما في ذلك النص، ومواقع الكلمات (صناديق الحدود)، والصورة نفسها.
يوضح هذا الدليل كيفية:
- قم بضبط LayoutLMv2 على مجموعة بيانات DocVQA.
- استخدم النموذج المُحسَّن لديك للاستدلال.
للاطلاع على جميع البنى المعمارية ونقاط التفتيش المتوافقة مع هذه المهمة، ننصح بالتحقق من صفحة المهمة
يحلّ LayoutLMv2 مهمة الإجابة عن الأسئلة المستندية بإضافة رأس للإجابة عن الأسئلة فوق الحالات المخفية النهائية للرموز، للتنبؤ بمواقع رموز البداية والنهاية للإجابة. بعبارة أخرى، يُعامَل المسألة على أنها إجابة استخلاصية عن الأسئلة: حيث يُستخلص من السياق الجزء الذي يجيب عن السؤال. يأتي السياق من مخرج محرك التعرف الضوئي على الحروف، وهو هنا Tesseract من Google.
قبل أن تبدأ، تأكد من تثبيت جميع المكتبات اللازمة. يعتمد LayoutLMv2 على detectron2 و torchvision و tesseract.
pip install -q transformers datasets
pip install 'git+https://github.com/facebookresearch/detectron2.git'
pip install torchvisionsudo apt install tesseract-ocr
pip install -q pytesseractبمجرد تثبيت جميع التبعيات، أعد تشغيل بيئة التشغيل الخاصة بك.
ننصحك بمشاركة نموذجك مع المجتمع. سجّل الدخول إلى حسابك على Hugging Face لرفعه إلى 🤗 Hub. عند الطلب، أدخل رمزك (token) لتسجيل الدخول:
>>> from huggingface_hub import notebook_login

>>> notebook_login()
لنعرّف بعض المتغيرات العامة.
>>> model_checkpoint = "microsoft/layoutlmv2-base-uncased"
>>> batch_size = 4
تحميل البيانات
في هذا الدليل، نستخدم عينة صغيرة من DocVQA المُعالَجة مسبقًا، والتي يمكنك العثور عليها على 🤗 Hub. إذا كنت ترغب في استخدام مجموعة بيانات DocVQA الكاملة، يمكنك التسجيل وتحميلها من صفحة DocVQA الرئيسية. إذا قمت بذلك، فلتُواصل مع هذا الدليل، اطّلع على كيفية تحميل الملفات إلى مجموعة بيانات 🤗.
>>> from datasets import load_dataset

>>> dataset = load_dataset("nielsr/docvqa_1200_examples")
>>> dataset
DatasetDict({
    train: Dataset({
        features: ['id', 'image', 'query', 'answers', 'words', 'bounding_boxes', 'answer'],
        num_rows: 1000
    })
    test: Dataset({
        features: ['id', 'image', 'query', 'answers', 'words', 'bounding_boxes', 'answer'],
        num_rows: 200
    })
})
كما ترون، تم تقسيم مجموعة البيانات مسبقًا إلى مجموعات تدريب واختبار. اطّلعوا على مثال عشوائي للتعرف على السمات.
>>> dataset["train"].featuresإليك ما تمثله الحقول الفردية:
id: معرّف المثالimage: كائن من نوع PIL.Image.Image يحتوي على صورة المستندquery: نص السؤال - السؤال المطروح بلغة طبيعية، بعدة لغاتanswers: قائمة بالإجابات الصحيحة التي قدمها المصنّفون البشرwordsوbounding_boxes: نتائج التعرف الضوئي على الحروف، والتي لن نستخدمها هناanswer: إجابة مطابقة من نموذج مختلف لن نستخدمها هنا
لنحتفظ بالأسئلة الإنجليزية فقط، ونتخلّى عن ميزة answer التي يبدو أنها تحتوي على تنبؤات من نموذج آخر.
وسنأخذ أيضًا الإجابة الأولى من المجموعة التي قدّمها المعلّمون. أو يمكنك أخذ عينة عشوائية منها.
>>> updated_dataset = dataset.map(lambda example: {"question": example["query"]["en"]}, remove_columns=["query"])
>>> updated_dataset = updated_dataset.map(
...     lambda example: {"answer": example["answers"][0]}, remove_columns=["answer", "answers"]
... )
لاحظ أن نقطة التفتيش max_position_embeddings = 512 التي نستخدمها في هذا الدليل تم تدريبها مع max_position_embeddings = 512 (يمكنك
إيجاد هذه المعلومات في ملف config.json الخاص بنقطة التفتيش).
يمكننا تقصير الأمثلة، ولكن لتجنب الحالة التي قد يكون فيها الجواب في نهاية مستند كبير فيُقصَر،
سنقوم هنا بإزالة القليل من الأمثلة التي من المرجح أن يكون تضمينها أطول من 512.
إذا كانت معظم المستندات في مجموعة بياناتك طويلة، يمكنك تنفيذ استراتيجية النافذة المنزلقة - راجع هذا الدفتر للتفاصيل.
>>> updated_dataset = updated_dataset.filter(lambda x: len(x["words"]) + len(x["question"].split()) < 512)في هذه المرحلة، دعونا نحذف أيضاً ميزات التعرف الضوئي على الحروف (OCR) من هذا مجموعة البيانات. هذه الميزات ناتجة عن تطبيق OCR لتهيئة نموذج مختلف. لا تزال تتطلب بعض المعالجة إذا أردنا استخدامها، لأنها لا تتوافق مع متطلبات المدخلات للنموذج الذي نستخدمه في هذا الدليل. بدلاً من ذلك، يمكننا استخدام LayoutLMv2Processor على البيانات الأصلية لكل من OCR وتجزئة الرموز. بهذه الطريقة، سنحصل على مدخلات تتوافق مع المدخلات المتوقعة من النموذج. إذا كنت ترغب في معالجة الصور يدوياً، فاطّلع على توثيق نموذج LayoutLMv2 لمعرفة صيغة المدخلات التي يتوقعها النموذج.
>>> updated_dataset = updated_dataset.remove_columns("words")
>>> updated_dataset = updated_dataset.remove_columns("bounding_boxes")
أخيرًا، لن تكتمل عملية استكشاف البيانات إذا لم نُلقي نظرة على مثال لصورة.
>>> updated_dataset["train"][11]["image"]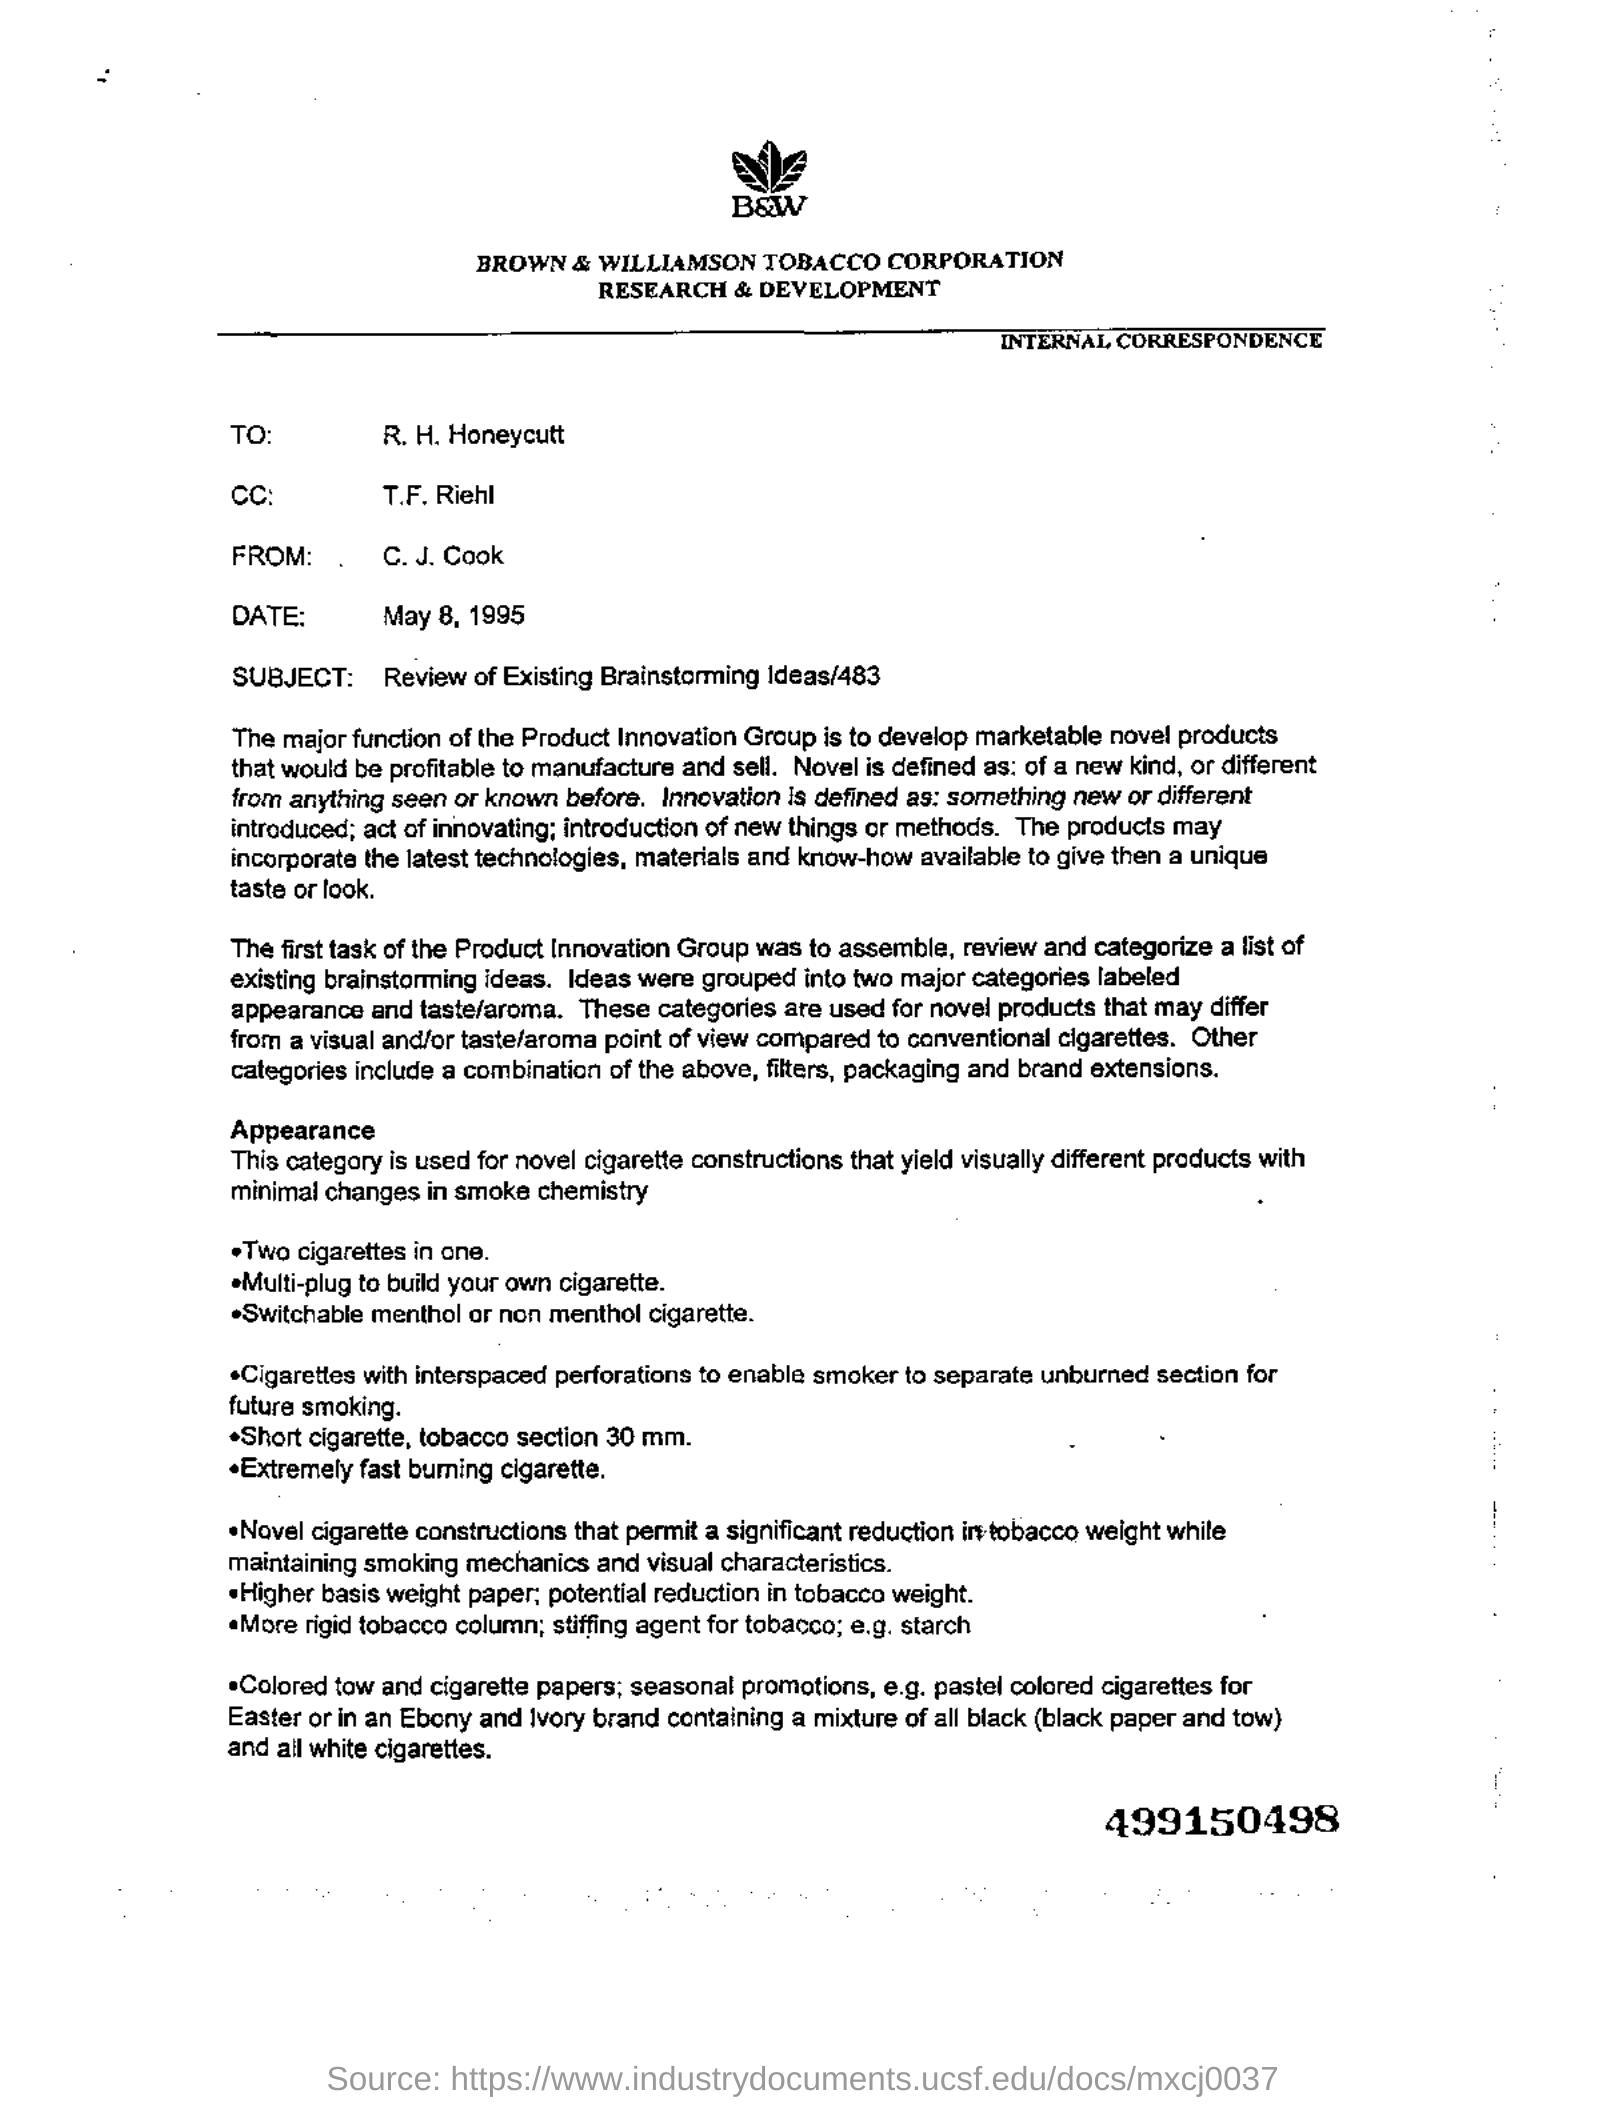
معالجة البيانات مسبقًا
مهمة الإجابة عن الأسئلة من المستندات هي مهمة متعددة الوسائط، ويتعين عليك التأكد من أن المدخلات من كل وسيلة معالجة مسبقاً وفقاً لتوقعات النموذج. لنبدأ بتحميل LayoutLMv2Processor، الذي يجمع داخلياً بين معالج صور يمكنه التعامل مع بيانات الصور، ومجزئ رموز يمكنه ترميز بيانات النص.
>>> from transformers import AutoProcessor

>>> processor = AutoProcessor.from_pretrained(model_checkpoint)
معالجة صور المستندات مسبقًا
أولاً، لنُعدّ صور المستندات للنموذج بمساعدة image_processor من المعالج.
بشكل افتراضي، يعيد معالج الصور حجم الصور إلى 224x224، ويتأكد من ترتيب قنوات الألوان الصحيح،
ويطبّق التعرف الضوئي على الحروف باستخدام tesseract للحصول على الكلمات وصناديق الحدود المعيارية. في هذا الشرح، كل هذه الإعدادات الافتراضية هي بالضبط ما نحتاجه.
اكتب دالة تطبّق معالجة الصور الافتراضية على دفعة من الصور وتعيد نتائج التعرف الضوئي على الحروف.
>>> image_processor = processor.image_processor


>>> def get_ocr_words_and_boxes(examples):
...     images = [image.convert("RGB") for image in examples["image"]]
...     encoded_inputs = image_processor(images)

...     examples["image"] = encoded_inputs.pixel_values
...     examples["words"] = encoded_inputs.words
...     examples["boxes"] = encoded_inputs.boxes

...     return examples
لتطبيق هذا المعالجة المسبقة على مجموعة البيانات بأكملها بطريقة سريعة، استخدم map.
>>> dataset_with_ocr = updated_dataset.map(get_ocr_words_and_boxes, batched=True, batch_size=2)معالجة البيانات النصية مسبقًا
بعد تطبيق تقنية التعرف الضوئي على الحروف على الصور، نحتاج إلى ترميز الجزء النصي من مجموعة البيانات لتجهيزها للنموذج.
يتضمن ذلك تحويل الكلمات والمربعات التي حصلنا عليها في الخطوة السابقة إلى مستوى الرموز input_ids وattention_mask وtoken_type_ids وbbox. وللمعالجة المسبقة للنص، سنحتاج إلى tokenizer من المعالج.
>>> tokenizer = processor.tokenizerإضافةً إلى المعالجة المسبقة المذكورة أعلاه، نحتاج أيضاً إلى إضافة التسميات للنموذج. ففي نماذج xxxForQuestionAnswering
في 🤗 Transformers، تتكون التسميات من start_positions وend_positions، والتي تشير إلى الرمز الذي يقع في
بداية الإجابة والرمز الذي يقع في نهايتها.
لنبدأ بذلك. عرّف دالة مساعدة قادرة على إيجاد قائمة فرعية (الإجابة مقسّمة إلى كلمات) داخل قائمة أكبر (قائمة الكلمات).
This function will take two lists as input, words_list and answer_list. It will then iterate over the words_list and check
if the current word in the words_list (words_list[i]) is equal to the first word of answer_list (answer_list[0]) and if
the sublist of words_list starting from the current word and of the same length as answer_list is equal to answer_list.
If this condition is true, it means that a match has been found, and the function will record the match, its starting index (idx),
and its ending index (idx + len(answer_list) - 1). If more than one match was found, the function will return only the first one.
If no match is found, the function returns (None, 0, and 0).
>>> def subfinder(words_list, answer_list):
...     matches = []
...     start_indices = []
...     end_indices = []
...     for idx, i in enumerate(range(len(words_list))):
...         if words_list[i] == answer_list[0] and words_list[i : i + len(answer_list)] == answer_list:
...             matches.append(answer_list)
...             start_indices.append(idx)
...             end_indices.append(idx + len(answer_list) - 1)
...     if matches:
...         return matches[0], start_indices[0], end_indices[0]
...     else:
...         return None, 0, 0
لإيضاح كيفية تحديد هذا الدالة لموقع الإجابة، دعونا نستخدمها على مثال:
>>> example = dataset_with_ocr["train"][1]
>>> words = [word.lower() for word in example["words"]]
>>> match, word_idx_start, word_idx_end = subfinder(words, example["answer"].lower().split())
>>> print("Question: ", example["question"])
>>> print("Words:", words)
>>> print("Answer: ", example["answer"])
>>> print("start_index", word_idx_start)
>>> print("end_index", word_idx_end)
Question:  Who is in  cc in this letter?
Words: ['wie', 'baw', 'brown', '&', 'williamson', 'tobacco', 'corporation', 'research', '&', 'development', 'internal', 'correspondence', 'to:', 'r.', 'h.', 'honeycutt', 'ce:', 't.f.', 'riehl', 'from:', '.', 'c.j.', 'cook', 'date:', 'may', '8,', '1995', 'subject:', 'review', 'of', 'existing', 'brainstorming', 'ideas/483', 'the', 'major', 'function', 'of', 'the', 'product', 'innovation', 'graup', 'is', 'to', 'develop', 'marketable', 'nove!', 'products', 'that', 'would', 'be', 'profitable', 'to', 'manufacture', 'and', 'sell.', 'novel', 'is', 'defined', 'as:', 'of', 'a', 'new', 'kind,', 'or', 'different', 'from', 'anything', 'seen', 'or', 'known', 'before.', 'innovation', 'is', 'defined', 'as:', 'something', 'new', 'or', 'different', 'introduced;', 'act', 'of', 'innovating;', 'introduction', 'of', 'new', 'things', 'or', 'methods.', 'the', 'products', 'may', 'incorporate', 'the', 'latest', 'technologies,', 'materials', 'and', 'know-how', 'available', 'to', 'give', 'then', 'a', 'unique', 'taste', 'or', 'look.', 'the', 'first', 'task', 'of', 'the', 'product', 'innovation', 'group', 'was', 'to', 'assemble,', 'review', 'and', 'categorize', 'a', 'list', 'of', 'existing', 'brainstorming', 'ideas.', 'ideas', 'were', 'grouped', 'into', 'two', 'major', 'categories', 'labeled', 'appearance', 'and', 'taste/aroma.', 'these', 'categories', 'are', 'used', 'for', 'novel', 'products', 'that', 'may', 'differ', 'from', 'a', 'visual', 'and/or', 'taste/aroma', 'point', 'of', 'view', 'compared', 'to', 'canventional', 'cigarettes.', 'other', 'categories', 'include', 'a', 'combination', 'of', 'the', 'above,', 'filters,', 'packaging', 'and', 'brand', 'extensions.', 'appearance', 'this', 'category', 'is', 'used', 'for', 'novel', 'cigarette', 'constructions', 'that', 'yield', 'visually', 'different', 'products', 'with', 'minimal', 'changes', 'in', 'smoke', 'chemistry', 'two', 'cigarettes', 'in', 'cne.', 'emulti-plug', 'te', 'build', 'yaur', 'awn', 'cigarette.', 'eswitchable', 'menthol', 'or', 'non', 'menthol', 'cigarette.', '*cigarettes', 'with', 'interspaced', 'perforations', 'to', 'enable', 'smoker', 'to', 'separate', 'unburned', 'section', 'for', 'future', 'smoking.', '«short', 'cigarette,', 'tobacco', 'section', '30', 'mm.', '«extremely', 'fast', 'buming', 'cigarette.', '«novel', 'cigarette', 'constructions', 'that', 'permit', 'a', 'significant', 'reduction', 'iretobacco', 'weight', 'while', 'maintaining', 'smoking', 'mechanics', 'and', 'visual', 'characteristics.', 'higher', 'basis', 'weight', 'paper:', 'potential', 'reduction', 'in', 'tobacco', 'weight.', '«more', 'rigid', 'tobacco', 'column;', 'stiffing', 'agent', 'for', 'tobacco;', 'e.g.', 'starch', '*colored', 'tow', 'and', 'cigarette', 'papers;', 'seasonal', 'promotions,', 'e.g.', 'pastel', 'colored', 'cigarettes', 'for', 'easter', 'or', 'in', 'an', 'ebony', 'and', 'ivory', 'brand', 'containing', 'a', 'mixture', 'of', 'all', 'black', '(black', 'paper', 'and', 'tow)', 'and', 'ail', 'white', 'cigarettes.', '499150498']
Answer:  T.F. Riehl
start_index 17
end_index 18
ومع ذلك، بمجرد ترميز الأمثلة، ستبدو على النحو التالي:
>>> encoding = tokenizer(example["question"], example["words"], example["boxes"])
>>> tokenizer.decode(encoding["input_ids"])
[CLS] who is in cc in this letter? [SEP] wie baw brown & williamson tobacco corporation research & development ...
سنحتاج إلى تحديد موضع الإجابة في المدخلات المُرمّزة.
- يُخبرنا
token_type_idsأي الرموز المكوّنة للسؤال وأيها مكوّنة لكلمات المستند. - يساعد
tokenizer.cls_token_idفي تحديد الرمز الخاص في بداية المدخلات. - يساعد
word_idsفي مطابقة الإجابة الموجودة فيwordsالأصلية مع الإجابة نفسها في المدخلات المشفّرة الكاملة، وتحديد موضع بداية/نهاية الإجابة في المدخلات المشفّرة.
مع ذلك في الاعتبار، لنقم بإنشاء دالة لتشفير دفعة من الأمثلة في مجموعة البيانات:
>>> def encode_dataset(examples, max_length=512):
...     questions = examples["question"]
...     words = examples["words"]
...     boxes = examples["boxes"]
...     answers = examples["answer"]

...     # encode the batch of examples and initialize the start_positions and end_positions
...     encoding = tokenizer(questions, words, boxes, max_length=max_length, padding="max_length", truncation=True)
...     start_positions = []
...     end_positions = []

...     # loop through the examples in the batch
...     for i in range(len(questions)):
...         cls_index = encoding["input_ids"][i].index(tokenizer.cls_token_id)

...         # find the position of the answer in example's words
...         words_example = [word.lower() for word in words[i]]
...         answer = answers[i]
...         match, word_idx_start, word_idx_end = subfinder(words_example, answer.lower().split())

...         if match:
...             # if match is found, use `token_type_ids` to find where words start in the encoding
...             token_type_ids = encoding["token_type_ids"][i]
...             token_start_index = 0
...             while token_type_ids[token_start_index] != 1:
...                 token_start_index += 1

...             token_end_index = len(encoding["input_ids"][i]) - 1
...             while token_type_ids[token_end_index] != 1:
...                 token_end_index -= 1

...             word_ids = encoding.word_ids(i)[token_start_index : token_end_index + 1]
...             start_position = cls_index
...             end_position = cls_index

...             # loop over word_ids and increase `token_start_index` until it matches the answer position in words
...             # once it matches, save the `token_start_index` as the `start_position` of the answer in the encoding
...             for id in word_ids:
...                 if id == word_idx_start:
...                     start_position = token_start_index
...                 else:
...                     token_start_index += 1

...             # similarly loop over `word_ids` starting from the end to find the `end_position` of the answer
...             for id in word_ids[::-1]:
...                 if id == word_idx_end:
...                     end_position = token_end_index
...                 else:
...                     token_end_index -= 1

...             start_positions.append(start_position)
...             end_positions.append(end_position)

...         else:
...             start_positions.append(cls_index)
...             end_positions.append(cls_index)

...     encoding["image"] = examples["image"]
...     encoding["start_positions"] = start_positions
...     encoding["end_positions"] = end_positions

...     return encoding
الآن، بما أن لدينا دالة المعالجة المسبقة هذه، يمكننا ترميز مجموعة البيانات بأكملها:
>>> encoded_train_dataset = dataset_with_ocr["train"].map(
...     encode_dataset, batched=True, batch_size=2, remove_columns=dataset_with_ocr["train"].column_names
... )
>>> encoded_test_dataset = dataset_with_ocr["test"].map(
...     encode_dataset, batched=True, batch_size=2, remove_columns=dataset_with_ocr["test"].column_names
... )
لننظر إلى شكل الميزات في مجموعة البيانات المُرمّزة:
>>> encoded_train_dataset.features
{'image': Sequence(feature=Sequence(feature=Sequence(feature=Value(dtype='uint8', id=None), length=-1, id=None), length=-1, id=None), length=-1, id=None),
 'input_ids': Sequence(feature=Value(dtype='int32', id=None), length=-1, id=None),
 'token_type_ids': Sequence(feature=Value(dtype='int8', id=None), length=-1, id=None),
 'attention_mask': Sequence(feature=Value(dtype='int8', id=None), length=-1, id=None),
 'bbox': Sequence(feature=Sequence(feature=Value(dtype='int64', id=None), length=-1, id=None), length=-1, id=None),
 'start_positions': Value(dtype='int64', id=None),
 'end_positions': Value(dtype='int64', id=None)}
التقييم
يتطلب تقييم الإجابة على أسئلة المستندات كمية كبيرة من المعالجة اللاحقة. لتجنب استهلاك الكثير من وقتك، يتخطى هذا الدليل خطوة التقييم. لا يزال Trainer يحسب خسارة التقييم أثناء التدريب، لذا فأنت لست في عماية تامة بشأن أداء نموذجك. يتم تقييم الإجابة الاستخراجية على الأسئلة عادةً باستخدام F1/المطابقة التامة. إذا كنت ترغب في تنفيذه بنفسك، فاطّلع على فصل الإجابة على الأسئلة في دورة Hugging Face للحصول على إلهام.
تدريب
تهانينا! لقد تجاوزت بنجاح أصعب جزء من هذا الدليل، وأنت الآن مستعد لتدريب نموذجك الخاص. يتضمن التدريب الخطوات التالية:
- حمّل النموذج باستخدام AutoModelForDocumentQuestionAnswering مع استخدام نفس نقطة التفتيش المستخدمة في المعالجة المسبقة.
- حدد معاملات التدريب الفائقة في TrainingArguments.
- عرّف دالةً لدمج الأمثلة في دفعات، وهنا سيكون DefaultDataCollator مناسبًا تمامًا.
- مرّر حُجج التدريب إلى Trainer مع النموذج ومجموعة البيانات ومُجمِّع البيانات.
- استدعِ train() لضبط نموذجك.
>>> from transformers import AutoModelForDocumentQuestionAnswering

>>> model = AutoModelForDocumentQuestionAnswering.from_pretrained(model_checkpoint)
في TrainingArguments استخدم output_dir لتحديد مكان حفظ نموذجك، واضبط المعاملات الفائقة كما تراه مناسباً.
إذا كنت ترغب في مشاركة نموذجك مع المجتمع، فاضبط push_to_hub على True (يجب أن تكون مسجلاً الدخول إلى Hugging Face لرفع نموذجك).
في هذه الحالة، سيكون output_dir أيضاً هو اسم المستودع الذي سيتم دفع نقطة التفتيش لنموذجك إليه.
>>> from transformers import TrainingArguments

>>> # REPLACE THIS WITH YOUR REPO ID
>>> repo_id = "MariaK/layoutlmv2-base-uncased_finetuned_docvqa"

>>> training_args = TrainingArguments(
...     output_dir=repo_id,
...     per_device_train_batch_size=4,
...     num_train_epochs=20,
...     save_steps=200,
...     logging_steps=50,
...     eval_strategy="steps",
...     learning_rate=5e-5,
...     save_total_limit=2,
...     remove_unused_columns=False,
...     push_to_hub=True,
... )
The input text is a single sentence without any special tags (``, ``, etc.). The sentence is: "Define a simple data collator to batch examples together." Key terms: - "Define": عرّف (Define) - "simple": بسيط (simple) - "data collator": مُجمِّع البيانات (data collator) or مُجمِّع الأمثلة (example collator). In ML context, "collator" is often translated as "مُجمِّع" or "مُجمِّع بيانات". Let's use "مُجمِّع بيانات بسيط" (simple data collator). - "to batch": لتجميع (to batch/group) - "examples": الأمثلة (examples) - "together": معاً (together) Draft 1: عرّف مُجمِّع بيانات بسيط لتجميع الأمثلة معاً. Draft 2: عرّف مُجمِّع بيانات بسيط لغرض تجميع الأمثلة في دفعات. (A bit more technical with "dodahat" for batches, but "batch" here is a verb "to batch"). Let's stick to the direct translation of the verb "to batch". "عرّف مُجمِّع بيانات بسيط لتجميع الأمثلة." (Define a simple data collator to batch examples.) Adding "معاً" (together) makes it flow better in Arabic. "عرّف مُجمِّع بيانات بسيط لتجميع الأمثلة معاً." Let's check if "data collator" has a standard translation. In Hugging Face docs, it's often referred to as "DataCollator". Translating it as "مُجمِّع بيانات" is accurate. Final check: عرّف مُجمِّع بيانات بسيط لتجميع الأمثلة معاً. عرّف مُجمِّع بيانات بسيط لتجميع الأمثلة معاً.
>>> from transformers import DefaultDataCollator

>>> data_collator = DefaultDataCollator()
أخيرًا، اجمع كل شيء، واستدعِ train():
>>> from transformers import Trainer

>>> trainer = Trainer(
...     model=model,
...     args=training_args,
...     data_collator=data_collator,
...     train_dataset=encoded_train_dataset,
...     eval_dataset=encoded_test_dataset,
...     processing_class=processor,
... )

>>> trainer.train()
لإضافة النموذج النهائي إلى 🤗 Hub، أنشئ بطاقة نموذج واستدعِ push_to_hub:
>>> trainer.create_model_card()
>>> trainer.push_to_hub()
الاستدلال
الآن بعد أن قمت بتدريب نموذج LayoutLMv2 بدقة، ورفعته إلى 🤗 Hub، يمكنك استخدامه للاستدلال. أبسط طريقة لتجربة النموذج المدرَّب بدقة في الاستدلال هي استخدامه في Pipeline.
لنأخذ مثالاً:
>>> example = dataset["test"][2]
>>> question = example["query"]["en"]
>>> image = example["image"]
>>> print(question)
>>> print(example["answers"])
'Who is ‘presiding’ TRRF GENERAL SESSION (PART 1)?'
['TRRF Vice President', 'lee a. waller']
بعد ذلك، أنشئ كائنًا من pipeline للإجابة على أسئلة المستندات باستخدام نموذجك، وقم بتمرير مجموعة الصورة والسؤال إليه.
>>> from transformers import pipeline

>>> qa_pipeline = pipeline("document-question-answering", model="MariaK/layoutlmv2-base-uncased_finetuned_docvqa")
>>> qa_pipeline(image, question)
[{'score': 0.9949808120727539,
  'answer': 'Lee A. Waller',
  'start': 55,
  'end': 57}]
يمكنك أيضًا إعادة إنتاج نتائج خط الأنابيب يدويًا إذا رغبت في ذلك:
- خذ صورةً وسؤالاً، ثم جهّزهما للنموذج باستخدام المعالج الخاص بنموذجك.
- مرّر النتيجة أو المعالجة المسبقة عبر النموذج.
- يعيد النموذج
start_logitsوend_logits، والتي تُظهر أي رمز يقع في بداية الإجابة وأي رمز يقع في نهايتها. وكلاهما له الشكل (batch_size, sequence_length). - قم بتطبيق argmax على البُعد الأخير لكلٍّ من
start_logitsوend_logitsللحصول علىstart_idxوend_idxالمتنبأ بهما. - فكّ ترميز الإجابة باستخدام مرمّز الرموز.
>>> import torch
>>> from transformers import AutoProcessor
>>> from transformers import AutoModelForDocumentQuestionAnswering

>>> processor = AutoProcessor.from_pretrained("MariaK/layoutlmv2-base-uncased_finetuned_docvqa")
>>> model = AutoModelForDocumentQuestionAnswering.from_pretrained("MariaK/layoutlmv2-base-uncased_finetuned_docvqa")

>>> with torch.no_grad():
...     encoding = processor(image.convert("RGB"), question, return_tensors="pt")
...     outputs = model(**encoding)
...     start_logits = outputs.start_logits
...     end_logits = outputs.end_logits
...     predicted_start_idx = start_logits.argmax(-1).item()
...     predicted_end_idx = end_logits.argmax(-1).item()

>>> processor.tokenizer.decode(encoding.input_ids.squeeze()[predicted_start_idx : predicted_end_idx + 1])
'lee a. waller'