
Transformers documentation
وصف الصور
وصف الصور
تتضمن مهمة وصف الصور التنبؤ بوصف لصورة معينة. ومن التطبيقات الشائعة في العالم الحقيقي المساعدة في تنقل الأشخاص ذوي الإعاقة البصرية عبر مواقف مختلفة. وبالتالي، يساعد وصف الصور في تحسين إمكانية الوصول إلى المحتوى للأشخاص من خلال وصف الصور لهم.
ستُظهر لك هذه الدليل كيفية:
- قم بضبط نموذج وصف الصور بدقة.
- استخدم النموذج المُحسَّن للاستدلال.
قبل أن تبدأ، تأكد من تثبيت جميع المكتبات اللازمة:
pip install transformers datasets evaluate -q
pip install jiwer -q
ننصحك بتسجيل الدخول إلى حسابك على Hugging Face حتى تتمكن من رفع نموذجك ومشاركته مع المجتمع. عند الطلب، أدخل رمزك (token) لتسجيل الدخول:
from huggingface_hub import notebook_login

notebook_login()
تحميل مجموعة بيانات تسميات Pokémon BLIP
استخدم مكتبة 🤗 Dataset لتحميل مجموعة بيانات تتكون من أزواج {image-caption}. لإنشاء مجموعة بيانات خاصة بك لتسمية الصور في PyTorch، يمكنك اتباع هذا الدفتر.
from datasets import load_dataset

ds = load_dataset("lambdalabs/pokemon-blip-captions")
dsDatasetDict({
train: Dataset({
features: ['image', 'text'],
num_rows: 833
})
})تحتوي مجموعة البيانات على ميزتين، وهما image وtext.
تحتوي العديد من مجموعات بيانات وصف الصور على عدة أوصاف لكل صورة. في تلك الحالات، تُعدّ استراتيجية شائعة هي أخذ عينة عشوائية من وصف واحد بين الأوصاف المتاحة أثناء التدريب.
قسّم مجموعة التدريب (train split) من مجموعة البيانات إلى مجموعة تدريب ومجموعة اختبار باستخدام طريقة train_test_split:
ds = ds["train"].train_test_split(test_size=0.1)
train_ds = ds["train"]
test_ds = ds["test"]
لنقم بتصور بعض العينات من مجموعة التدريب.
from textwrap import wrap
import matplotlib.pyplot as plt
import numpy as np


def plot_images(images, captions):
    plt.figure(figsize=(20, 20))
    for i in range(len(images)):
        ax = plt.subplot(1, len(images), i + 1)
        caption = captions[i]
        caption = "\n".join(wrap(caption, 12))
        plt.title(caption)
        plt.imshow(images[i])
        plt.axis("off")


sample_images_to_visualize = [np.array(train_ds[i]["image"]) for i in range(5)]
sample_captions = [train_ds[i]["text"] for i in range(5)]
plot_images(sample_images_to_visualize, sample_captions)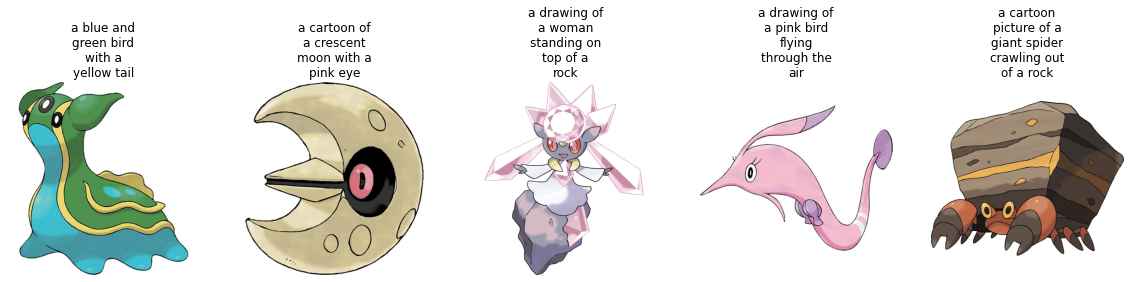
معالجة مجموعة البيانات مسبقًا
بما أن مجموعة البيانات تحتوي على نمطين (صورة ونص)، فإن خط المعالجة المسبقة سيقوم بمعالجة الصور والتعليقات التوضيحية مسبقًا.
لتنفيذ ذلك، حمّل فئة المعالج المرتبطة بالنموذج الذي ستقوم بتدريبه الدقيق.
from transformers import AutoProcessor

checkpoint = "microsoft/git-base"
processor = AutoProcessor.from_pretrained(checkpoint)
سيقوم المعالج بمعالجة الصورة مسبقاً داخلياً (والتي تتضمن تغيير الحجم، وتقييس البكسلات) وتحويل الوصف إلى رموز.
def transforms(example_batch):
    images = [x for x in example_batch["image"]]
    captions = [x for x in example_batch["text"]]
    inputs = processor(images=images, text=captions, padding="max_length")
    inputs.update({"labels": inputs["input_ids"]})
    return inputs


train_ds.set_transform(transforms)
test_ds.set_transform(transforms)
بعد تجهيز مجموعة البيانات، يمكنك الآن إعداد النموذج للضبط الدقيق.
تحميل نموذج أساسي
حمّل “microsoft/git-base” في كائن AutoModelForCausalLM.
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(checkpoint)
تقييم
تُقيَّم نماذج وصف الصور عادةً باستخدام درجة Rouge أو معدل خطأ الكلمة. في هذا الدليل، ستستخدم معدل خطأ الكلمة (WER).
نستخدم مكتبة 🤗 Evaluate للقيام بذلك. للاطلاع على القيود المحتملة وغيرها من المصاعب المتعلقة بمقياس WER، راجع هذا الدليل.
from evaluate import load
import torch

wer = load("wer")


def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predicted = logits.argmax(-1)
    decoded_labels = processor.batch_decode(labels, skip_special_tokens=True)
    decoded_predictions = processor.batch_decode(predicted, skip_special_tokens=True)
    wer_score = wer.compute(predictions=decoded_predictions, references=decoded_labels)
    return {"wer_score": wer_score}
تدريب
الآن، أنت مستعد لبدء ضبط النموذج. ستستخدم Trainer من 🤗 لهذا الغرض.
أولاً، عرّف معاملات التدريب باستخدام TrainingArguments.
from transformers import TrainingArguments, Trainer

model_name = checkpoint.split("/")[1]

training_args = TrainingArguments(
    output_dir=f"{model_name}-pokemon",
    learning_rate=5e-5,
    num_train_epochs=50,
    fp16=True,
    per_device_train_batch_size=32,
    per_device_eval_batch_size=32,
    gradient_accumulation_steps=2,
    save_total_limit=3,
    eval_strategy="steps",
    eval_steps=50,
    save_strategy="steps",
    save_steps=50,
    logging_steps=50,
    remove_unused_columns=False,
    push_to_hub=True,
    label_names=["labels"],
    load_best_model_at_end=True,
)
ثم مررهما مع مجموعات البيانات والنموذج إلى 🤗 Trainer.
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_ds,
    eval_dataset=test_ds,
    compute_metrics=compute_metrics,
)
لبدء التدريب، ما عليك سوى استدعاء train() على كائن Trainer.
trainer.train()
يجب أن تلاحظ انخفاضاً سلساً في خسارة التدريب مع تقدم عملية التدريب.
بمجرد اكتمال التدريب، شارك نموذجك على Hub باستخدام طريقة push_to_hub() ليتمكن الجميع من استخدام نموذجك:
trainer.push_to_hub()
الاستدلال
خذ صورة عينة من test_ds لاختبار النموذج.
from PIL import Image
import requests

url = "https://huggingface.co/datasets/sayakpaul/sample-datasets/resolve/main/pokemon.png"
image = Image.open(requests.get(url, stream=True).raw)
image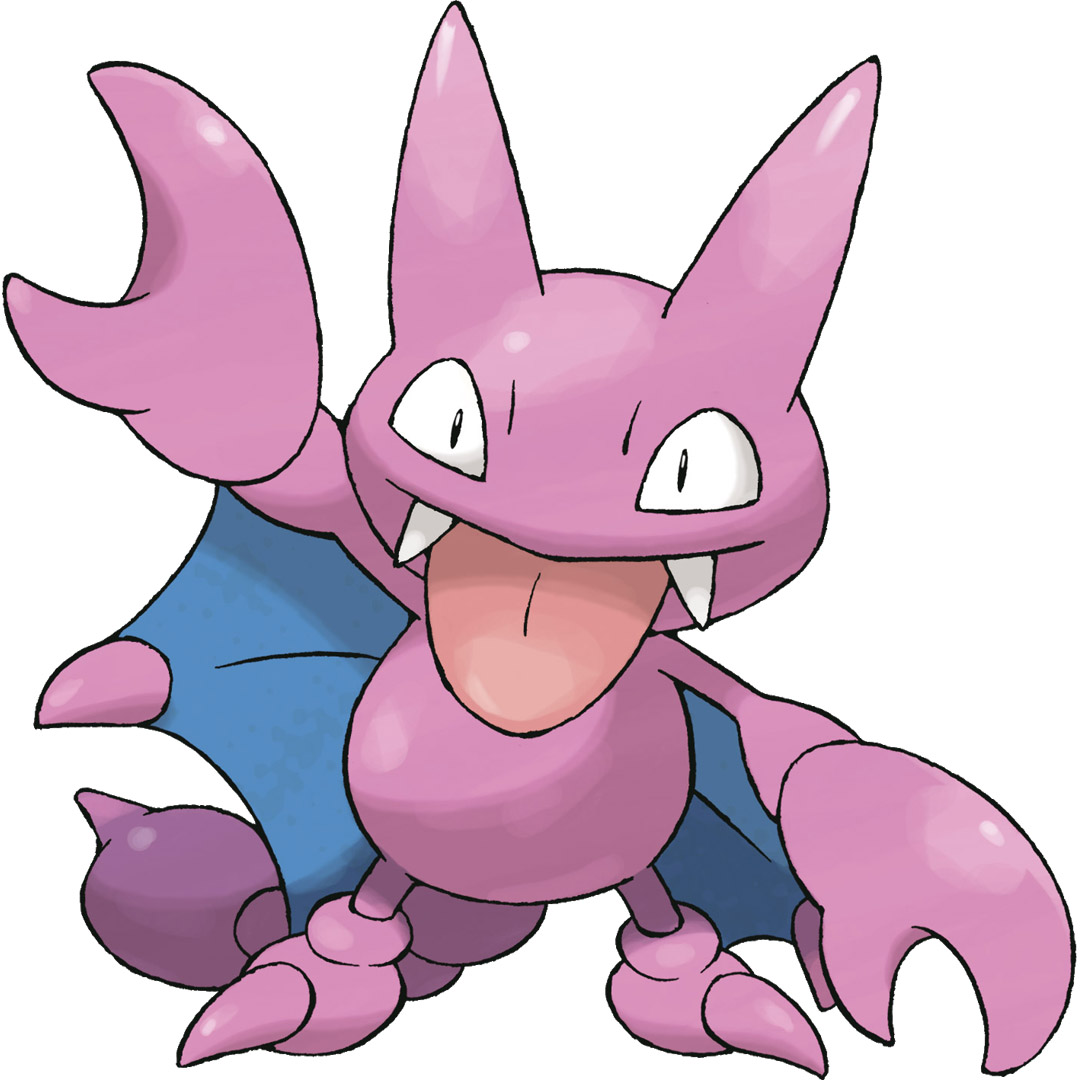
جهّز الصورة للنموذج.
from accelerate import Accelerator

device = Accelerator().device
inputs = processor(images=image, return_tensors="pt").to(device)
pixel_values = inputs.pixel_values
استدعِ generate وفكّ ترميز التنبؤات.
generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
generated_caption = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_caption)a drawing of a pink and blue pokemon
يبدو أن النموذج المُحسَّن ولّد عنوانًا وصفيًا جيدًا إلى حد كبير!
Update on GitHub