
Transformers documentation
تصنيف الصور بدون تدريب مسبق
تصنيف الصور بدون تدريب مسبق
تصنيف الصور بدون تدريب مسبق هو مهمة تتضمن تصنيف الصور إلى فئات مختلفة باستخدام نموذج لم يتم تدريبه صراحةً على بيانات تحتوي على أمثلة موسومة من تلك الفئات المحددة.
تتطلب تصنيف الصور تقليدياً تدريب نموذج على مجموعة محددة من الصور الموسومة، ويتعلم هذا النموذج «ربط» سمات معينة في الصور بالتسميات. وعندما تكون هناك حاجة إلى استخدام مثل هذا النموذج في مهمة تصنيف تُدخل مجموعة جديدة من التسميات، يلزم إجراء الضبط الدقيق «لإعادة معايرة» النموذج.
في المقابل، تُعدّ نماذج تصنيف الصور بدون تدريب مسبق أو ذات المفردات المفتوحة عادةً نماذج متعددة الوسائط تم تدريبها على مجموعة بيانات كبيرة من الصور والأوصاف المرتبطة بها. تتعلّم هذه النماذج تمثيلات مرئية-لغوية متسقة يمكن استخدامها في العديد من المهام اللاحقة، بما في ذلك تصنيف الصور بدون تدريب مسبق.
هذا نهج أكثر مرونة لتصنيف الصور، يتيح للنماذج التعميم على فئات جديدة وغير مرئية دون الحاجة إلى بيانات تدريب إضافية، ويُمكّن المستخدمين من الاستعلام عن الصور باستخدام أوصاف نصية حرة للأهداف المراد البحث عنها.
في هذا الدليل ستتعلم كيفية:
- إنشاء خط أنابيب لتصنيف الصور بدون تدريب مسبق
- تشغيل استنتاج تصنيف الصور بدون تدريب يدويًا
قبل أن تبدأ، تأكد من تثبيت جميع المكتبات اللازمة:
pip install -q "transformers[torch]" pillowخط أنابيب تصنيف الصور بدون تدريب مسبق
أبسط طريقة لتجربة الاستدلال باستخدام نموذج يدعم تصنيف الصور بدون تدريب مسبق هي استخدام pipeline() المقابل. أنشئ خط أنابيب من نقطة تحقق على Hugging Face Hub:
>>> from transformers import pipeline

>>> checkpoint = "openai/clip-vit-large-patch14"
>>> detector = pipeline(model=checkpoint, task="zero-shot-image-classification")
بعد ذلك، اختر صورة تريد تصنيفها.
>>> from PIL import Image
>>> import requests

>>> url = "https://unsplash.com/photos/g8oS8-82DxI/download?ixid=MnwxMjA3fDB8MXx0b3BpY3x8SnBnNktpZGwtSGt8fHx8fDJ8fDE2NzgxMDYwODc&force=true&w=640"
>>> image = Image.open(requests.get(url, stream=True).raw)

>>> image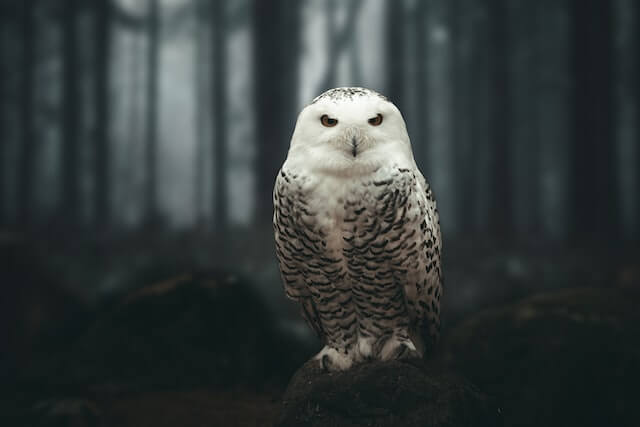
مرّر الصورة وتسميات الكائنات المرشحة إلى خط الأنابيب. هنا نمرر الصورة مباشرةً؛ وتشمل الخيارات المناسبة الأخرى مسارًا محليًا لصورة أو عنوان URL لصورة. يمكن أن تكون التسميات المرشحة كلمات بسيطة كما في هذا المثال، أو أكثر وصفًا.
>>> predictions = detector(image, candidate_labels=["fox", "bear", "seagull", "owl"])
>>> predictions
[{'score': 0.9996670484542847, 'label': 'owl'},
 {'score': 0.000199399160919711, 'label': 'seagull'},
 {'score': 7.392891711788252e-05, 'label': 'fox'},
 {'score': 5.96074532950297e-05, 'label': 'bear'}]
تصنيف الصور بدون تدريب يدوي
الآن بعد أن اطلعتَ على كيفية استخدام خط أنابيب تصنيف الصور بدون تدريب مسبق، دعنا ننظر إلى كيفية تشغيل تصنيف الصور بدون تدريب مسبق يدويًا.
ابدأ بتحميل النموذج والمعالج المرتبط به من نقطة تحقق على Hugging Face Hub. سنستخدم هنا نفس نقطة التحقق التي استخدمناها سابقًا:
>>> from transformers import AutoProcessor, AutoModelForZeroShotImageClassification

>>> model = AutoModelForZeroShotImageClassification.from_pretrained(checkpoint)
>>> processor = AutoProcessor.from_pretrained(checkpoint)
لنأخذ صورة مختلفة لتغيير الأمور.
>>> from PIL import Image
>>> import requests

>>> url = "https://unsplash.com/photos/xBRQfR2bqNI/download?ixid=MnwxMjA3fDB8MXxhbGx8fHx8fHx8fHwxNjc4Mzg4ODEx&force=true&w=640"
>>> image = Image.open(requests.get(url, stream=True).raw)

>>> image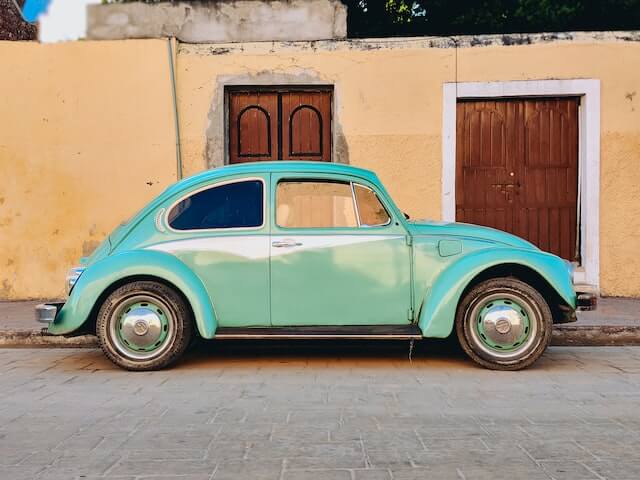
استخدم المعالج processor لتحضير المدخلات للنموذج. يجمع المعالج بين معالج صور image processor يقوم بتحضير الصورة للنموذج عن طريق تغيير حجمها وتطبيعها، ومجزئ tokenizer يتولى معالجة مدخلات النص.
>>> candidate_labels = ["tree", "car", "bike", "cat"]
# follows the pipeline prompt template to get same results
>>> candidate_labels = [f'This is a photo of {label}.' for label in candidate_labels]
>>> inputs = processor(images=image, text=candidate_labels, return_tensors="pt", padding=True)
مرّر المدخلات عبر النموذج، ثم عالج النتائج بعد المعالجة:
>>> import torch

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> logits = outputs.logits_per_image[0]
>>> probs = logits.softmax(dim=-1).numpy()
>>> scores = probs.tolist()

>>> result = [
...     {"score": score, "label": candidate_label}
...     for score, candidate_label in sorted(zip(probs, candidate_labels), key=lambda x: -x[0])
... ]

>>> result
[{'score': 0.998572, 'label': 'car'},
 {'score': 0.0010570387, 'label': 'bike'},
 {'score': 0.0003393686, 'label': 'tree'},
 {'score': 3.1572064e-05, 'label': 'cat'}]