
Transformers documentation
توليد الأقنعة
توليد الأقنعة
إن توليد الأقنعة هو مهمة توليد أقنعة ذات دلالة دلالية لصورة. تشبه هذه المهمة تجزئة الصور إلى حد كبير، لكن توجد اختلافات عديدة. تُدرَّب نماذج تجزئة الصور على مجموعات بيانات مُوسومة، وهي محدودة بالفئات التي رأتها أثناء التدريب؛ حيث تُرجع مجموعة من الأقنعة والفئات المقابلة لها عند تقديم صورة.
تُدرب نماذج تولية الأقنعة على كميات كبيرة من البيانات وتعمل في وضعين.
- وضع التوجيه: في هذا الوضع، يستقبل النموذج صورة وتوجيهاً، حيث يمكن أن يكون التوجيه موقعاً ثنائي الأبعاد (إحداثيات XY) داخل الصورة ضمن كائن، أو صندوقاً محيطةً بكائن. في وضع التوجيه، يعيد النموذج فقط القناع (mask) الخاص بالكائن الذي يشير إليه التوجيه.
- وضع تحديد كل شيء: في وضع تحديد كل شيء، عند تقديم صورة، يولّد النموذج جميع الأقنعة الموجودة في الصورة. ولتحقيق ذلك، يتم توليد شبكة من النقاط وتراكبها على الصورة للاستدلال.
- الاستدلال على الفيديو: يقبل النموذج فيديو، بالإضافة إلى نقطة أو مربع تلميح في إطار من إطارات الفيديو، ويتم تتبعه طوال الفيديو. يمكنك الحصول على مزيد من المعلومات حول كيفية تنفيذ الاستدلال على الفيديو من خلال الاطلاع على وثائق SAM 2.
تُؤمَّن مهمة توليد الأقنعة بواسطة نموذج Segment Anything (SAM) ونموذج Segment Anything 2 (SAM2)، بينما يُؤمَّن الاستدلال على الفيديو بواسطة نموذج Segment Anything 2 (SAM2). يُعد SAM نموذجاً قوياً يتكون من مُشفِّر صور يعتمد على Vision Transformer، ومُشفِّر أوامر، ومُفكِّك أقنعة يعمل باتجاهين. تُشفَّر الصور والأوامر، ثم يستقبل المُفكِّك هذه التضمينات ويولّد أقنعة صالحة. وفي الوقت نفسه، يوسّع SAM 2 قدرات SAM من خلال إضافة وحدة ذاكرة لتتبع الأقنعة.
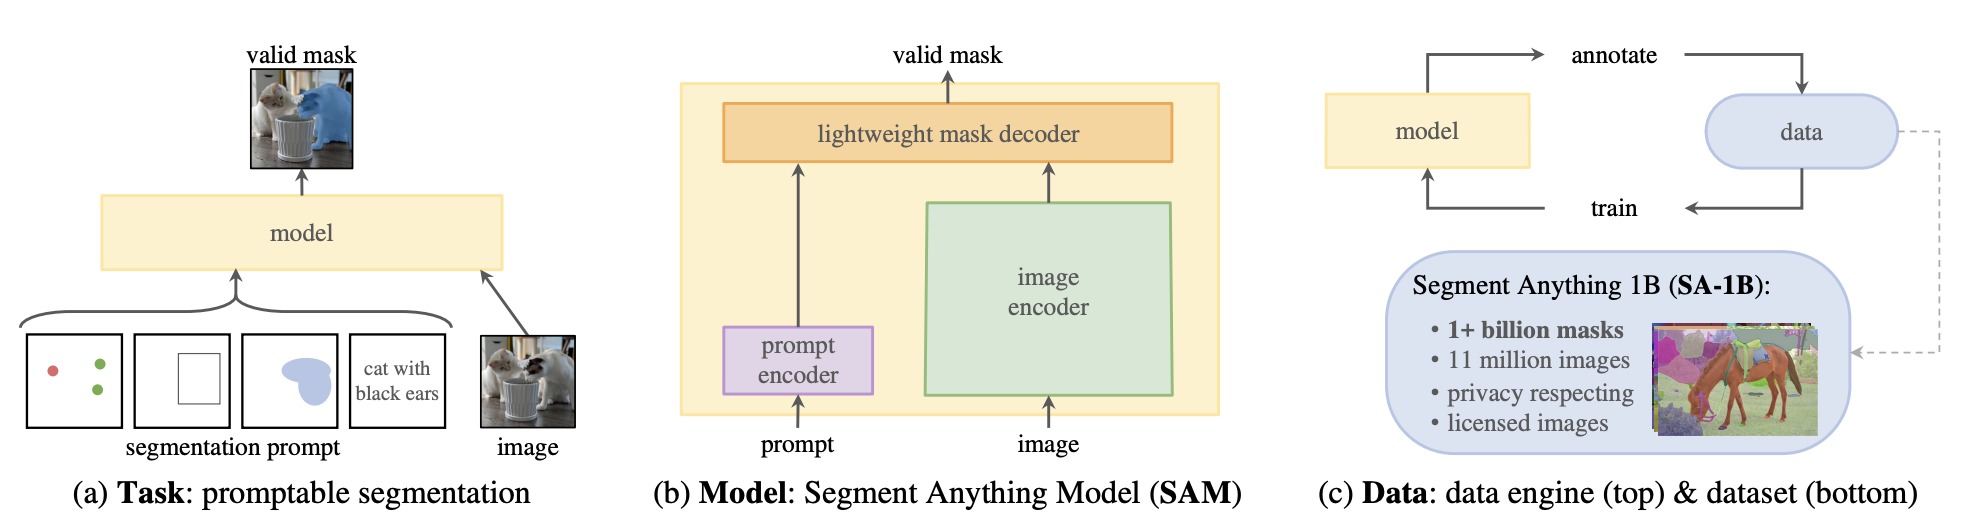
يُعدّ SAM نموذجًا أساسيًا قويًا للتجزئة نظرًا لتغطيته الواسعة للبيانات. وقد تم تدريبه على SA-1B، وهو مجموعة بيانات تضم مليون صورة و1.1 مليار قناع.
في هذا الدليل، ستتعلم كيفية:
- استنتاج في وضع "كل شيء مقسّم" مع الدفعات،
- الاستدلال في وضع تلميح النقاط،
- استنتاج في وضع تلميح الصندوق.
أولاً، لنقم بتثبيت transformers:
pip install -q transformers
خط أنابيب توليد الأقنعة
أسهل طريقة لاستدلال نماذج توليد الأقنعة هي استخدام خط أنابيب mask-generation.
>>> from transformers import pipeline

>>> checkpoint = "facebook/sam2-hiera-base-plus"
>>> mask_generator = pipeline(model=checkpoint, task="mask-generation")
لنلقِ نظرة على الصورة.
from PIL import Image
import requests

img_url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"
image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")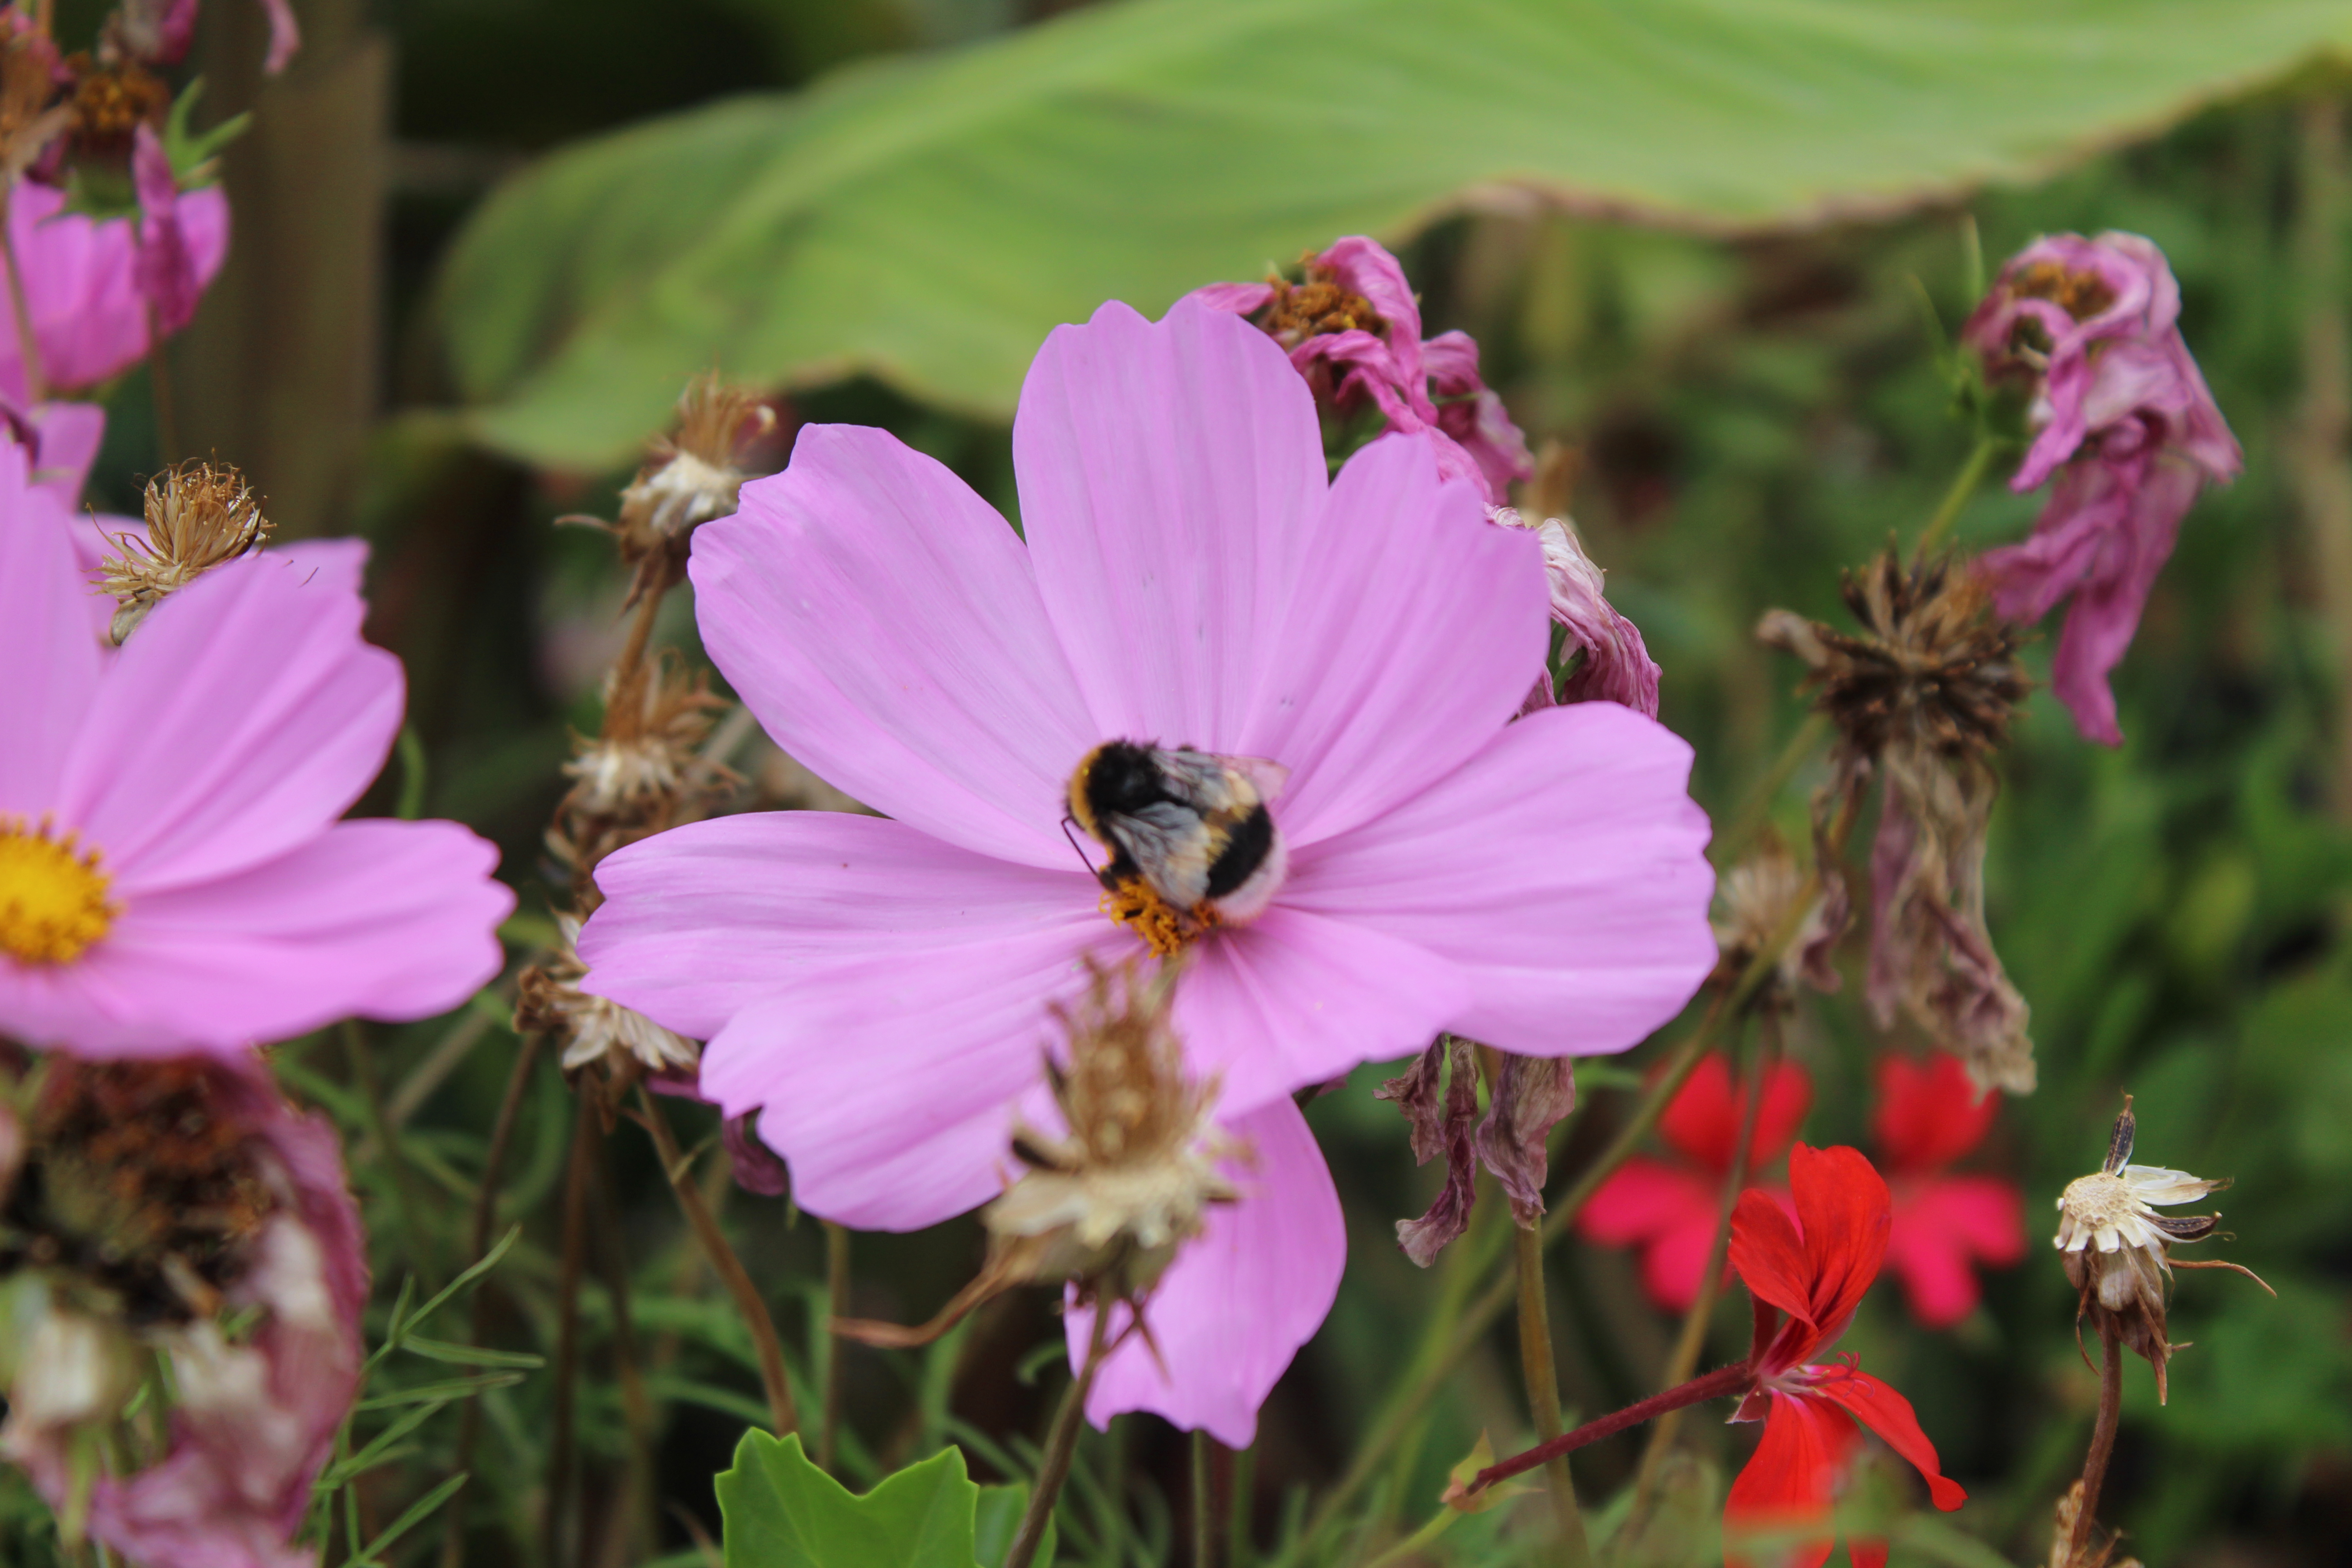
لنجزّئ كل شيء. يتيح points-per-batch الاستدلال المتوازي على النقاط في وضع تجزئة كل شيء. وهذا يتيح استدلالاً أسرع، لكنه يستهلك ذاكرة أكثر. علاوة على ذلك، لا يتيح SAM الدفع (batching) إلا على النقاط وليس على الصور. pred_iou_thresh هو عتبة الثقة لـ IoU، حيث تُعاد فقط الأقنعة التي تتجاوز تلك العتبة المحددة.
masks = mask_generator(image, points_per_batch=128, pred_iou_thresh=0.88)يبدو masks على النحو التالي:
{'masks': [tensor([[False, False, False,  ...,  True,  True,  True],
          [False, False, False,  ...,  True,  True,  True],
          [False, False, False,  ...,  True,  True,  True],
          ...,
          [False, False, False,  ..., False, False, False], ..
 'scores': tensor([0.9874, 0.9793, 0.9780, 0.9776, ... 0.9016])}
يمكننا تصورها على النحو التالي:
import matplotlib.pyplot as plt

plt.imshow(image, cmap='gray')

for i, mask in enumerate(masks["masks"]):
    plt.imshow(mask, cmap='viridis', alpha=0.1, vmin=0, vmax=1)

plt.axis('off')
plt.show()
فيما يلي الصورة الأصلية بالأبيض والأسود مع خرائط ملونة مرسومة فوقها. إنها مبهرة للغاية.
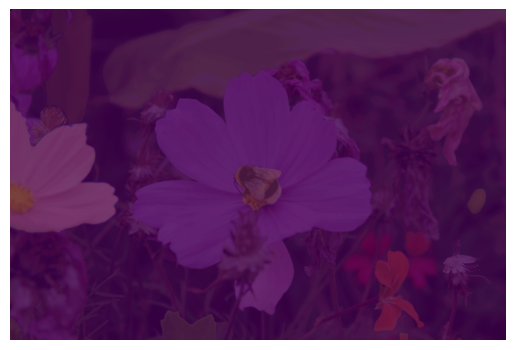
استدلال النموذج
التوجيه بالنقاط
يمكنك أيضًا استخدام النموذج دون خط المعالجة. للقيام بذلك، قم بتهيئة النموذج ومعالج المعالجة.
from transformers import SamModel, SamProcessor
from accelerate import Accelerator
import torch
device = Accelerator().device
model = SamModel.from_pretrained("facebook/sam-vit-base").to(device)
processor = SamProcessor.from_pretrained("facebook/sam-vit-base")
لتنفيذ التلميح بالنقاط، مرّر النقطة المدخلة إلى المعالج، ثم خذ مخرجات المعالج ومرّرها إلى النموذج للاستدلال. لمعالجة مخرجات النموذج بعد الاستدلال، مرّر المخرجات وoriginal_sizes وهي مأخوذة من المخرجات الأولية للمعالج. نحتاج إلى تمرير هذه القيم لأن المعالج يعيد تحجيم الصورة، ويحتاج المخرج إلى أن يُستنتج خارجياً.
input_points = [[[2592, 1728]]] # point location of the bee

inputs = processor(image, input_points=input_points, return_tensors="pt").to(device)
with torch.no_grad():
    outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"].cpu())
يمكننا تصور الأقنعة الثلاثة في المخرجات masks.
import matplotlib.pyplot as plt
import numpy as np

fig, axes = plt.subplots(1, 4, figsize=(15, 5))

axes[0].imshow(image)
axes[0].set_title('Original Image')
mask_list = [masks[0][0][0].numpy(), masks[0][0][1].numpy(), masks[0][0][2].numpy()]

for i, mask in enumerate(mask_list, start=1):
    overlayed_image = np.array(image).copy()

    overlayed_image[:,:,0] = np.where(mask == 1, 255, overlayed_image[:,:,0])
    overlayed_image[:,:,1] = np.where(mask == 1, 0, overlayed_image[:,:,1])
    overlayed_image[:,:,2] = np.where(mask == 1, 0, overlayed_image[:,:,2])

    axes[i].imshow(overlayed_image)
    axes[i].set_title(f'Mask {i}')
for ax in axes:
    ax.axis('off')

plt.show()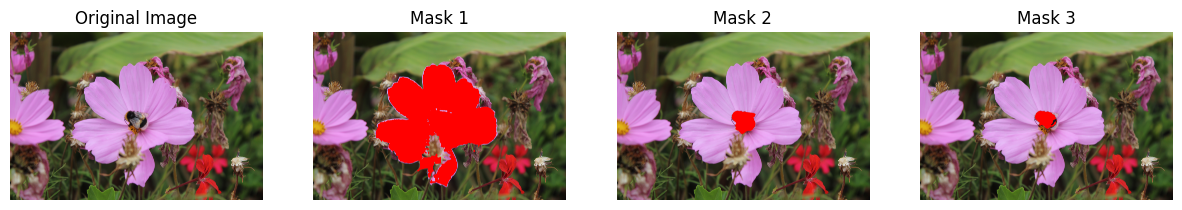
التلميح الصندوق
يمكنك أيضًا تنفيذ تلميح الصندوق (box prompting) بطريقة مشابهة لتلميح النقطة (point prompting). ما عليك سوى تمرير الصندوق المُدخل بصيغة قائمة [x_min, y_min, x_max, y_max] إلى جانب الصورة إلى processor. خذ مخرجات المعالج وتمررها مباشرة إلى النموذج، ثم قم بمعالجة المخرجات مرة أخرى.
# bounding box around the bee
box = [2350, 1600, 2850, 2100]

inputs = processor(
        image,
        input_boxes=[[[box]]],
        return_tensors="pt"
    ).to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

mask = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(),
    inputs["original_sizes"].cpu(),
)[0][0][0].numpy()
يمكنك تصور الصندوق المحيط حول النحلة كما هو موضح أدناه.
import matplotlib.patches as patches

fig, ax = plt.subplots()
ax.imshow(image)

rectangle = patches.Rectangle((2350, 1600), 500, 500, linewidth=2, edgecolor='r', facecolor='none')
ax.add_patch(rectangle)
ax.axis("off")
plt.show()
يمكنك الاطلاع على مخرجات الاستدلال أدناه.
fig, ax = plt.subplots()
ax.imshow(image)
ax.imshow(mask, cmap='viridis', alpha=0.4)

ax.axis("off")
plt.show()
الضبط الدقيق لتوليد الأقنعة
سنقوم بضبط نموذج SAM2.1 على جزء صغير من مجموعة بيانات MicroMat لأغراض تفتيح الصور. نحتاج إلى تثبيت مكتبة monai لاستخدام دالة خسارة DICE، ومكتبة trackio لتسجيل الأقنعة أثناء التدريب.
pip install -q datasets monai trackio
```
We can now load our dataset and take a look.

```python
from datasets import load_dataset

dataset = load_dataset("merve/MicroMat-mini", split="train")
dataset
# Dataset({
#    features: ['image', 'mask', 'prompt', 'image_id', 'object_id', 'sample_idx', 'granularity',
# 'image_path', 'mask_path', 'prompt_path'],  num_rows: 94
#})
نحتاج إلى أعمدة للصورة والقناع والموجّه. نقسم البيانات إلى مجموعات للتدريب والاختبار.
dataset = dataset.train_test_split(test_size=0.1)
train_ds = dataset["train"]
val_ds = dataset["test"]
لنلقِ نظرة على عينة.
train_ds[0] {'image': <PIL.PngImagePlugin.PngImageFile image mode=RGB size=2040x1356>,
'mask': <PIL.PngImagePlugin.PngImageFile image mode=L size=2040x1356>,
'prompt': '{"point": [[137, 1165, 1], [77, 1273, 0], [58, 1351, 0]], "bbox": [0, 701, 251, 1356]}',
'image_id': '0034',
'object_id': '34',
'sample_idx': 1,
'granularity': 'fine',
'image_path': '/content/MicroMat-mini/img/0034.png',
'mask_path': '/content/MicroMat-mini/mask/0034_34.png',
'prompt_path': '/content/MicroMat-mini/prompt/0034_34.json'}الموجّهات هي سلسلة من القواميس، لذا يمكنك الحصول على صناديق الحدود كما هو موضح أدناه.
import json

json.loads(train_ds["prompt"][0])["bbox"]
# [0, 701, 251, 1356]
تصویر صورة وموجّه وقناع كمثال.
import matplotlib.pyplot as plt
import numpy as np

def show_mask(mask, ax):
    color = np.array([0.12, 0.56, 1.0, 0.6])
    mask = np.array(mask)
    h, w = mask.shape
    mask_image = mask.reshape(h, w, 1) * color.reshape(1, 1, 4)
    ax.imshow(mask_image)
    x0, y0, x1, y1 = eval(train_ds["prompt"][0])["bbox"]
    ax.add_patch(
        plt.Rectangle((x0, y0), x1 - x0, y1 - y0,
                      fill=False, edgecolor="lime", linewidth=2))

example = train_ds[0]
image = np.array(example["image"])
ground_truth_mask = np.array(example["mask"])

fig, ax = plt.subplots()
ax.imshow(image)
show_mask(ground_truth_mask, ax)
ax.set_title("Ground truth mask")
ax.set_axis_off()

plt.show()
الآن يمكننا تعريف مجموعة البيانات الخاصة بنا لتحميل البيانات. يلتف SAMDataset حول مجموعة البيانات الخاصة بنا ويصيغ كل عينة بالطريقة التي يتوقعها معالج SAM. لذا، بدلاً من الصور الخام والأقنعة، ستحصل على صور مُعالجة، وصناديق محيطة، وأقنعة صحيحة جاهزة للتدريب.
بشكل افتراضي، يعيد المُعالِج (processor) تصغير الصور، لذا إلى جانب الصور والأقنعة، يعيد أيضًا الأحجام الأصلية. كما نحتاج إلى تحويل القناع إلى ثنائي (binarize) لأن قيمته تتراوح بين [0, 255].
from torch.utils.data import Dataset
import torch

class SAMDataset(Dataset):
  def __init__(self, dataset, processor):
    self.dataset = dataset
    self.processor = processor

  def __len__(self):
    return len(self.dataset)

  def __getitem__(self, idx):
    item = self.dataset[idx]
    image = item["image"]
    prompt = eval(item["prompt"])["bbox"]
    inputs = self.processor(image, input_boxes=[[prompt]], return_tensors="pt")
    inputs["ground_truth_mask"] = (np.array(item["mask"]) > 0).astype(np.float32)
    inputs["original_image_size"] = torch.tensor(image.size[::-1])


    return inputs
يمكننا تهيئة المعالج ومجموعة البيانات باستخدامه.
from transformers import Sam2Processor

processor = Sam2Processor.from_pretrained("facebook/sam2.1-hiera-small")
train_dataset = SAMDataset(dataset=train_ds, processor=processor)
```

We need to define a data collator that will turn varying size of ground truth masks to batches of reshaped masks in same shape. We reshape them using nearest neighbor interpolation. We also make batched tensors for rest of the elements in the batch. If your masks are all of same size, feel free to skip this step.

```python
import torch.nn.functional as F

def collate_fn(batch, target_hw=(256, 256)):

    pixel_values = torch.cat([item["pixel_values"] for item in batch], dim=0)
    original_sizes = torch.stack([item["original_sizes"] for item in batch])
    input_boxes = torch.cat([item["input_boxes"] for item in batch], dim=0)
    ground_truth_masks = torch.cat([
        F.interpolate(
            torch.as_tensor(x["ground_truth_mask"]).unsqueeze(0).unsqueeze(0).float(),
            size=(256, 256),
            mode="nearest"
        )
        for x in batch
    ], dim=0).long()

    return {
        "pixel_values": pixel_values,
        "original_sizes": original_sizes,
        "input_boxes": input_boxes,
        "ground_truth_mask": ground_truth_masks,
        "original_image_size": torch.stack([item["original_image_size"] for item in batch]),
    }

from torch.utils.data import DataLoader
train_dataloader = DataLoader(
    train_dataset,
    batch_size=4,
    shuffle=True,
    collate_fn=collate_fn,
)
لنلقِ نظرة على ما يُنتجه مُحمِّل البيانات.
batch = next(iter(train_dataloader))
for k,v in batch.items():
  print(k,v.shape)

# pixel_values torch.Size([4, 3, 1024, 1024])
# original_sizes torch.Size([4, 1, 2])
# input_boxes torch.Size([4, 1, 4])
# ground_truth_mask torch.Size([4, 1, 256, 256])
#original_image_size torch.Size([4, 2])
سنقوم الآن بتحميل النموذج وتجميد مُشفِّر الرؤية ومُشفِّر المُوجِّه لتدريب مُفكِّك القناع فقط.
from transformers import Sam2Model

model = Sam2Model.from_pretrained("facebook/sam2.1-hiera-small")

for name, param in model.named_parameters():
  if name.startswith("vision_encoder") or name.startswith("prompt_encoder"):
    param.requires_grad_(False)
```

We can now define the optimizer and the loss function.
```python
from torch.optim import Adam
import monai

optimizer = Adam(model.mask_decoder.parameters(), lr=1e-5, weight_decay=0)
seg_loss = monai.losses.DiceCELoss(sigmoid=True, squared_pred=True, reduction='mean')
لننظر إلى أداء النموذج قبل التدريب.
import matplotlib.pyplot as plt

item = val_ds[1]
img = item["image"]
bbox = json.loads(item["prompt"])["bbox"]
inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

with torch.no_grad():
  outputs = model(**inputs)

masks = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]
preds = masks.squeeze(0)
mask = (preds[0] > 0).cpu().numpy()

overlay = np.asarray(img, dtype=np.uint8).copy()
overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)

plt.imshow(overlay)
plt.axis("off")
plt.show()
نحتاج إلى تسجيل تنبؤاتنا في trackio حتى نتمكن من مراقبة تحسّن النموذج أثناء التدريب.
from PIL import Image
import trackio
import json


@torch.no_grad()
def predict_fn(img, bbox):

  inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

  with torch.no_grad():
      outputs = model(**inputs)

  masks = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]
  return masks

def log_eval_masks_trackio(dataset, indices, step, predict_fn,  project=None, sample_cap=8):
    logs = {"eval/step": int(step)}
    for idx in indices[:sample_cap]:
        item = dataset[idx]
        img = item["image"]
        bbox = json.loads(item["prompt"])["bbox"]
        preds = predict_fn(img, bbox)
        preds = preds.squeeze(0)
        mask = (preds[0] > 0).cpu().numpy()

        overlay = np.asarray(img, dtype=np.uint8).copy()
        overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)
        logs[f"{idx}/overlay"] = trackio.Image(overlay, caption="overlay")

    trackio.log(logs)
يمكننا الآن كتابة حلقة التدريب والتدريب!
لاحظ كيف نسجّل خسارة النموذج وأقنعة التقييم باستخدام trackio.
from tqdm import tqdm
from statistics import mean
import trackio
import torch

num_epochs = 30

device = torch.accelerator.current_accelerator().type if torch.accelerator.is_available() else "cpu"
model.to(device)

model.train()
trackio.init(project="mask-eval")
for epoch in range(num_epochs):
    epoch_losses = []
    for batch in tqdm(train_dataloader):
      outputs = model(pixel_values=batch["pixel_values"].to(device),
                      input_boxes=batch["input_boxes"].to(device),
                      multimask_output=False)

      predicted_masks = outputs.pred_masks.squeeze(1)
      ground_truth_masks = batch["ground_truth_mask"].float().to(device)
      loss = seg_loss(predicted_masks, ground_truth_masks)

      optimizer.zero_grad()
      loss.backward()

      optimizer.step()
      epoch_losses.append(loss.item())

    log_eval_masks_trackio(dataset=val_ds, indices=[0, 3, 6, 9], step=epoch, predict_fn=predict_fn, project="mask-eval")
    print(f'Epoch: {epoch}')
    print(f'Mean loss: {mean(epoch_losses)}')
    trackio.log({"loss": mean(epoch_losses)})

trackio.finish()
لنضع النموذج المُدرَّب في الاختبار.
import matplotlib.pyplot as plt

item = val_ds[1]
img = item["image"]
bbox = json.loads(item["prompt"])["bbox"]

inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

with torch.no_grad():
  outputs = model(**inputs)

preds = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]

preds = preds.squeeze(0)
mask = (preds[0] > 0).cpu().numpy()

overlay = np.asarray(img, dtype=np.uint8).copy()
overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)

plt.imshow(overlay)
plt.axis("off")
plt.show()
تحسّن كبير بعد التدريب لمدة 20 دورة فقط على مجموعة بيانات صغيرة!
