
Transformers documentation
SAM
نُشر هذا النموذج في أوراق HF في 2023-04-05، وسُهم به في Hugging Face Transformers في 2023-04-19.
SAM
نظرة عامة
قُدِّم نموذج SAM (نموذج تقسيم أي شيء) في تقسيم أي شيء بواسطة ألكسندر كيريلوف، وإريك مينتون، ونيكهلا رافي، وهانزي ماو، وكلوي رولاند، ولورا غوستافسون، وتيتي شياو، وسبنسر وايتهد، وأليكس بيرغ، ووان-يين لو، وبيوتر دولار، وروس غيرشيك.
يمكن استخدام النموذج للتنبؤ بأقنعة تجزئة لأي كائن ذي اهتمام، عند تقديم صورة مدخلات.
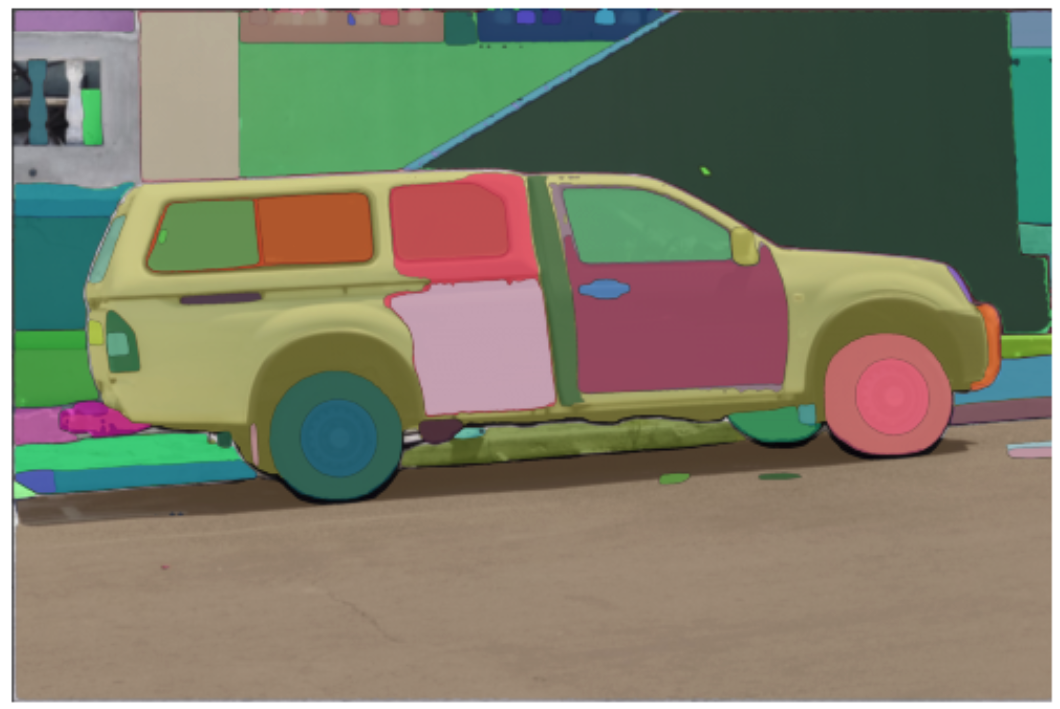
المستخلص من الورقة البحثية هو كالتالي:
نقدّم مشروع Segment Anything (SA): مهمة ونموذج ومجموعة بيانات جديدة لتجزئة الصور. باستخدام نموذجنا الفعّال في حلقة جمع البيانات، بنينا أكبر مجموعة بيانات للتجزئة حتى الآن (بفارق كبير)، تضم أكثر من مليار قناع على 11 مليون صورة مرخّصة تحترم الخصوصية. صُمّم النموذج ودُرّب ليكون قابلاً للتوجيه (promptable)، مما يتيح له الانتقال بدون تدريب مسبق (zero-shot) إلى توزيعات ومهام جديدة للصور. قمنا بتقييم قدراته على عدد كبير من المهام، ووجدنا أن أدائه بدون تدريب مسبق مثير للإعجاب — وغالبًا ما يكون تنافسيًا مع النتائج الإشرافية الكاملة السابقة أو حتى يتفوق عليها. نحن نطلق نموذج Segment Anything (SAM) والمجموعة البيانات المقابلة (SA-1B) التي تضم 1 مليار قناع و11 مليون صورة على https://segment-anything.com لتعزيز البحث في النماذج الأساسية لرؤية الحاسوب.
نصائح:
- يتنبأ النموذج بأقنعة ثنائية تحدد وجود الكائن محل الاهتمام أو عدم وجوده بناءً على صورة معينة.
- يتنبأ النموذج بنتائج أفضل بكثير إذا تم توفير نقاط ثنائية الأبعاد و/أو صناديق الإحاطة المدخلة
- يمكنك إدخال عدة نقاط لنفس الصورة، والتنبؤ بقناع واحد.
- لا يُدعَم ضبط النموذج الدقيق بعد
- وفقاً للورقة البحثية، ينبغي أن يكون مدخل النص مدعوماً أيضاً. ومع ذلك، في وقت كتابة هذا النص، يبدو أنه غير مدعوم وفقاً لـالمستودع الرسمي.
تمت مساهمة هذا النموذج من قِبل ybelkada وArthurZ. يمكن العثور على الكود الأصلي هنا.
فيما يلي مثال على كيفية تشغيل توليد الأقنعة بناءً على صورة ونقطة ثنائية الأبعاد:
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
يمكنك أيضًا معالجة أقنعتك الخاصة جنبًا إلى جنب مع الصور المدخلة في المعالج لتُمرَّر إلى النموذج.
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء مع SAM.
- دفتر ملاحظات تجريبي لاستخدام النموذج.
- دفتر ملاحظات تجريبي لاستخدام خط أنابيب توليد الأقنعة التلقائي.
- دفتر ملاحظات تجريبي للاستدلال باستخدام MedSAM، وهو نسخة مُعدَّلة من SAM مخصصة للمجال الطبي. 🌎
- دفتر ملاحظات تجريبي لضبط النموذج على بيانات مخصصة. 🌎
SlimSAM
قُدِّم SlimSAM، وهو نسخة مُقصوصة من SAM، في 0.1% Data Makes Segment Anything Slim من قِبل Zigeng Chen وآخرون. يقلل SlimSAM حجم نماذج SAM بشكل كبير مع الحفاظ على الأداء نفسه.
يمكن العثور على نقاط التفتيش على المركز، ويمكن استخدامها كبديل جاهز للاستخدام مباشرة عن SAM.
سام الموثّق
يمكن الجمع بين Grounding DINO وSAM لتوليد الأقنعة بناءً على النص، كما هو موضح في Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks. يمكنك الرجوع إلى دفتر العرض التوضيحي 🌍 للاطلاع على التفاصيل.
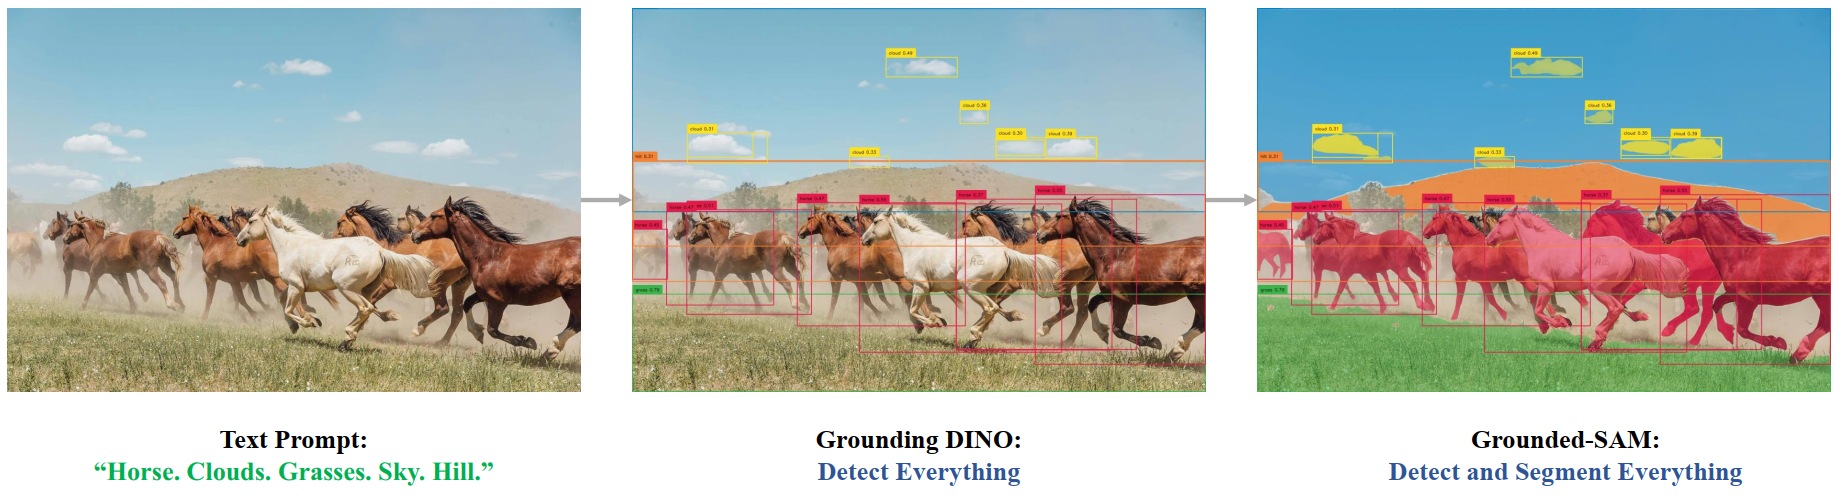 Grounded SAM overview. Taken from the original repository.
SamConfig
فئة transformers.SamConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
المعاملات
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — كائن الإعدادات أو قاموس العمود الفقري البصري. - prompt_encoder_config (Union[
dict,SamPromptEncoderConfig], اختياري) — قاموس لخيارات التهيئة المستخدمة في تهيئة SamPromptEncoderConfig. - mask_decoder_config (Union[
dict,SamMaskDecoderConfig], اختياري) — قائمة خيارات الإعدادات المستخدمة لتبويب SamMaskDecoderConfig. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamModel. تُستخدم لاستحداث نموذج Sam وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/sam-vit-huge
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     SamVisionConfig,
...     SamPromptEncoderConfig,
...     SamMaskDecoderConfig,
...     SamModel,
... )

>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()

>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig

>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()

>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
SamVisionConfig
فئة transformers.SamVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - output_channels (
int، اختياري، القيمة الافتراضية 256) — أبعاد قنوات الإخراج في Patch Encoder. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية1024) — حجم (دقة) كل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية1e-10) — انحراف معياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم. - mlp_ratio (
float، اختياري، القيمة الافتراضية4.0) — نسبة بُعد مخفي MLP إلى بُعد التضمين. - use_abs_pos (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام تضمينات الموضع المطلق. - use_rel_pos (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام تضمين الموضع النسبي. - window_size (
int، اختياري، القيمة الافتراضية 14) — حجم النافذة للموضع النسبي. - global_attn_indexes (
list[int]، اختياري، القيمة الافتراضية[2, 5, 8, 11]) — فهارس طبقات الانتباه الشامل. - num_pos_feats (
int، اختياري، القيمة الافتراضية 128) — أبعاد تضمين الموقع. - mlp_dim (
int, اختياري) — أبعاد طبقة MLP في مُشفِّر Transformer. إذا كانتNone، فإن القيمة الافتراضية هيmlp_ratio * hidden_size.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamModel. تُستخدم لاستحداث نموذج Sam وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/sam-vit-huge
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     SamVisionConfig,
...     SamVisionModel,
... )

>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()

>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamMaskDecoderConfig
فئة transformers.SamMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06 )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية256) — أبعاد التمثيلات المخفية. - hidden_act (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - mlp_dim (
int، اختياري، القيمة الافتراضية 2048) — أبعاد طبقة «الوسط» (أي طبقة التغذية الأمامية) في مُشفِّر Transformer. - num_hidden_layers (
int، اختياري، القيمة الافتراضية2) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - attention_downsample_rate (
int، اختياري، القيمة الافتراضية 2) — معدل تخفيض عينة طبقة الانتباه. - num_multimask_outputs (
int، اختياري، القيمة الافتراضية 3) — عدد المخرجات من وحدةSamMaskDecoder. في ورقة Segment Anything، يتم ضبط هذه القيمة على 3. - iou_head_depth (
int، اختياري، القيمة الافتراضية 3) — عدد الطبقات في وحدة رأس IoU. - iou_head_hidden_dim (
int, اختياري، القيمة الافتراضية 256) — أبعاد الحالات المخفية في وحدة رأس IoU. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamModel. تُستخدم لاستحداث نموذج Sam وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/sam-vit-huge
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
SamPromptEncoderConfig
فئة transformers.SamPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية256) — أبعاد التمثيلات المخفية. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية1024) — حجم (دقة) كل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - mask_input_channels (
int، اختياري، القيمة الافتراضية 16) — عدد القنوات التي تُمرَّر إلى وحدةMaskDecoder. - num_point_embeddings (
int، اختياري، القيمة الافتراضية 4) — عدد تضمينات النقاط التي سيتم استخدامها. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamModel. تُستخدم لاستحداث نموذج Sam وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/sam-vit-huge
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
SamProcessor
فئة transformers.SamProcessor
< source >( image_processor )
ينشئ SamProcessor الذي يغلّف معالج الصور في معالج واحد.
يوفر SamProcessor جميع وظائف SamImageProcessor. راجع ~SamImageProcessor لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = None**kwargs ) → ~tokenization_utils_base.BatchEncoding
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str], list[list[str]]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصاً أو قائمة من النصوص (نص مُقسَّم مسبقاً إلى رموز). إذا مرّرت مدخلاً مُقسَّماً مسبقاً إلى رموز، فعيّنis_split_into_words=Trueلتجنّب الغموض مع المدخلات المُجمَّعة في دفعات. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
يعيد
~tokenization_utils_base.BatchEncoding
- data (
dict، اختياري) — قاموس من القوائم/المصفوفات/الموترات التي تُعاد بواسطة طرق__call__/encode_plus/batch_encode_plus(مثل ‘input_ids’، ‘attention_mask’، وما إلى ذلك). - ترميز (
tokenizers.EncodingأوSequence[tokenizers.Encoding]، اختياري) — إذا كان مُرمِّز الكلمات (tokenizer) من النوع السريع الذي يُخرج معلومات إضافية مثل التحويل من مساحة الكلمات/الأحرف إلى مساحة الرموز (tokens)، فإن كائنtokenizers.Encodingأو قائمة بالكائنات (في حالة الدفعات) تحتفظ بهذه المعلومات. - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة. - prepend_batch_axis (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة محور الدفعة عند التحويل إلى متجهات (انظرtensor_typeأعلاه). لاحظ أن لهذا المعامل تأثيرًا إذا تم تعيين المعاملtensor_type، وإلا فلا يكون له أي تأثير. - n_sequences (
int, اختياري) — عدد تسلسلات الإدخال التي يُمثّلها كل ترميز (Noneفي حال عدم المعرفة، و1لتسلسل واحد، و2لزوج من التسلسلات).
SamImageProcessor
فئة transformers.SamImageProcessor
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'longest_edge' -- 1024}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ملء الصورة. يتم الملء إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الملء الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 1024, 'width': 1024}): الحجم بصيغة{"height": int, "width" int}الذي سيتم توسيط الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيط الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - mask_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"longest_edge": int}الذي يجب إعادة تحجيم خرائط التقسيم إليه. - mask_pad_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"height": int, "width": int}الذي يجب ملء خرائط التقسيم (segmentation maps) إليه. يجب أن يكون أكبر من حجم أي خريطة تقسيم مُقدَّمة للمعالجة المسبقة.
ينشئ معالج صور SamImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقسيم المراد معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - mask_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"longest_edge": int}الذي يجب إعادة تحجيم خرائط التقسيم إليه. - mask_pad_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"height": int, "width": int}الذي يجب ملء خرائط التقسيم (segmentation maps) إليه. يجب أن يكون أكبر من حجم أي خريطة تقسيم مُقدَّمة للمعالجة المسبقة.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
SamImageProcessorPil
فئة transformers.SamImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'longest_edge' -- 1024}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ملء الصورة. يتم الملء إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الملء الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 1024, 'width': 1024}): الحجم بصيغة{"height": int, "width" int}الذي سيتم توسيط الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيط الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - mask_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"longest_edge": int}الذي يجب إعادة تحجيم خرائط التقسيم إليه. - mask_pad_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"height": int, "width": int}الذي يجب توسيع خرائط التقسيم (segmentation maps) إليه. يجب أن يكون أكبر من حجم أي خريطة تقسيم مُقدَّمة للمعالجة المسبقة.
ينشئ معالج صور SamImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقسيم المراد معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - mask_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"longest_edge": int}الذي يجب إعادة تحجيم خرائط التقسيم إليه. - mask_pad_size (
dict[str, *kwargs*, int]، اختياري) — الحجم{"height": int, "width": int}الذي يجب ملء خرائط التقسيم (segmentation maps) إليه. يجب أن يكون أكبر من أي حجم لخريطة تقسيم مُقدَّم للمعالجة المسبقة.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
SamVisionModel
فئة transformers.SamVisionModel
< source >( config: SamVisionConfig )
المعاملات
- config (SamVisionConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج الرؤية من Sam دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamVisionEncoderOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام SamImageProcessor. راجع SamImageProcessor.call() للتفاصيل (SamProcessor يستخدم SamImageProcessor لمعالجة الصور).
يعيد
SamVisionEncoderOutput أو tuple(torch.Tensor)
SamVisionEncoderOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعدادات (SamConfig) والمدخلات.
تتجاوز طريقة SamVisionModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
image_embeds (
torch.Tensorمن الشكل(batch_size, output_dim)اختياري يُعاد عند تهيئة النموذج معwith_projection=True) — تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على pooler_output.last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
SamModel
فئة transformers.SamModel
< source >( config: SamConfig )
المعاملات
- config (SamConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Segment Anything (SAM) لتوليد أقنعة التقسيم، بناءً على صورة مدخلة ونقاط وسمات مدخلة، أو صناديق، أو أقنعة.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Trueattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamImageSegmentationOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام SamImageProcessor. راجع SamImageProcessor.call() للتفاصيل (SamProcessor يستخدم SamImageProcessor لمعالجة الصور). - input_points (
torch.Tensorمن الشكل(batch_size, num_points, 2)) — نقاط مكانية ثنائية الأبعاد مدخلة، تُستخدم بواسطة مُشفِّر الموجه (prompt encoder) لتشفير الموجه. عادةً ما يؤدي ذلك إلى نتائج أفضل بكثير. يمكن الحصول على النقاط عن طريق تمرير قائمة من قوائم القوائم إلى المُعالِج (processor) الذي سيُنشئtorchtensors المقابلة من البُعد الرابع. البُعد الأول هو حجم دفعة الصور (image batch size)، والبُعد الثاني هو حجم دفعة النقاط (point batch size) (أي عدد أقنعة التقطيع (segmentation masks) التي نريد من النموذج أن يتنبأ بها لكل نقطة مدخلة)، والبُعد الثالث هو عدد النقاط لكل قناع تقطيع (من الممكن تمرير عدة نقاط لقناع واحد)، وآخر بُعد هو إحداثيات x (العمودية) و y (الأفقية) للنقطة. إذا تم تمرير عدد مختلف من النقاط إما لكل صورة، أو لكل قناع، فسيقوم المُعالِج بإنشاء نقاط “PAD” ستُطابق إحداثي (0, 0)، وسيتم تخطي حساب التضمين (embedding) لهذه النقاط باستخدام التسميات (labels). - input_labels (
torch.LongTensorبشكل(batch_size, point_batch_size, num_points)) — التسميات المدخلة للنقاط، تُستخدم هذه التسميات من قِبل مُشفِّر المُوجِّه (prompt encoder) لتشفير المُوجِّه. وفقًا للتنفيذ الرسمي، توجد ثلاثة أنواع من التسميات1: النقطة هي نقطة تحتوي على الكائن محل الاهتمام0: النقطة هي نقطة لا تحتوي على الكائن محل الاهتمام-1: النقطة المقابلة للخلفية
أضفنا التسمية:
-10: النقطة هي نقطة حشو، وبالتالي يجب تجاهلها من قِبل مُشفِّر المُوجِّه
يجب أن يتم ملء التسميات تلقائيًا بواسطة المعالج.
- input_boxes (
torch.Tensorبشكل(batch_size, num_boxes, 4)) — صناديق الإدخال للنقاط، تُستخدم هذه الصناديق بواسطة مُشفِّر المُوجِّه (prompt encoder) لتشفير المُوجِّه. بشكل عام، يؤدي ذلك إلى أقنعة (masks) مولَّدة أفضل بكثير. يمكن الحصول على الصناديق عن طريق تمرير قائمة من قوائم القوائم إلى المُعالِج (processor)، والذي سيولّدtorchمُتغيِّرًا (tensor)، حيث يتوافق كل بُعد على التوالي مع حجم دفعة الصور (batch size)، وعدد الصناديق لكل صورة، وإحداثيات النقطة العلوية اليسرى والنقطة السفلية اليمنى للصندوق. بالترتيب (x1,y1,x2,y2):x1: إحداثي x للنقطة العلوية اليسرى من الصندوق المدخلy1: إحداثي y للنقطة العلوية اليسرى من مربع الإدخالx2: إحداثي x للنقطة السفلية اليمنى من مربع الإدخالy2: إحداثي y للنقطة السفلية اليمنى من مربع الإدخال
- input_masks (
torch.Tensorمن الشكل(batch_size, image_size, image_size)) — يقبل نموذج SAM أيضًا أقنعة التقسيم كمدخلات. سيتم تضمين القناع بواسطة مُشفِّر المُوجِّه لتوليد تضمين مقابل، سيُغذَّى لاحقًا إلى مُفكِّك الأقنعة. يجب على المستخدم تغذية هذه الأقنعة يدويًا، ويجب أن تكون من الشكل (batch_size،image_size،image_size). - image_embeddings (
torch.Tensorمن الشكل(batch_size, output_channels, window_size, window_size)) — تضمينات الصور، تُستخدم من قِبَل فكّ الترميز للقناع لتوليد الأقنعة ودرجات iou. لحساب أكثر كفاءةً في استخدام الذاكرة، يمكن للمستخدمين أولاً استرجاع تضمينات الصور باستخدام طريقةget_image_embeddings، ثم تمريرها إلى طريقةforwardبدلاً من تمريرpixel_values. - multimask_output (
bool، اختياري) — في التنفيذ الأصلي والورقة البحثية، يُخرج النموذج دائمًا 3 أقنعة لكل صورة (أو لكل نقطة / لكل مربع محدد إذا كان ذلك ذا صلة). ومع ذلك، يمكن إخراج قناع واحد فقط، يقابل القناع «الأفضل»، عن طريق تحديدmultimask_output=False. - attention_similarity (
torch.Tensor، اختياري) — مصفوفة تشابه الانتباه، التي يجب تقديمها إلى فاحص الأقنعة (mask decoder) للانتباه الموجَّه بالهدف في حال استخدام النموذج للتخصيص كما تم تقديمه في PerSAM. - target_embedding (
torch.Tensor، اختياري) — تضمين المفهوم المستهدف، ليُقدَّم إلى فكّ الترميز القناعي (mask decoder) للتلميح الدلالي المستهدف في حال استخدام النموذج للتخصيص كما أُدخل في PerSAM.
يعيد
SamImageSegmentationOutput أو tuple(torch.Tensor)
أمر SamImageSegmentationOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتماداً على الإعدادات (SamConfig) والمدخلات.
تتجاوز طريقة SamModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
iou_scores (
torch.Tensorمن الشكل(batch_size, num_masks)) — درجات iou للأقنعة المتنبأ بها.pred_masks (
torch.Tensorمن الشكل(batch_size, num_masks, height, width)) — الأقنعة ذات الدقة المنخفضة المتوقعة. يجب معالجتها بعد المعالجة بواسطة المعالجvision_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لمخرجات الطبقة المضمنة، إذا كان للنموذج طبقة تضمين، + واحدة لمخرجات كل طبقة) ذات الشكل(batch_size, sequence_length, hidden_size).حالات المخفية لنموذج الرؤية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
vision_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
mask_decoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")

>>> # Get segmentation mask
>>> outputs = model(**inputs)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )