
Transformers documentation
Grounding DINO
このモデルは2023年3月9日にHF papersで公開され、2024年4月11日にHugging Face Transformersに貢献されました。
Grounding DINO
概要
Grounding DINO モデルは、Shilong Liu、Zhaoyang Zeng、Tianhe Ren、Feng Li、Hao Zhang、Jie Yang、Chunyuan Li、Jianwei Yang、Hang Su、Jun Zhu、Lei Zhang によって提案された Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection に記載されています。Grounding DINO は、テキストエンコーダーを閉集合オブジェクト検出モデルに拡張することで、オープンセットオブジェクト検出を可能にします。このモデルは、COCO のゼロショットで 52.5 AP を達成するなど、優れた結果を示しています。
論文の抄録は以下の通りです。
本論文では、Transformerベースの検出器DINOとグラウンデッド事前学習を組み合わせることで、カテゴリ名や参照表現などの人間による入力を用いて任意のオブジェクトを検出できるオープンセットオブジェクト検出器Grounding DINOを提案します。オープンセットオブジェクト検出の鍵となる解決策は、オープンセット概念の汎化のためにクローズドセット検出器に言語を導入することです。言語とビジョンのモダリティを効果的に融合するために、クローズドセット検出器を概念的に3つのフェーズに分割し、特徴量エンハンサー、言語ガイドクエリ選択、およびクロスモダリティ融合のためのクロスモダリティデコーダーを含む緊密な融合ソリューションを提案します。従来の研究は主に新規カテゴリでオープンセットオブジェクト検出を評価していましたが、属性で指定されたオブジェクトに対する参照表現理解についても評価を行うことを提案します。Grounding DINOは、COCO、LVIS、ODinW、RefCOCO/+/gのベンチマークを含むすべての3つの設定で非常に優れた性能を発揮します。Grounding DINOは、COCOからの訓練データを使用しないゼロショット転送ベンチマークにおいて52.5 APを達成しました。また、ODinWゼロショットベンチマークで平均26.1 APという新記録を樹立しています。
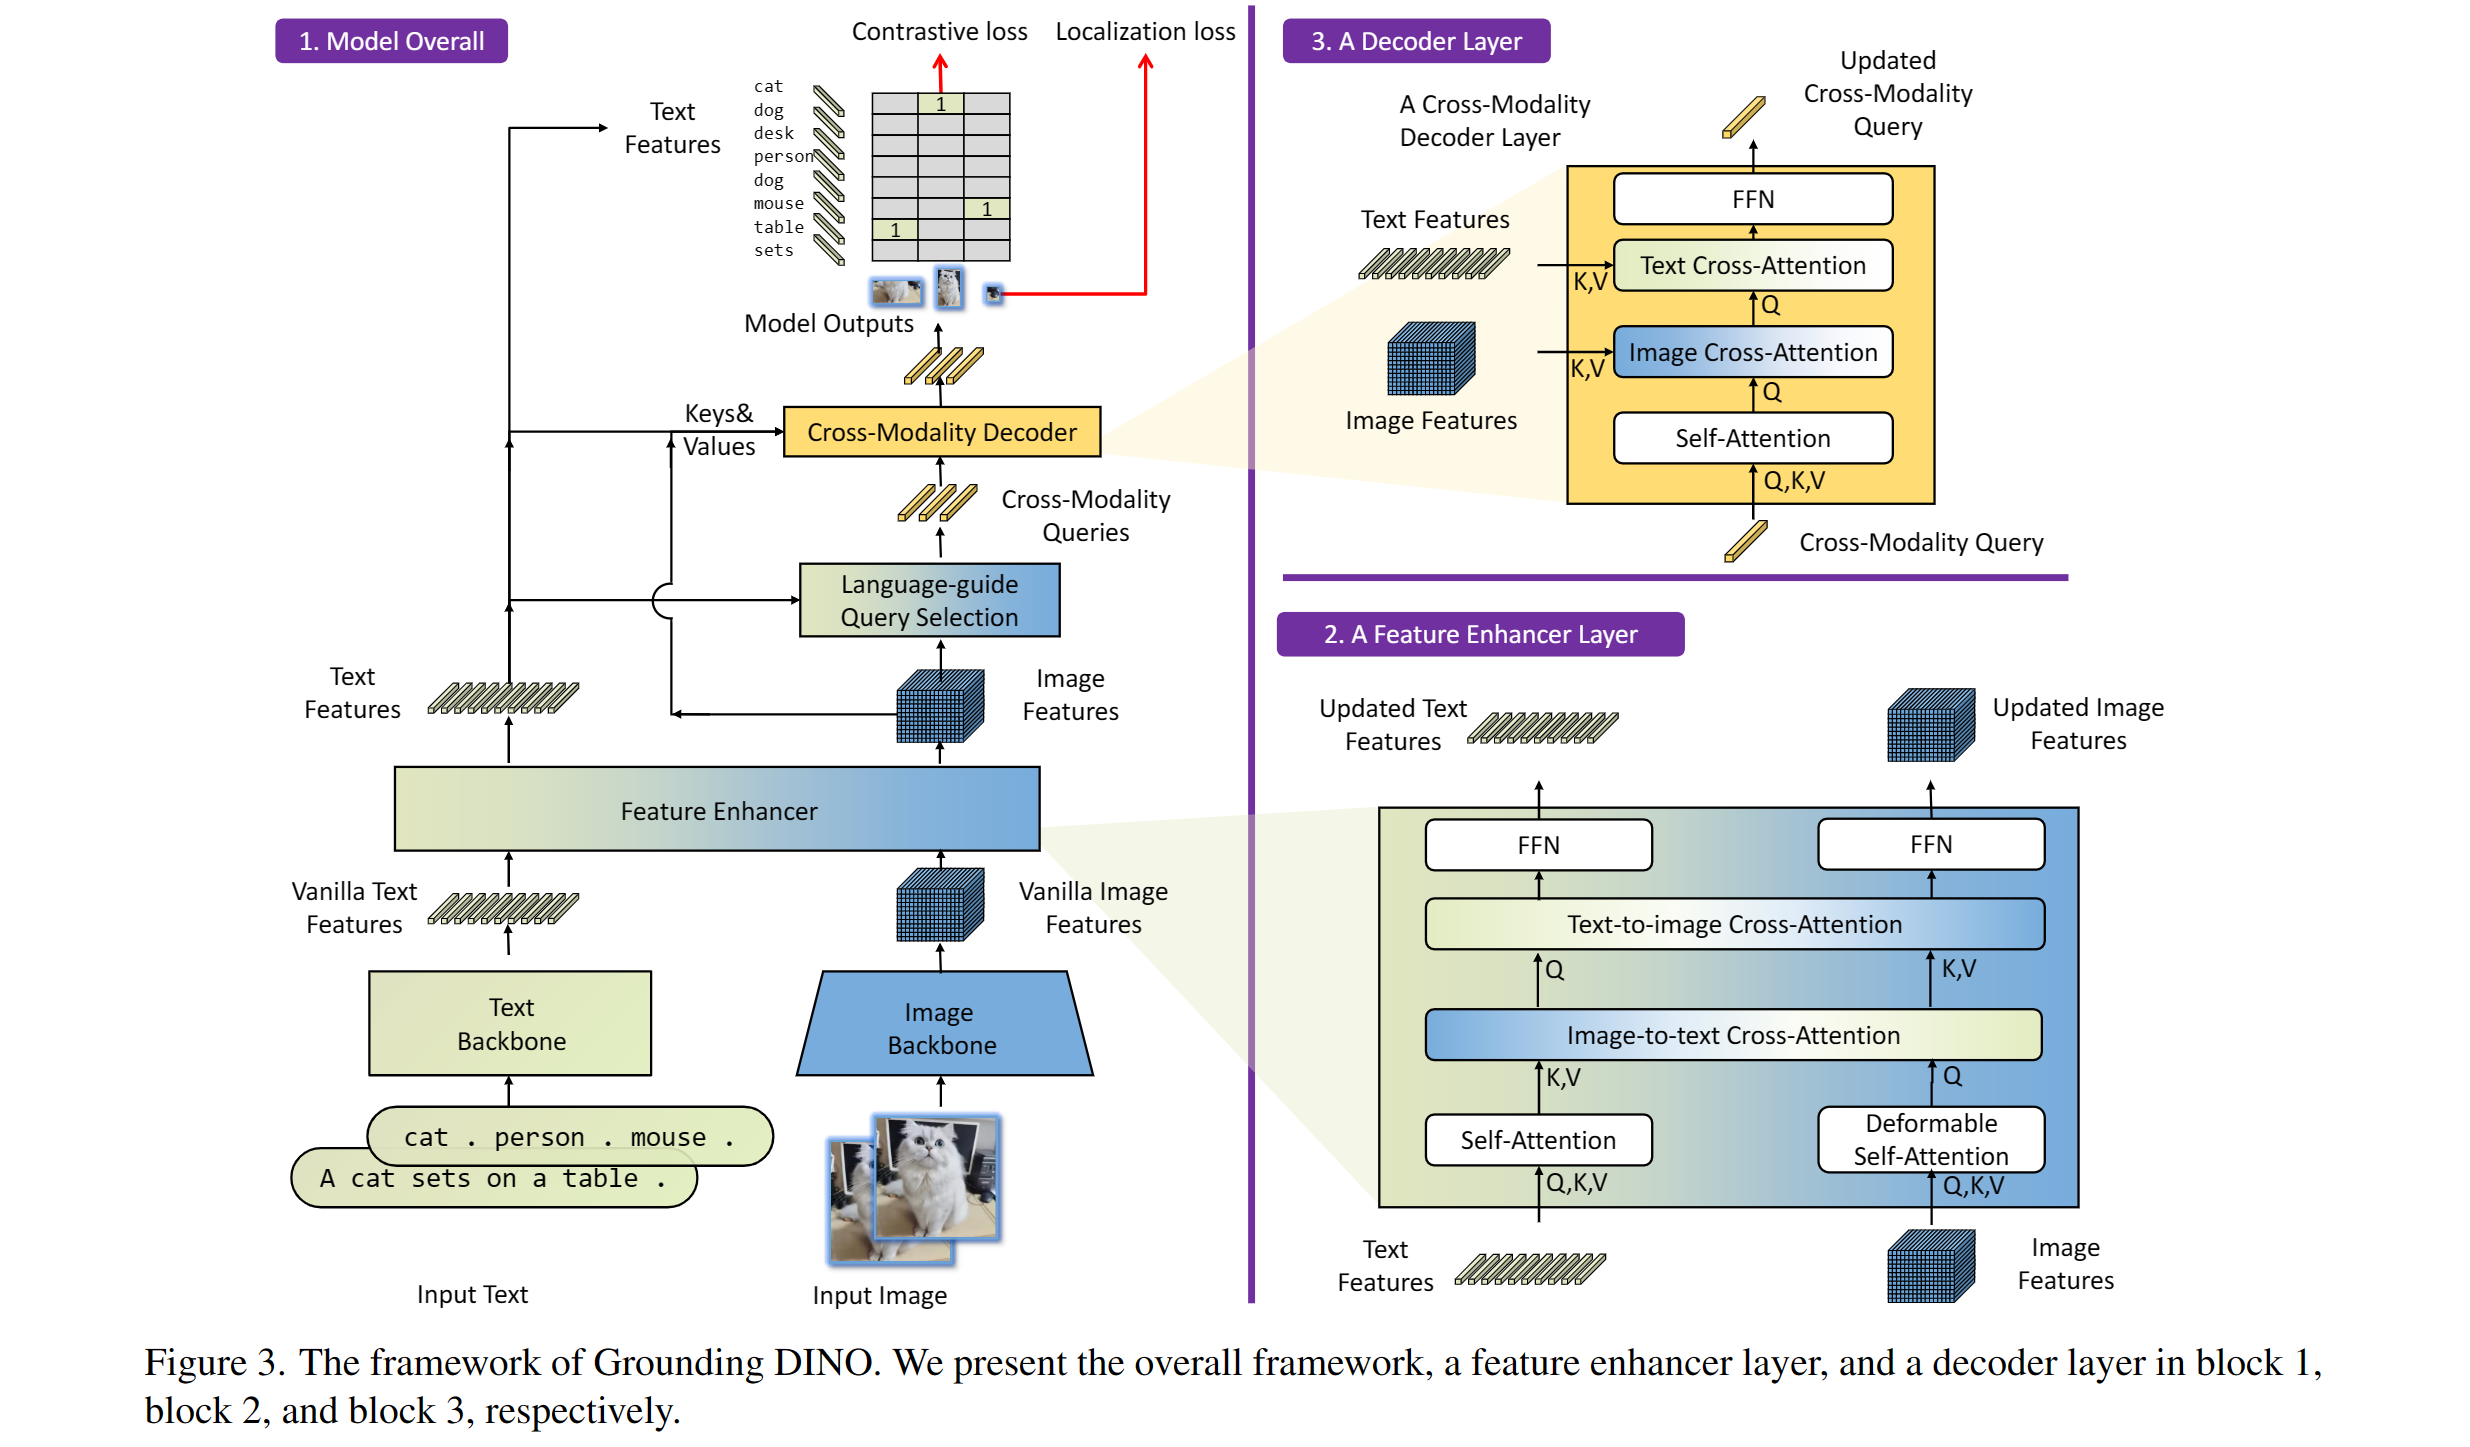 Grounding DINO overview. Taken from the original paper.
このモデルはEduardoPacheco氏とnielsr氏によって提供されました。 元のコードはこちらで確認できます。
使用のコツ
- GroundingDinoProcessorを使用して、モデル用の画像とテキストのペアを準備できます。
- テキスト内でクラスを区切るには、ピリオドを使用します。例: “a cat. a dog.”
- 複数のクラスを使用する場合(例:
"a cat. a dog.")、出力の後処理には GroundingDinoProcessor のpost_process_grounded_object_detectionを使用してください。これは、post_process_object_detectionが返すラベルが、prob > threshold を満たすモデル次元のインデックスを表すためです。
ゼロショット物体検出にモデルを使用する方法は以下の通りです。
import requests

import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection

model_id = "IDEA-Research/grounding-dino-tiny"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")

image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]

inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

results = processor.post_process_grounded_object_detection(
    outputs,
    inputs.input_ids,
    threshold=0.4,
    text_threshold=0.3,
    target_sizes=[image.size[::-1]]
)

# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
    box = [round(x, 2) for x in box.tolist()]
    print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
Grounded SAM
Grounding DINO と Segment Anything モデルを組み合わせることで、Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks で紹介されているテキストベースのマスク生成を行うことができます。詳細については、この デモノートブック 🌍 を参照してください。
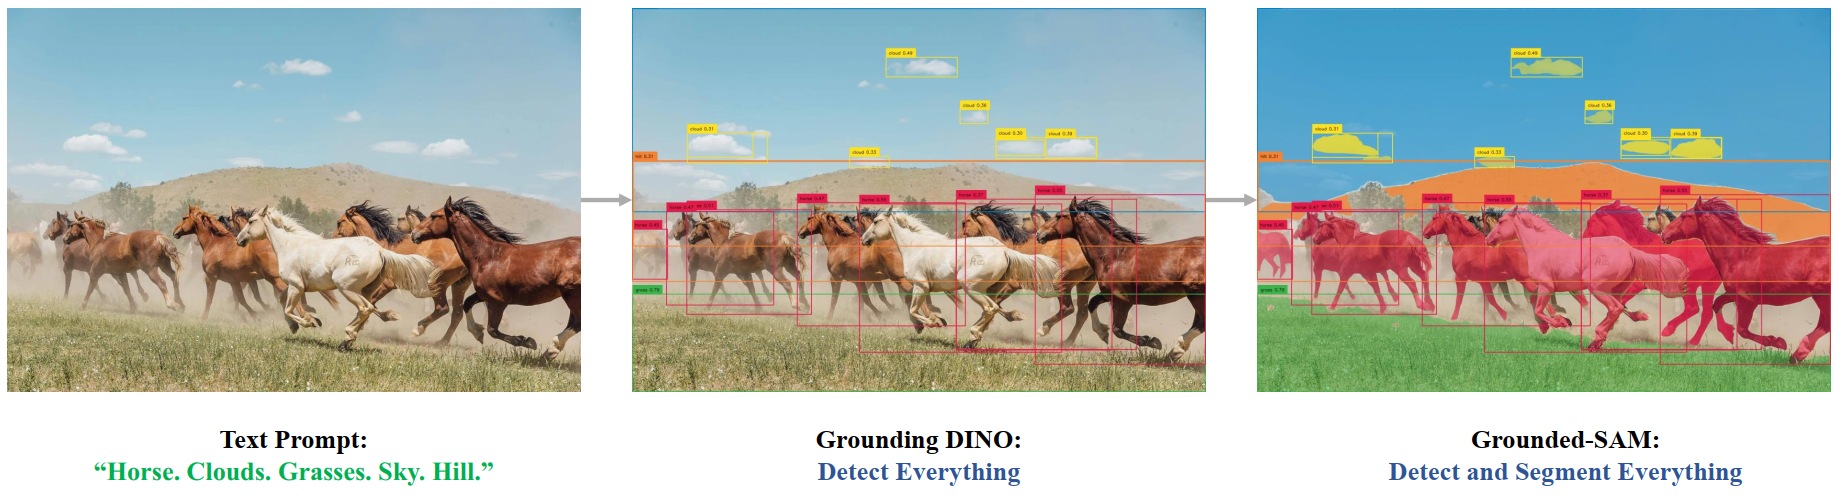 Grounded SAM overview. Taken from the original repository.
リソース
Grounding DINO の入門を支援するための、Hugging Face 公式およびコミュニティ(🌎 で示されます)のリソース一覧です。ここにリソースを掲載していただくことを希望される場合は、Pull Request をお気軽に開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しい内容をデモントレートするものが望ましいです。
GroundingDinoImageProcessor
class transformers.GroundingDinoImageProcessor
< source >( **kwargs: *<class 'transformers.models.grounding_dino.image_processing_grounding_dino.GroundingDinoImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 800, 'longest_edge': 1333}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, デフォルトは2) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool、kwargs、optional、デフォルトはTrue) — 画像をパディングするかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - format (
str, kwargs, optional, デフォルトはAnnotationFormat.COCO_DETECTION) — アノテーションのデータ形式。“coco_detection” または “coco_panoptic” のいずれかです。 - do_convert_annotations (
bool、kwargs、optional、デフォルトはTrue) — GROUNDING_DINO モデルが期待する形式にアノテーションを変換するかどうかを制御します。バウンディングボックスを(center_x, center_y, width, height)の形式に変換し、値の範囲を[0, 1]にします。preprocessメソッドのdo_convert_annotationsパラメータによって上書きできます。
GroundingDinoImageProcessor 画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = Nonereturn_segmentation_masks: bool | None = Nonemasks_path: str | pathlib.Path | None = None**kwargs: *<class 'transformers.models.grounding_dino.image_processing_grounding_dino.GroundingDinoImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - annotations (
AnnotationTypeまたはlist[AnnotationType]、省略可) — 画像に適用されるパディングに従って変換するアノテーション。 - return_segmentation_masks (
bool、省略可、デフォルトはself.return_segmentation_masks) — セグメンテーションマスクを返すかどうかを指定します。 - masks_path (
strまたはpathlib.Path、省略可) — セグメンテーションマスクを含むディレクトリへのパス。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - format (
str, kwargs, optional, デフォルトはAnnotationFormat.COCO_DETECTION) — アノテーションのデータ形式。“coco_detection” または “coco_panoptic” のいずれかです。 - do_convert_annotations (
bool、kwargs、optional、デフォルトはTrue) — GROUNDING_DINO モデルが期待する形式にアノテーションを変換するかどうかを制御します。バウンディングボックスを(center_x, center_y, width, height)の形式に変換し、値の範囲を[0, 1]にします。preprocessメソッドのdo_convert_annotationsパラメータによって上書きできます。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
GroundingDinoImageProcessorPil
class transformers.GroundingDinoImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.grounding_dino.image_processing_pil_grounding_dino.GroundingDinoImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 800, 'longest_edge': 1333}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, デフォルトは2) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool、kwargs、optional、デフォルトはTrue) — 画像をパディングするかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - format (
str, kwargs, optional, デフォルトはAnnotationFormat.COCO_DETECTION) — アノテーションのデータ形式。“coco_detection” または “coco_panoptic” のいずれかです。 - do_convert_annotations (
bool、kwargs、optional、デフォルトはTrue) — GROUNDING_DINO モデルが期待する形式にアノテーションを変換するかどうかを制御します。バウンディングボックスを(center_x, center_y, width, height)の形式に変換し、値の範囲を[0, 1]にします。preprocessメソッドのdo_convert_annotationsパラメータによって上書きできます。
GroundingDinoImageProcessor 画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = Nonereturn_segmentation_masks: bool | None = Nonemasks_path: str | pathlib.Path | None = None**kwargs: *<class 'transformers.models.grounding_dino.image_processing_pil_grounding_dino.GroundingDinoImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - annotations (
AnnotationTypeまたはlist[AnnotationType]、省略可) — 画像に適用されるパディングに従って変換するアノテーション。 - return_segmentation_masks (
bool、省略可、デフォルトはself.return_segmentation_masks) — セグメンテーションマスクを返すかどうかを指定します。 - masks_path (
strまたはpathlib.Path、省略可) — セグメンテーションマスクを含むディレクトリへのパス。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - format (
str, kwargs, optional, デフォルトはAnnotationFormat.COCO_DETECTION) — アノテーションのデータ形式。“coco_detection” または “coco_panoptic” のいずれかです。 - do_convert_annotations (
bool、kwargs、optional、デフォルトはTrue) — GROUNDING_DINO モデルが期待する形式にアノテーションを変換するかどうかを制御します。バウンディングボックスを(center_x, center_y, width, height)の形式に変換し、値の範囲を[0, 1]にします。preprocessメソッドのdo_convert_annotationsパラメータによって上書きできます。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
post_process_object_detection
< source >( outputs: GroundingDinoObjectDetectionOutputthreshold: float = 0.1target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None ) → list[Dict]
パラメータ
- outputs (
GroundingDinoObjectDetectionOutput) — モデルの生出力です。 - threshold (
float、任意、デフォルト値は 0.1) — オブジェクト検出の予測結果を保持するためのスコアしきい値。 - target_sizes (
torch.Tensorまたはlist[tuple[int, int]]、任意) —(batch_size, 2)の形状を持つ Tensor、または各画像のターゲットサイズ(height, width)を含むタプルのリスト (tuple[int, int])。 未設定の場合、予測結果はリサイズされません。
戻り値
list[Dict]
各辞書に以下のキーが含まれる辞書のリスト:
- “scores”: 画像上の各予測ボックスに対する信頼度スコア。
- “labels”: モデルが画像に対して予測したクラスのインデックス。
- “boxes”: (top_left_x, top_left_y, bottom_right_x, bottom_right_y) 形式の画像のバウンディングボックス。
GroundingDinoForObjectDetectionの生出力を、(top_left_x, top_left_y, bottom_right_x, bottom_right_y)形式の最終的なバウンディングボックスに変換します。
GroundingDinoProcessor
class transformers.GroundingDinoProcessor
< source >( image_processortokenizer )
画像プロセッサとトークナイザーを単一のプロセッサにラップするGroundingDinoProcessorを構築します。
GroundingDinoProcessor は、GroundingDinoImageProcessor と BertTokenizer のすべての機能を提供します。詳細については、~GroundingDinoImageProcessor および ~BertTokenizer を参照してください。
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = Nonevideos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = Noneaudio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.processing_utils.ProcessingKwargs'> )
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], 任意) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - text (
Union[str, list[str], list[list[str]]]、省略可) — エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(事前トークン化済み文字列)であることができます。事前トークン化済みの入力を渡す場合は、バッチ入力との曖昧さを避けるためにis_split_into_words=Trueを設定してください。 - videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]], 任意) — 前処理を行う動画です。ピクセル値が 0 から 255 の範囲にある、単一の動画またはバッチの動画を想定しています。ピクセル値が 0 から 1 の範囲にある動画を渡す場合は、do_rescale=Falseを設定してください。 - audio (
Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]], 任意) — 準備対象のオーディオまたはオーディオのバッチです。各オーディオは NumPy 配列または PyTorch テンソルであることができます。 NumPy 配列/PyTorch テンソルの場合、各オーディオの形状は (C, T) である必要があります。ここで C はチャネル数、T はオーディオのサンプル長です。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、特定のフレームワークのテンソルを返します。使用可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': NumPyのnp.ndarrayオブジェクトを返します。
- **kwargs (ProcessingKwargs、任意) — 各モダリティ(テキスト、画像、動画、音声)の追加処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDictクラスを参照してください。
post_process_grounded_object_detection
< source >( outputs: GroundingDinoObjectDetectionOutputinput_ids: transformers.utils.generic.TensorType | None = Nonethreshold: float = 0.25text_threshold: float = 0.25target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = Nonetext_labels: list[list[str]] | None = None ) → list[Dict]
パラメータ
- outputs (
GroundingDinoObjectDetectionOutput) — モデルの生出力です。 - input_ids (
torch.LongTensor、形状(batch_size, sequence_length)、任意) — 入力テキストのトークン ID です。指定されない場合、モデルの出力から取得されます。 - threshold (
float、任意、デフォルト値は 0.25) — 信頼度スコアに基づいて物体検出の予測を保持するための閾値。 - text_threshold (
float、任意、デフォルト値は 0.25) — テキスト検出の予測を保持するためのスコアしきい値です。 - target_sizes (
torch.Tensorまたはlist[tuple[int, int]]、任意) —(batch_size, 2)の形状を持つ Tensor、または各画像のターゲットサイズ(height, width)を含むタプルのリスト (tuple[int, int])。 未設定の場合、予測結果はリサイズされません。 - text_labels (
list[list[str]]、任意) — 各画像で検出される候補ラベルのリストです。現時点では使用されていませんが、zero-shot object detection パイプラインのシグネチャに必要です。テキストラベルは代わりに、outputsに提供されるinput_idsテンソルから抽出されます。
戻り値
list[Dict]
各辞書に以下を含む辞書のリスト
- scores: 検出されたオブジェクトの信頼度スコアのテンソル
- boxes: [x0, y0, x1, y1] 形式のバウンディングボックスのテンソル
- labels: 検出された各オブジェクトのテキストラベルのリスト(v4.51.0 で整数 ID に置き換えられます)
- text_labels: 検出されたオブジェクトのテキストラベルのリスト
GroundingDinoForObjectDetectionの生出力を、(top_left_x, top_left_y, bottom_right_x, bottom_right_y)形式の最終的なバウンディングボックスに変換し、関連するテキストラベルを取得します。
GroundingDinoConfig
クラス transformers.GroundingDinoConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_queries: int = 900encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'num_feature_levels: int = 4encoder_n_points: int = 4decoder_n_points: int = 4two_stage: bool = Trueclass_cost: float = 1.0bbox_cost: float = 5.0giou_cost: float = 2.0bbox_loss_coefficient: float = 5.0giou_loss_coefficient: float = 2.0focal_alpha: float = 0.25disable_custom_kernels: bool = Falsemax_text_len: int = 256text_enhancer_dropout: float | int = 0.0fusion_droppath: float | int = 0.1fusion_dropout: float | int = 0.0embedding_init_target: bool = Truequery_dim: int = 4decoder_bbox_embed_share: bool = Truetwo_stage_bbox_embed_share: bool = Falsepositional_embedding_temperature: int = 20init_std: float = 0.02layer_norm_eps: float = 1e-05tie_word_embeddings: bool = True )
パラメータ
- is_encoder_decoder (
bool、任意、デフォルトはTrue) — モデルがエンコーダー/デコーダーとして使用されるかどうかを示します。 - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]、省略可) — テキストバックボーンの設定オブジェクトまたは辞書。 - num_queries (
int、任意、デフォルトは 900) — オブジェクトクエリ数、すなわち検出スロットの数です。これは、GroundingDinoModel が 1 枚の画像内で検出できるオブジェクトの最大数を表します。 - encoder_layers (
int、任意、デフォルトは6) — Transformer エンコーダーの隠れ層の数です。設定されていない場合は、num_layersと同じ値が使用されます。 - encoder_ffn_dim (
int、任意、デフォルトは2048) — エンコーダー内の「中間」層(フィードフォワード層と呼ばれることが多い)の次元数。 - encoder_attention_heads (
int、任意、デフォルトは8) — Transformer エンコーダーの各アテンション層におけるアテンションヘッドの数。 - decoder_layers (
int、任意、デフォルトは6) — Transformer デコーダーの隠れ層の数です。設定されていない場合、num_layersと同じ値が使用されます。 - decoder_ffn_dim (
int、任意、デフォルトは2048) — デコーダー内の「中間」(feed-forward と呼ばれることが多い) レイヤーの次元数。 - decoder_attention_heads (
int、任意、デフォルトは8) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - activation_function (
str、任意、デフォルトはrelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - d_model (
int、省略可、デフォルトは256) — エンコーダ層とプーラ層のサイズ。 - dropout (
Union[float, int]、任意、デフォルト値は0.1) — すべての dropout レイヤーの比率です。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - activation_dropout (
Union[float, int]、任意、デフォルトは0.0) — 全結合層内の活性化に対する dropout 率です。 - auxiliary_loss (
bool、任意、デフォルトはFalse) — 補助デコーディング損失(各デコーダ層での損失)を使用するかどうかを指定します。 - position_embedding_type (
str, 任意、デフォルトは"sine") — 画像特徴の上に適用する位置埋め込みの種類。"sine"または"learned"のいずれかです。 - num_feature_levels (
int、任意、デフォルトは 4) — 入力特徴量のレベル数です。 - encoder_n_points (
int、省略可能、デフォルト値は 4)— エンコーダーの各アテンションヘッドにおいて、各特徴レベルでサンプリングされるキーの数を指定します。 - decoder_n_points (
int、省略可能、デフォルトは 4) — デコーダーの各アテンションヘッドにおいて、各特徴量レベルでサンプリングされるキーの数を指定します。 - two_stage (
bool、省略可、デフォルトはTrue) — 2段階のデフォーマブル DETR を適用するかどうか。この場合、Grounding DINO のバリアントによってリージョン提案も生成され、それらがデコーダーに渡されてバウンディングボックスの反復的な精緻化が行われます。 - class_cost (
float、任意、デフォルトは1.0) — ハンガリー法によるマッチングコストにおける、分類誤差の相対的な重み。 - bbox_cost (
float、任意、デフォルトは5.0) — ハンガリー法によるマッチングコストにおける、L1バウンディングボックス誤差の相対的な重み。 - giou_cost (
float、任意、デフォルトは2.0) — ハンガリー法によるマッチングコストにおける、汎化 IoU ロスの相対的な重み。 - bbox_loss_coefficient (
float、任意、デフォルトは5.0) — パノプティックセグメンテーション損失における L1 バウンディングボックス損失の相対的な重み。 - giou_loss_coefficient (
float、任意、デフォルトは2.0) — パンノミックセグメンテーション損失における汎化 IoU 損失の相対的な重み。 - focal_alpha (
float、任意、デフォルトは0.25) — focal loss の Alpha パラメータ。 - disable_custom_kernels (
bool、任意、デフォルトはFalse) — カスタム CUDA カーネルおよび CPU カーネルの使用を無効にします。このオプションは ONNX エクスポートに必要であり、カスタムカーネルは PyTorch の ONNX エクスポートではサポートされていないためです。 - max_text_len (
int、任意、デフォルトは 256) — テキスト入力の最大長です。 - text_enhancer_dropout (
float、任意、デフォルト値は 0.0) — テキストエンハンサーのドロップアウト率です。 - fusion_droppath (
float、任意、デフォルトは 0.1) — fusion モジュールの droppath 比率です。 - fusion_dropout (
float、任意、デフォルト値は 0.0) — fusion モジュールの dropout 率です。 - embedding_init_target (
bool、省略可、デフォルトはTrue) — Embedding の重みでターゲットを初期化するかを指定します。 - query_dim (
int、任意、デフォルトは 4) — クエリベクトルの次元数です。 - decoder_bbox_embed_share (
bool、任意、デフォルトはTrue) — すべてのデコーダー層で bbox 回帰ヘッドを共有するかどうか。 - two_stage_bbox_embed_share (
bool、任意、デフォルトはFalse) — 2段階bboxジェネレーターとregion proposal生成の間でbbox埋め込みを共有するかどうか。 - positional_embedding_temperature (
float、任意、デフォルト値は 20) — ビジョンバックボーンと併せて使用される Sine Positional Embedding の温度です。 - init_std (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - tie_word_embeddings (
bool、任意、デフォルトはTrue) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。
これは、Grounding Dinoモデルの設定を保存するための設定クラスです。指定された引数に基づいてGrounding Dinoモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、IDEA-Research/grounding-dino-tiny と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import GroundingDinoConfig, GroundingDinoModel

>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()

>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
GroundingDinoModel
クラス transformers.GroundingDinoModel
< source >( config: GroundingDinoConfig )
パラメータ
- config (GroundingDinoConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Grounding DINOのベースモデル(バックボーンとエンコーダー・デコーダーのTransformerで構成)は、特定のヘッドを備えずに生のhidden-statesを出力します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: Tensorinput_ids: Tensortoken_type_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneencoder_outputs = Noneoutput_attentions = Noneoutput_hidden_states = Nonereturn_dict = None**kwargs ) → GroundingDinoModelOutput or tuple(torch.Tensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は GroundingDinoImageProcessor を使用して取得できます。詳細については GroundingDinoImageProcessor.call() を参照してください(GroundingDinoProcessor は画像の処理に GroundingDinoImageProcessor を使用します)。 - input_ids (
torch.LongTensorの形状(batch_size, text_sequence_length)) — 語彙における入力シーケンスのトークンインデックスです。パディングが提供された場合、デフォルトでは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細はBertTokenizer.call()を参照してください。
- token_type_ids (
torch.LongTensorの形状(batch_size, text_sequence_length), 、任意) — 入力テキストの前半と後半を示すためのセグメントトークンインデックス。インデックスは[0, 1]: 0 に対応します。sentence Aトークンに対応します。sentence Bトークンに対応します。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- pixel_mask (
torch.Tensorの形状(batch_size, height, width), 、任意) — パディングピクセル値に対するアテンションの適用を回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- encoder_outputs (`
) -- Tuple consists of (last_hidden_state, *optional*:hidden_states, *optional*:attentions)last_hidden_stateof shape(batch_size, sequence_length, hidden_size)`, optional) is a sequence of hidden-states at the output of the last layer of the encoder. Used in the cross-attention of the decoder. - output_attentions (`
) -- Whether or not to return the attentions tensors of all attention layers. Seeattentions` under returned tensors for more detail. - output_hidden_states (`
) -- Whether or not to return the hidden states of all layers. Seehidden_states` under returned tensors for more detail. - return_dict (“) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
GroundingDinoModelOutput または tuple(torch.Tensor)
GroundingDinoModelOutput、またはtorch.Tensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(GroundingDinoConfig)や入力に応じて、さまざまな要素で構成されます。
GroundingDinoModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.Tensor、形状(batch_size, num_queries, hidden_size)) — モデルのデコーダーの最終層の出力における、隠れ状態のシーケンスです。init_reference_points (
torch.Tensor、形状(batch_size, num_queries, 4)) — Transformerデコーダーに渡される初期の参照点。intermediate_hidden_states (
torch.Tensor、形状(batch_size, config.decoder_layers, num_queries, hidden_size)) — 中間隠れ状態のスタック(デコーダーの各層の出力)。intermediate_reference_points (
torch.Tensor、形状(batch_size, config.decoder_layers, num_queries, 4)) — 中間参照点のスタック(デコーダーの各層の参照点)。decoder_hidden_states (
tuple[torch.Tensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力における、デコーダーの隠れ状態。
decoder_attentions (
tuple[tuple[torch.Tensor]]、任意、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
encoder_last_hidden_state_vision (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) — モデルのエンコーダーの最終層の出力における隠れ状態のシーケンス。encoder_last_hidden_state_text (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) — モデルのエンコーダーの最終層の出力における隠れ状態のシーケンス。encoder_vision_hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(ビジョン埋め込みの出力用 1 つ + 各レイヤーの出力用 1 つ)、形状は(batch_size, sequence_length, hidden_size)。各レイヤーの出力および初期埋め込み出力におけるビジョンエンコーダーの隠れ状態。encoder_text_hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(テキスト埋め込みの出力用 1 つ + 各層の出力用 1 つ) 形状は(batch_size, sequence_length, hidden_size)です。テキストエンコーダーの各層の出力における隠れ状態と、初期埋め込みの出力です。encoder_attentions (
tuple(tuple(torch.Tensor))、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプルのタプル(各レイヤーの注意機構用)で、形状は(batch_size, num_heads, sequence_length, sequence_length)です。注意機構の softmax 後のアテンション重みで、テキストとビジュアル間の注意機構、ビジュアルとテキスト間の注意機構、テキストエンハンサー(自己注意機構)、およびマルチスケール変形注意機構ヘッドにおける加重平均の計算に使用されます。注意機構の softmax 後のアテンション重みで、双方向注意機構ヘッドにおける加重平均の計算に使用されます。enc_outputs_class (
torch.Tensor、形状(batch_size, sequence_length, config.num_labels)、任意、config.two_stage=Trueの場合に返されます) — 予測されたバウンディングボックスのスコアです。第1段階では、スコアが上位のconfig.num_queries個のバウンディングボックスがリージョンプロポーザルとして選択されます。バウンディングボックスの二値分類(すなわち、フォアグラウンドとバックグラウンド)の出力です。enc_outputs_coord_logits (
torch.Tensor、形状(batch_size, sequence_length, 4)、任意、config.two_stage=Trueの場合に返されます) — 第1段階で予測されるバウンディングボックス座標のロジット。encoder_logits (
torch.Tensor、形状(batch_size, sequence_length, config.num_labels)、任意、config.two_stage=Trueの場合に返されます) — 第1段階でスコアが上位のconfig.num_queries個のバウンディングボックスのロジット。encoder_pred_boxes (
torch.Tensor、形状(batch_size, sequence_length, 4)、任意、config.two_stage=Trueの場合に返されます) — 第1段階でスコアが上位のconfig.num_queries個のバウンディングボックスの座標。
例:
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> text = "a cat."

>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")

>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)

>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
GroundingDinoForObjectDetection
クラス transformers.GroundingDinoForObjectDetection
< source >( config: GroundingDinoConfig )
パラメータ
- config (GroundingDinoConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
オブジェクト検出ヘッドを備えた Grounding DINO モデル(バックボーンとエンコーダー・デコーダー型 Transformer で構成)は、COCO 検出などのタスクに使用されます。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: Tensorinput_ids: LongTensortoken_type_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonepixel_mask: typing.Optional[torch.BoolTensor] = Noneencoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = Nonelabels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None**kwargs )
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は GroundingDinoImageProcessor を使用して取得できます。詳細については GroundingDinoImageProcessor.call() を参照してください(GroundingDinoProcessor は画像の処理に GroundingDinoImageProcessor を使用します)。 - input_ids (
torch.LongTensorの形状(batch_size, text_sequence_length)) — 語彙における入力シーケンスのトークンインデックスです。パディングが提供された場合、デフォルトでは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細はBertTokenizer.call()を参照してください。
- token_type_ids (
torch.LongTensorの形状(batch_size, text_sequence_length), 、任意) — 入力テキストの前半と後半を示すためのセグメントトークンインデックス。インデックスは[0, 1]: 0 に対応します。sentence Aトークンに対応します。sentence Bトークンに対応します。 - attention_mask (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- pixel_mask (
torch.BoolTensor形状(batch_size, height, width), 、任意) — パディングピクセル値へのアテンションを回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- encoder_outputs (
Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple], 省略可) —last_hidden_state、省略可:hidden_states、省略可:attentionsのタプルです。last_hidden_stateは形状(batch_size, sequence_length, hidden_size)、省略可 のシーケンスで、エンコーダーの最終層の出力における hidden-states です。デコーダーの cross-attention に使用されます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - labels (
list[Dict]、長さ(batch_size,)、任意) — 二部マッチング損失を計算するためのラベル。辞書のリストで、各辞書には少なくとも以下の 2 つのキーが含まれます: ‘class_labels’ と ‘boxes’ (それぞれバッチ内の画像のクラスラベルとバウンディングボックス)。クラスラベル自体は長さ(number of bounding boxes in the image,)のtorch.LongTensorであり、ボックスは形状(number of bounding boxes in the image, 4)のtorch.Tensorである必要があります。
GroundingDinoForObjectDetectionのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
例:
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection

>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"

>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]

>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> results = processor.post_process_grounded_object_detection(
...     outputs,
...     threshold=0.4,
...     text_threshold=0.3,
...     target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
...     box = [round(x, 2) for x in box.tolist()]
...     print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]