
Transformers documentation
UDOP
このモデルは2022年12月5日にHF papersで公開され、2024年3月4日にHugging Face Transformersに貢献されました。
UDOP
概要
UDOPモデルは、Zineng Tang、Ziyi Yang、Guoxin Wang、Yuwei Fang、Yang Liu、Chenguang Zhu、Michael Zeng、Cha Zhang、Mohit Bansal による Unifying Vision, Text, and Layout for Universal Document Processing で提案されました。 UDOPは、文書画像の分類、文書の解析、文書ビジュアル質問応答などのドキュメントAIタスクのために、T5 に基づくエンコーダーデコーダー型Transformerアーキテクチャを採用しています。
論文の抄録は以下の通りです。
Universal Document Processing (UDOP) を提案します。UDOP は、文書理解や生成を含む多様なタスク形式を統合した、テキスト、画像、レイアウトのモダリティを統合した基盤となる Document AI モデルです。UDOP は、テキストコンテンツと文書画像の間の空間的相関を利用し、画像、テキスト、レイアウトのモダリティを単一の均一な表現でモデル化します。新しい Vision-Text-Layout Transformer を用いることで、UDOP は事前学習とマルチドメインのダウンストリームタスクを、プロンプトベースのシーケンス生成スキームに統合します。UDOP は、革新的な自己教師あり目的関数を用いた大規模なラベルなし文書コーパスと、多様なラベル付きデータを用いて事前学習されています。また、UDOP はマスクド画像再構成を通じて、テキストとレイアウトのモダリティから文書画像を生成するよう学習します。私たちの知る限り、これは Document AI の分野において、1 つのモデルが同時に高品質なニューラル文書編集とコンテンツのカスタマイズを実現した初の事例です。私たちの手法は、金融レポート、学術論文、ウェブサイトなどの多様なデータドメインにおいて、文書理解や QA などの 9 つの Document AI タスクで SOTA を達成しています。UDOP は、Document Understanding Benchmark (DUE) のリーダーボードで 1 位を獲得しています。*
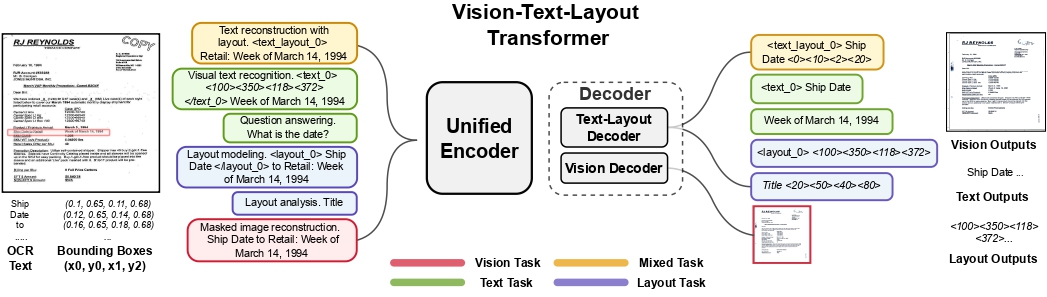 UDOP architecture. Taken from the original paper.
使用のコツ
- input_idsに加えて、UdopForConditionalGenerationは、入力トークンのバウンディングボックス(つまり2次元の位置)である入力
bboxも期待します。これらは、GoogleのTesseract(Pythonラッパーが利用可能)などの外部OCRエンジンを使用して取得できます。各バウンディングボックスは(x0, y0, x1, y1)の形式である必要があり、(x0, y0)はバウンディングボックスの左上隅の位置、(x1, y1)は右下隅の位置を表します。なお、バウンディングボックスを0〜1000のスケールに正規化してから使用する必要があります。正規化には、以下の関数を使用できます。
def normalize_bbox(bbox, width, height):
    return [
        int(1000 * (bbox[0] / width)),
        int(1000 * (bbox[1] / height)),
        int(1000 * (bbox[2] / width)),
        int(1000 * (bbox[3] / height)),
]ここでは、width と height は、トークンが出現する元の文書の幅と高さに相当します。これらは、例えば Python Image Library (PIL) ライブラリを使用して、次のように取得できます。
from PIL import Image


# Document can be a png, jpg, etc. PDFs must be converted to images.
image = Image.open(name_of_your_document).convert("RGB")

width, height = image.size
UdopProcessor を使用すると、モデル用の画像とテキストの準備をすべて行えます。デフォルトでは、このクラスは Tesseract エンジンを使用して、指定されたドキュメントから単語とボックス(座標)のリストを抽出します。その機能は LayoutLMv3Processor と同等であり、独自の OCR エンジンを使用する場合は apply_ocr=False を、デフォルトの OCR エンジンを使用する場合は apply_ocr=True を渡すことができます。すべての使用可能なユースケースについては、LayoutLMv2 の使用ガイドを参照してください(UdopProcessor の機能は同一です)。
- 独自のOCRエンジンを使用する場合、推奨されるのは、いわゆるラインセグメントをサポートするAzureのRead APIです。セグメント位置埋め込みを使用すると、通常、パフォーマンスが向上します。
- 推論時には、ドキュメント画像を基に自己回帰的にテキストを生成するために、
generateメソッドの使用を推奨します。 - The model has been pre-trained on both self-supervised and supervised objectives. One can use the various task prefixes (prompts) used during pre-training to test out the out-of-the-box capabilities. For instance, the model can be prompted with “Question answering. What is the date?”, as “Question answering.” is the task prefix used during pre-training for DocVQA. Refer to the paper (table 1) for all task prefixes.
- UdopEncoderModelもファインチューニングできます。これはUDOPのエンコーダーのみで構成される部分であり、LayoutLMv3のようなTransformerエンコーダーと見なすことができます。判別タスクでは、その上に線形分類器を追加し、ラベル付きデータセットでファインチューニングするだけです。
このモデルはnielsrによって提供されました。 元のコードはこちらで確認できます。
リソース
UDOPの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです。ここにリソースを掲載していただくことを希望される場合は、Pull Requestをオープンしていただければ、レビューいたします。リソースは、既存のリソースと重複するのではなく、新しい内容をデモンストレーションするものが望ましいです。
- UDOPに関するデモノートブックはこちらで確認できます。カスタムデータセットでのUDOPのファインチューニングおよび推論の方法を示しています。🌎
- ドキュメント質問応答タスクガイド
UdopConfig
クラス transformers.UdopConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truevocab_size: int = 33201d_model: int = 1024d_kv: int = 64d_ff: int = 4096num_layers: int = 24num_decoder_layers: int | None = Nonenum_heads: int = 16relative_attention_num_buckets: int = 32relative_attention_max_distance: int = 128relative_bias_args: list[dict] | None = Nonedropout_rate: float | int = 0.1layer_norm_epsilon: float = 1e-06initializer_factor: float = 1.0feed_forward_proj: str = 'relu'use_cache: bool = Truepad_token_id: int | None = 0eos_token_id: int | list[int] | None = 1max_2d_position_embeddings: int = 1024image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3is_decoder: bool = Falseadd_cross_attention: bool = Falsetie_word_embeddings: bool = True )
パラメータ
- is_encoder_decoder (
bool、任意、デフォルトはTrue) — モデルがエンコーダー/デコーダーとして使用されるかどうかを示します。 - vocab_size (
int、任意、デフォルトは33201) — モデルの語彙サイズです。input_idsで表現できるトークンの種類数を定義します。 - d_model (
int、任意、デフォルトは1024) — エンコーダ層とプーラ層のサイズ。 - d_kv (
int、任意、デフォルトは64) — 各アテンションヘッドにおけるキー、クエリ、バリューの射影サイズ。射影層のinner_dimはnum_heads * d_kvとして定義されます。 - d_ff (
int、任意、デフォルトは4096) — MLP 表現の次元数。 - num_layers (
int、任意、デフォルトは24) — Transformer デコーダーにおける隠れ層の数。 - num_decoder_layers (
int, 任意) — Transformer デコーダーの隠れ層の数。設定されていない場合、num_layersと同じ値が使用されます。 - num_heads (
int、任意、デフォルトは16) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - relative_attention_num_buckets (
int、任意、デフォルトは 32) — 各アテンション層で使用するバケット数。 - relative_attention_max_distance (
int、任意、デフォルトは 128) — バケット分離における、より長いシーケンスの最大距離です。 - relative_bias_args (
list[dict]、任意、デフォルトは[{'type' -- '1d'}, {'type': 'horizontal'}, {'type': 'vertical'}]): 相対バイアス層の引数を含む辞書のリストです。 - dropout_rate (
Union[float, int]、任意、デフォルトは0.1) — すべての dropout レイヤーの比率です。 - layer_norm_epsilon (
float、任意、デフォルトは1e-06) — レイヤーノーマル層で使用する epsilon です。 - initializer_factor (
float、任意、デフォルトは1.0) — すべての重み行列を初期化する際に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。 - feed_forward_proj (
string、任意、デフォルトは"relu") — 使用するフィードフォワード層の種類です。"relu"または"gated-gelu"のいずれかである必要があります。Udopv1.1 は"gated-gelu"フィードフォワード投影を使用します。元の Udop は"relu"を使用します。 - use_cache (
bool、任意、デフォルトはTrue) — モデルが最後のキー/バリューの注意を返すかどうか(すべてのモデルで利用されるわけではありません)。config.is_decoder=Trueの場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。 - pad_token_id (
int、任意、デフォルトは0) — 語彙内でパディングに使用されるトークン ID。 - eos_token_id (
Union[int, list[int]]、任意、デフォルトは1) — 語彙内でストリーム終了に使用されるトークン ID。 - max_2d_position_embeddings (
int、任意、デフォルト値は 1024) — 相対位置エンコーディングにおける、絶対位置埋め込みの最大値です。 - image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは224) — 各画像のサイズ(解像度)。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは16) — 各パッチのサイズ(解像度)です。 - num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - is_decoder (
bool、任意、デフォルトはFalse) — モデルがデコーダーとして使用されるかどうかを示します。Falseの場合、モデルはエンコーダーとして使用されます。 - add_cross_attention (
bool、任意、デフォルトはFalse) — モデルにクロスアテンション層を追加するかどうか。 - tie_word_embeddings (
bool、任意、デフォルトはTrue) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。
これは UdopModel の設定を保存するための設定クラスです。指定された引数に基づいて Udop モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、microsoft/udop-large と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
UdopTokenizer
class transformers.UdopTokenizer
< source >( vocab: str | list[tuple[str, float]] | None = Noneeos_token = '</s>'sep_token = '</s>'unk_token = '<unk>'pad_token = '<pad>'sep_token_box = [1000, 1000, 1000, 1000]pad_token_box = [0, 0, 0, 0]pad_token_label = -100only_label_first_subword = Trueextra_special_tokens = None**kwargs )
パラメータ
- eos_token (
str, 省略可, デフォルトは"</s>") — シーケンスの終了トークンです。特殊トークンを用いてシーケンスを構築する場合、シーケンスの終了に使用されるのはこのトークンではありません。 使用されるのは
sep_tokenです。 - sep_token (
str、任意、デフォルトは"</s>") — 区切りトークンです。複数のシーケンスからシーケンスを構築する際に使用されます。例えば、シーケンス分類では2つのシーケンス、質問応答ではテキストと質問です。また、特殊トークンを用いて構築されたシーケンスの最後のトークンとしても使用されます。 - unk_token (
str、任意、デフォルトは"<unk>") — 不明トークンです。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。 - pad_token (
str、任意、デフォルトは"<pad>") — パディングに使用されるトークンです。例えば、長さが異なるシーケンスをバッチ処理する際に使用します。 - sep_token_box (
list[int]、任意、デフォルトは[1000, 1000, 1000, 1000]) — 特殊トークン [SEP] に使用するバウンディングボックスです。 - pad_token_box (
list[int]、任意、デフォルトは[0, 0, 0, 0]) — 特殊トークン [PAD] に使用するバウンディングボックス。 - pad_token_label (
int、任意、デフォルトは -100) — パディングトークンに使用するラベルです。デフォルトは -100 で、これは PyTorch の CrossEntropyLoss のignore_indexです。 - only_label_first_subword (
bool、省略可、デフォルトはTrue) — 単語ラベルが提供されている場合、最初のサブワードのみをラベル付けするかどうかを指定します。 - extra_special_tokens (
list[str]、任意、デフォルトは["<s>NOTUSED", "</s>NOTUSED"]) — トークナイザーで使用される追加の特殊トークンです。
HuggingFaceのtokenizersライブラリをベースにした「高速」なUDOPトークナイザーを構築します。LayoutXLMTokenizerおよびT5Tokenizerを参考にしています。BPEに基づいています。
このトークナイザーは、主要なメソッドの大部分を含む TokenizersBackend を継承しています。これらのメソッドに関する詳細については、このスーパークラスを参照してください。
build_inputs_with_special_tokens
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
パラメータ
- token_ids_0 (
list[int]) — 特殊トークンが追加されるIDのリストです。 - token_ids_1 (
list[int]、省略可) — シーケンスペア用の第2のIDリスト(任意)。
戻り値
list[int]
適切な特殊トークンを含む入力 IDのリスト。
シーケンス分類タスクにおいて、シーケンスまたはシーケンスのペアからモデルの入力を構築するには、特殊トークンを連結して追加します。XLM-RoBERTaのシーケンスは、次の形式を持ちます:
- 単一シーケンス:
<s> X </s> - シーケンスのペア:
<s> A </s></s> B </s>
get_special_tokens_mask
< source >( token_ids_0: list[int]token_ids_1: list[int] | None = Nonealready_has_special_tokens: bool = False ) → A list of integers in the range [0, 1]
特殊トークンが追加されていないトークンリストからシーケンスIDを取得します。
高速なトークナイザーでは、データコラテーターはalready_has_special_tokens=Trueを指定してこれを呼び出し、すでに整形済みのシーケンスに対してマスクを構築します。その場合、all_special_idsへの所属を確認することによってマスクを計算します。
create_token_type_ids_from_sequences
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
シーケンスペア分類タスクで使用するために、渡された2つのシーケンスからマスクを作成します。XLM-RoBERTaはトークンタイプIDを使用しないため、ゼロのリストが返されます。
トークナイザの語彙ファイルを保存します。TokenizersBackend の場合、tokenizer.json ファイルはベースクラスによって保存されます。このメソッドは、tokenizer.json のみを使用するため、空のタプルを返します。
UdopProcessor
class transformers.UdopProcessor
< source >( image_processortokenizer )
UdopProcessorを構築します。画像プロセッサとトークナイザーを単一のプロセッサにラップします。
UdopProcessor は、LayoutLMv3ImageProcessor と UdopTokenizer のすべての機能を提供します。詳細については、~LayoutLMv3ImageProcessor および ~UdopTokenizer を参照してください。
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] = None**kwargs: *<class 'transformers.models.udop.processing_udop.UdopProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], 任意) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - text (
Union[str, list[str], list[list[str]]]、省略可) — エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(事前トークン化済み文字列)であることができます。事前トークン化済みの入力を渡す場合は、バッチ入力との曖昧さを避けるためにis_split_into_words=Trueを設定してください。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、特定のフレームワークのテンソルを返します。使用可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': NumPyのnp.ndarrayオブジェクトを返します。
- **kwargs (ProcessingKwargs、任意) — 各モダリティ(テキスト、画像、動画、音声)の追加処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDictクラスを参照してください。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
UdopModel
class transformers.UdopModel
< source >( config: UdopConfig )
パラメータ
- config (UdopConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生の隠れ状態を出力する素の Udop Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonebbox: dict[str, typing.Any] | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonevisual_bbox: dict[str, typing.Any] | None = Nonedecoder_input_ids: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqModelOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- bbox (
torch.LongTensor形状({0}, 4), 任意) — 各入力シーケンスのトークンのバウンディングボックス。範囲[0, config.max_2d_position_embeddings-1]. 各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置、(x1, y1) は右下隅の位置を表します。sequence_length = token_sequence_length + patch_sequence_length + 1であることに注意してください。ここで1は [CLS] トークン用のものです。patch_sequence_lengthについてはpixel_valuesを参照してください。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は LayoutLMv3ImageProcessor を使用して取得できます。詳細については LayoutLMv3ImageProcessor.call() を参照してください(UdopProcessor は画像の処理に LayoutLMv3ImageProcessor を使用します)。 - visual_bbox (
torch.LongTensor、形状(batch_size, patch_sequence_length, 4)、任意) — 画像内の各パッチのバウンディングボックスです。指定しない場合、モデル内でバウンディングボックスが作成されます。 - decoder_input_ids (
torch.LongTensor、形状(batch_size, target_sequence_length)、任意) — ボキャブラリにおけるデコーダー入力シーケンスのトークンインデックスです。インデックスは AutoTokenizer を使用して取得できます。詳細については、PreTrainedTokenizer.encode() および PreTrainedTokenizer.call() を参照してください。 デコーダー入力IDとは? T5 は、decoder_input_idsの生成の開始トークンとしてpad_token_idを使用します。past_key_valuesを使用する場合は、オプションとして最後のdecoder_input_idsだけを入力すれば十分です(past_key_valuesを参照)。事前学習用にdecoder_input_idsを準備する方法については、T5 Training をご覧ください。 - decoder_attention_mask (
torch.BoolTensor、shape(batch_size, target_sequence_length)、任意) — デフォルトの動作:decoder_input_ids内の pad トークンを無視するテンソルを生成します。デフォルトでは、causal mask も使用されます。 - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - encoder_outputs (
torch.Tensor, 任意) —last_hidden_state、任意:hidden_states、任意:attentionsのタプルlast_hidden_stateは形状(batch_size, sequence_length, hidden_size)、任意)であり、エンコーダーの最終層の出力における隠れ状態のシーケンスです。デコーダーのクロスアテンションで使用されます。 - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - decoder_inputs_embeds (
torch.Tensorの形状(batch_size, target_sequence_length, hidden_size), 、任意) — 、任意で、decoder_input_idsの代わりに、埋め込み表現を直接渡すこともできます。past_key_valuesが使用されている場合、最後のdecoder_inputs_embedsのみを入力すれば十分です(past_key_values). 、decoder_input_idsのインデックスを関連するベクトルに変換する方法を、モデル内部の埋め込みルックアップ行列よりも細かく制御したい場合に便利です。decoder_input_idsとdecoder_inputs_embedsの両方が設定されていない場合、decoder_inputs_embedsはinputs_embedsの値を採ります。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
Seq2SeqModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または Seq2SeqModelOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(UdopConfig)や入力に応じて、さまざまな要素で構成されます。
UdopModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルのデコーダーの最終層の出力における、隠れ状態のシーケンス。past_key_valuesが使用されている場合、出力されるのは、形状(batch_size, 1, hidden_size)のシーケンスの最後の隠れ状態のみです。past_key_values (
EncoderDecoderCache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — EncoderDecoderCache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己注意ブロックおよび相互注意ブロック内のキーとバリューの事前計算済み隠れ状態(hidden-states)を保持しており、シーケンシャルデコーディングを高速化するために使用できます(
past_key_values入力参照)。decoder_hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるデコーダーのHidden-states、および任意の初期埋め込み出力。
decoder_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのエンコーダーの最終層の出力における、隠れ状態のシーケンス。encoder_hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるエンコーダーのHidden-states、および任意の初期埋め込み出力。
encoder_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmaxを適用した後のエンコーダーのアテンション重み。自己アテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoProcessor, AutoModel
>>> from datasets import load_dataset
>>> import torch

>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = AutoModel.from_pretrained("microsoft/udop-large")

>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> inputs = processor(image, words, boxes=boxes, return_tensors="pt")

>>> decoder_input_ids = torch.tensor([[model.config.decoder_start_token_id]])

>>> # forward pass
>>> outputs = model(**inputs, decoder_input_ids=decoder_input_ids)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1, 1024]
UdopForConditionalGeneration
クラス transformers.UdopForConditionalGeneration
< source >( config: UdopConfig )
パラメータ
- config (UdopConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
UDOPエンコーダー・デコーダーTransformerは、上部に言語モデリングヘッドを備えており、ドキュメント画像と任意のプロンプトを指定することでテキストを生成できます。
このクラスはT5ForConditionalGenerationをベースとしており、画像およびレイアウト(2D)データに対応するように拡張されています。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonebbox: dict[str, typing.Any] | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonevisual_bbox: dict[str, typing.Any] | None = Nonedecoder_input_ids: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqLMOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- bbox (
torch.LongTensor形状({0}, 4), 任意) — 各入力シーケンスのトークンのバウンディングボックス。範囲[0, config.max_2d_position_embeddings-1]. 各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置、(x1, y1) は右下隅の位置を表します。sequence_length = token_sequence_length + patch_sequence_length + 1であることに注意してください。ここで1は [CLS] トークン用のものです。patch_sequence_lengthについてはpixel_valuesを参照してください。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は LayoutLMv3ImageProcessor を使用して取得できます。詳細については LayoutLMv3ImageProcessor.call() を参照してください(UdopProcessor は画像の処理に LayoutLMv3ImageProcessor を使用します)。 - visual_bbox (
torch.LongTensor、形状(batch_size, patch_sequence_length, 4)、任意) — 画像内の各パッチのバウンディングボックスです。指定しない場合、モデル内でバウンディングボックスが作成されます。 - decoder_input_ids (
torch.LongTensor、形状(batch_size, target_sequence_length)、任意) — ボキャブラリにおけるデコーダー入力シーケンスのトークンインデックスです。インデックスは AutoTokenizer を使用して取得できます。詳細については、PreTrainedTokenizer.encode() および PreTrainedTokenizer.call() を参照してください。 デコーダー入力IDとは? T5 は、decoder_input_idsの生成の開始トークンとしてpad_token_idを使用します。past_key_valuesを使用する場合は、オプションとして最後のdecoder_input_idsだけを入力すれば十分です(past_key_valuesを参照)。事前学習用にdecoder_input_idsを準備する方法については、T5 Training をご覧ください。 - decoder_attention_mask (
torch.BoolTensor、shape(batch_size, target_sequence_length)、任意) — デフォルトの動作:decoder_input_ids内の pad トークンを無視するテンソルを生成します。デフォルトでは、causal mask も使用されます。 - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - encoder_outputs (
torch.Tensor, 任意) —last_hidden_state、任意:hidden_states、任意:attentionsのタプルlast_hidden_stateは形状(batch_size, sequence_length, hidden_size)、任意)であり、エンコーダーの最終層の出力における隠れ状態のシーケンスです。デコーダーのクロスアテンションで使用されます。 - past_key_values (
~cache_utils.Cache, 省略可) — 逐次デコードを高速化するために使用できる、事前計算された隠れ状態(自己アテンションブロックおよびクロスアテンションブロックのキーとバリュー)。通常、これはデコードの以前の段階でモデルが返したpast_key_valuesであり、use_cache=Trueまたはconfig.use_cache=True.入力として許可されるのは Cache インスタンスのみです。kv cache ガイドを参照してください。
past_key_valuesが渡されない場合、デフォルトで DynamicCache が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。
past_key_valuesを使用する場合、すべてのinput_ids(形状(batch_size, sequence_length))ではなく、このモデルに過去のキー・バリュー状態が与えられていない未処理のinput_ids(形状(batch_size, unprocessed_length))のみを入力することになります。 - decoder_inputs_embeds (
torch.Tensorの形状(batch_size, target_sequence_length, hidden_size), 、任意) — 、任意で、decoder_input_idsの代わりに、埋め込み表現を直接渡すこともできます。past_key_valuesが使用されている場合、最後のdecoder_inputs_embedsのみを入力すれば十分です(past_key_values). 、decoder_input_idsのインデックスを関連するベクトルに変換する方法を、モデル内部の埋め込みルックアップ行列よりも細かく制御したい場合に便利です。decoder_input_idsとdecoder_inputs_embedsの両方が設定されていない場合、decoder_inputs_embedsはinputs_embedsの値を採ります。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 言語モデリング損失の計算に使用するラベルです。インデックスは[-100, 0, ..., config.vocab_size - 1]の範囲である必要があります。-100に設定されたすべてのラベルは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲のラベルに対してのみ計算されます。
戻り値
Seq2SeqLMOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または Seq2SeqLMOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(UdopConfig)や入力に応じて、さまざまな要素で構成されます。
UdopForConditionalGenerationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます)— 言語モデリングの損失。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。past_key_values (
EncoderDecoderCache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — EncoderDecoderCache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己注意ブロックおよび相互注意ブロック内のキーとバリューの事前計算済み隠れ状態(hidden-states)を保持しており、シーケンシャルデコーディングを高速化するために使用できます(
past_key_values入力参照)。decoder_hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力における、デコーダーの隠れ状態。
decoder_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのエンコーダーの最終層の出力における、隠れ状態のシーケンス。encoder_hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力におけるエンコーダーの隠れ状態。
encoder_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmaxを適用した後のエンコーダーのアテンション重み。自己アテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoProcessor, UdopForConditionalGeneration
>>> from datasets import load_dataset

>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopForConditionalGeneration.from_pretrained("microsoft/udop-large")

>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> # one can use the various task prefixes (prompts) used during pre-training
>>> # e.g. the task prefix for DocVQA is "Question answering. "
>>> question = "Question answering. What is the date on the form?"
>>> encoding = processor(image, question, text_pair=words, boxes=boxes, return_tensors="pt")

>>> # autoregressive generation
>>> predicted_ids = model.generate(**encoding)
>>> print(processor.batch_decode(predicted_ids, skip_special_tokens=True)[0])
9/30/92
UdopEncoderModel
クラス transformers.UdopEncoderModel
< source >( config: UdopConfig )
パラメータ
- config (UdopConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生の隠れ状態を出力する素の Udop Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonebbox: dict[str, typing.Any] | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Nonevisual_bbox: dict[str, typing.Any] | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithAttentionMask or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length)) — 語彙における入力シーケンスのトークンインデックスです。T5 は相対位置埋め込みを持つモデルであるため、入力の右側と左側の両方にパディングを適用できます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
事前学習のために
input_idsを準備する方法の詳細については、T5 Trainingを参照してください。 - bbox (
torch.LongTensor形状({0}, 4), 任意) — 各入力シーケンスのトークンのバウンディングボックス。範囲[0, config.max_2d_position_embeddings-1]. 各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置、(x1, y1) は右下隅の位置を表します。sequence_length = token_sequence_length + patch_sequence_length + 1であることに注意してください。ここで1は [CLS] トークン用のものです。patch_sequence_lengthについてはpixel_valuesを参照してください。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は LayoutLMv3ImageProcessor を使用して取得できます。詳細については LayoutLMv3ImageProcessor.call() を参照してください(UdopProcessor は画像の処理に LayoutLMv3ImageProcessor を使用します)。 - visual_bbox (
torch.LongTensor、形状(batch_size, patch_sequence_length, 4)、任意) — 画像内の各パッチのバウンディングボックスです。指定しない場合、モデル内でバウンディングボックスが作成されます。 - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
戻り値
BaseModelOutputWithAttentionMask または tuple(torch.FloatTensor)
BaseModelOutputWithAttentionMask、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(UdopConfig)や入力に応じて、さまざまな要素で構成されます。
UdopEncoderModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。past_key_valuesを使用する場合、shape(batch_size, 1, hidden_size)のシーケンスの最後の隠れ状態のみが出力されます。attention_mask (
torch.FloatTensor、shape(batch_size, sequence_length)、任意) — モデルの forward pass で使用されるアテンションマスクです。padding トークンのインデックスに対してアテンションを実行しないようにするために使用します。[0, 1]から選択されるマスクの値:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック内のキーとバリュー、および
config.is_encoder_decoder=Trueの場合のクロスアテンションブロック内のキーとバリューの、事前計算済みヒドゥンステートが含まれます。これらはシーケンシャルデコーディングを高速化するために使用できます(past_key_values入力参照)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(モデルに埋め込み層がある場合はその出力、および各層の出力をそれぞれ1つずつ含む)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルの隠れ状態と、任意の初期埋め込み出力です。attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)で、形状は(batch_size, num_heads, sequence_length, sequence_length)です。アテンションの softmax 後のアテンション重みで、self-attention ヘッドにおける加重平均の計算に使用されます。cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合、またはconfig.add_cross_attention=Trueが渡された場合、またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションの softmax 適用後の、デコーダーのクロスアテンションレイヤーのアテンション重み。クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoProcessor, UdopEncoderModel
>>> from huggingface_hub import hf_hub_download
>>> from datasets import load_dataset

>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopEncoderModel.from_pretrained("microsoft/udop-large")

>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> encoding = processor(image, words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state