
Transformers documentation
Perceiver
このモデルは2021年7月30日にHF papersで公開され、2021年12月8日にHugging Face Transformersに貢献されました。
Perceiver
概要
Perceiver IOモデルは、Andrew Jaegle、Sebastian Borgeaud、Jean-Baptiste Alayrac、Carl Doersch、Catalin Ionescu、David Ding、Skanda Koppula、Daniel Zoran、Andrew Brock、Evan Shelhamer、Olivier Hénaff、Matthew M. Botvinick、Andrew Zisserman、Oriol Vinyals、João Carreira によって、Perceiver IO: A General Architecture for Structured Inputs & Outputs で提案されました。
Perceiver IO は、任意の入力に加えて任意の出力も処理できるように Perceiver を一般化したものです。元の Perceiver は単一の分類ラベルのみを出力していました。Perceiver IO は、分類ラベルに加えて、言語、光流、音声付きマルチモーダル動画などを出力できます。これは、元の Perceiver と同じ構成要素を用いて実現されています。Perceiver IO の計算複雑度は、入力と出力のサイズに対して線形であり、処理の大部分は潜在空間で行われるため、標準的な Transformers では処理できないほど大きな入力と出力を扱えます。例えば、Perceiver IO は、トークン化された入力ではなくバイトを直接使用して、BERT 形式のマスク言語モデリングを行うことができます。
論文の抄録は以下の通りです。
最近提案された Perceiver モデルは、入力サイズに対して計算量とメモリが線形にスケーリングしながら、画像、音声、マルチモーダル、点群など複数のドメインで良好な結果を達成しています。Perceiver は多様な入力に対応できますが、出力としてはクラススコアのような非常に単純なものしか生成できません。Perceiver IO は、モデルの潜在空間を柔軟にクエリして学習することで、任意のサイズや意味を持つ出力を生成し、この制約を克服します。これにより、元のモデルの魅力ある特性を損なうことなく、モデルの深さとデータサイズを分離したまま、データサイズに対して線形にスケーリングする特性を維持します。ただし、スケーリングの対象は入力サイズと出力サイズの両方となります。完全な Perceiver IO モデルは、自然言語や視覚理解、StarCraft II、マルチタスクおよびマルチモーダルドメインなど、出力空間が高度に構造化されたタスクで強力な結果を達成しています。特に注目すべき点として、Perceiver IO は入力トークン化を必要とせずに GLUE 言語ベンチマークで Transformer ベースの BERT ベースラインと同等の性能を達成し、Sintel 光流推定では最先端の性能を達成しています。
Perceiver の仕組みを説明する TLDR(要点)は以下の通りです:
Transformerの自己注意機構の主な問題は、計算時間とメモリ要件がシーケンス長の2乗に比例して増加することです。そのため、BERTやRoBERTaなどのモデルは、最大シーケンス長が512トークンに制限されています。Perceiverは、入力に対して自己注意を実行する代わりに、潜在変数の集合に対して自己注意を実行し、入力はクロスアテンションにのみ使用することで、この問題を解決しようとしています。これにより、256や512のような固定数の潜在変数を使用するため、計算時間とメモリ要件が入力の長さに依存しなくなります。これらの潜在変数はランダムに初期化され、その後、バックプロパゲーションを用いてエンドツーエンドで学習されます。
内部では、PerceiverModel が latents を生成します。これは (batch_size, num_latents, d_latents) という形状のテンソルです。モデルには inputs(テキスト、画像、音声など、何でも構いません)を渡す必要があります。モデルはこれを用いて、latents とのクロスアテンションを実行します。Perceiver エンコーダーの出力は、同じ形状のテンソルです。その後、BERT と同様に、latents の最後の隠れ状態をシーケンス次元に沿って平均化し、その上に線形層を配置して d_latents を num_labels に射影することで、分類ロジットに変換できます。
これが、元の Perceiver 論文のアイデアでした。ただし、出力できるのは分類の logits だけです。その後続研究である PerceiverIO では、モデルが任意のサイズの出力を生成できるように一般化しました。どのように実現したのか、と疑問に思うかもしれません。そのアイデアは比較的シンプルです。任意のサイズの出力を定義し、latents の最後の隠れ状態に対してクロスアテンションを適用します。このとき、出力をクエリとして、latents をキーとバリューとして使用します。
Perceiver を用いたマスク言語モデリング(BERT スタイル)を行う場合を例に考えてみましょう。Perceiver の入力長は自己注意レイヤーの計算時間に影響しないため、モデルに長さ 2048 の inputs として生バイトを渡すことができます。次に、この 2048 トークンのうち特定のトークンをマスクすると、outputs を形状 (batch_size, 2048, 768) と定義できます。その後、latents の最終的な隠れ状態を用いてクロスアテンションを実行し、outputs テンソルを更新します。クロスアテンション後も、テンソルの形状は (batch_size, 2048, 768) のままです。次に、通常の言語モデリングヘッドを上に配置し、最終次元をモデルの語彙サイズに射影します。これにより、形状 (batch_size, 2048, 262) の logits が生成されます(Perceiver は 262 のバイト ID からなる語彙を使用しているため)。
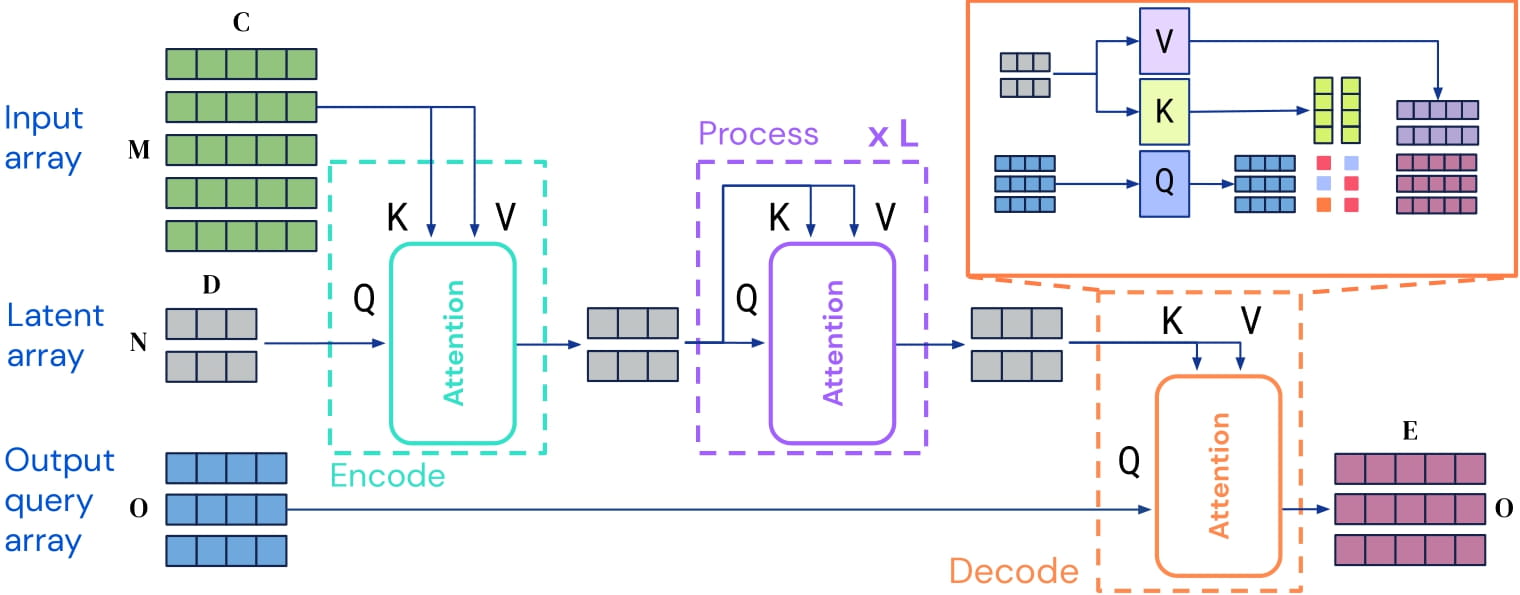 Perceiver IO architecture. Taken from the original paper
このモデルは nielsr によって提供されました。元のコードは こちら で確認できます。
PyTorch のバグにより、Perceiver は
torch.nn.DataParallelと 併用できません。詳細は issue #36035 を参照してください。
リソース
- Perceiverの最も簡単な始め方は、tutorial notebooksを確認することです。
- モデルの動作とライブラリでの実装を完全に理解したい場合は、ブログ記事を参照してください。なお、ライブラリで利用可能なモデルは、Perceiverで実現できることのいくつかの例を示すものにすぎません。質問応答、名前実体認識、物体検出、音声分類、動画分類など、さらに多くのユースケースがあります。
- テキスト分類タスクガイド
- マスクド言語モデリングタスクのガイド
- 画像分類タスクガイド
Perceiver固有の出力
class transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput
< source >( logits: typing.Optional[torch.FloatTensor] = Nonelast_hidden_state: typing.Optional[torch.FloatTensor] = Nonehidden_states: tuple[torch.FloatTensor] | None = Noneattentions: tuple[torch.FloatTensor] | None = Nonecross_attentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- logits (
torch.FloatTensor、形状(batch_size, num_labels)) — 分類スコア(config.num_labels==1 の場合は回帰スコア)(SoftMax 適用前)。 - last_hidden_state (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) — モデルの最終層の出力における隠れ状態のシーケンスです。 - hidden_states (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_hidden_states=Trueが渡された場合、またはconfig.output_hidden_states=True) — のタプルtorch.FloatTensor((埋め込み層を持つモデルの場合は埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は(batch_size, sequence_length, hidden_size).各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- cross_attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
Perceiverベースモデルの出力の基底クラスです。潜在的なhidden states、attentions、cross-attentionsを含む場合があります。
クラス transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput
< source >( logits: typing.Optional[torch.FloatTensor] = Nonecross_attentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- logits (
torch.FloatTensor、形状(batch_size, num_labels)) — 基本デコーダーの出力。 - cross_attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
クロスアテンションを含む可能性のある Perceiver デコーダーの出力の基底クラス。
class transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput
< source >( loss: typing.Optional[torch.FloatTensor] = Nonelogits: typing.Optional[torch.FloatTensor] = Nonehidden_states: tuple[torch.FloatTensor] | None = Noneattentions: tuple[torch.FloatTensor] | None = Nonecross_attentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます)— マスクド言語モデリング (MLM) の損失です。 - logits (
torch.FloatTensor、形状(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。 - hidden_states (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_hidden_states=Trueが渡された場合、またはconfig.output_hidden_states=True) — のタプルtorch.FloatTensor((埋め込み層を持つモデルの場合は埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は(batch_size, sequence_length, hidden_size).各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- cross_attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
Perceiverのマスク言語モデルの出力の基底クラス。
class transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput
< source >( loss: typing.Optional[torch.FloatTensor] = Nonelogits: typing.Optional[torch.FloatTensor] = Nonehidden_states: tuple[torch.FloatTensor] | None = Noneattentions: tuple[torch.FloatTensor] | None = Nonecross_attentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます)— 分類(または、config.num_labels==1 の場合は回帰)の損失。 - logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — 分類スコア(config.num_labels==1 の場合は回帰スコア)(SoftMax 適用前)。 - hidden_states (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_hidden_states=Trueが渡された場合、またはconfig.output_hidden_states=True) — のタプルtorch.FloatTensor((埋め込み層を持つモデルの場合は埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は(batch_size, sequence_length, hidden_size).各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- cross_attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
シーケンス/画像分類モデル、光流、マルチモーダル自動符号化のPerceiverの出力の基底クラス。
PerceiverConfig
クラス transformers.PerceiverConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_latents: int = 256d_latents: int = 1280d_model: int = 768num_blocks: int = 1num_self_attends_per_block: int = 26num_self_attention_heads: int = 8num_cross_attention_heads: int = 8qk_channels: int | None = Nonev_channels: int | None = Nonecross_attention_shape_for_attention: str = 'kv'self_attention_widening_factor: int = 1cross_attention_widening_factor: int = 1hidden_act: str = 'gelu'attention_probs_dropout_prob: float | int = 0.1initializer_range: float = 0.02layer_norm_eps: float = 1e-12use_query_residual: bool = Truevocab_size: int = 262max_position_embeddings: int = 2048image_size: int | list[int] | tuple[int, int] = 56train_size: list[int] | tuple[int, ...] = (368, 496)num_frames: int = 16audio_samples_per_frame: int = 1920samples_per_patch: int = 16output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224)output_num_channels: int = 512_label_trainable_num_channels: int = 1024 )
パラメータ
- num_latents (
int、任意、デフォルトは 256) — 潜在変数の数です。 - d_latents (
int、任意、デフォルトは 1280)— 潜在埋め込みの次元数。 - d_model (
int、任意、デフォルトは768) — エンコーダ層とプーラ層のサイズ。 - num_blocks (
int、任意、デフォルトは 1) — Transformer エンコーダーのブロック数。 - num_self_attends_per_block (
int、任意、デフォルト値は 26) — ブロックあたりの自己注意レイヤーの数。 - num_self_attention_heads (
int、任意、デフォルトは 8) — Transformer エンコーダーの各自己注意層におけるアテンションヘッドの数。 - num_cross_attention_heads (
int、任意、デフォルトは 8)— Transformer エンコーダーの各クロスアテンション層におけるアテンションヘッドの数。 - qk_channels (
int, 省略可) — エンコーダーのクロスアテンション層およびセルフアテンション層で、アテンションを適用する前にクエリとキーを射影する次元。指定しない場合、クエリの次元を維持した値がデフォルトとして使用されます。 - v_channels (
int, 任意) — エンコーダーのクロスアテンション層および自己アテンション層で、アテンションを適用する前に値を射影するための次元数。指定しない場合、クエリの次元を維持した値がデフォルトとして使用されます。 - cross_attention_shape_for_attention (
str、省略可能、デフォルトは"kv") — エンコーダーのクロスアテンション層でクエリとキーをダウンサンプリングする際に使用する次元です。 - self_attention_widening_factor (
int、任意、デフォルト値は 1)— Transformer エンコーダーのクロスアテンション層におけるフィードフォワード層の次元数。 - cross_attention_widening_factor (
int、任意、デフォルト値は 1) — Transformer エンコーダーの自己アテンション層におけるフィードフォワード層の次元数。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - attention_probs_dropout_prob (
Union[float, int]、任意、デフォルトは0.1) — アテンション確率のドロップアウト率です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-12) — レイヤーノーマル層で使用する epsilon です。 - use_query_residual (
float、省略可能、デフォルトはTrue) — エンコーダーのクロスアテンション層にクエリ残差を加えるかどうかを指定します。 - vocab_size (
int、任意、デフォルトは262) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - max_position_embeddings (
int、任意、デフォルトは2048) — このモデルが使用される可能性のある最大シーケンス長です。 - image_size (
int、任意、デフォルト値: 56) — PerceiverForImageClassificationLearned において、前処理後の画像サイズです。 - train_size (
list[int]、任意、デフォルトは[368, 496]) — 光流モデルの学習に使用する画像サイズです。 - num_frames (
int、任意、デフォルトは 16)— マルチモーダルオートエンコーディングモデルで使用する動画フレームの数です。 - audio_samples_per_frame (
int、任意、デフォルト値は 1920) — マルチモーダルオートエンコーディングモデルにおけるフレームあたりのオーディオサンプル数。 - samples_per_patch (
int、任意、デフォルトは 16)— マルチモーダルオートエンコーディングモデルの事前処理において、パッチあたりのオーディオサンプル数。 - output_shape (
list[int]、任意、デフォルトは[1, 16, 224, 224]) — マルチモーダルオートエンコーディングモデルのビデオデコーダークエリにおける出力の形状 (batch_size, num_frames, height, width) です。これはチャネル次元を含まない形状です。 - output_num_channels (
int、任意、デフォルトは 512) — 各モダリティデコーダーの出力チャネル数。
This is the configuration class to store the configuration of a PerceiverModel. It is used to instantiate a Perceiver model according to the specified arguments, defining the model architecture. Instantiating a configuration with the defaults will yield a similar configuration to that of the deepmind/language-perceiver
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import PerceiverModel, PerceiverConfig

>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()

>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PerceiverTokenizer
class transformers.PerceiverTokenizer
< source >( pad_token = '[PAD]'bos_token = '[BOS]'eos_token = '[EOS]'mask_token = '[MASK]'cls_token = '[CLS]'sep_token = '[SEP]'model_max_length = 2048**kwargs )
パラメータ
- pad_token (
str、任意、デフォルトは"[PAD]") — パディングに使用されるトークンです。例えば、長さが異なるシーケンスをバッチ処理する場合に使用します。 - bos_token (
str、任意、デフォルトは"[BOS]") — BOS トークン(語彙に予約されているが、実際には使用されない)。 - eos_token (
str, 省略可, デフォルトは"[EOS]") — シーケンスの終了トークン(語彙に予約されているが、実際には使用されない)。特殊トークンを用いてシーケンスを構築する場合、シーケンスの終了に使用されるのはこのトークンではありません。 使用されるのは
sep_tokenです。 - mask_token (
str、任意、デフォルトは"[MASK]") — マスク言語モデリングに有用な MASK トークンです。 - cls_token (
str、省略可能、デフォルトは"[CLS]") — CLS トークン(語彙に予約されているが、実際には使用されない)。 - sep_token (
str、任意、デフォルトは"[SEP]") — 2つのシーケンスからシーケンスを構築する際に使用される区切りトークンです。
Perceiver トークナイザーを構築します。Perceiver は、生のバイトの utf-8 エンコーディングをそのまま使用します。
このトークナイザーは、PreTrainedTokenizer を継承しており、主要なメソッドのほとんどが含まれています。これらのメソッドに関する詳細については、このスーパークラスを参照してください。
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
パラメータ
- text (
str、list[str]、list[list[str]]、任意) — エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは、文字列または文字列のリスト(事前トークン化済み文字列)であることができます。シーケンスが文字列のリスト(事前トークン化済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - text_pair (
str、list[str]、list[list[str]]、任意) — エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは、文字列または文字列のリスト(事前トークン化された文字列)であることができます。シーケンスが文字列のリスト(事前トークン化済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - text_target (
str、list[str]、list[list[str]]、任意) — ターゲットテキストとしてエンコードされるシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(プレトークナイズ済み文字列)であることができます。シーケンスが文字列のリスト(プレトークナイズ済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - text_pair_target (
str、list[str]、list[list[str]]、任意) — ターゲットテキストとしてエンコードされるシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(プレトークナイズ済み文字列)であることができます。シーケンスが文字列のリスト(プレトークナイズ済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - tokenizer_kwargs (
dict[str, Any]、省略可) — トークナイザーに渡す追加の kwargs です。これらは明示的なパラメータおよびその他の kwargs とマージされますが、明示的なパラメータが優先されます。 - add_special_tokens (
bool、省略可、デフォルトはTrue) — シーケンスをエンコードする際に特殊トークンを追加するかどうかを指定します。これは、入力 ID に自動的に追加されるトークンを定義する基盤となるPretrainedTokenizerBase.build_inputs_with_special_tokens関数を使用します。bosやeosトークンを自動的に追加したい場合に便利です。 - padding (
bool,strまたは PaddingStrategy, 省略可, デフォルトはFalse) — パディングの有効化と制御を行います。以下の値を受け入れます:Trueまたは'longest': バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。'max_length': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。Falseまたは'do_not_pad'(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
- truncation (
bool,strまたは TruncationStrategy, 省略可能, デフォルトはFalse) — 切り詰めを有効にし、制御します。以下の値を受け取ります:Trueまたは'longest_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。この場合、トークン単位で切り詰めが行われ、ペアのシーケンス(またはペアのバッチ)が提供されている場合は、ペアの中で最も長いシーケンスから1トークンずつ削除します。'only_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れることのできる最大入力長まで切り詰めます。この設定では、ペアのシーケンス(またはペアのバッチ)が提供された場合のみ、ペアの最初のシーケンスだけが切り詰められます。'only_second': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長まで切り詰めます。このモードでは、シーケンスのペア(またはペアのバッチ)が提供された場合のみ、ペアの2番目のシーケンスが切り詰められます。Falseまたは'do_not_truncate'(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
- max_length (
int, 省略可能) — truncation/padding パラメータのいずれかによって使用される最大長を制御します。未設定のまま、または
Noneに設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。 - stride (
int、省略可能、デフォルトは 0) —max_lengthとともに数値が設定されている場合、return_overflowing_tokens=Trueで返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複を確保します。この引数の値は、重複するトークンの数を定義します。 - is_split_into_words (
bool、任意、デフォルトはFalse) — 入力がすでに事前トークン化済み(例:単語に分割済み)かどうかを指定します。Trueに設定すると、トークナイザーは入力がすでに単語に分割済み(たとえば空白で分割済み)であると仮定し、それをトークン化します。これは NER やトークン分類に有用です。 - pad_to_multiple_of (
int, 任意) — 設定すると、指定された値の倍数にシーケンスをパディングします。paddingが有効になっている必要があります。 これは、計算能力が>= 7.5(Volta) の NVIDIA ハードウェア上で Tensor Cores を使用可能にするために特に有用です。 - padding_side (
str, 省略可) — モデルにパディングを適用する側です。[‘right’, ‘left’] のいずれかを選択してください。 デフォルト値は、同名のクラス属性から取得されます。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': Numpy のnp.ndarrayオブジェクトを返します。
- return_token_type_ids (
bool, 省略可能) — トークンタイプIDを返すかどうか。デフォルトのままにすると、特定のトークナイザーのデフォルトに従ってトークンタイプIDを返します。これはreturn_outputs属性で定義されます。 - return_attention_mask (
bool, 省略可能) — attention mask を返すかどうか。デフォルトのままにすると、return_outputs属性によって定義される、特定の tokenizer のデフォルトに従って attention mask を返します。 - return_overflowing_tokens (
bool、任意、デフォルトはFalse) — 溢れ出したトークンシーケンスを返すかどうかを指定します。入力 ID のシーケンスのペア(またはペアのバッチ)がtruncation_strategy = longest_firstまたはTrueとともに提供された場合、溢れ出したトークンを返す代わりにエラーが発生します。 - return_special_tokens_mask (
bool、省略可能、デフォルトはFalse) — 特殊トークンのマスク情報を返すかどうかを指定します。 - return_offsets_mapping (
bool, 省略可能, デフォルトはFalse) — 各トークンについて(char_start, char_end)を返すかどうか。この機能は、PreTrainedTokenizerFast を継承する高速トークナイザーでのみ利用可能です。Python のトークナイザーを使用している場合、このメソッドは
NotImplementedErrorを送出します。 - return_length (
bool、任意、デフォルトはFalse) — エンコードされた入力の長さを返すかどうかを指定します。 - verbose (
bool、任意、デフォルトはTrue) — より多くの情報や警告を表示するかどうかを指定します。 - **kwargs —
self.tokenize()メソッドに渡されます
戻り値
以下のフィールドを持つBatchEncoding:
-
input_ids — モデルに与えるトークン ID のリスト。
-
token_type_ids — モデルに渡すトークンタイプIDのリスト(
return_token_type_ids=Trueの場合、またはself.model_input_namesに“token_type_ids”が含まれている場合)。 -
attention_mask — モデルがどのトークンに注意を向けるべきかを指定するインデックスのリスト(
return_attention_mask=Trueの場合、またはself.model_input_namesに “attention_mask” が含まれている場合)。 -
overflowing_tokens — 溢れ出したトークンシーケンスのリスト(
max_lengthが指定され、return_overflowing_tokens=Trueの場合)。 -
num_truncated_tokens — トークンが切り詰められた数(
max_lengthが指定され、return_overflowing_tokens=Trueの場合)。 -
special_tokens_mask — 0 と 1 のリスト。1 は追加された特殊トークンを、0 は通常のシーケンストークンを示します(
add_special_tokens=Trueかつreturn_special_tokens_mask=Trueの場合)。 -
length — 入力データの長さ(
return_length=Trueの場合)
1 つ以上のシーケンス、または 1 つ以上のシーケンスのペアをトークナイズし、モデル用に準備するためのメインメソッドです。
PerceiverImageProcessor
クラス transformers.PerceiverImageProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, デフォルトは{'height' -- 224, 'width': 224}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'height' -- 256, 'width': 256}):center_cropを適用した後の出力画像のサイズです。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool、kwargs、optional、デフォルトはTrue) — 画像を中央クロップするかどうか。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
PerceiverImageProcessor 画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - image_like_kwargs (
dict[str, Any], 省略可) — 追加の画像類似入力を前処理対象に含めるための開発者向けフラグです。引数として入力値を渡す方法が機能しない場合のみ使用してください。例えば、preprocess(images, masks=masks)が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりにpreprocess(images, image_like_inputs={"masks": masks})を使用できます。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
PerceiverImageProcessorPil
クラス transformers.PerceiverImageProcessorPil
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, デフォルトは{'height' -- 224, 'width': 224}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'height' -- 256, 'width': 256}):center_cropを適用した後の出力画像のサイズです。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool、kwargs、optional、デフォルトはTrue) — 画像を中央クロップするかどうか。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
PerceiverImageProcessor 画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - image_like_kwargs (
dict[str, Any], 省略可) — 追加の画像類似入力を前処理対象に含めるための開発者向けフラグです。引数として入力値を渡す方法が機能しない場合のみ使用してください。例えば、preprocess(images, masks=masks)が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりにpreprocess(images, image_like_inputs={"masks": masks})を使用できます。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
PerceiverTextPreprocessor
class transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルの設定です。
Perceiver Encoder用のテキスト前処理。inputsを埋め込み、位置エンコーディングを追加するために使用できます。
埋め込みの次元数は、設定のd_model属性によって決定されます。
PerceiverImagePreprocessor
クラス transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor
< source >( configprep_type = 'conv'spatial_downsample: int = 4temporal_downsample: int = 1position_encoding_type: str = 'fourier'in_channels: int = 3out_channels: int = 64conv_after_patching: bool = Falseconv_after_patching_in_channels: int = 54conv2d_use_batchnorm: bool = Trueconcat_or_add_pos: str = 'concat'project_pos_dim: int = -1**position_encoding_kwargs )
パラメータ
- config ([PerceiverConfig]) — モデルの設定です。
- prep_type (
str、任意、デフォルトは"conv") — 前処理の種類。“conv1x1”、“conv”、“patches”、“pixels”のいずれかを指定できます。 - spatial_downsample (
int、省略可能、デフォルト値は 4) — 空間的下サンプリング係数です。 - temporal_downsample (
int、任意、デフォルトは 1) — 時間方向のダウンサンプリング係数(時間次元が存在する場合のみ関連します)。 - position_encoding_type (
str、任意、デフォルトは"fourier") — 位置エンコーディングの種類。“fourier” または “trainable” を指定できます。 - in_channels (
int、省略可、デフォルト値は 3) — 入力データのチャネル数。 - out_channels (
int、省略可能、デフォルトは 64)— 出力のチャネル数。 - conv_after_patching (
bool、任意、デフォルトはFalse) — パッチ適用後に畳み込み層を適用するかどうかを指定します。 - conv_after_patching_in_channels (
int、任意、デフォルト値は 54)— パッチ適用後の畳み込み層の入力チャネル数です。 - conv2d_use_batchnorm (
bool、任意、デフォルトはTrue) — 畳み込み層でバッチ正規化を使用するかどうか。 - concat_or_add_pos (
str、optional、デフォルトは"concat") — 位置エンコーディングを入力に結合する方法。“concat” または “add” を指定できます。 - project_pos_dim (
int、任意、デフォルトは -1) — 位置エンコーディングを射影する次元数です。-1 の場合は、射影は適用されません。 - **position_encoding_kwargs (
Dict, optional) — 位置エンコーディング用のキーワード引数。
Perceiver Encoder用の画像前処理。
注: out_channels引数は、prep_typeが“conv1x1”または“conv”に設定されている場合、畳み込み層の出力チャネル数を指します。絶対位置埋め込みを追加する場合は、位置エンコーディングのkwargsのnum_channelsがout_channelsと等しくなるよう設定していることを確認してください。
PerceiverOneHotPreprocessor
クラス transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルの設定です。
Perceiver Encoder用のOne-hotプリプロセッサです。入力にダミーのインデックス次元を追加するために使用できます。
PerceiverAudioPreprocessor
class transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor
< source >( configprep_type: str = 'patches'samples_per_patch: int = 96position_encoding_type: str = 'fourier'concat_or_add_pos: str = 'concat'out_channels = 64project_pos_dim = -1**position_encoding_kwargs )
パラメータ
- config ([PerceiverConfig]) — モデルの設定です。
- prep_type (
str、任意、デフォルトは"patches") — 使用するプリプロセッサの種類です。サポートされているのは “patches” のみです。 - samples_per_patch (
int、任意、デフォルト値は 96)— パッチごとのサンプル数。 - position_encoding_type (
str、任意、デフォルトは"fourier") — 使用する位置エンコーディングの種類です。“trainable”または“fourier”を指定できます。 - concat_or_add_pos (
str、optional、デフォルトは"concat") — 位置エンコーディングを入力に結合する方法。“concat” または “add” を指定できます。 - out_channels (
int、省略可能、デフォルトは 64)— 出力のチャネル数。 - project_pos_dim (
int、任意、デフォルトは -1) — 位置エンコーディングを射影する次元数です。-1 の場合は、射影は適用されません。 - **position_encoding_kwargs (
Dict, optional) — 位置エンコーディング用のキーワード引数。
Perceiver Encoder用のオーディオ前処理。
PerceiverMultimodalPreprocessor
class transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor
< source >( modalities: Mappingmask_probs: collections.abc.Mapping[str, float] | None = Nonemin_padding_size: int = 2 )
Perceiver Encoder向けのマルチモーダル前処理。
各モダリティの入力は前処理され、その後、学習可能な位置埋め込みでパディングされて、チャネル数が揃えられます。
PerceiverProjectionDecoder
class transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder
< source >( config )
パラメータ
- config (PerceiverConfig) — モデルの設定です。
ベースラインの予測デコーダー(クロスアテンションなし)。
PerceiverBasicDecoder
クラス transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder
< source >( config: PerceiverConfigoutput_num_channels: intposition_encoding_type: str | None = 'trainable'output_index_dims: int | None = Nonenum_channels: int | None = 128subsampled_index_dims: int | None = Noneqk_channels: int | None = Nonev_channels: int | None = Nonenum_heads: int | None = 1widening_factor: int | None = 1use_query_residual: bool | None = Falseconcat_preprocessed_input: bool | None = Falsefinal_project: bool | None = Trueposition_encoding_only: bool | None = False**position_encoding_kwargs )
パラメータ
- config ([PerceiverConfig]) — モデルの設定です。
- output_num_channels (
int, 任意) — 出力のチャネル数。final_project がTrueに設定されている場合のみ使用されます。 - position_encoding_type (
str, 任意、デフォルトは “trainable”) — 使用する位置エンコーディングの種類です。“trainable”、“fourier”、“none” のいずれかを指定できます。 - output_index_dims (
int, 任意) — 出力クエリの次元数です。‘position_encoding_type’ == ‘none’ の場合は無視されます。 - num_channels (
int, 任意、デフォルトは 128) — デコーダークエリのチャネル数です。‘position_encoding_type’ == ‘none’ の場合は無視されます。 - qk_channels (
int, 省略可) — クロスアテンション層におけるクエリとキーのチャネル数。 - v_channels (
int, 任意) — クロスアテンション層の値のチャネル数。 - num_heads (
int、任意、デフォルトは 1) — クロスアテンション層におけるアテンションヘッドの数。 - widening_factor (
int、任意、デフォルトは 1) — クロスアテンション層のワイドニング係数です。 - use_query_residual (
bool、任意、デフォルトはFalse) — クエリとクロスアテンション層の出力との間に残差接続を使用するかどうかを指定します。 - concat_preprocessed_input (
bool、省略可、デフォルトはFalse) — 前処理済みの入力をクエリに連結するかどうかを指定します。 - final_project (
bool、省略可、デフォルトはTrue) — クロスアテンション層の出力をターゲット次元に射影するかどうかを指定します。 - position_encoding_only (
bool、任意、デフォルトはFalse) — このクラスを出力クエリの定義にのみ使用するかどうかを指定します。
Cross-attentionベースのデコーダー。このクラスは、latentsがキーとバリューを生成するcross-attention操作を用いて、latentsの最終的なhidden statesをデコードするために使用できます。
このクラスの出力の形状は、出力クエリ(デコーダクエリとも呼ばれる)の定義方法によって異なります。
PerceiverClassificationDecoder
class transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder
< source >( config**decoder_kwargs )
パラメータ
- config (PerceiverConfig) — モデルの設定です。
Cross-attention ベースの分類デコーダー。PerceiverBasicDecoder の軽量ラッパーで、logit を出力します。
Perceiver エンコーダーの出力(shape: (batch_size, num_latents, d_latents))を、shape (batch_size, num_labels) のテンソルに変換します。クエリの shape は (batch_size, 1, num_labels) です。
PerceiverOpticalFlowDecoder
class transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder
< source >( configoutput_image_shapeoutput_num_channels = 2rescale_factor = 100.0**decoder_kwargs )
Cross-attention ベースの光流デコーダー。
PerceiverBasicVideoAutoencodingDecoder
class transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder
< source >( config: PerceiverConfigoutput_shape: listposition_encoding_type: str**decoder_kwargs )
Cross-attention ベースの video-autoencoding デコーダー。PerceiverBasicDecoder の軽量ラッパーで、video の reshaping ロジックを含みます。
PerceiverMultimodalDecoder
class transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder
< source >( config: PerceiverConfigmodalities: dictnum_outputs: intoutput_num_channels: intmin_padding_size: int | None = 2subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None**decoder_kwargs )
パラメータ
- config ([PerceiverConfig]) — モデルの設定です。
- modalities (
dict[str, PerceiverAbstractDecoder]) — モダリティ名をそのモダリティのデコーダーにマッピングする辞書。 - num_outputs (
int) — デコーダーの出力数。 - output_num_channels (
int) — 出力のチャネル数。 - min_padding_size (
int、任意、デフォルトは 2) — すべてのモダリティにおける最小のパディングサイズです。最終的な出力の num_channels は、すべてのモダリティの最大チャンネル数に min_padding_size を加えた値になります。 - subsampled_index_dims (
dict[str, PerceiverAbstractDecoder]、任意) — モダリティ名を、そのモダリティのデコーダークエリに使用するサブサンプリングされたインデックス次元にマッピングする辞書。
単一モーダルデコーダーを組み合わせることで、マルチモーダルデコーディングを実現します。コンストラクタの modalities 引数は、モーダル名をそのモーダルのデコーダーにマッピングする辞書です。そのデコーダーは、該当するモーダルのクエリを構築するために使用されます。モーダル固有のクエリは、学習可能なモーダル固有のパラメータでパディングされた後、時間次元に沿って連結されます。
次に、すべてのモダリティにまたがる共有クロスアテンション操作があります。
PerceiverProjectionPostprocessor
クラス transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor
< source >( in_channels: intout_channels: int )
Perceiver用のProjection後処理。デコーダー出力のチャネルをより低い次元に射影するために使用できます。
PerceiverAudioPostprocessor
class transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor
< source >( config: PerceiverConfigin_channels: intpostproc_type: str = 'patches' )
Perceiver用のオーディオ後処理。デコーダーの出力をオーディオ特徴量に変換するために使用できます。
PerceiverClassificationPostprocessor
class transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor
< source >( config: PerceiverConfigin_channels: int )
Perceiver用の分類後処理。デコーダーの出力を分類ロジットに変換するために使用できます。
PerceiverMultimodalPostprocessor
class transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor
< source >( modalities: Mappinginput_is_dict: bool = False )
Perceiver用のマルチモーダル後処理。モダリティ固有の後処理器を単一の後処理器に統合するために使用できます。
PerceiverModel
class transformers.PerceiverModel
< source >( config: PerceiverConfigdecoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = Noneinput_preprocessor: Callable = Noneoutput_postprocessor: Callable = None )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
- decoder (
PerceiverDecoder、任意) — 潜在表現をタスクの予測に変換するデコーダーモジュール。 - input_preprocessor (
PreprocessorType、省略可) — モデル用のテンソルへ生入力をエンコードするプリプロセッサ。 - output_postprocessor (
PostprocessorType、省略可) — モデルの出力を最終的な予測に変換する Postprocessor です。
Perceiver:スケーラブルで、完全にアテンションベースのアーキテクチャ。
モデルの forward で
interpolate_pos_encodingをTrueに設定することで、Perceiver を学習時に使用した解像度よりも高い解像度の画像でファインチューニングすることが可能です。これにより、事前学習済みの位置エンベディングがより高い解像度に補間されます。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: FloatTensorattention_mask: typing.Optional[torch.FloatTensor] = Nonesubsampled_output_points: dict[str, torch.Tensor] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Noneinterpolate_pos_encoding: bool = Falsereturn_dict: bool | None = None**kwargs ) → PerceiverModelOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.FloatTensor) — Perceiverへの入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- subsampled_output_points (
dict[str, torch.Tensor], optional) — デコーダーのクエリとして使用されるテンソルの辞書です。デコーダーはこれらのクエリをモデルの潜在表現にマッピングします。サブサンプリングされたデコーディング、例えば特定の画像パッチのみをデコードする場合などに使用されます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - interpolate_pos_encoding (
bool、省略可、デフォルトはFalse) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
PerceiverModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverModelOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
logits (
torch.FloatTensor、shape(batch_size, num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰)。last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルの最終層の出力における隠れ状態のシーケンス。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
...     PerceiverTextPreprocessor,
...     PerceiverImagePreprocessor,
...     PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image

>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
...     config,
...     num_channels=config.d_latents,
...     trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
...     use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)

>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids

>>> with torch.no_grad():
...     outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]

>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()

>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)

>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
...     config,
...     prep_type="conv1x1",
...     spatial_downsample=1,
...     out_channels=256,
...     position_encoding_type="trainable",
...     concat_or_add_pos="concat",
...     project_pos_dim=256,
...     trainable_position_encoding_kwargs=dict(
...         num_channels=256,
...         index_dims=config.image_size**2,
...     ),
... )

>>> model = PerceiverModel(
...     config,
...     input_preprocessor=preprocessor,
...     decoder=PerceiverClassificationDecoder(
...         config,
...         num_channels=config.d_latents,
...         trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
...         use_query_residual=True,
...     ),
... )

>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values

>>> with torch.no_grad():
...     outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]

>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()

>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
PerceiverForMaskedLM
class transformers.PerceiverForMaskedLM
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Perceiverをマスク言語モデリングに用いる例。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneinput_ids: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverMaskedLMOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[-100, 0, ..., config.vocab_size]の範囲である必要があります(input_idsのドキュメント文字列を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲のラベルを持つトークンに対してのみ計算されます。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
戻り値
PerceiverMaskedLMOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または return_dict=False が渡された場合、または config.return_dict=False の場合は torch.FloatTensor のタプルとして返されます。設定 (PerceiverConfig) や入力に応じて、PerceiverMaskedLMOutput または torch.FloatTensor のタプルとして、さまざまな要素が含まれます。
PerceiverForMaskedLMのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — マスクド言語モデリング (MLM) の損失。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")

>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids

>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87

>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]

>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")

>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id

>>> # forward pass
>>> with torch.no_grad():
...     outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]

>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
PerceiverForSequenceClassification
クラス transformers.PerceiverForSequenceClassification
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Perceiver をテキスト分類に使用した例。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneinput_ids: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 分類/回帰の損失を計算するためのラベルです。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(Mean-Square loss)が計算され、config.num_labels > 1の場合は分類損失(Cross-Entropy)が計算されます。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
戻り値
PerceiverClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverClassifierOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverForSequenceClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")

>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
PerceiverForImageClassificationLearned
class transformers.PerceiverForImageClassificationLearned
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ImageNetなどのタスクにおける画像分類でのPerceiverの使用例。
このモデルは学習された位置埋め込みを使用しています。つまり、このモデルには画像の構造に関する特別な情報が与えられていません。論文に示されているように、このモデルはImageNetでトップ1精度72.7を達成できます。
PerceiverForImageClassificationLearned は、入力画像の前処理に PerceiverImagePreprocessor(prep_type="conv1x1" を使用)を、PerceiverModel の潜在表現を分類 logits にデコードするために PerceiverClassificationDecoder を使用します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = Falsereturn_dict: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 画像分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - interpolate_pos_encoding (
bool、省略可、デフォルトはFalse) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は PerceiverImageProcessor を使用して取得できます。詳細については PerceiverImageProcessor.call() を参照してください(processor_classは画像の処理に PerceiverImageProcessor を使用します)。
戻り値
PerceiverClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverClassifierOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverForImageClassificationLearnedのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")

>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
PerceiverForImageClassificationFourier
class transformers.PerceiverForImageClassificationFourier
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ImageNetなどのタスクにおける画像分類でのPerceiverの使用例。
このモデルは固定の2次元フーリエ位置埋め込みを使用しています。論文に示されているように、このモデルはImageNetでトップ1精度79.0を達成し、大規模データセット(JFTなど)で事前学習を行うと84.5に向上します。
PerceiverForImageClassificationLearned は、入力画像の前処理に PerceiverImagePreprocessor(prep_type="pixels" を指定)を使用し、PerceiverModel の潜在表現を分類 logits にデコードするために PerceiverClassificationDecoder を使用します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 画像分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は PerceiverImageProcessor を使用して取得できます。詳細については PerceiverImageProcessor.call() を参照してください(processor_classは画像の処理に PerceiverImageProcessor を使用します)。
戻り値
PerceiverClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverClassifierOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverForImageClassificationFourierのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")

>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
PerceiverForImageClassificationConvProcessing
クラス transformers.PerceiverForImageClassificationConvProcessing
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ImageNetなどのタスクにおける画像分類でのPerceiverの使用例。
このモデルは、2D conv+maxpoolの事前処理ネットワークを使用しています。論文に示されているように、このモデルはImageNetでtop-1精度82.1を達成できます。
PerceiverForImageClassificationLearned は、入力画像の前処理に PerceiverImagePreprocessor(prep_type="conv" を使用)を、PerceiverModel の潜在表現を分類 logits にデコードするために PerceiverClassificationDecoder を使用します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 画像分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は PerceiverImageProcessor を使用して取得できます。詳細については PerceiverImageProcessor.call() を参照してください(processor_classは画像の処理に PerceiverImageProcessor を使用します)。
戻り値
PerceiverClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverClassifierOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverForImageClassificationConvProcessingのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")

>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
PerceiverForOpticalFlow
class transformers.PerceiverForOpticalFlow
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Sintel や KITTI などのタスクにおける光流の Perceiver の使用例。PerceiverForOpticalFlow は、入力画像の前処理に PerceiverImagePreprocessor(prep_type=“patches” を使用)を、PerceiverModel の潜在表現のデコードに PerceiverOpticalFlowDecoder を使用します。
入力として、2つの連続フレームをチャネル次元に沿って連結し、各ピクセルの周囲の3 x 3パッチを抽出します(これにより、各ピクセルあたり3 x 3 x 3 x 2 = 54個の値が得られます)。パッチ内の各ピクセルの位置をエンコードするために、固定のFourier位置エンコーディングを使用します。次に、Perceiverエンコーダを適用します。デコード時には、入力に使用したのと同じエンコーディングを用いて、潜在表現をクエリします。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 光流損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
PerceiverClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverClassifierOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverForOpticalFlowのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import PerceiverForOpticalFlow
>>> import torch

>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")

>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
PerceiverForMultimodalAutoencoding
class transformers.PerceiverForMultimodalAutoencoding
< source >( config: PerceiverConfig )
パラメータ
- config (PerceiverConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Kinetics-700などのタスクにおいて、Perceiverをマルチモーダル(動画)オートエンコーディングに用いる例。
PerceiverForMultimodalAutoencoding は、PerceiverMultimodalPreprocessor を使用して、画像、音声、クラスラベルという3つのモダリティを前処理します。この前処理器は、モダリティ固有の前処理器を用いて各モダリティを個別に前処理し、その後それらを連結します。連結可能なように、各モダリティを同じ数のチャネルにパディングするために、学習可能な位置埋め込みを使用します。その後、Perceiver エンコーダーを適用します。
PerceiverMultimodalDecoder は、PerceiverModel の潜在表現をデコードするために使用されます。このデコーダーは、各モダリティ固有のデコーダーを用いてクエリを構築します。デコーダーのクエリは、前処理後の入力に基づいて作成されます。ただし、単一のフォワードパスで動画全体をオートエンコードすることは計算上実行不可能なため、潜在表現とのクロスアテンションには、デコーダーのクエリの一部のみを使用します。これは、各モダリティのサブサンプリングされたインデックスによって決定され、PerceiverForMultimodalAutoencoding のフォワードパスへの追加入力として提供できます。
PerceiverMultimodalDecoder は、異なるモダリティのデコーダークエリを同じ数のチャネルにパディングし、時間次元に沿って連結します。その後、PerceiverModel の潜在表現を用いてクロスアテンションを実行します。
最後に、~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor を使用して、このテンソルを実際の動画に変換します。まず出力を異なるモダリティに分割し、その後、各モダリティに対応するポストプロセッサーを適用します。
評価時に分類ラベルをマスク(つまり、「label」モダリティにゼロのテンソルを渡す)することで、このオートエンコーディングモデルはKinetics 700の動画分類器として機能することに注意してください。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonesubsampled_output_points: dict[str, torch.Tensor] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- inputs (
torch.Tensor, 任意) — Perceiver への入力です。画像、テキスト、音声、動画など、何でも構いません。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- subsampled_output_points (
dict[str, torch.Tensor], optional) — デコーダーのクエリとして使用されるテンソルの辞書です。デコーダーはこれらのクエリをモデルの潜在表現にマッピングします。サブサンプリングされたデコーディング、例えば特定の画像パッチのみをデコードする場合などに使用されます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 画像分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
PerceiverClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または PerceiverClassifierOutput。設定(PerceiverConfig)や入力に応じて、さまざまな要素で構成されます。
PerceiverForMultimodalAutoencoding の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np

>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))

>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")

>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
...     "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
...     "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
...     "label": None,
... }

>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]

>>> list(logits["image"].shape)
[1, 6272, 3]

>>> list(logits["label"].shape)
[1, 700]