
Transformers documentation
OneFormer
このモデルは2022年11月10日にHF papersで公開され、2023年1月19日にHugging Face Transformersに貢献されました。
OneFormer
概要
OneFormerモデルは、Jitesh Jain、Jiachen Li、MangTik Chiu、Ali Hassani、Nikita Orlov、Humphrey Shi によって提唱された OneFormer: One Transformer to Rule Universal Image Segmentation に記載されています。OneFormerは、単一のパンオプティックデータセットで学習させることで、セマンティックセグメンテーション、インスタンスセグメンテーション、パンオプティックセグメンテーションのタスクを実行できる汎用的な画像セグメンテーションフレームワークです。OneFormerはタスクトークンを用いて、注目しているタスクに基づいてモデルを条件付け、学習時にはタスク主導、推論時にはタスク動的なアーキテクチャを実現しています。

論文の抄録は以下の通りです。
汎用画像セグメンテーションは新しい概念ではありません。過去数十年における画像セグメンテーションの統合に向けた試みとしては、シーンパース、パノプティックセグメンテーション、そしてより最近では新しいパノプティックアーキテクチャなどが挙げられます。しかし、こうしたパノプティックアーキテクチャは、最高のパフォーマンスを発揮させるために、セマンティック、インスタンス、またはパノプティックセグメンテーションそれぞれに対して個別にトレーニングする必要があるため、真の意味で画像セグメンテーションを統合しているとは言えません。理想的には、真に汎用的なフレームワークは一度だけトレーニングされるだけで、3つの画像セグメンテーションタスクすべてにおいてSOTAのパフォーマンスを達成すべきです。そのために、私たちは、マルチタスクのtrain-once設計によってセグメンテーションを統合する汎用画像セグメンテーションフレームワークであるOneFormerを提案します。まず、単一のマルチタスクトレーニングプロセス内で、各ドメイン(セマンティック、インスタンス、パノプティックセグメンテーション)の正解データを用いたトレーニングを可能にする、タスク条件付きのジョイントトレーニング戦略を提案します。次に、タスクトークンを用いてモデルを現在のタスクに条件付けすることで、マルチタスクのトレーニングと推論をサポートするタスク動的なモデルを実現します。さらに、トレーニング中にクエリとテキストの対比損失を使用することで、タスク間およびクラス間のより明確な区別を確立することを提案します。注目すべきは、3倍のリソースを用いて3つのタスクそれぞれに個別にトレーニングされた専用のMask2Formerモデルと比較して、私たちの単一のOneFormerモデルが、ADE20k、CityScapes、COCOのすべての3つのセグメンテーションタスクで優れたパフォーマンスを示した点です。新しいConvNeXtとDiNATのバックボーンを使用することで、さらなるパフォーマンスの向上を確認しました。私たちは、OneFormerが画像セグメンテーションをより汎用的でアクセスしやすくするための重要な一歩だと考えています。
下の図は、OneFormerのアーキテクチャを示しています。元の論文より引用。
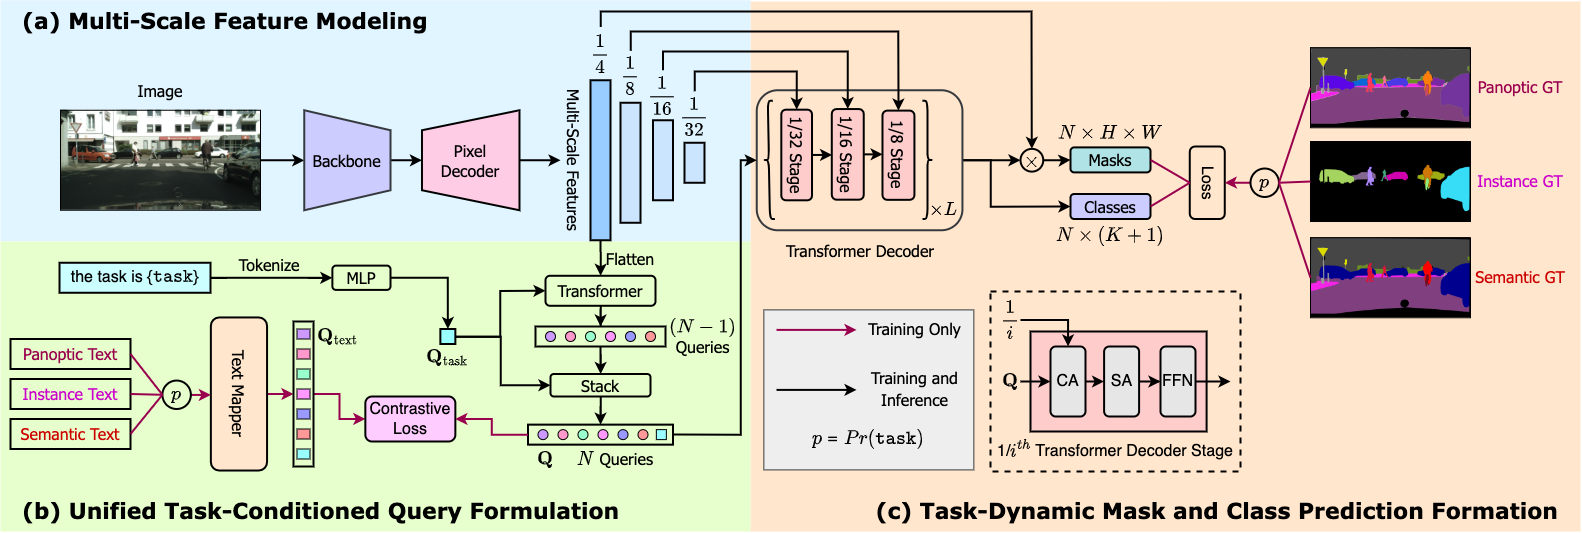
このモデルはJitesh Jain氏によって提供されました。元のコードはこちらで確認できます。
使用のコツ
- OneFormerの推論時には、imageとtask tokenの2つの入力が必要です。
- 学習中、OneFormerはパンノプティックアノテーションのみを使用します。
- モデルを複数ノードにまたがる分散環境で学習する場合、
modeling_oneformer.py内のOneFormerLossクラスにあるget_num_masks関数を更新する必要があります。複数ノードでの学習では、こちらの元の実装にあるように、この値を全ノードにわたるターゲットマスクの平均数に設定する必要があります。 - OneFormerProcessor を使用して、モデル用の入力画像とタスク入力、およびモデル用の任意のターゲットを準備できます。OneFormerProcessor は OneFormerImageProcessor と CLIPTokenizer を単一のインスタンスにラップし、画像の準備とタスク入力のエンコーディングの両方を行います。
- 最終的なセグメンテーションを取得するには、タスクに応じて、
post_process_semantic_segmentation()、post_process_instance_segmentation()、または post_process_panoptic_segmentation() を呼び出すことができます。これら 3 つのタスクはすべて、OneFormerForUniversalSegmentation の出力を使用して解決でき、パンノプティックセグメンテーションでは、対象オブジェクト(例:空)のインスタンスを融合するための任意の引数label_ids_to_fuseを受け取ります。
リソース
OneFormerの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです。
- カスタムデータでの推論とファインチューニングに関するデモノートブックは、こちらで確認できます。
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。確認いたします。 リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
OneFormer固有の出力
クラス transformers.models.oneformer.modeling_oneformer.OneFormerModelOutput
< source >( encoder_hidden_states: tuple[torch.FloatTensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.FloatTensor] | None = Nonetransformer_decoder_hidden_states: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_object_queries: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_contrastive_queries: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_mask_predictions: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_class_predictions: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_auxiliary_predictions: tuple[dict[str, torch.FloatTensor]] | None = Nonetext_queries: typing.Optional[torch.FloatTensor] = Nonetask_token: typing.Optional[torch.FloatTensor] = Noneattentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。 ピクセルデコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, sequence_length, hidden_size)です。 transformer decoder の各ステージの出力における hidden states(feature maps とも呼ばれます)。 - transformer_decoder_object_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — Transformer デコーダーの最終層からの出力オブジェクトクエリ。 - transformer_decoder_contrastive_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — transformer decoder からの対照クエリ。 - transformer_decoder_mask_predictions (
torch.FloatTensor、shape(batch_size, num_queries, height, width)) — transformer decoder の最終層からのマスク予測。 - transformer_decoder_class_predictions (
torch.FloatTensor、shape(batch_size, num_queries, num_classes+1)) — transformer decoder の最終層からのクラス予測。 - transformer_decoder_auxiliary_predictions (
Tupleof Dict ofstr, torch.FloatTensor, optional) — Tuple of class and mask predictions from each layer of the transformer decoder. - text_queries (
torch.FloatTensor、任意、形状(batch_size, num_queries, hidden_dim)) — 学習中の対比損失の計算に使用される、入力テキストリストから導出されたテキストクエリ。 - task_token (
torch.FloatTensor、shape(batch_size, hidden_dim)) — クエリを条件付けするための1次元タスクトークン。 - attentions (
tuple(tuple(torch.FloatTensor))、任意、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—tuple(torch.FloatTensor)のタプル(各レイヤーごとに 1 つ)で、形状は(batch_size, num_heads, sequence_length, sequence_length)です。transformer デコーダーからの Self Attention と Cross Attention の重みです。
OneFormerModelの出力を表すクラスです。このクラスは、logitsを計算するために必要なすべてのhidden statesを返します。
class transformers.models.oneformer.modeling_oneformer.OneFormerForUniversalSegmentationOutput
< source >( loss: typing.Optional[torch.FloatTensor] = Noneclass_queries_logits: typing.Optional[torch.FloatTensor] = Nonemasks_queries_logits: typing.Optional[torch.FloatTensor] = Noneauxiliary_predictions: list = Noneencoder_hidden_states: tuple[torch.FloatTensor] | None = Nonepixel_decoder_hidden_states: list[torch.FloatTensor] | None = Nonetransformer_decoder_hidden_states: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_object_queries: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_contrastive_queries: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_mask_predictions: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_class_predictions: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_auxiliary_predictions: list[dict[str, torch.FloatTensor]] | None = Nonetext_queries: typing.Optional[torch.FloatTensor] = Nonetask_token: typing.Optional[torch.FloatTensor] = Noneattentions: tuple[tuple[torch.FloatTensor]] | None = None )
パラメータ
- loss (
torch.Tensor, 任意) — ラベルが存在する場合に返される、計算された損失。 - class_queries_logits (
torch.FloatTensor, 任意) — 各クエリに対して提案されるクラスを表す、形状が(batch_size, num_queries, num_labels + 1)のテンソルです。+ 1は、nullクラスを組み込む必要があるためです。 - masks_queries_logits (
torch.FloatTensor, 任意) — 各クエリに対する提案マスクを表す、形状(batch_size, num_queries, height, width)のテンソル。 - auxiliary_predictions (
Listof Dict ofstr, torch.FloatTensor, 任意) — Transformer デコーダーの各レイヤーからのクラスおよびマスクの予測のリスト。 - encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。 ピクセルデコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, sequence_length, hidden_size)です。 transformer decoder の各ステージの出力における hidden states(feature maps とも呼ばれます)。 - transformer_decoder_object_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — Transformer デコーダーの最終層からの出力オブジェクトクエリ。 - transformer_decoder_contrastive_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — transformer decoder からの対照クエリ。 - transformer_decoder_mask_predictions (
torch.FloatTensor、shape(batch_size, num_queries, height, width)) — transformer decoder の最終層からのマスク予測。 - transformer_decoder_class_predictions (
torch.FloatTensor、shape(batch_size, num_queries, num_classes+1)) — transformer decoder の最終層からのクラス予測。 - transformer_decoder_auxiliary_predictions (
Listof Dict ofstr, torch.FloatTensor, 任意) — transformer decoder の各レイヤーからのクラスおよびマスクの予測のリスト。 - text_queries (
torch.FloatTensor、任意、形状(batch_size, num_queries, hidden_dim)) — 学習中の対比損失の計算に使用される、入力テキストリストから導出されたテキストクエリ。 - task_token (
torch.FloatTensor、shape(batch_size, hidden_dim)) — クエリを条件付けするための1次元タスクトークン。 - attentions (
tuple(tuple(torch.FloatTensor))、任意、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—tuple(torch.FloatTensor)のタプル(各レイヤーごとに 1 つ)で、形状は(batch_size, num_heads, sequence_length, sequence_length)です。transformer デコーダーからの Self Attention と Cross Attention の重みです。
OneFormerForUniversalSegmentationOutput の出力用のクラスです。
この出力は、タスクに応じて、post_process_semantic_segmentation()、post_process_instance_segmentation()、または post_process_panoptic_segmentation() に直接渡すことができます。使用法の詳細については、[`~OneFormerImageProcessor] を参照してください。
OneFormerConfig
クラス transformers.OneFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneignore_value: int = 255num_queries: int = 150no_object_weight: float = 0.1class_weight: float = 2.0mask_weight: float = 5.0dice_weight: float = 5.0contrastive_weight: float = 0.5contrastive_temperature: float = 0.07train_num_points: int = 12544oversample_ratio: float = 3.0importance_sample_ratio: float = 0.75init_std: float = 0.02init_xavier_std: float = 1.0layer_norm_eps: float = 1e-05is_training: bool = Falseuse_auxiliary_loss: bool = Trueoutput_auxiliary_logits: bool = Truestrides: list[int] | tuple[int, ...] = (4, 8, 16, 32)task_seq_len: int = 77text_encoder_width: int = 256text_encoder_context_length: int = 77text_encoder_num_layers: int = 6text_encoder_vocab_size: int = 49408text_encoder_proj_layers: int = 2text_encoder_n_ctx: int = 16conv_dim: int = 256mask_dim: int = 256hidden_dim: int = 256encoder_feedforward_dim: int = 1024norm: str = 'GN'encoder_layers: int = 6decoder_layers: int = 10use_task_norm: bool = Truenum_attention_heads: int = 8dropout: float | int = 0.1dim_feedforward: int = 2048pre_norm: bool = Falseenforce_input_proj: bool = Falsequery_dec_layers: int = 2common_stride: int = 4 )
パラメータ
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - ignore_value (
int、任意、デフォルトは 255) — 損失を計算する際に GT ラベルで無視される値。 - num_queries (
int、任意、デフォルトは 150)— オブジェクトクエリの数。 - no_object_weight (
float、任意、デフォルト値は0.1) — オブジェクト検出の損失における、no-object クラスの相対的な分類重み。 - class_weight (
float、任意、デフォルトは2.0) — ハンガリー法によるマッチングコストにおける、分類誤差の相対的な重み。 - mask_weight (
float、任意、デフォルトは5.0) — パノプティックセグメンテーション損失における、focal loss の相対的な重み。 - dice_weight (
float、任意、デフォルトは5.0) — パノラミックセグメンテーション損失における dice loss の相対的な重み。 - contrastive_weight (
float、任意、デフォルトは 0.5) — 対比損失の重み。 - contrastive_temperature (
float、任意、デフォルト値は 0.07) — 対照学習の logits をスケーリングするための初期値。 - train_num_points (
int、任意、デフォルト値は 12544)— マスク予測の損失を計算する際にサンプリングする点の数。 - oversample_ratio (
float、任意、デフォルト値は 3.0) — オーバーサンプリングする点の数を決定するための比率。 - importance_sample_ratio (
float, 任意、デフォルト値は 0.75) — 重要度サンプリングによってサンプリングされる点の比率です。 - init_std (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - init_xavier_std (
float、任意、デフォルトは1.0) — クロスアテンションの重みの Xavier 初期化に使用されるスケーリング係数です。 - layer_norm_eps (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - is_training (
bool、省略可能、デフォルトはFalse) — 学習モードで実行するか、推論モードで実行するかを指定します。 - use_auxiliary_loss (
bool、省略可、デフォルトはTrue) — transformer decoder の中間予測を用いて損失を計算するかどうか。 - output_auxiliary_logits (
bool、任意、デフォルトはTrue) — transformer decoder からの中間予測を返すかどうかを指定します。 - strides (
list、任意、デフォルトは[4, 8, 16, 32]) — エンコーダーのフィーチャマップのストライドを含むリスト。 - task_seq_len (
int、省略可、デフォルト値は 77)— テキストリスト入力をトークン化する際のシーケンス長。 - text_encoder_width (
int、任意、デフォルトは 256) — テキストエンコーダーの隠れ層サイズです。 - text_encoder_context_length (
int、任意、デフォルト値は 77)— テキストエンコーダーの入力シーケンス長です。 - text_encoder_num_layers (
int、任意、デフォルト値は 6)— テキストエンコーダー内の transformer の層数。 - text_encoder_vocab_size (
int、任意、デフォルト値は 49408) — トークナイザーの語彙サイズ。 - text_encoder_proj_layers (
int、任意、デフォルトは 2)— テキストクエリを投影するための MLP の層数。 - text_encoder_n_ctx (
int、任意、デフォルト値は 16)— 学習可能なテキストコンテキストクエリの数。 - conv_dim (
int、任意、デフォルトは 256) — バックボーンからの出力をマッピングするための特徴マップの次元。 - mask_dim (
int、省略可、デフォルトは 256) — ピクセルデコーダーにおける特徴マップの次元数。 - hidden_dim (
int、任意、デフォルトは 256) — transformer decoder における隠れ状態の次元数。 - encoder_feedforward_dim (
int、任意、デフォルトは 1024) — ピクセルデコーダー内の FFN レイヤーの次元数。 - norm (
str、任意、デフォルトは"GN") — 正規化の種類。 - encoder_layers (
int、任意、デフォルトは6) — Transformer エンコーダーの隠れ層の数です。設定されていない場合は、num_layersと同じ値が使用されます。 - decoder_layers (
int、任意、デフォルトは10) — Transformer デコーダーの隠れ層の数です。設定されていない場合は、num_layersと同じ値が使用されます。 - use_task_norm (
bool、省略可、デフォルトはTrue) — タスクトークンを正規化するか否かを指定します。 - num_attention_heads (
int、任意、デフォルトは8) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - dropout (
Union[float, int]、任意、デフォルト値は0.1) — すべての dropout レイヤーの比率です。 - dim_feedforward (
int、任意、デフォルトは 2048) — transformer デコーダーの FFN レイヤーの次元数。 - pre_norm (
bool、任意、デフォルトはFalse) — transformer デコーダーの attention レイヤーの前に hidden states を正規化するか否かを指定します。 - enforce_input_proj (
bool、任意、デフォルトはFalse) — transformer デコーダー内で隠れ状態を投影するかどうかを指定します。 - query_dec_layers (
int、任意、デフォルトは 2) — クエリトランスフォーマーの層数です。 - common_stride (
int、省略可能、デフォルトは 4) — ピクセルデコーダーの機能に使用される共通ストライドです。
これは OneFormerModel の設定を保存するための設定クラスです。指定された引数に基づいて Oneformer モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、shi-labs/oneformer_ade20k_swin_tiny と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import OneFormerConfig, OneFormerModel

>>> # Initializing a OneFormer shi-labs/oneformer_ade20k_swin_tiny configuration
>>> configuration = OneFormerConfig()
>>> # Initializing a model (with random weights) from the shi-labs/oneformer_ade20k_swin_tiny style configuration
>>> model = OneFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
OneFormerImageProcessor
クラス transformers.OneFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.oneformer.image_processing_oneformer.OneFormerImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、optional、デフォルトはTrue) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 800, 'longest_edge': 1333}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, デフォルトは2) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - repo_path (
str, kwargs, optional, デフォルトはshi-labs/oneformer_demo) — モデルのメタデータを含むローカルディレクトリまたは HuggingFace Hub リポジトリへのパス。 - class_info_file (
str, kwargs, optional) — リポジトリ内のクラスメタデータを含む JSON ファイルへのパス。 - num_text (
int、kwargs、任意) — テキストエンコーダー用のテキストクエリの数。タスクを導くプロンプトとして使用されます。 - num_labels (
int、kwargs、optional) — セグメンテーションにおけるセマンティッククラスの数を指定します。出力層のサイズを決定します。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップで無視するラベル。パディングに使用されることが多いです。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — すべてのラベル値を 1 減算し、背景クラスをignore_indexにマッピングするかどうかを指定します。
OneFormerImageProcessor イメージプロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]task_inputs: list[str] | None = Nonesegmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.oneformer.image_processing_oneformer.OneFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - task_inputs (
list[str]、省略可) — バッチ内の各画像に対するタスク("panoptic"、"instance"、"semantic")のリスト。 - segmentation_maps (
ImageInput、任意) — セグメンテーションマップです。 - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], 省略可) — インスタンス ID からセマンティック ID へのマッピングです。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - repo_path (
str, kwargs, optional, デフォルトはshi-labs/oneformer_demo) — モデルのメタデータを含むローカルディレクトリまたは HuggingFace Hub リポジトリへのパス。 - class_info_file (
str, kwargs, optional) — リポジトリ内のクラスメタデータを含む JSON ファイルへのパス。 - num_text (
int、kwargs、任意) — テキストエンコーダー用のテキストクエリの数。タスクを導くプロンプトとして使用されます。 - num_labels (
int、kwargs、optional) — セグメンテーションにおけるセマンティッククラスの数を指定します。出力層のサイズを決定します。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップで無視するラベル。パディングに使用されることが多いです。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — すべてのラベル値を 1 減算し、背景クラスをignore_indexにマッピングするかどうかを指定します。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
パラメータ
- outputs (OneFormerForUniversalSegmentation) — モデルの生出力です。
- target_sizes (
list[tuple[int, int]]、任意) — 長さ (batch_size) のリストで、各リストの要素 (Tuple[int, int]]) は、各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_segmentation_scores (
bool、省略可、デフォルトはFalse) — セグメンテーションマップとともにセグメンテーションスコアを返すかどうか。Trueの場合、返されるリストの各要素は、segmentation(クラス ID、形状(height, width))とsegmentation_scores(形状(num_classes, height, width))というフィールドを持つSemanticSegmentationPostProcessorOutputです。
戻り値
list[torch.Tensor] または list[SemanticSegmentationPostProcessorOutput]
return_segmentation_scores=False(デフォルト)の場合、各要素がクラス ID を持つ (height, width) の形状のセグメンテーションマップである、長さ batch_size のリストが返されます。return_segmentation_scores=True の場合、フィールド segmentation(クラス ID、形状 (height, width))と segmentation_scores(形状 (num_classes, height, width))を持つ SemanticSegmentationPostProcessorOutput のリストが返されます。どちらの場合も、(height, width) はターゲットサイズ(target_sizes が指定されている場合)に対応します。
OneFormerForUniversalSegmentationの出力をセマンティックセグメンテーションマップに変換します。PyTorchのみサポートしています。
post_process_instance_segmentation
< source >( outputstask_type: str = 'instance'is_demo: bool = Truethreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → List[Dict]
パラメータ
- outputs (
OneFormerForUniversalSegmentationOutput) —OneFormerForUniversalSegmentationOutputからの出力です。 - task_type (
str、任意、デフォルトは “instance”) — 後処理はタスクトークンの入力に依存します。task_typeが “panoptic” の場合、stuff の予測を無視する必要があります。 - is_demo (
bool、省略可能、デフォルトはTrue) — モデルがデモモードかどうかを示します。true の場合、最終的なマスクの予測に threshold を使用します。 - threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - target_sizes (
List[Tuple]、任意) — 長さ (batch_size) のリストで、各リストの要素 (Tuple[int, int]]) は、バッチ内の各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_coco_annotation (
bool、省略可、デフォルトはFalse) — 予測結果を COCO 形式で返すかどうかを指定します。
戻り値
List[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。target_sizesが指定されている場合、segmentationは対応するtarget_sizesのエントリにリサイズされます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - was_fused — 論理値。
label_idがlabel_ids_to_fuseに含まれていた場合はTrue、それ以外の場合はFalse。 同一クラス/ラベルの複数のインスタンスが融合され、単一のsegment_idが割り当てられました。 - score —
segment_idを持つセグメントの予測スコア。
- id —
OneFormerForUniversalSegmentationOutputの出力を、画像インスタンスセグメンテーションの予測に変換します。PyTorchのみサポートしています。
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
パラメータ
- outputs (
MaskFormerForInstanceSegmentationOutput) — MaskFormerForInstanceSegmentationからの出力です。 - threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - label_ids_to_fuse (
Set[int]、省略可) — この状態にあるラベルは、すべてのインスタンスが融合されます。例えば、画像には空が1つしか存在しませんが、人物は複数存在し得るため、空のラベル ID はこのセットに含まれますが、人物のラベル ID は含まれません。 - target_sizes (
list[Tuple], 任意) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、バッチ内の各予測の最終的な要求サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。
戻り値
list[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。target_sizesが指定されている場合、segmentationは対応するtarget_sizesのエントリにリサイズされます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - was_fused — 論理値。
label_idがlabel_ids_to_fuseに含まれていた場合はTrue、それ以外の場合はFalse。 同一クラス/ラベルの複数のインスタンスが融合され、単一のsegment_idが割り当てられました。 - score —
segment_idを持つセグメントの予測スコア。
- id —
MaskFormerForInstanceSegmentationOutputの出力を、画像のパンノセグメンテーション予測に変換します。PyTorchのみサポートしています。
OneFormerImageProcessorPil
クラス transformers.OneFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.oneformer.image_processing_pil_oneformer.OneFormerImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、optional、デフォルトはTrue) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 800, 'longest_edge': 1333}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, デフォルトは2) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - repo_path (
str, kwargs, optional, デフォルトはshi-labs/oneformer_demo) — モデルのメタデータを含むローカルディレクトリまたは HuggingFace Hub リポジトリへのパス。 - class_info_file (
str, kwargs, optional) — リポジトリ内のクラスメタデータを含む JSON ファイルへのパス。 - num_text (
int、kwargs、任意) — テキストエンコーダー用のテキストクエリの数。タスクを導くプロンプトとして使用されます。 - num_labels (
int、kwargs、optional) — セグメンテーションにおけるセマンティッククラスの数を指定します。出力層のサイズを決定します。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップで無視するラベル。パディングに使用されることが多いです。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — すべてのラベル値を 1 減算し、背景クラスをignore_indexにマッピングするかどうかを指定します。
OneFormerImageProcessor イメージプロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]task_inputs: list[str] | None = Nonesegmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.oneformer.image_processing_pil_oneformer.OneFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - task_inputs (
list[str]、省略可) — バッチ内の各画像に対するタスク("panoptic"、"instance"、"semantic")のリスト。 - segmentation_maps (
ImageInput、任意) — セグメンテーションマップです。 - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], 省略可) — インスタンス ID からセマンティック ID へのマッピングです。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - repo_path (
str, kwargs, optional, デフォルトはshi-labs/oneformer_demo) — モデルのメタデータを含むローカルディレクトリまたは HuggingFace Hub リポジトリへのパス。 - class_info_file (
str, kwargs, optional) — リポジトリ内のクラスメタデータを含む JSON ファイルへのパス。 - num_text (
int、kwargs、任意) — テキストエンコーダー用のテキストクエリの数。タスクを導くプロンプトとして使用されます。 - num_labels (
int、kwargs、optional) — セグメンテーションにおけるセマンティッククラスの数を指定します。出力層のサイズを決定します。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップで無視するラベル。パディングに使用されることが多いです。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — すべてのラベル値を 1 減算し、背景クラスをignore_indexにマッピングするかどうかを指定します。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
パラメータ
- outputs (OneFormerForUniversalSegmentation) — モデルの生出力です。
- target_sizes (
list[tuple[int, int]]、任意) — 長さ (batch_size) のリストで、各リストの要素 (Tuple[int, int]]) は、各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_segmentation_scores (
bool、省略可、デフォルトはFalse) — セグメンテーションマップとともにセグメンテーションスコアを返すかどうか。Trueの場合、返されるリストの各要素は、segmentation(クラス ID、形状(height, width))とsegmentation_scores(形状(num_classes, height, width))というフィールドを持つSemanticSegmentationPostProcessorOutputです。
戻り値
list[torch.Tensor] または list[SemanticSegmentationPostProcessorOutput]
return_segmentation_scores=False(デフォルト)の場合、各要素がクラス ID を持つ (height, width) の形状のセグメンテーションマップである、長さ batch_size のリストが返されます。return_segmentation_scores=True の場合、フィールド segmentation(クラス ID、形状 (height, width))と segmentation_scores(形状 (num_classes, height, width))を持つ SemanticSegmentationPostProcessorOutput のリストが返されます。どちらの場合も、(height, width) はターゲットサイズ(target_sizes が指定されている場合)に対応します。
OneFormerForUniversalSegmentationの出力をセマンティックセグメンテーションマップに変換します。PyTorchのみサポートしています。
post_process_instance_segmentation
< source >( outputstask_type: str = 'instance'is_demo: bool = Truethreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → List[Dict]
パラメータ
- outputs (
OneFormerForUniversalSegmentationOutput) —OneFormerForUniversalSegmentationOutputからの出力です。 - task_type (
str、任意、デフォルトは “instance”) — 後処理はタスクトークンの入力に依存します。task_typeが “panoptic” の場合、stuff の予測を無視する必要があります。 - is_demo (
bool、省略可能、デフォルトはTrue) — モデルがデモモードかどうかを示します。true の場合、最終的なマスクの予測に threshold を使用します。 - threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - target_sizes (
List[Tuple]、任意) — 長さ (batch_size) のリストで、各リストの要素 (Tuple[int, int]]) は、バッチ内の各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_coco_annotation (
bool、省略可、デフォルトはFalse) — 予測結果を COCO 形式で返すかどうかを指定します。
戻り値
List[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。target_sizesが指定されている場合、segmentationは対応するtarget_sizesのエントリにリサイズされます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - was_fused — 論理値。
label_idがlabel_ids_to_fuseに含まれていた場合はTrue、それ以外の場合はFalse。 同一クラス/ラベルの複数のインスタンスが融合され、単一のsegment_idが割り当てられました。 - score —
segment_idを持つセグメントの予測スコア。
- id —
OneFormerForUniversalSegmentationOutputの出力を、画像インスタンスセグメンテーションの予測に変換します。PyTorchのみサポートしています。
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
パラメータ
- outputs (
MaskFormerForInstanceSegmentationOutput) — MaskFormerForInstanceSegmentationからの出力です。 - threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - label_ids_to_fuse (
Set[int]、省略可) — この状態にあるラベルは、すべてのインスタンスが融合されます。例えば、画像には空が1つしか存在しませんが、人物は複数存在し得るため、空のラベル ID はこのセットに含まれますが、人物のラベル ID は含まれません。 - target_sizes (
list[Tuple], 任意) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、バッチ内の各予測の最終的な要求サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。
戻り値
list[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。target_sizesが指定されている場合、segmentationは対応するtarget_sizesのエントリにリサイズされます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - was_fused — 論理値。
label_idがlabel_ids_to_fuseに含まれていた場合はTrue、それ以外の場合はFalse。 同一クラス/ラベルの複数のインスタンスが融合され、単一のsegment_idが割り当てられました。 - score —
segment_idを持つセグメントの予測スコア。
- id —
MaskFormerForInstanceSegmentationOutputの出力を、画像のパンノセグメンテーション予測に変換します。PyTorchのみサポートしています。
OneFormerProcessor
クラス transformers.OneFormerProcessor
< source >( image_processor = Nonetokenizer = Nonemax_seq_length: int = 77task_seq_length: int = 77**kwargs )
パラメータ
- image_processor (
OneFormerImageProcessor) — 画像プロセッサは必須の入力です。 - tokenizer (
CLIPTokenizer) — トークナイザーは必須の入力です。 - max_seq_length (
int、任意、デフォルトは77) — クラス名やテキスト入力をエンコードする際の最大シーケンス長です。このパラメータは、モデル用のクラス名やその他のテキスト入力をトークン化する際に使用される最大トークン数を制御します。 - task_seq_length (
int、任意、デフォルトは77) — タスク説明のエンコードに特化した最大シーケンス長です。タスク説明(例:「the task is semantic」)は、この長さ制限でトークン化されます。これは一般的なテキストのシーケンス長と異なる場合があります。
画像プロセッサとトークナイザーを単一のプロセッサにラップするOneFormerProcessorを構築します。
OneFormerProcessor は、OneFormerImageProcessor と CLIPTokenizer のすべての機能を提供します。詳細については、~OneFormerImageProcessor および ~CLIPTokenizer を参照してください。
__call__
< source >( images = Nonetask_inputs = Nonesegmentation_maps = None**kwargs ) → BatchFeature
パラメータ
- images (`
) -- Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, setdo_rescale=False`. - task_inputs (
strまたはlist[str]、必須) — セグメンテーションのタスクタイプです。"semantic"、"instance"、"panoptic"のいずれか、またはそれらの組み合わせを指定します。 単一の画像に対しては単一の文字列、バッチ処理に対しては文字列のリスト(画像ごとに1つ)を指定できます。 タスクタイプによって、モデルが入力画像に対して実行するセグメンテーションの種類が決定されます。 - segmentation_maps (
ImageInput, 省略可能) — ピクセル単位の注釈を含む対応するセマンティックセグメンテーションマップ。(
bool、任意、デフォルトはTrue): バッチ内の最大の画像サイズまで画像をパディングし、ピクセルマスクを作成するかどうかを指定します。デフォルトのままにすると、次のようなピクセルマスクを返します:
- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- return_tensors (
strまたは TensorType, 省略可) — 設定すると、特定のフレームワークのテンソルを返します。使用可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': NumPyのnp.ndarrayオブジェクトを返します。
戻り値
以下のフィールドを持つBatchFeature:
- task_inputs — モデルに与えるトークン ID のリスト。
textがNoneでない場合に返されます。 - pixel_values — モデルに渡すピクセル値。
imagesがNoneでない場合に返されます。
OneFormerModel
class transformers.OneFormerModel
< source >( config: OneFormerConfig )
パラメータ
- config (OneFormerConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する素のOneformer Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: Tensortask_inputs: Tensortext_inputs: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OneFormerModelOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は OneFormerImageProcessor を使用して取得できます。詳細は OneFormerImageProcessor.call() を参照してください(OneFormerProcessor は画像の処理に OneFormerImageProcessor を使用します)。 - task_inputs (
torch.FloatTensor、shape(batch_size, sequence_length)) — タスク入力です。AutoImageProcessor を使用して取得できます。詳細は OneFormerProcessor.call() を参照してください。 - text_inputs (
list[torch.Tensor]、任意) — モデルに渡す、(num_queries, sequence_length)の形状を持つテンソル - pixel_mask (
torch.Tensorの形状(batch_size, height, width), 、任意) — パディングピクセル値に対するアテンションの適用を回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
OneFormerModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または OneFormerModelOutput。設定(OneFormerConfig)や入力に応じて、さまざまな要素で構成されます。
OneFormerModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。ピクセルデコーダーモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, sequence_length, hidden_size)です。transformer デコーダーの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_object_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — transformer decoder の最終層からの出力オブジェクトクエリ。 - transformer_decoder_contrastive_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — transformer decoder からの対照クエリ。 - transformer_decoder_mask_predictions (
torch.FloatTensor、shape(batch_size, num_queries, height, width)) — Transformer デコーダーの最終層からのマスク予測。 - transformer_decoder_class_predictions (
torch.FloatTensor、shape(batch_size, num_queries, num_classes+1)) — Transformer デコーダーの最終層からのクラス予測。 - transformer_decoder_auxiliary_predictions (
Tupleof Dict ofstr, torch.FloatTensor, optional) — Tuple of class and mask predictions from each layer of the transformer decoder. - text_queries (
torch.FloatTensor、optional、shape(batch_size, num_queries, hidden_dim)) — 学習時の対比損失の計算に使用される、入力テキストリストから導出されたテキストクエリ。 - task_token (
torch.FloatTensor、shape(batch_size, hidden_dim)) — クエリを条件付けするための1次元タスクトークン。 - attentions (
tuple(tuple(torch.FloatTensor))、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —tuple(torch.FloatTensor)のタプル(レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。Transformer デコーダーからの Self Attention と Cross Attention の重み。
例:
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import OneFormerProcessor, OneFormerModel

>>> # download test image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> # load processor for preprocessing the inputs
>>> processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> model = OneFormerModel.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> inputs = processor(image, ["semantic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> mask_predictions = outputs.transformer_decoder_mask_predictions
>>> class_predictions = outputs.transformer_decoder_class_predictions

>>> f"👉 Mask Predictions Shape: {list(mask_predictions.shape)}, Class Predictions Shape: {list(class_predictions.shape)}"
'👉 Mask Predictions Shape: [1, 150, 128, 171], Class Predictions Shape: [1, 150, 151]'
OneFormerForUniversalSegmentation
class transformers.OneFormerForUniversalSegmentation
< source >( config: OneFormerConfig )
パラメータ
- config (OneFormerConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
OneFormerは、インスタンス、セマンティック、パノプティックの画像セグメンテーション用のモデルです。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: Tensortask_inputs: Tensortext_inputs: typing.Optional[torch.Tensor] = Nonemask_labels: list[torch.Tensor] | None = Noneclass_labels: list[torch.Tensor] | None = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_auxiliary_logits: bool | None = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OneFormerForUniversalSegmentationOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は OneFormerImageProcessor を使用して取得できます。詳細は OneFormerImageProcessor.call() を参照してください(OneFormerProcessor は画像の処理に OneFormerImageProcessor を使用します)。 - task_inputs (
torch.FloatTensor、shape(batch_size, sequence_length)) — タスク入力です。AutoImageProcessor を使用して取得できます。詳細は OneFormerProcessor.call() を参照してください。 - text_inputs (
list[torch.Tensor]、任意) — モデルに渡す、(num_queries, sequence_length)の形状を持つテンソル - mask_labels (
list[torch.Tensor]、任意) — モデルに渡す、(num_labels, height, width)の形状を持つマスクラベルのリスト - class_labels (
list[torch.LongTensor]、任意) — モデルに渡す、(num_labels, height, width)の形状を持つターゲットクラスラベルのリストです。mask_labelsのラベルを識別します。例えば、class_labels[i][j]が真の場合、mask_labels[i][j]のラベルを示します。 - pixel_mask (
torch.Tensorの形状(batch_size, height, width), 、任意) — パディングピクセル値に対するアテンションの適用を回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- output_auxiliary_logits (
bool, 省略可) — 補助 logits を出力するかどうか。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
OneFormerForUniversalSegmentationOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または OneFormerForUniversalSegmentationOutput。設定(OneFormerConfig)や入力に応じて、さまざまな要素で構成されます。
OneFormerForUniversalSegmentationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- loss (
torch.Tensor, optional) — ラベルが存在する場合に返される、計算された損失。 - class_queries_logits (
torch.FloatTensor, optional) — 各クエリに対して提案されるクラスを表す、形状が(batch_size, num_queries, num_labels + 1)のテンソル。nullクラスを組み込む必要があるため、+ 1が必要です。 - masks_queries_logits (
torch.FloatTensor, オプション) — 各クエリに対する提案マスクを表す、形状が(batch_size, num_queries, height, width)のテンソル。 - auxiliary_predictions (
Listof Dict ofstr, torch.FloatTensor, optional) — List of class and mask predictions from each layer of the transformer decoder. - encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。ピクセルデコーダーモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, sequence_length, hidden_size)です。transformer デコーダーの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_object_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — transformer decoder の最終層からの出力オブジェクトクエリ。 - transformer_decoder_contrastive_queries (
torch.FloatTensor、shape(batch_size, num_queries, hidden_dim)) — transformer decoder からの対照クエリ。 - transformer_decoder_mask_predictions (
torch.FloatTensor、shape(batch_size, num_queries, height, width)) — Transformer デコーダーの最終層からのマスク予測。 - transformer_decoder_class_predictions (
torch.FloatTensor、shape(batch_size, num_queries, num_classes+1)) — Transformer デコーダーの最終層からのクラス予測。 - transformer_decoder_auxiliary_predictions (
Listof Dict ofstr, torch.FloatTensor, optional) — List of class and mask predictions from each layer of the transformer decoder. - text_queries (
torch.FloatTensor、optional、shape(batch_size, num_queries, hidden_dim)) — 学習時の対比損失の計算に使用される、入力テキストリストから導出されたテキストクエリ。 - task_token (
torch.FloatTensor、shape(batch_size, hidden_dim)) — クエリを条件付けするための1次元タスクトークン。 - attentions (
tuple(tuple(torch.FloatTensor))、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —tuple(torch.FloatTensor)のタプル(レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。Transformer デコーダーからの Self Attention と Cross Attention の重み。
例:
汎用セグメンテーションの例:
>>> from transformers import OneFormerProcessor, OneFormerForUniversalSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch

>>> # load OneFormer fine-tuned on ADE20k for universal segmentation
>>> processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> model = OneFormerForUniversalSegmentation.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")

>>> url = (
...     "https://huggingface.co/datasets/hf-internal-testing/fixtures_ade20k/resolve/main/ADE_val_00000001.jpg"
... )
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> # Semantic Segmentation
>>> inputs = processor(image, ["semantic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for semantic postprocessing
>>> predicted_semantic_map = processor.post_process_semantic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]
>>> f"👉 Semantic Predictions Shape: {list(predicted_semantic_map.shape)}"
'👉 Semantic Predictions Shape: [512, 683]'

>>> # Instance Segmentation
>>> inputs = processor(image, ["instance"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for instance postprocessing
>>> predicted_instance_map = processor.post_process_instance_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]["segmentation"]
>>> f"👉 Instance Predictions Shape: {list(predicted_instance_map.shape)}"
'👉 Instance Predictions Shape: [512, 683]'

>>> # Panoptic Segmentation
>>> inputs = processor(image, ["panoptic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for panoptic postprocessing
>>> predicted_panoptic_map = processor.post_process_panoptic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]["segmentation"]
>>> f"👉 Panoptic Predictions Shape: {list(predicted_panoptic_map.shape)}"
'👉 Panoptic Predictions Shape: [512, 683]'