
Transformers documentation
TAPAS
このモデルは2020年4月5日にHF papersで公開され、2020年12月15日にHugging Face Transformersに貢献されました。
TAPAS
概要
TAPASモデルは、Jonathan Herzig、Paweł Krzysztof Nowak、Thomas Müller、Francesco Piccinno、Julian Martin Eisenschlos による TAPAS: Weakly Supervised Table Parsing via Pre-training で提案されました。これは、表形式のデータに関する質問に答えるために特化して設計(および事前学習)された BERT ベースのモデルです。BERT との違いとして、TAPAS は相対位置埋め込みを使用し、表構造をエンコードする 7 種類のトークンタイプを備えています。TAPAS は、英語版 Wikipedia の数百万の表とそれに対応するテキストからなる大規模データセット上で、マスク言語モデリング(MLM)目的で事前学習されています。
質問応答において、TAPASは上部に2つのヘッドを備えています。1つはセル選択ヘッド、もう1つは集約ヘッドで、選択されたセルに対して(任意で)集約(カウントや合計など)を実行します。TAPASは複数のデータセットでファインチューニングされています。
- SQA(MicrosoftによるSequential Question Answering)
- WTQ(スタンフォード大学による Wiki Table Questions)
- WikiSQL(Salesforce 製)。
SQAとWTQの両方で最先端の性能を達成すると同時に、WikiSQLではSOTAと同等の性能を示しており、かつはるかにシンプルなアーキテクチャを備えています。
論文の抄録は以下の通りです。
表に対する自然言語質問への回答は、通常、意味解析タスクとして扱われます。完全な論理形式の収集コストを軽減するため、論理形式ではなく意味(denotation)からなる弱教師信号に焦点を当てるアプローチが広く用いられています。しかし、弱教師信号から意味解析器を訓練することは困難を伴い、さらに、生成された論理形式は意味の取得を目的とした中間ステップとしてのみ使用されます。本論文では、論理形式を生成せずに表に対する質問応答を行う手法 TAPAS を提案します。TAPAS は弱教師信号から訓練され、表のセルを選択し、必要に応じてその選択に対応する集約演算子を適用することで意味を予測します。TAPAS は BERT のアーキテクチャを拡張して表を入力としてエンコードし、Wikipedia から収集したテキストセグメントと表の効果的な共同事前学習から初期化され、エンドツーエンドで訓練されます。3 つの異なる意味解析データセットで実験を行い、TAPAS は SQA における最先端の精度を 55.1 から 67.2 に向上させ、WIKISQL と WIKITQ において最先端と同等の性能を示す一方で、よりシンプルなモデルアーキテクチャを持つことを確認しました。さらに、私たちの設定では自明な WIKISQL から WIKITQ への転移学習により、最先端を 4.2 ポイント上回る 48.7 の精度が得られることも確認しました。
さらに、著者らは、自動生成された数百万の学習例からなるバランスの取れたデータセットを作成し、ファインチューニング前の中間ステップでこれらを学習させることで、テーブルエンティルメントを認識するように TAPAS をさらに事前学習しています。TAPAS の著者らは、このさらなる事前学習を中間事前学習と呼んでいます(TAPAS はまず MLM で事前学習され、その後別のデータセットで事前学習されるためです)。彼らは、中間事前学習により SQA でのパフォーマンスがさらに向上し、新たな SOTA を達成するとともに、テーブルエンティルメント(二値分類タスク)のための 16k の Wikipedia テーブルを含む大規模データセットである TabFact においても SOTA を達成したことを発見しました。詳細については、Julian Martin Eisenschlos、Syrine Krichene、Thomas Müller によるフォローアップ論文 Understanding tables with intermediate pre-training を参照してください。
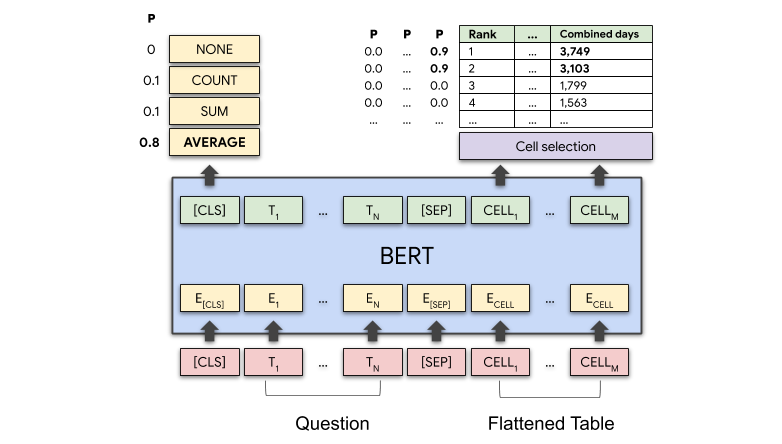 TAPAS architecture. Taken from the original blog post.
このモデルは nielsr によって提供されました。元のコードは こちら で確認できます。
使用のコツ
- TAPAS は、デフォルトで相対位置埋め込みを使用するモデルです(テーブルの各セルごとに位置埋め込みをリセットします)。なお、これは元の TAPAS 論文の公開後に追加された機能です。著者によると、これにより通常はわずかにパフォーマンスが向上し、埋め込みを使い切ることなくより長いシーケンスをエンコードできるようになるとのことです。これは TapasConfig の
reset_position_index_per_cellパラメータに反映されており、デフォルトではTrueに設定されています。hub で利用可能なモデルのデフォルトバージョンはすべて、相対位置埋め込みを使用しています。from_pretrained()メソッドを呼び出す際に、追加の引数としてrevision="no_reset"を渡すことで、絶対位置埋め込みを使用するモデルを依然として利用できます。なお、入力のパディングは通常、左側ではなく右側に行うことが推奨されています。 - TAPAS は BERT をベースにしているため、例えば
TAPAS-baseはBERT-baseアーキテクチャに対応します。もちろん、TAPAS-largeが最高のパフォーマンスを発揮します(論文で報告された結果はTAPAS-largeのものです)。さまざまなサイズのモデルの結果は、元の GitHub リポジトリ に掲載されています。 - TAPASにはSQAでファインチューニングされたチェックポイントがあり、会話形式のセットアップにおいて、テーブルに関連する質問に回答できます。これにより、「彼の年齢は?」といった、前の質問に関連するフォローアップ質問を行うことができます。なお、会話形式のセットアップでは、TAPASのフォワードパスがやや異なります。その場合、モデルにテーブルと質問のペアを1つずつ入力し、
prev_labelsのトークンタイプIDを、モデルが前の質問に対して予測したlabelsで上書きできるようにする必要があります。詳細は「Usage」セクションを参照してください。 - TAPAS は BERT に類似しており、そのためマスク言語モデリング(MLM)の目的関数に依存しています。したがって、マスクされたトークンの予測や NLU 全般では効率的ですが、テキスト生成には最適ではありません。その点については、因果言語モデリング(CLM)の目的関数で訓練されたモデルの方が優れています。なお、TAPAS は EncoderDecoderModel フレームワーク内でエンコーダーとして使用でき、GPT-2 などの自己回帰型テキストデコーダーと組み合わせることができます。
使用法:ファインチューニング
ここでは、独自のデータセットでTapasForQuestionAnsweringをファインチューニングする方法を説明します。
ステップ1: TAPASの3つの利用方法のいずれかを選択するか、実験する
基本的に、TapasForQuestionAnsweringをファインチューニングする方法は3つあり、Tapasがファインチューニングされた異なるデータセットに対応しています。
- SQA: テーブルに関連するフォローアップ質問を対話形式で尋ねたい場合に使用します。例えば、最初に「最初の俳優の名前は何ですか?」と質問した後、「彼はどのくらいの年齢ですか?」のようなフォローアップ質問を行うことができます。ここでは、質問には集約(aggregation)は含まれません(すべての質問はセル選択の質問です)。
- WTQ: 会話的な設定で質問を行うことではなく、テーブルに関連する質問を行うことに興味がある場合です。テーブルには集計が含まれる可能性があり、例えば行数のカウント、セル値の合計、セル値の平均などが挙げられます。例えば、「クリスティアーノ・ロナウドのキャリアにおける総得点数は?」と質問できます。このケースも弱教師ありと呼ばれます。これは、モデルが質問の答えのみを教師信号として与えられた状態で、適切な集計演算子(SUM/COUNT/AVERAGE/NONE)を自ら学習しなければならないためです。
- WikiSQL-supervised: このデータセットは WikiSQL に基づいており、学習時にモデルに正解の集約演算子が与えられます。これは strong supervision(強監督)とも呼ばれます。ここでは、適切な集約演算子の学習がはるかに容易になります。
まとめると:
| タスク | データセットの例 | 説明 |
|---|---|---|
| 会話 | SQA | 対話形式、セル選択のみの質問 |
| 集約のための弱教師 | WTQ | 質問には集約が含まれる場合があり、モデルは正解のみを教師信号として与えられた状態で、これを学習する必要があります。 |
| 集約のための強力な教師あり | WikiSQL教師あり | 質問には集約が含まれる場合があり、モデルはゴールド集約演算子が与えられた状態で、これを学習する必要があります。 |
ハブから事前学習済みのベースモデルと、ランダムに初期化された分類ヘッドでモデルを初期化するには、以下のように行います。
from transformers import TapasConfig, TapasForQuestionAnswering


# for example, the base sized model with default SQA configuration
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", device_map="auto")

# or, the base sized model with WTQ configuration
config = TapasConfig.from_pretrained("google/tapas-base-finetuned-wtq")
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")

# or, the base sized model with WikiSQL configuration
config = TapasConfig("google-base-finetuned-wikisql-supervised")
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")もちろん、TAPASがファインチューニングされた3つの方法のいずれかに従う必要はありません。TapasConfigを初期化する際に、任意のハイパーパラメータを定義して実験することもできます。その後、その設定に基づいてTapasForQuestionAnsweringを作成します。例えば、対話的な質問と集計を伴う可能性のある質問の両方を含むデータセットがある場合、次のように行うことができます。以下に例を示します。
from transformers import TapasConfig, TapasForQuestionAnswering


# you can initialize the classification heads any way you want (see docs of TapasConfig)
config = TapasConfig(num_aggregation_labels=3, average_logits_per_cell=True)
# initializing the pre-trained base sized model with our custom classification heads
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")もう一つの選択肢として、すでにファインチューニング済みのチェックポイントから始める方法もあります。なお、WTQ上のファインチューニング済みチェックポイントは、L2損失がやや不安定なため、いくつかの問題があります。詳細はこちらを参照してください。
HuggingFaceのハブで利用可能な事前学習済みおよびファインチューニング済みのTAPASチェックポイントのリストについては、こちらを参照してください。
ステップ2: SQA形式でデータを準備する
第二に、上記で何を選択したかに関わらず、SQA形式でデータセットを準備する必要があります。この形式は、以下の列を持つTSV/CSVファイルです。
id: 任意。テーブルと質問のペアの ID。管理目的で使用します。annotator: 任意。テーブルと質問のペアをアノテーションした人物のIDです。管理目的で使用します。position: 質問が表に関連する第1、第2、第3のいずれであるかを示す整数。対話型セットアップ(SQA)の場合のみ必須です。WTQ/WikiSQL による教師あり学習を行う場合は、この列は不要です。question: stringtable_file: string、タブ形式のデータを含む CSV ファイルの名前answer_coordinates: 1つ以上のタプルのリスト(各タプルはセルの座標、つまり回答の一部である行と列のペア)answer_text: 1 つ以上の文字列のリスト(各文字列は、回答の一部を構成するセルの値)aggregation_label: 集約演算子のインデックス。集約の強教師あり学習(WikiSQL教師ありの場合)でのみ必要です。float_answer: 質問に対する浮動小数点数の答え(存在しない場合は np.nan)。集約のための弱教師あり学習(WTQ や WikiSQL など)の場合のみ必須です。
テーブル自体はフォルダ内に配置する必要があり、各テーブルは個別のcsvファイルとして保存されます。なお、TAPASアルゴリズムの著者らは、他のデータセット(WTQ、WikiSQL)をSQA形式に変換するために、一部の自動化ロジックを含む変換スクリプトを使用しました。著者による説明はこちらにあります。HuggingFaceの実装で動作するこのスクリプトの変換版はこちらで入手できます。興味深いことに、これらの変換スクリプトは完全ではなく(answer_coordinatesおよびfloat_answerフィールドはanswer_textに基づいて設定される)、WTQおよびWikiSQLの結果は実際には改善される可能性があります。
ステップ 3: TapasTokenizer を使用してデータをテンソルに変換する
第三に、データをこのTSV/CSV形式(および対応する表形式データを含むCSVファイル)で準備した後は、TapasTokenizerを使用して、テーブルと質問のペアをinput_ids、attention_mask、token_type_idsなどに変換できます。また、上記の3つのケースのいずれを選択したかによって、ファインチューニングに必要となるTapasForQuestionAnsweringへの入力が異なります。
| タスク | 必須の入力 |
|---|---|
| 会話 | input_ids, attention_mask, token_type_ids, labels |
| 集約のための弱教師 | input_ids, attention_mask, token_type_ids, labels, numeric_values, numeric_values_scale, float_answer |
| 集約のための強力な教師あり | input ids, attention mask, token type ids, labels, aggregation_labels |
TapasTokenizerは、TSVファイルのanswer_coordinates列とanswer_text列に基づいて、labels、numeric_values、numeric_values_scaleを生成します。float_answerとaggregation_labelsは、ステップ2のTSVファイルにすでに含まれています。以下に例を示します。
from transformers import TapasTokenizer
import pandas as pd

model_name = "google/tapas-base"
tokenizer = TapasTokenizer.from_pretrained(model_name)

data = {"Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"], "Number of movies": ["87", "53", "69"]}
queries = [
    "What is the name of the first actor?",
    "How many movies has George Clooney played in?",
    "What is the total number of movies?",
]
answer_coordinates = [[(0, 0)], [(2, 1)], [(0, 1), (1, 1), (2, 1)]]
answer_text = [["Brad Pitt"], ["69"], ["209"]]
table = pd.DataFrame.from_dict(data)
inputs = tokenizer(
    table=table,
    queries=queries,
    answer_coordinates=answer_coordinates,
    answer_text=answer_text,
    padding="max_length",
    return_tensors="pt",
)
inputs
{'input_ids': tensor([[ ]]), 'attention_mask': tensor([[...]]), 'token_type_ids': tensor([[[...]]]),
'numeric_values': tensor([[ ]]), 'numeric_values_scale: tensor([[ ]]), labels: tensor([[ ]])}TapasTokenizerは、テーブルのデータがテキストのみであることを前提としています。データフレームに対して.astype(str)を使用することで、テキストのみのデータに変換できます。
もちろん、これは単一の学習例をエンコードする方法を示しているだけです。バッチを反復処理するために、dataloaderを作成することをお勧めします。
import pandas as pd
import torch


tsv_path = "your_path_to_the_tsv_file"
table_csv_path = "your_path_to_a_directory_containing_all_csv_files"


class TableDataset(torch.utils.data.Dataset):
    def __init__(self, data, tokenizer):
        self.data = data
        self.tokenizer = tokenizer

    def __getitem__(self, idx):
        item = data.iloc[idx]
        table = pd.read_csv(table_csv_path + item.table_file).astype(
            str
        )  # be sure to make your table data text only
        encoding = self.tokenizer(
            table=table,
            queries=item.question,
            answer_coordinates=item.answer_coordinates,
            answer_text=item.answer_text,
            truncation=True,
            padding="max_length",
            return_tensors="pt",
        )
        # remove the batch dimension which the tokenizer adds by default
        encoding = {key: val.squeeze(0) for key, val in encoding.items()}
        # add the float_answer which is also required (weak supervision for aggregation case)
        encoding["float_answer"] = torch.tensor(item.float_answer)
        return encoding

    def __len__(self):
        return len(self.data)


data = pd.read_csv(tsv_path, sep="\t")
train_dataset = TableDataset(data, tokenizer)
train_dataloader = torch.utils.data.DataLoader(train_dataset, batch_size=32)ここでは、各テーブルと質問のペアを独立してエンコードしています。データセットが対話形式でない限り、この方法で問題ありません。データセットが対話形式の質問(SQAなど)を含む場合は、まずテーブルごとにqueries、answer_coordinates、answer_textをpositionインデックスの順序でグループ化し、各テーブルとその質問をバッチでエンコードする必要があります。これにより、prev_labelsトークンタイプ(TapasTokenizerのドキュメントを参照)が正しく設定されます。詳細はこのノートブックを参照してください。
**ステップ 4: モデルの学習(ファインチューニング)
その後、TapasForQuestionAnswering を次のようにファインチューニングできます(ここでは、集約の弱教師あり学習のケースを示します):
from transformers import AdamW, TapasConfig, TapasForQuestionAnswering


# this is the default WTQ configuration
config = TapasConfig(
    num_aggregation_labels=4,
    use_answer_as_supervision=True,
    answer_loss_cutoff=0.664694,
    cell_selection_preference=0.207951,
    huber_loss_delta=0.121194,
    init_cell_selection_weights_to_zero=True,
    select_one_column=True,
    allow_empty_column_selection=False,
    temperature=0.0352513,
)
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")

optimizer = AdamW(model.parameters(), lr=5e-5)

model.train()
for epoch in range(2):  # loop over the dataset multiple times
    for batch in train_dataloader:
        # get the inputs;
        input_ids = batch["input_ids"]
        attention_mask = batch["attention_mask"]
        token_type_ids = batch["token_type_ids"]
        labels = batch["labels"]
        numeric_values = batch["numeric_values"]
        numeric_values_scale = batch["numeric_values_scale"]
        float_answer = batch["float_answer"]

        # zero the parameter gradients
        optimizer.zero_grad()

        # forward + backward + optimize
        outputs = model(
            input_ids=input_ids,
            attention_mask=attention_mask,
            token_type_ids=token_type_ids,
            labels=labels,
            numeric_values=numeric_values,
            numeric_values_scale=numeric_values_scale,
            float_answer=float_answer,
        )
        loss = outputs.loss
        loss.backward()
        optimizer.step()
使用法: 推論
ここでは、TapasForQuestionAnswering を推論(つまり、新しいデータに対する予測)に使用する方法を説明します。推論を行う場合、モデルに input_ids、attention_mask、token_type_ids(TapasTokenizer を使用して取得できます)を渡すだけで logits を得られます。次に、便利な ~models.tapas.tokenization_tapas.convert_logits_to_predictions メソッドを使用して、これらを予測された座標および任意の集約インデックスに変換できます。
ただし、推論はセットアップが対話型かどうかによって異なる点に注意してください。非対話型のセットアップでは、バッチ内のすべてのテーブルと質問のペアに対して並列で推論を実行できます。その例を以下に示します。
from transformers import TapasTokenizer, TapasForQuestionAnswering
import pandas as pd

model_name = "google/tapas-base-finetuned-wtq"
model = TapasForQuestionAnswering.from_pretrained(model_name, device_map="auto")
tokenizer = TapasTokenizer.from_pretrained(model_name)

data = {"Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"], "Number of movies": ["87", "53", "69"]}
queries = [
    "What is the name of the first actor?",
    "How many movies has George Clooney played in?",
    "What is the total number of movies?",
]
table = pd.DataFrame.from_dict(data)
inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt").to(model.device)
outputs = model(**inputs)
predicted_answer_coordinates, predicted_aggregation_indices = tokenizer.convert_logits_to_predictions(
    inputs, outputs.logits.detach(), outputs.logits_aggregation.detach()
)

# let's print out the results:
id2aggregation = {0: "NONE", 1: "SUM", 2: "AVERAGE", 3: "COUNT"}
aggregation_predictions_string = [id2aggregation[x] for x in predicted_aggregation_indices]

answers = []
for coordinates in predicted_answer_coordinates:
    if len(coordinates) == 1:
        # only a single cell:
        answers.append(table.iat[coordinates[0]])
    else:
        # multiple cells
        cell_values = []
        for coordinate in coordinates:
            cell_values.append(table.iat[coordinate])
        answers.append(", ".join(cell_values))

display(table)
print("")
for query, answer, predicted_agg in zip(queries, answers, aggregation_predictions_string):
    print(query)
    if predicted_agg == "NONE":
        print("Predicted answer: " + answer)
    else:
        print("Predicted answer: " + predicted_agg + " > " + answer)
What is the name of the first actor?
Predicted answer: Brad Pitt
How many movies has George Clooney played in?
Predicted answer: COUNT > 69
What is the total number of movies?
Predicted answer: SUM > 87, 53, 69対話形式のセットアップの場合、各テーブルと質問のペアを順番にモデルに提供する必要があります。これにより、prev_labelsトークンタイプが、直前のテーブルと質問のペアの予測されたlabelsで上書きされるようになります。詳細はこのノートブックを参照してください。
リソース
TAPAS固有の出力
クラス transformers.models.tapas.modeling_tapas.TableQuestionAnsweringOutput
< source >( loss: typing.Optional[torch.FloatTensor] = Nonelogits: typing.Optional[torch.FloatTensor] = Nonelogits_aggregation: typing.Optional[torch.FloatTensor] = Nonehidden_states: tuple[torch.FloatTensor] | None = Noneattentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- loss (
torch.FloatTensor、shape(1,)、optional、labels(および場合によってはanswer、aggregation_labels、numeric_valuesおよびnumeric_values_scale)が提供された場合に返されます) — 階層的セル選択の対数尤度損失と、(任意で)半教師あり回帰損失、および(任意で)集約用の教師あり損失の合計として計算される総損失。 - logits (
torch.FloatTensor、形状(batch_size, sequence_length)) — セル選択ヘッドによる、各トークンに対する予測スコア。 - logits_aggregation (
torch.FloatTensor、任意、形状(batch_size, num_aggregation_labels)) — すべての集約オペレーターに対する、集約ヘッドの予測スコアです。 - hidden_states (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_hidden_states=Trueが渡された場合、またはconfig.output_hidden_states=True) — のタプルtorch.FloatTensor((埋め込み層を持つモデルの場合は埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は(batch_size, sequence_length, hidden_size).各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
TapasConfig
class transformers.TapasConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 1024type_vocab_sizes: list[int] | tuple[int, ...] = (3, 256, 256, 2, 256, 256, 10)initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0bos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepositive_label_weight: float = 10.0num_aggregation_labels: int = 0aggregation_loss_weight: float = 1.0use_answer_as_supervision: bool | None = Noneanswer_loss_importance: float = 1.0use_normalized_answer_loss: bool = Falsehuber_loss_delta: float | None = Nonetemperature: float = 1.0aggregation_temperature: float = 1.0use_gumbel_for_cells: bool = Falseuse_gumbel_for_aggregation: bool = Falseaverage_approximation_function: str = 'ratio'cell_selection_preference: float | None = Noneanswer_loss_cutoff: float | int | None = Nonemax_num_rows: int = 64max_num_columns: int = 32average_logits_per_cell: bool = Falseselect_one_column: bool = Trueallow_empty_column_selection: bool = Falseinit_cell_selection_weights_to_zero: bool = Falsereset_position_index_per_cell: bool = Truedisable_per_token_loss: bool = Falseaggregation_labels: dict | None = Noneno_aggregation_label_index: int | None = Noneis_decoder: bool = Falseadd_cross_attention: bool = Falsetie_word_embeddings: bool = True )
パラメータ
- vocab_size (
int、任意、デフォルトは30522) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは768) — 隠れ表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは12) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - intermediate_size (
int、任意、デフォルトは3072) — MLP 表現の次元数。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - hidden_dropout_prob (
Union[float, int]、任意、デフォルト値は0.1) — embeddings、encoder、pooler 内のすべての全結合層における dropout 確率です。 - attention_probs_dropout_prob (
Union[float, int]、任意、デフォルトは0.1) — アテンション確率のドロップアウト率です。 - max_position_embeddings (
int、任意、デフォルトは1024) — このモデルが使用される可能性のある最大シーケンス長です。 - type_vocab_sizes (
list[int]、任意、デフォルトは[3, 256, 256, 2, 256, 256, 10]) — TapasModel を呼び出す際に渡すtoken_type_idsの語彙サイズです。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-12) — レイヤーノーマル層で使用する epsilon です。 - pad_token_id (
int、任意、デフォルトは0) — 語彙内でパディングに使用されるトークン ID。 - bos_token_id (
int, 省略可) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]], 省略可) — 語彙内でストリーム終了に使用されるトークン ID。 - positive_label_weight (
float、任意、デフォルト値は 10.0)— 正ラベルの重み。 - num_aggregation_labels (
int、省略可、デフォルト値は 0) — 予測する集約演算子の数です。 - aggregation_loss_weight (
float、任意、デフォルトは 1.0) — 集約損失の重要度重み。 - use_answer_as_supervision (
bool, 任意) — 集約の例に対して、回答のみを教師信号として使用するかどうかを指定します。 - answer_loss_importance (
float、任意、デフォルト値: 1.0) — 回帰損失の重要度重み。 - use_normalized_answer_loss (
bool、任意、デフォルトはFalse) — 予測値と期待値の最大値で answer loss を正規化するかを指定します。 - huber_loss_delta (
float, 省略可) — 回帰損失を計算するために使用される Delta パラメータです。 - temperature (
float、任意、デフォルト値は 1.0) — セルの logits 確率の歪みを制御(または変更)するために使用される値。 - aggregation_temperature (
float、任意、デフォルト値は 1.0) — 集約 logits をスケーリングして、確率の歪みを制御します。 - use_gumbel_for_cells (
bool、任意、デフォルトはFalse) — セル選択にGumbel-Softmaxを適用するかどうかを指定します。 - use_gumbel_for_aggregation (
bool、任意、デフォルトはFalse) — 集約の選択に Gumbel-Softmax を適用するかどうかを指定します。 - average_approximation_function (
string、任意、デフォルトは"ratio") — 弱監督学習の場合に、セルの期待平均を計算する方法。"ratio"、"first_order"、または"second_order"のいずれかです。 - cell_selection_preference (
float, 任意) — 曖昧なケースにおけるセル選択の優先度。アグリゲーションの弱教師あり学習(WTQ、WikiSQL)の場合にのみ適用されます。アグリゲーション確率の総質量(“NONE”オペレーターを除く)がこのハイパーパラメータより大きい場合、その例に対してアグリゲーションが予測されます。 - answer_loss_cutoff (
float、省略可) — answer loss が cutoff を超える例を無視します。 - max_num_rows (
int、任意、デフォルトは 64) — 最大行数。 - max_num_columns (
int、任意、デフォルト値は 32)— 最大カラム数。 - average_logits_per_cell (
bool、任意、デフォルトはFalse) — セルごとに logits を平均化するかを指定します。 - select_one_column (
bool、任意、デフォルトはTrue) — モデルが単一の列のセルのみを選択するように制約をかけるかどうかを指定します。 - allow_empty_column_selection (
bool、任意、デフォルトはFalse) — どのカラムも選択しないことを許可するかどうか。 - init_cell_selection_weights_to_zero (
bool、任意、デフォルトはFalse) — セル選択の重みを 0 に初期化して、初期確率を 50% にするかどうかを指定します。 - reset_position_index_per_cell (
bool、任意、デフォルトはTrue) — 各セルごとに位置インデックスをリセットするかどうか(つまり、相対位置埋め込みを使用するかどうか)。 - disable_per_token_loss (
bool、任意、デフォルトはFalse) — セルに対する(強い・弱い)スーパービジョンを無効にするかどうか。 - aggregation_labels (
dict[int, label]、省略可) — 結果を集約するために使用される集約ラベルです。例えば、WTQモデルには次のような集約ラベルがあります:{0: "NONE", 1: "SUM", 2: "AVERAGE", 3: "COUNT"} - no_aggregation_label_index (
int, 任意) — アグリゲーションラベルが定義されており、そのラベルのいずれかが「No aggregation」を表す場合、そのインデックスを設定してください。例えば、WTQ モデルではインデックス 0 に「NONE」アグリゲーションラベルがあるため、これらのモデルではこの値を 0 に設定します。 - is_decoder (
bool、任意、デフォルトはFalse) — モデルがデコーダーとして使用されるかどうかを示します。Falseの場合、モデルはエンコーダーとして使用されます。 - add_cross_attention (
bool、任意、デフォルトはFalse) — モデルにクロスアテンション層を追加するかどうか。 - tie_word_embeddings (
bool、任意、デフォルトはTrue) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。
これは TapasModel の設定を保存するための設定クラスです。指定された引数に基づいて Tapas モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、google/tapas-base-finetuned-sqa と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import TapasModel, TapasConfig

>>> # Initializing a default (SQA) Tapas configuration
>>> configuration = TapasConfig()
>>> # Initializing a model from the configuration
>>> model = TapasModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
TapasTokenizer
class transformers.TapasTokenizer
< source >( vocab_filedo_lower_case = Truedo_basic_tokenize = Truenever_split = Noneunk_token = '[UNK]'sep_token = '[SEP]'pad_token = '[PAD]'cls_token = '[CLS]'mask_token = '[MASK]'empty_token = '[EMPTY]'tokenize_chinese_chars = Truestrip_accents = Nonecell_trim_length: int = -1max_column_id: int | None = Nonemax_row_id: int | None = Nonestrip_column_names: bool = Falseupdate_answer_coordinates: bool = Falsemin_question_length = Nonemax_question_length = Nonemodel_max_length: int = 512additional_special_tokens: list[str] | None = Noneclean_up_tokenization_spaces = True**kwargs )
パラメータ
- vocab_file (
str) — 語彙を含むファイル。 - do_lower_case (
bool、省略可、デフォルトはTrue) — トークン化時に、入力を小文字に変換するかどうかを指定します。 - do_basic_tokenize (
bool、省略可、デフォルトはTrue) — WordPieceの前に基本トークン化を行うかどうかを指定します。 - never_split (
Iterable、省略可) — トークン化中に分割されないトークンのコレクション。do_basic_tokenize=Trueの場合のみ有効です。 - unk_token (
str、任意、デフォルトは"[UNK]") — 不明トークンです。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。 - sep_token (
str、任意、デフォルトは"[SEP]") — 複数のシーケンスからシーケンスを構築する際に使用される区切りトークンです。例えば、シーケンス分類用の2つのシーケンス、または質問応答用のテキストと質問などです。また、特殊トークンを用いて構築されたシーケンスの最後のトークンとしても使用されます。 - pad_token (
str、任意、デフォルトは"[PAD]") — パディングに使用されるトークンです。例えば、長さが異なるシーケンスをバッチ処理する場合に使用します。 - cls_token (
str、任意、デフォルトは"[CLS]") — シーケンス分類(トークンごとの分類ではなく、シーケンス全体の分類)を行う際に使用される分類トークンです。特殊トークンを用いて構築された場合、シーケンスの最初のトークンになります。 - mask_token (
str、任意、デフォルトは"[MASK]") — 値をマスクするために使用されるトークンです。これは、マスク言語モデリングでこのモデルを学習する際に使用されるトークンです。モデルが予測しようとする対象となるトークンです。 - empty_token (
str、任意、デフォルトは"[EMPTY]") — テーブル内の空のセル値に使用されるトークンです。空のセル値には、""、"n/a"、"nan"、"?" が含まれます。 - tokenize_chinese_chars (
bool、任意、デフォルトはTrue) — 中国語の文字をトークン化するかどうか。日本語では無効にすべきです(このissueを参照)。 - strip_accents (
bool, 任意) — すべてのアクセント記号を除去するかどうか。このオプションが指定されない場合、lowercaseの値によって決定されます(元の BERT と同じ)。 - cell_trim_length (
int、任意、デフォルトは -1) — 0 より大きい場合: セルの長さをこの値以下になるようにトリムします。これにより、それ以降のセルトリミングが無効になるため、truncationをTrueに設定して使用してください。 - max_column_id (
int, 任意) — 抽出する最大のカラム ID。 - max_row_id (
int, 任意) — 抽出する最大行ID。 - strip_column_names (
bool、省略可、デフォルトはFalse) — カラム名ではなく空の文字列を追加するかどうか。 - update_answer_coordinates (
bool、省略可、デフォルトはFalse) — 回答テキストから回答の座標を再計算するかどうかを指定します。 - min_question_length (
int, 省略可) — 各質問のトークン数による最小長(これ未満の場合はスキップされます)。 - max_question_length (
int, 任意) — 各質問のトークン数による最大長(これを超える場合はスキップされます)。 - clean_up_tokenization_spaces (
bool、任意、デフォルトはTrue) — デコード後にスペースをクリーンアップするかどうか。クリーンアップとは、余分なスペースなどの潜在的なアーティファクトを削除することを指します。
TAPAS トークナイザーを構築します。WordPiece に基づいています。TAPAS モデルで使用するために、テーブルと関連する1文以上の文をフラット化します。
このトークナイザーは、ほとんどの主要なメソッドを含む PreTrainedTokenizer を継承しています。これらのメソッドに関する詳細については、このスーパークラスを参照してください。 TapasTokenizer は、表構造をエンコードするために複数のトークンタイプIDを作成します。具体的には、以下の順序で7つのトークンタイプIDを追加します: segment_ids、column_ids、row_ids、prev_labels、column_ranks、inv_column_ranks、numeric_relations
- segment_ids: トークンが質問(0)に属するか、テーブル(1)に属するかを示します。特殊トークンとパディングには0を指定します。
- column_ids: トークンがテーブルのどの列に属するかを示します(1から始まります)。すべての質問トークン、特殊トークン、およびパディングでは0です。
- row_ids: トークンがテーブルのどの行に属するかを示します(1から始まります)。すべての質問トークン、特殊トークン、およびパディングでは 0 です。列ヘッダーのトークンも 0 です。
- prev_labels: 前の質問への回答(の一部)であったトークンかどうかを示します(1: 該当、0: 非該当)。対話形式のセットアップ(SQA など)で有用です。
- column_ranks: 該当する場合、テーブル内のトークンがその列において持つ順位を示します。例えば、値が 87、53、69 の列「number of movies」がある場合、これらのトークンの column ranks はそれぞれ 3、1、2 となります。質問トークン、特殊トークン、およびパディングには 0 を指定します。
- inv_column_ranks: indicate the inverse rank of a table token relative to a column, if applicable. For example, if you have a column “number of movies” with values 87, 53 and 69, then the inverse column ranks of these tokens are 1, 3 and 2 respectively. 0 for all question tokens, special tokens and padding.
- numeric_relations: テーブルのトークンと質問との間の数値的関係を示します。すべての質問トークン、特殊トークン、およびパディングに対しては 0 を指定します。
TapasTokenizerは、テーブルおよび関連する文に対して、句読点の分割やwordpieceを含むエンドツーエンドのトークン化を実行します。
__call__
< source >( table: typing.Union[ForwardRef('pd.DataFrame'), str, list[str], NoneType]queries: str | list[str] | list[int] | list[list[str]] | list[list[int]] | None = Noneanswer_coordinates: list[tuple] | list[list[tuple]] | None = Noneanswer_text: list[str] | list[list[str]] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | transformers.utils.generic.PaddingStrategy = Falsetruncation: bool | str | transformers.models.tapas.tokenization_tapas.TapasTruncationStrategy = Falsemax_length: int | None = Nonepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = True**kwargs )
パラメータ
- table (
pd.DataFrameまたはstrまたはlist[str]) — 表形式のデータを含むテーブルです。すべてのセルの値がテキストである必要があります。Pandas のデータフレームを文字列に変換するには、.astype(str) を使用してください。文字列または文字列のリストを渡す場合、それらは空のテーブルを持つクエリとして解釈されます(汎用的なトークナイザーのテストをサポートするため)。 - queries (
strまたはlist[str]) — エンコード対象のテーブルに関連する質問、または質問のバッチです。バッチの場合、すべての質問は同じテーブルを参照する必要があります。 - answer_coordinates (
list[Tuple]またはlist[list[Tuple]]、任意) — バッチ内の各テーブルと質問のペアに対する回答の座標です。テーブルと質問のペアが1つだけ提供される場合、answer_coordinates は1つ以上のタプルからなる単一のリストでなければなりません。各タプルは (row_index, column_index) のペアでなければなりません。最初のデータ行(列ヘッダー行ではない)のインデックスは 0 です。最初の列のインデックスは 0 です。テーブルと質問のペアのバッチが提供される場合、answer_coordinates はタプルのリストのリストでなければなりません(各リストは1つのテーブルと質問のペアに対応します)。 - answer_text (
list[str]またはlist[list[str]]、任意) — バッチ内の各テーブル・質問ペアの回答テキストです。テーブル・質問ペアが1つだけ提供される場合は、answer_text は1つ以上の文字列からなる単一のリストでなければなりません。各文字列は、対応する回答座標の回答テキストでなければなりません。テーブル・質問ペアのバッチが提供される場合は、answer_coordinates は文字列のリストのリストでなければなりません(各リストが単一のテーブル・質問ペアに対応します)。 - add_special_tokens (
bool、省略可、デフォルトはTrue) — モデルに紐づく特殊トークンを用いてシーケンスをエンコードするかどうかを指定します。 - padding (
bool,strまたは PaddingStrategy, 省略可, デフォルトはFalse) — パディングの有効化と制御を行います。以下の値を受け入れます:Trueまたは'longest': バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。'max_length': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。Falseまたは'do_not_pad'(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
- truncation (
bool,strまたはTapasTruncationStrategy, 省略可, デフォルトはFalse) — 切り詰めを有効にし、制御します。以下の値を受け入れます:Trueまたは'drop_rows_to_fit': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れられる最大入力長まで切り詰めます。これにより、テーブルから行単位で切り詰め、行を削除します。Falseまたは'do_not_truncate'(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
- max_length (
int, 省略可能) — truncation/padding パラメータのいずれかによって使用される最大長を制御します。未設定のまま、または
Noneに設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。 - is_split_into_words (
bool、任意、デフォルトはFalse) — 入力がすでに事前トークン化済み(例:単語に分割済み)かどうかを指定します。Trueに設定すると、トークナイザーは入力がすでに単語に分割済み(たとえば空白で分割済み)であると仮定し、それをトークン化します。これは NER やトークン分類に有用です。 - pad_to_multiple_of (
int, 省略可) — 設定すると、シーケンスを指定された値の倍数にパディングします。これは、計算能力が>= 7.5(Volta) の NVIDIA ハードウェアで Tensor Cores を使用できるようにするため、特に有用です。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': Numpy のnp.ndarrayオブジェクトを返します。
テーブルに関連する1つ以上のシーケンスをトークナイズし、モデル用に準備するための主要なメソッドです。
convert_logits_to_predictions
< source >( datalogitslogits_agg = Nonecell_classification_threshold = 0.5 ) → tuple comprising various elements depending on the inputs
パラメータ
- data (
dict) — 特徴量から実際の値へのマッピングを行う辞書。TapasTokenizer を使用して作成する必要があります。 - logits (
torch.Tensor、shape(batch_size, sequence_length)) — トークンレベルのlogitsを含むTensor。 - logits_agg (
torch.Tensor、形状(batch_size, num_aggregation_labels)、任意) — アグリゲーションの logits を含むテンソル。 - cell_classification_threshold (
float、任意、デフォルト値は 0.5)— セル選択に使用される閾値です。この閾値より確率が高いすべてのテーブルセルが選択されます。
戻り値
入力に応じてさまざまな要素を含むtuple
- predicted_answer_coordinates (
list[list[[tuple]]、長さbatch_size): 予測された回答の座標を、タプルのリストのリストとして表したものです。リストの各要素は、バッチ内の1つのサンプルの予測された回答の座標を、タプルのリストとして保持します。各タプルはセル、すなわち (行インデックス, 列インデックス) を表します。 - predicted_aggregation_indices (
list[int]、長さbatch_size、任意、logits_aggregationが指定された場合に返されます): 集約ヘッドの予測された集約演算子のインデックス。
TapasForQuestionAnsweringのlogitsを実際の予測された回答の座標および任意の集約インデックスに変換します。
この関数のベースとなっている元の実装は、こちらで確認できます。
TapasModel
class transformers.TapasModel
< source >( config: TapasConfigadd_pooling_layer = True )
パラメータ
- config (TapasConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
- add_pooling_layer (
bool、省略可、デフォルトはTrue) — プーリング層を追加するかどうか
特定のヘッドを上に載せずに、生のhidden-statesを出力する素のTapas Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Noneencoder_hidden_states: typing.Optional[torch.FloatTensor] = Noneencoder_attention_mask: typing.Optional[torch.FloatTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length, 7), 任意) — 表形式の構造をエンコードするトークンインデックス。インデックスは AutoTokenizer. を使用して取得できます。詳細については、このクラスを参照してください。 - position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。reset_position_index_per_cellの TapasConfig がTrue, に設定されている場合、相対位置埋め込みが使用されます。範囲[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - encoder_hidden_states (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) — エンコーダーの最終層の出力における隠れ状態のシーケンスです。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。 - encoder_attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — エンコーダー入力のパディングトークンインデックスに対するアテンションを回避するためのマスク。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。マスクの値は[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
BaseModelOutputWithPooling または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または BaseModelOutputWithPooling。設定(TapasConfig)や入力に応じて、さまざまな要素で構成されます。
TapasModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.FloatTensor、shape(batch_size, hidden_size)) — 補助事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態。例えば、BERT 系のモデルでは、線形層と tanh 活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次文予測(分類)目的から学習されます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, TapasModel
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base")
>>> model = TapasModel.from_pretrained("google/tapas-base")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)
>>> queries = ["How many movies has George Clooney played in?", "How old is Brad Pitt?"]

>>> inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt")
>>> outputs = model(**inputs)

>>> last_hidden_states = outputs.last_hidden_state
TapasForMaskedLM
class transformers.TapasForMaskedLM
< source >( config: TapasConfig )
パラメータ
- config (TapasConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
language modelingヘッドを備えたTapasモデル。”
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Noneencoder_hidden_states: typing.Optional[torch.FloatTensor] = Noneencoder_attention_mask: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskedLMOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length, 7), 任意) — 表形式の構造をエンコードするトークンインデックス。インデックスは AutoTokenizer. を使用して取得できます。詳細については、このクラスを参照してください。 - position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。reset_position_index_per_cellの TapasConfig がTrue, に設定されている場合、相対位置埋め込みが使用されます。範囲[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - encoder_hidden_states (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) — エンコーダーの最終層の出力における隠れ状態のシーケンスです。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。 - encoder_attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — エンコーダー入力のパディングトークンインデックスに対するアテンションを回避するためのマスク。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。マスクの値は[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[-100, 0, ..., config.vocab_size]の範囲である必要があります(input_idsのドキュメント文字列を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲のラベルを持つトークンに対してのみ計算されます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
MaskedLMOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または MaskedLMOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(TapasConfig)や入力に応じて、さまざまな要素で構成されます。
TapasForMaskedLM の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — マスクド言語モデリング (MLM) の損失。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, TapasForMaskedLM
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base")
>>> model = TapasForMaskedLM.from_pretrained("google/tapas-base")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)

>>> inputs = tokenizer(
...     table=table, queries="How many [MASK] has George [MASK] played in?", return_tensors="pt"
... )
>>> labels = tokenizer(
...     table=table, queries="How many movies has George Clooney played in?", return_tensors="pt"
... )["input_ids"]

>>> outputs = model(**inputs, labels=labels)
>>> logits = outputs.logits
TapasForSequenceClassification
class transformers.TapasForSequenceClassification
< source >( config: TapasConfig )
パラメータ
- config (TapasConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
シーケンス分類ヘッド(プーリングされた出力の上に線形層を配置したもの)を備えた Tapas モデル。例えば、TabFact(Chen et al., 2020)のようなテーブルエンタイルメントタスクに使用できます。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → SequenceClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length, 7), 任意) — 表形式の構造をエンコードするトークンインデックス。インデックスは AutoTokenizer. を使用して取得できます。詳細については、このクラスを参照してください。 - position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。reset_position_index_per_cellの TapasConfig がTrue, に設定されている場合、相対位置埋め込みが使用されます。範囲[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — シーケンス分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(Mean-Square loss)が計算され、config.num_labels > 1の場合は分類損失(Cross-Entropy)が計算されます。なお、元の実装では “classification_class_index” と呼ばれています。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
SequenceClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または SequenceClassifierOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(TapasConfig)と入力に応じて、さまざまな要素で構成されます。
TapasForSequenceClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, TapasForSequenceClassification
>>> import torch
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base-finetuned-tabfact")
>>> model = TapasForSequenceClassification.from_pretrained("google/tapas-base-finetuned-tabfact")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)
>>> queries = [
...     "There is only one actor who is 45 years old",
...     "There are 3 actors which played in more than 60 movies",
... ]

>>> inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt")
>>> labels = torch.tensor([1, 0])  # 1 means entailed, 0 means refuted

>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> logits = outputs.logits
TapasForQuestionAnswering
クラス transformers.TapasForQuestionAnswering
< source >( config: TapasConfig )
パラメータ
- config (TapasConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
内の質問応答タスク向けに、セル選択ヘッドと任意の集約ヘッドを上部に備えた Tapas モデル(logitsおよび任意のlogits_aggregationを計算するために、hidden-states の出力上に線形層を配置)の例として、SQA、WTQ、または WikiSQL による教師ありタスク。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonetable_mask: typing.Optional[torch.LongTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneaggregation_labels: typing.Optional[torch.LongTensor] = Nonefloat_answer: typing.Optional[torch.FloatTensor] = Nonenumeric_values: typing.Optional[torch.FloatTensor] = Nonenumeric_values_scale: typing.Optional[torch.FloatTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TableQuestionAnsweringOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length, 7), 任意) — 表形式の構造をエンコードするトークンインデックス。インデックスは AutoTokenizer. を使用して取得できます。詳細については、このクラスを参照してください。 - position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。reset_position_index_per_cellの TapasConfig がTrue, に設定されている場合、相対位置埋め込みが使用されます。範囲[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - table_mask (
torch.LongTensor、形状(batch_size, seq_length)、任意) — テーブル用のマスクです。どのトークンがテーブルに属するかを示します(1)。質問トークン、テーブルヘッダー、パディングは 0 です。 - labels (
torch.LongTensorの形状(batch_size, seq_length), 、省略可) — 階層的セル選択損失の計算に使用するトークンごとのラベル。テーブル内で答えが出現する位置をエンコードします。 を使用して取得できます。答えの一部であるトークンは 1、答えの一部でないトークンは 0 です。.- 回答の一部であるトークンに対して1
- 回答の一部ではないトークンには 0
- aggregation_labels (
torch.LongTensor、形状(batch_size, )、任意) — バッチ内の各サンプルについて、アグリゲーション損失を計算するためのアグリゲーション関数のインデックスです。インデックスは[0, ..., config.num_aggregation_labels - 1]の範囲である必要があります。アグリゲーションの強教師あり学習(WikiSQL-supervised)の場合にのみ必要です。 - float_answer (
torch.FloatTensor、shape(batch_size, )、任意) — バッチ内の各サンプルに対する Float 形式の回答。セル選択問題の場合は float(‘nan’) に設定します。弱教師あり(WTQ)の場合のみ、アグリゲートマスクと回帰損失の計算のために必要です。 - numeric_values (
torch.FloatTensor、shape(batch_size, seq_length)、任意) — 各トークンの数値。数値でないトークンは NaN になります。AutoTokenizer を使用して取得できます。集約(WTQ)における弱教師あり学習の場合、回帰損失を計算するためにのみ必要です。 - numeric_values_scale (
torch.FloatTensor、形状(batch_size, seq_length)、任意) — 各トークンの数値のスケールです。AutoTokenizer を使用して取得できます。集約(WTQ)における弱教師あり学習の場合、回帰損失を計算するためにのみ必要です。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
TableQuestionAnsweringOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または TableQuestionAnsweringOutput。設定(TapasConfig)や入力に応じて、さまざまな要素で構成されます。
TapasForQuestionAnsweringのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labels(および場合によってはanswer、aggregation_labels、numeric_values、numeric_values_scale)が提供された場合に返されます)— 階層的セル選択の対数尤度損失と、(任意で)半教師あり回帰損失、および(任意で)集約用の教師あり損失の合計として計算される総損失。logits (
torch.FloatTensor、形状(batch_size, sequence_length)) — セル選択ヘッドによる、各トークンに対する予測スコア。logits_aggregation (
torch.FloatTensor、optional、形状(batch_size, num_aggregation_labels)) — 各集約オペレーターに対する集約ヘッドの予測スコア。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, TapasForQuestionAnswering
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base-finetuned-wtq")
>>> model = TapasForQuestionAnswering.from_pretrained("google/tapas-base-finetuned-wtq")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)
>>> queries = ["How many movies has George Clooney played in?", "How old is Brad Pitt?"]

>>> inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt")
>>> outputs = model(**inputs)

>>> logits = outputs.logits
>>> logits_aggregation = outputs.logits_aggregation