
Transformers documentation
LiLT
このモデルは2022年2月28日にHF papersで公開され、2022年10月12日にHugging Face Transformersに貢献されました。
LiLT
概要
LiLTモデルは、Jiapeng Wang、Lianwen Jin、Kai Ding による LiLT: A Simple yet Effective Language-Independent Layout Transformer for Structured Document Understanding で提案されました。 LiLT は、任意の事前学習済み RoBERTa テキストエンコーダーと軽量な Layout Transformer を組み合わせることで、LayoutLM 同様のドキュメント理解を多くの言語で実現します。
論文の抄録は以下の通りです。
構造化ドキュメント理解は、インテリジェントなドキュメント処理において重要な役割を果たすため、近年大きな注目を集め、著しい進歩を遂げています。しかし、既存の関連モデルの多くは、事前学習コーパスに含まれる特定の言語(通常は英語)のドキュメントデータのみを処理できるという極めて大きな制約があります。この問題を解決するために、私たちは、構造化ドキュメント理解のためのシンプルかつ効果的な手法である Language-independent Layout Transformer (LiLT) を提案します。LiLT は、単一の言語の構造化ドキュメントで事前学習を行い、その後、対応する市販の単一言語/多言語の事前学習済みテキストモデルを用いて、他の言語に直接ファインチューニングすることができます。8つの言語での実験結果から、LiLT は、広く使用されている多様な下流ベンチマークにおいて、競争力のある、あるいはそれ以上の性能を達成することが示されました。これにより、ドキュメントレイアウト構造の事前学習から言語非依存の恩恵を受けることが可能になります。
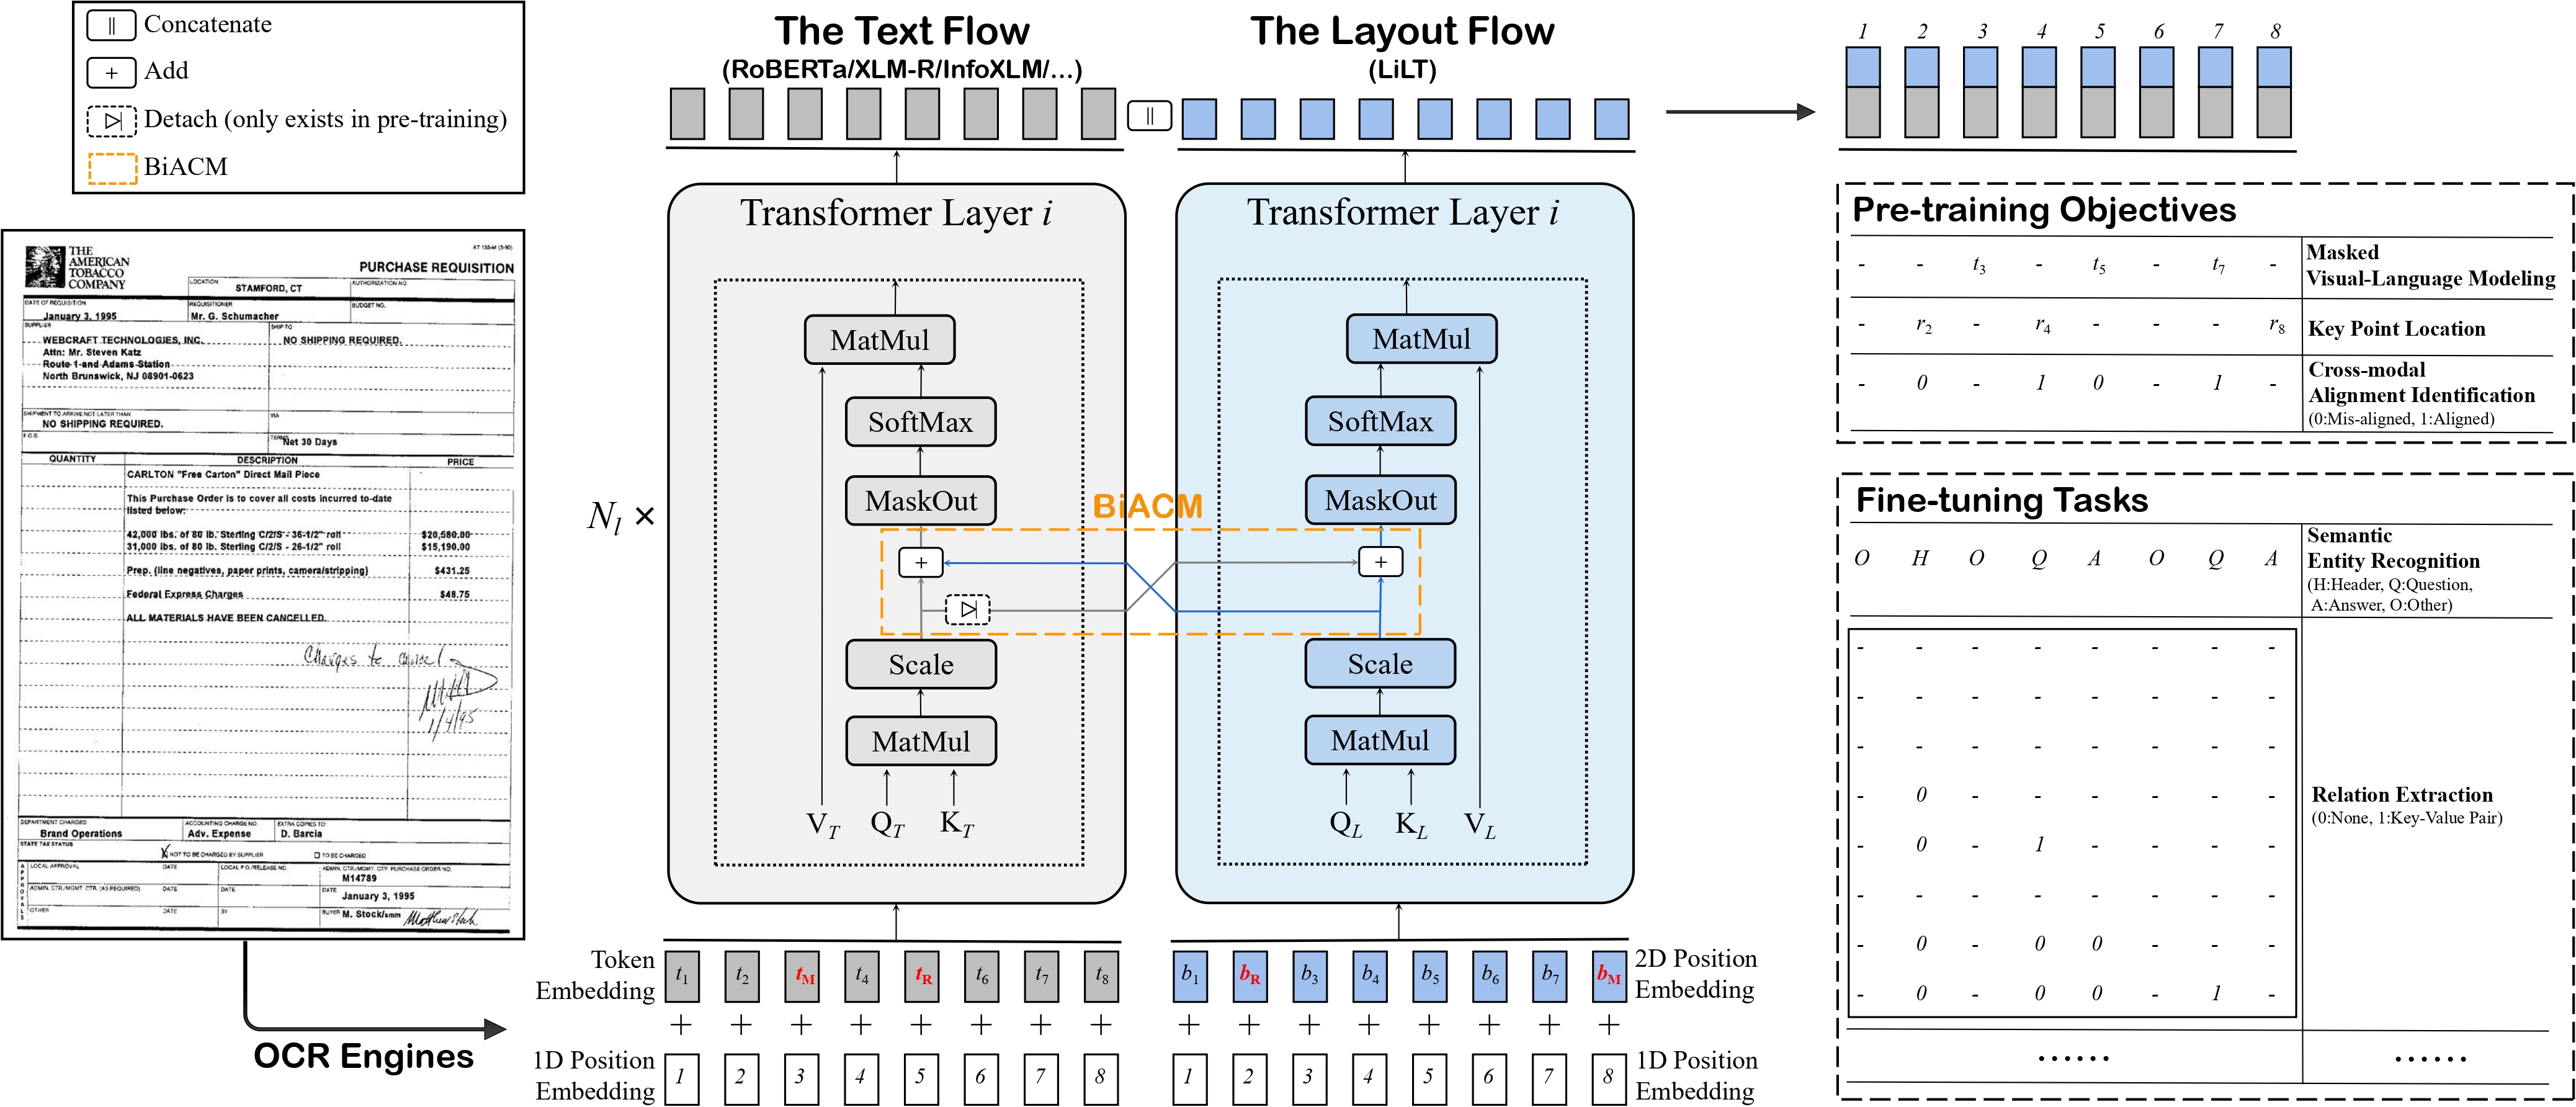 LiLT architecture. Taken from the original paper.
このモデルはnielsrによって提供されました。 元のコードはこちらで確認できます。
使用のコツ
- ハブの新しい RoBERTa チェックポイントと Language-Independent Layout Transformer を組み合わせるには、このガイドを参照してください。
このスクリプトを実行すると、
config.jsonとpytorch_model.binがローカルに保存されます。これを行った後、HuggingFace アカウントでログインしていることを前提として、以下を行うことができます。
from transformers import LiltModel


model = LiltModel.from_pretrained("path_to_your_files", device_map="auto")
model.push_to_hub("name_of_repo_on_the_hub")- モデル用のデータを準備する際は、Layout Transformerと組み合わせるRoBERTaチェックポイントに対応するトークン語彙を使用してください。
- lilt-roberta-en-base は LayoutLMv3 と同じ語彙を使用しているため、LayoutLMv3TokenizerFast を使用してモデル用のデータを準備できます。 lilt-roberta-en-base についても同様で、LayoutXLMTokenizerFast を使用できます。
リソース
LiLTの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示す)のリソースのリストです。
- LiLTのデモノートブックはこちらで確認できます。
ドキュメントリソース
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
LiltConfig
class transformers.LiltConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 512type_vocab_size: int = 2initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0bos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Noneclassifier_dropout: float | int | None = Nonechannel_shrink_ratio: int = 4max_2d_position_embeddings: int = 1024 )
パラメータ
- vocab_size (
int、任意、デフォルトは30522) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは768) — 隠れ表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは12) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - intermediate_size (
int、任意、デフォルトは3072) — MLP 表現の次元数。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - hidden_dropout_prob (
Union[float, int]、任意、デフォルト値は0.1) — embeddings、encoder、pooler 内のすべての全結合層における dropout 確率です。 - attention_probs_dropout_prob (
Union[float, int]、任意、デフォルトは0.1) — アテンション確率のドロップアウト率です。 - max_position_embeddings (
int、任意、デフォルトは512) — このモデルが使用される可能性のある最大シーケンス長です。 - type_vocab_size (
int、任意、デフォルトは2) —token_type_idsの語彙サイズです。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-12) — レイヤーノーマル層で使用する epsilon です。 - pad_token_id (
int、任意、デフォルトは0) — 語彙内でパディングに使用されるトークン ID。 - bos_token_id (
int, 省略可) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]], 省略可) — 語彙内でストリーム終了に使用されるトークン ID。 - classifier_dropout (
Union[float, int]、省略可) — 分類器のドロップアウト率です。 - channel_shrink_ratio (
int、任意、デフォルトは 4)— レイアウト埋め込みのチャネル次元において、hidden_sizeに対する縮小比率です。 - max_2d_position_embeddings (
int、任意、デフォルト値は 1024) — 2D 位置埋め込みで使用される可能性のある最大値です。念のため、大きな値(例: 1024)に設定するのが一般的です。
これは SCUT-DLVCLab/lilt-roberta-en-base と同様の設定をデフォルト値で生成する、LiltModel の設定を保存するための設定クラスです。指定された引数に基づいて Lilt モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import LiltConfig, LiltModel

>>> # Initializing a LiLT SCUT-DLVCLab/lilt-roberta-en-base style configuration
>>> configuration = LiltConfig()
>>> # Randomly initializing a model from the SCUT-DLVCLab/lilt-roberta-en-base style configuration
>>> model = LiltModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
LiltModel
class transformers.LiltModel
< source >( config: LiltConfigadd_pooling_layer = True )
パラメータ
- config (LiltConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
- add_pooling_layer (
bool、省略可、デフォルトはTrue) — プーリング層を追加するかどうか
特定のヘッドを付加せずに、生のhidden-statesを出力する素のLilt Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonebbox: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- bbox (
torch.LongTensor、形状(batch_size, sequence_length, 4)、任意) — 各入力シーケンスのトークンのバウンディングボックスです。範囲[0, config.max_2d_position_embeddings-1]から選択されます。各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置に対応し、(x1, y1) は右下隅の位置を表します。正規化については 概要 を参照してください。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
BaseModelOutputWithPooling または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または BaseModelOutputWithPooling。設定(LiltConfig)や入力に応じて、さまざまな要素で構成されます。
LiltModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.FloatTensor、shape(batch_size, hidden_size)) — 補助事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態。例えば、BERT 系のモデルでは、線形層と tanh 活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次文予測(分類)目的から学習されます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, AutoModel
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModel.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
LiltForSequenceClassification
クラス transformers.LiltForSequenceClassification
< source >( config: LiltConfig )
パラメータ
- config (LiltConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
LiLTモデルは、プーリングされた出力の上に線形層を配置したシーケンス分類/回帰ヘッドを備えたtransformerです。GLUEタスクなどに使用されます。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonebbox: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → SequenceClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- bbox (
torch.LongTensor、形状(batch_size, sequence_length, 4)、任意) — 各入力シーケンスのトークンのバウンディングボックスです。範囲[0, config.max_2d_position_embeddings-1]から選択されます。各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置に対応し、(x1, y1) は右下隅の位置を表します。正規化については 概要 を参照してください。 - attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — シーケンス分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
SequenceClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または SequenceClassifierOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(LiltConfig)や入力に応じて、さまざまな要素で構成されます。
LiltForSequenceClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, AutoModelForSequenceClassification
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> predicted_class_idx = outputs.logits.argmax(-1).item()
>>> predicted_class = model.config.id2label[predicted_class_idx]
LiltForTokenClassification
class transformers.LiltForTokenClassification
< source >( config: LiltConfig )
パラメータ
- config (LiltConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
トークン分類ヘッドを上部に備えた Lilt transformer(hidden-states の出力上に線形層を配置したもの)。例えば、固有表現抽出(NER)タスクに使用します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonebbox: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TokenClassifierOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- bbox (
torch.LongTensor、形状(batch_size, sequence_length, 4)、任意) — 各入力シーケンスのトークンのバウンディングボックスです。範囲[0, config.max_2d_position_embeddings-1]から選択されます。各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置に対応し、(x1, y1) は右下隅の位置を表します。正規化については 概要 を参照してください。 - attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、形状(batch_size, sequence_length)、任意) — トークン分類の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
TokenClassifierOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または TokenClassifierOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(LiltConfig)や入力に応じて、さまざまな要素で構成されます。
LiltForTokenClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失。logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.num_labels)) — SoftMax 適用前の分類スコア。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, AutoModelForTokenClassification
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModelForTokenClassification.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> predicted_class_indices = outputs.logits.argmax(-1)
LiltForQuestionAnswering
クラス transformers.LiltForQuestionAnswering
< source >( config: LiltConfig )
パラメータ
- config (LiltConfig) — モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連付けられた重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
SQuAD などの抽出型質問応答タスクに対応するため、span start logits と span end logits を計算するために隠れ状態の出力上に線形層を配置したスパン分類ヘッドを備えた Lilt transformer。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonebbox: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.FloatTensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonestart_positions: typing.Optional[torch.LongTensor] = Noneend_positions: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → QuestionAnsweringModelOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- bbox (
torch.LongTensor、形状(batch_size, sequence_length, 4)、任意) — 各入力シーケンスのトークンのバウンディングボックスです。範囲[0, config.max_2d_position_embeddings-1]から選択されます。各バウンディングボックスは (x0, y0, x1, y1) 形式の正規化された値である必要があります。ここで (x0, y0) はバウンディングボックスの左上隅の位置に対応し、(x1, y1) は右下隅の位置を表します。正規化については 概要 を参照してください。 - attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- token_type_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 入力テキストの第1部分と第2部分を区別するためのセグメントトークンインデックス。インデックスは[0, 1]:- 0 は sentence A トークンに対応します。
- 1 は sentence B トークンに対応します。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - start_positions (
torch.LongTensor、shape(batch_size,)、任意) — トークン分類損失の計算に使用する、ラベル付きスパンの開始位置(インデックス)のラベルです。 位置はシーケンスの長さ(sequence_length)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。 - end_positions (
torch.LongTensor、形状(batch_size,)、任意) — トークン分類損失の計算に使用する、ラベル付きスパンの終了位置(インデックス)のラベルです。 位置はシーケンスの長さ(sequence_length)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
QuestionAnsweringModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または QuestionAnsweringModelOutput(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(LiltConfig)や入力に応じて、さまざまな要素で構成されます。
LiltForQuestionAnsweringのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます)— 総スパン抽出損失は、開始位置と終了位置に対する Cross-Entropy の和です。start_logits (
torch.FloatTensor、shape(batch_size, sequence_length)) — SoftMax 適用前のスパン開始スコア。end_logits (
torch.FloatTensor、shape(batch_size, sequence_length)) — スパンの終了スコア(SoftMax 適用前)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, AutoModelForQuestionAnswering
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModelForQuestionAnswering.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)

>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()

>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> predicted_answer = tokenizer.decode(predict_answer_tokens)