
Transformers documentation
InstructBlipVideo
このモデルは2023年5月11日にHF papersで公開され、2024年6月25日にHugging Face Transformersに貢献されました。


InstructBlipVideo
概要
InstructBLIPVideo は、Wenliang Dai、Junnan Li、Dongxu Li、Anthony Meng Huat Tiong、Junqi Zhao、Weisheng Wang、Boyang Li、Pascale Fung、Steven Hoi によって提案された InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning のモデルを拡張したものです。 InstructBLIPVideo は InstructBLIP と同じアーキテクチャを使用し、InstructBLIP と同じチェックポイントで動作します。唯一の違いは、動画を処理できる点です。
論文の抄録は以下の通りです。
事前学習と指示チューニングのパイプラインを駆動力として、多様な言語ドメインのタスクを解決できる汎用言語モデルが登場しました。しかし、追加の視覚入力によって生じるタスク間の乖離が大きくなるため、汎用のビジョン・言語モデルを構築することは困難です。ビジョン・言語事前学習は広く研究されてきましたが、ビジョン・言語指示チューニングはまだ比較的未開拓な領域です。本論文では、事前学習済みBLIP-2モデルを基盤としたビジョン・言語指示チューニングについて、体系的かつ包括的な研究を行います。26の公開データセットを幅広く収集し、指示チューニングの形式に変換した上で、保持内(held-in)指示チューニングと保持外(held-out)ゼロショット評価の2つのクラスターに分類しました。さらに、与えられた指示に合わせて有益な特徴を抽出できるようにする重要な手法である、指示認識型視覚特徴抽出を導入します。その結果得られたInstructBLIPモデルは、すべての13の保持外データセットで最先端(state-of-the-art)のゼロショット性能を達成し、BLIP-2やより大きなFlamingoを大幅に上回りました。また、個々の下流タスクでファインチューニングした場合にも、最先端の性能(例:ScienceQA IMGでの90.7%の精度)を実現します。さらに、InstructBLIPが同時期に発表されたマルチモーダルモデルに対して持つ優位性を定性的に示します。
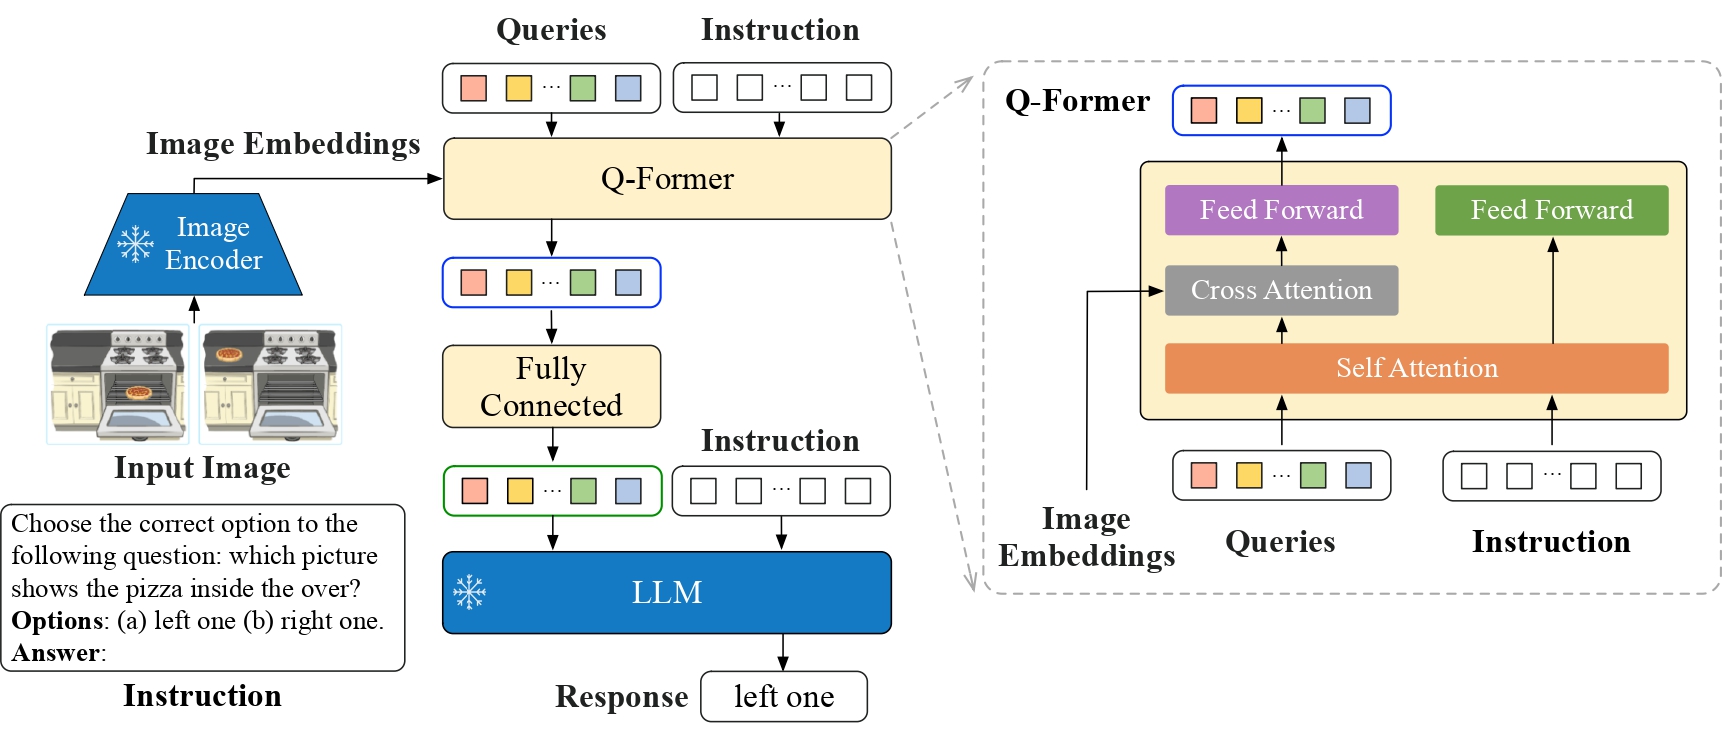 InstructBLIPVideo architecture. Taken from the original paper.
このモデルは RaushanTurganbay によって提供されました。 元のコードは こちら で確認できます。
使用のコツ
- モデルは1つの動画から4フレームをサンプリングして学習されているため、4フレームをサンプリングすることをお勧めします。
v4.46 以降の BLIP モデルでは、
processor.num_query_tokens = {{num_query_tokens}}を追加すること、およびモデルの埋め込み層を拡張して特別な<image>トークンを追加することに関する警告が発生します。モデルのチェックポイントを所有している場合は、プロセッサーにこれらの属性を追加することを強く推奨します。所有していない場合は、プルリクエストを開いてください。これらの属性を追加すると、BLIP は画像ごとに必要なクエリトークンの数を追加し、クエリトークンの数だけ<image>プレースホルダーでテキストを拡張します。通常、画像あたり約 500 トークン必要となるため、テキストが切り捨てられないようご注意ください。切り捨てが発生すると、埋め込みのマージ時に失敗します。 これらの属性は、model.config.num_query_tokensとしてモデルの config から取得でき、モデルの埋め込みの拡張は このリンク に従って実行できます。
InstructBlipVideoConfig
クラス transformers.InstructBlipVideoConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneqformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_query_tokens: int = 32initializer_factor: float = 1.0initializer_range: float = 0.02video_token_index: int | None = None )
パラメータ
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig]、任意) — ビジョンバックボーンの config オブジェクトまたは辞書です。 - qformer_config (
dict, 任意) — InstructBlipVideoQFormerConfig を初期化するために使用される設定オプションの辞書。 - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]、省略可) — テキストバックボーンの設定オブジェクトまたは辞書。 - num_query_tokens (
int、省略可、デフォルトは 32) — Transformer に渡されるクエリトークンの数です。 - initializer_factor (
float、任意、デフォルトは1.0) — すべての重み行列を初期化する際に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - video_token_index (
int, 省略可) — 入力動画のプレースホルダーとして使用される動画トークンのインデックスです。
これは InstructBlipVideoModel の設定を保存するための設定クラスです。指定された引数に基づいて Instructblipvideo モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、Salesforce/instructblip-flan-t5-xl と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import (
...     InstructBlipVideoVisionConfig,
...     InstructBlipVideoQFormerConfig,
...     OPTConfig,
...     InstructBlipVideoConfig,
...     InstructBlipVideoForConditionalGeneration,
... )

>>> # Initializing a InstructBlipVideoConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoConfig()

>>> # Initializing a InstructBlipVideoForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoForConditionalGeneration(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a InstructBlipVideoConfig from a InstructBlipVideoVisionConfig, InstructBlipVideoQFormerConfig and any PreTrainedConfig

>>> # Initializing Instructblipvideo vision, Instructblipvideo Q-Former and language model configurations
>>> vision_config = InstructBlipVideoVisionConfig()
>>> qformer_config = InstructBlipVideoQFormerConfig()
>>> text_config = OPTConfig()

>>> config = InstructBlipVideoConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
InstructBlipVideoVisionConfig
class transformers.InstructBlipVideoVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1408intermediate_size: int = 6144num_hidden_layers: int = 39num_attention_heads: int = 16image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 14hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = True )
パラメータ
- hidden_size (
int、任意、デフォルトは1408) — 隠れ表現の次元数です。 - intermediate_size (
int、任意、デフォルトは6144) — MLP 表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは39) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは16) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは224) — 各画像のサイズ(解像度)。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは14) — 各パッチのサイズ(解像度)です。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - layer_norm_eps (
float、任意、デフォルトは1e-06) — レイヤーノーマル層で使用する epsilon です。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - initializer_range (
float、任意、デフォルトは1e-10) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - qkv_bias (
bool、省略可、デフォルトはTrue) — クエリ、キー、バリューにバイアスを追加するかどうか。
これは InstructBlipVideoModel の設定を保存するための設定クラスです。指定された引数に基づいて Instructblipvideo モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、Salesforce/instructblip-flan-t5-xl と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import InstructBlipVideoVisionConfig, InstructBlipVideoVisionModel

>>> # Initializing a InstructBlipVideoVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoVisionConfig()

>>> # Initializing a InstructBlipVideoVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
InstructBlipVideoQFormerConfig
class transformers.InstructBlipVideoQFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 512initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0cross_attention_frequency: int = 2encoder_hidden_size: int = 1408 )
パラメータ
- vocab_size (
int、任意、デフォルトは30522) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは768) — 隠れ表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは12) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - intermediate_size (
int、任意、デフォルトは3072) — MLP 表現の次元数。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - hidden_dropout_prob (
Union[float, int]、任意、デフォルト値は0.1) — embeddings、encoder、pooler 内のすべての全結合層における dropout 確率です。 - attention_probs_dropout_prob (
Union[float, int]、任意、デフォルトは0.1) — アテンション確率のドロップアウト率です。 - max_position_embeddings (
int、任意、デフォルトは512) — このモデルが使用される可能性のある最大シーケンス長です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-12) — レイヤーノーマル層で使用する epsilon です。 - pad_token_id (
int、任意、デフォルトは0) — 語彙内でパディングに使用されるトークン ID。 - cross_attention_frequency (
int、任意、デフォルトは 2) — Transformer 層にクロスアテンションを追加する頻度です。 - encoder_hidden_size (
int、任意、デフォルト値は 1408)— クロスアテンションにおける隠れ状態の隠れサイズです。
これは InstructBlipVideoModel の設定を保存するための設定クラスです。指定された引数に基づいて Instructblipvideo モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、Salesforce/instructblip-flan-t5-xl と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import InstructBlipVideoQFormerConfig, InstructBlipVideoQFormerModel

>>> # Initializing a InstructBlipVideo Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoQFormerConfig()

>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
InstructBlipVideoProcessor
クラス transformers.InstructBlipVideoProcessor
< source >( video_processortokenizerqformer_tokenizernum_query_tokens = None**kwargs )
を構築します。このクラスは、動画プロセッサ、トークナイザー、qformer トークナイザーを単一のプロセッサにラップします。
InstructBlipVideoProcessor は、InstructBlipVideoVideoProcessor、GPT2Tokenizer、および {qformer_tokenizer_class} のすべての機能を提供します。詳細については、~InstructBlipVideoVideoProcessor、~GPT2Tokenizer、および ~{qformer_tokenizer_class} を参照してください。
InstructBlipVideoVideoProcessor
class transformers.InstructBlipVideoVideoProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.VideosKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、optional、デフォルトはTrue) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, デフォルトは{'height' -- 384, 'width': 384}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルトは[0.48145466, 0.4578275, 0.40821073]) — 正規化に使用する画像の平均値です。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, デフォルト値は[0.26862954, 0.26130258, 0.27577711]) — 正規化に使用する画像の標準偏差です。do_normalizeがTrueに設定されている場合のみ、効果が現れます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - do_sample_frames (
bool、kwargs、任意、デフォルトはFalse) — 処理前に動画からフレームをサンプリングするか、動画全体を処理するかを指定します。 - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — 動画のメタデータで、総再生時間、fps、総フレーム数に関する情報を含みます。動画からのフレームサンプリングやタイムスタンプの計算に使用されます。動画を処理する前に手動でデコードしようとしている場合を除き、メタデータは渡さないでください。 - fps (
Annotated[int | float | None, None], kwargs) —do_sample_frames=Trueの場合、1 秒あたりサンプリングするターゲットフレーム数。 - num_frames (
Annotated[int | None, None], kwargs) —do_sample_frames=Trueの場合、サンプリングするフレームの最大数。 - return_metadata (
bool、kwargs、任意、デフォルトはFalse) — 動画メタデータを返すかどうかを指定します。動画メタデータは、動画の長さ、fps、デコードバックエンドなどの情報を含むオブジェクトです。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — 設定されている場合、特定のフレームワークのテンソルを返します。受け入れられる値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': NumPyのnp.ndarrayオブジェクトを返します。
- **kwargs (VideosKwargs、optional) — テキスト、画像、動画、音声の各モダリティに対する追加の処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDictクラスを参照してください。
InstructBlipVideoVideoProcessor ビデオプロセッサを構築します。
preprocess
< source >( videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]]**kwargs: *<class 'transformers.processing_utils.VideosKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]) — 前処理対象の動画です。ピクセル値が 0 から 255 の範囲にある、単一の動画またはバッチの動画を想定しています。ピクセル値が 0 から 1 の範囲にある動画を渡す場合は、do_rescale=Falseを設定してください。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - do_sample_frames (
bool、kwargs、任意) — 処理前に動画からフレームをサンプリングするか、動画全体を処理するかどうかを指定します。 - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — 動画のメタデータで、総再生時間、fps、総フレーム数に関する情報を含みます。動画からのフレームサンプリングやタイムスタンプの計算に使用されます。動画を処理する前に手動でデコードしようとしている場合を除き、メタデータは渡さないでください。 - fps (
Annotated[int | float | None, None], kwargs) —do_sample_frames=Trueの場合、1 秒あたりサンプリングするターゲットフレーム数。 - num_frames (
Annotated[int | None, None], kwargs) —do_sample_frames=Trueの場合、サンプリングするフレームの最大数。 - return_metadata (
bool、kwargs、optional) — 動画メタデータを返すかどうかを指定します。動画メタデータは、動画の長さ、fps、デコードバックエンドなどの情報を含むオブジェクトです。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
InstructBlipVideoVisionModel
class transformers.InstructBlipVideoVisionModel
< source >( config: InstructBlipVideoVisionConfig )
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値はimage_processor_classを使用して取得できます。詳細はimage_processor_class.__call__を参照してください(InstructBlipVideoProcessor は画像の処理にimage_processor_classを使用します)。 - interpolate_pos_encoding (
bool、省略可、デフォルトはFalse) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
戻り値
BaseModelOutputWithPooling または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または BaseModelOutputWithPooling。設定(InstructBlipVideoConfig)や入力に応じて、さまざまな要素で構成されます。
InstructBlipVideoVisionModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.FloatTensor、shape(batch_size, hidden_size)) — 補助事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態。例えば、BERT 系のモデルでは、線形層と tanh 活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次文予測(分類)目的から学習されます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
InstructBlipVideoQFormerModel
class transformers.InstructBlipVideoQFormerModel
< source >( config: InstructBlipVideoQFormerConfig )
InstructBlipVideoで使用されるQuerying Transformer (Q-Former)。指示も入力として受け取るため、BLIP-2からわずかに変更されています。
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.FloatTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonequery_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.FloatTensor] = Noneencoder_attention_mask: typing.Optional[torch.FloatTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPoolingAndCrossAttentions or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length)) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - query_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)) — アテンション計算に使用される隠れ状態。クロスアテンションの場合、クエリとして使用されます(つまり、キーとバリューには encoder_hidden_states が使用されます)。 - encoder_hidden_states (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) — エンコーダーの最終層の出力における隠れ状態のシーケンスです。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。 - encoder_attention_mask (
torch.FloatTensorの形状(batch_size, sequence_length), 、任意) — エンコーダー入力のパディングトークンインデックスに対するアテンションを回避するためのマスク。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。マスクの値は[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
戻り値
BaseModelOutputWithPoolingAndCrossAttentions または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または BaseModelOutputWithPoolingAndCrossAttentions。設定(InstructBlipVideoConfig)や入力に応じて、さまざまな要素で構成されます。
InstructBlipVideoQFormerModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.FloatTensor、shape(batch_size, hidden_size)) — 補助事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態。例えば、BERT 系のモデルでは、線形層と tanh 活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次文予測(分類)目的から学習されます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合、またはconfig.add_cross_attention=Trueが渡された場合、またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
past_key_values (
Cache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — Cache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己アテンションブロック(および
config.is_encoder_decoder=Trueの場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(past_key_values入力参照)。
InstructBlipVideoModel
class transformers.InstructBlipVideoModel
< source >( config: InstructBlipVideoConfig )
パラメータ
- config (InstructBlipVideoConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
InstructBlipVideo base モデルは、言語モデル、qformer、ビジュアルエンコーダーで構成されています。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: FloatTensorqformer_input_ids: FloatTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.FloatTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = Falseuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InstructBlipVideoForConditionalGenerationModelOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、shape(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値はimage_processor_classを使用して取得できます。詳細はimage_processor_class.__call__を参照してください(InstructBlipVideoProcessorは画像の処理にimage_processor_classを使用します)。 - qformer_input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — Q-Former の語彙における入力シーケンスのトークンインデックスです。入力トークンは任意で指定でき、テキストプロンプトとして機能します。Q-Former モデルはこのプロンプトをエンコードします。インデックスはInstructBlipVideoProcessorを使用して取得できます。詳細は
InstructBlipVideoProcessor.__call__()を参照してください。 - qformer_attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。マスクの値は[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- input_ids (
torch.FloatTensorの形状(batch_size, sequence_length), 任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- decoder_input_ids (
torch.LongTensorの形状(batch_size, target_sequence_length), 、任意) — 語彙におけるデコーダー入力シーケンスのトークンインデックスです。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- decoder_attention_mask (
torch.BoolTensorの形状(batch_size, target_sequence_length), 、省略可) — デフォルトの動作:decoder_input_ids. デフォルトでは因果マスクも使用されます。エンコーダー・デコーダー型言語モデル(T5 など)を使用する場合にのみ関連します。
- inputs_embeds (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - interpolate_pos_encoding (
bool、省略可、デフォルトはFalse) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。
戻り値
InstructBlipVideoForConditionalGenerationModelOutput または tuple(torch.FloatTensor)
InstructBlipVideoForConditionalGenerationModelOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(InstructBlipVideoConfig)や入力に応じて、さまざまな要素で構成されます。
InstructBlipVideoModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- loss (
torch.FloatTensor、optional、labelsが指定された場合のみ返されます、torch.FloatTensor、形状(1,)) — 言語モデルによる言語モデリング損失。 - logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデルの言語モデリングヘッドの予測スコア。 - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling、任意) — ビジョンエンコーダーの出力。 - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions、任意) — Q-Former (Querying Transformer) の出力。 - language_model_outputs(
CausalLMOutputWithPastまたはSeq2SeqLMOutput)— 言語モデルの出力です。
InstructBlipVideoForConditionalGeneration
クラス transformers.InstructBlipVideoForConditionalGeneration
< source >( config: InstructBlipVideoConfig )
パラメータ
- config (InstructBlipVideoConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
画像と任意のテキストプロンプトを指定してテキストを生成するためのInstructBlipVideoモデル。このモデルは、ビジョンエンコーダー、Querying Transformer (Q-Former)、および言語モデルで構成されています。
モデルにinput_idsを任意で渡すことができます。これはテキストのプロンプトとして機能し、言語モデルがプロンプトを継続するようにします。渡さない場合、言語モデルは[BOS](シーケンスの開始)トークンからテキストの生成を開始します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: FloatTensorqformer_input_ids: FloatTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.FloatTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool = Falseuse_cache: bool | None = Nonemm_encoder_outputs: transformers.modeling_outputs.BaseModelOutputWithPooling | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InstructBlipVideoForConditionalGenerationModelOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、shape(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値はimage_processor_classを使用して取得できます。詳細はimage_processor_class.__call__を参照してください(InstructBlipVideoProcessorは画像の処理にimage_processor_classを使用します)。 - qformer_input_ids (
torch.LongTensor、shape: (batch_size, sequence_length)) — Q-Former モジュールに投入されるプロンプトとして使用されるシーケンス。 - qformer_attention_mask (
torch.LongTensor、shape: (batch_size, sequence_length)、任意) — padding トークンのインデックスに対して attention を実行しないようにするためのマスク。 - input_ids (
torch.FloatTensorの形状(batch_size, sequence_length), 任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- decoder_input_ids (
torch.LongTensorの形状(batch_size, target_sequence_length), 、任意) — 語彙におけるデコーダー入力シーケンスのトークンインデックスです。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- decoder_attention_mask (
torch.LongTensor、shape(batch_size, target_sequence_length)、任意) — 特定のトークンインデックスに対するアテンションの計算を回避するためのマスクです。デフォルトでは因果マスクが使用され、モデルが未来を予測する際に過去の入力のみを参照できるようにします。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) —input_idsを渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込みルックアップ行列よりも、input_idsのインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[0, ..., config.vocab_size]の範囲内であるか、-100 である必要があります(input_idsの docstring を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲内のラベルを持つトークンに対してのみ計算されます。 - interpolate_pos_encoding (
bool、省略可、デフォルトはFalse) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。 - use_cache (
bool、任意) —Trueに設定すると、past_key_valuesのキーバリュー状態が返され、デコーディングの高速化に利用できます(past_key_valuesを参照)。 - mm_encoder_outputs (
~modeling_outputs.BaseModelOutputWithPooling, 任意) — キーがサポートされているモダリティ、値がそのモダリティのエンコード済み出力である辞書。各エンコード済み出力は、(pooler_output, 任意:last_hidden_states, 任意:hidden_states, 任意:attentions)pooler_output(形状(batch_size, sequence_length, hidden_size), 任意) からなるタプルです。これは、エンコーダーのマルチモーダル特徴量がテキスト埋め込みにマージされたシーケンスです。
戻り値
InstructBlipVideoForConditionalGenerationModelOutput または tuple(torch.FloatTensor)
InstructBlipVideoForConditionalGenerationModelOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(InstructBlipVideoConfig)や入力に応じて、さまざまな要素で構成されます。
InstructBlipVideoForConditionalGeneration の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- loss (
torch.FloatTensor、optional、labelsが指定された場合のみ返されます、torch.FloatTensor、形状(1,)) — 言語モデルによる言語モデリング損失。 - logits (
torch.FloatTensor、shape(batch_size, sequence_length, config.vocab_size)) — 言語モデルの言語モデリングヘッドの予測スコア。 - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling、任意) — ビジョンエンコーダーの出力。 - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions、任意) — Q-Former (Querying Transformer) の出力。 - language_model_outputs(
CausalLMOutputWithPastまたはSeq2SeqLMOutput)— 言語モデルの出力です。
例:
>>> from transformers import InstructBlipVideoProcessor, InstructBlipVideoForConditionalGeneration
>>> import torch
>>> from huggingface_hub import hf_hub_download
>>> import av
>>> import numpy as np

>>> def read_video_pyav(container, indices):
...     '''
...     Decode the video with PyAV decoder.
...     Args:
...         container (`av.container.input.InputContainer`): PyAV container.
...         indices (`list[int]`): List of frame indices to decode.
...     Returns:
...         result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
...     '''
...     frames = []
...     container.seek(0)
...     start_index = indices[0]
...     end_index = indices[-1]
...     for i, frame in enumerate(container.decode(video=0)):
...         if i > end_index:
...             break
...         if i >= start_index and i in indices:
...             frames.append(frame)
...     return np.stack([x.to_ndarray(format="rgb24") for x in frames])

>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b", device_map="auto")
>>> processor = InstructBlipVideoProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")

>>> file_path = hf_hub_download(
...       repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)

>>> # sample uniformly 4 frames from the video
>>> total_frames = container.streams.video[0].frames
>>> indices = np.arange(0, total_frames, total_frames / 4).astype(int)
>>> clip = read_video_pyav(container, indices)

>>> prompt = "What is happening in the video?"
>>> inputs = processor(text=prompt, images=clip, return_tensors="pt").to(model.device)

>>> outputs = model.generate(
...     **inputs,
...     do_sample=False,
...     num_beams=5,
...     max_length=256,
...     repetition_penalty=1.5,
...     length_penalty=1.0,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
"A person is eating a bowl of pasta, and they are using a fork to eat it. The person is sitting at a table, and the plate of pasta is on the table in front"
generate
< source >( pixel_values: FloatTensorqformer_input_ids: typing.Optional[torch.LongTensor] = Noneqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Noneinterpolate_pos_encoding: bool = False**generate_kwargs ) → captions (list)
パラメータ
- pixel_values (
torch.FloatTensor、shape (batch_size, num_channels, height, width) または (batch_size, num_frames, num_channels, height, width)): 処理対象の画像または動画。 - qformer_input_ids (
torch.LongTensor、shape (batch_size, sequence_length)、任意) — Q-Former モジュールに投入されるプロンプトとして使用されるシーケンス。 - qformer_attention_mask (
torch.LongTensor、shape: (batch_size, sequence_length)、任意) — padding トークンのインデックスに対して attention を実行しないようにするためのマスク。 - input_ids (
torch.LongTensor、shape (batch_size, sequence_length)、任意) — 生成のプロンプトとして使用されるシーケンス。 - attention_mask (
torch.LongTensor、shape: (batch_size, sequence_length)、任意) — padding トークンのインデックスに対して attention を実行しないようにするためのマスク。 - inputs_embeds (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — 入力埋め込み表現です。int トークンではなく、float である必要があります。 - interpolate_pos_encoding (
bool、任意、デフォルトはFalse) — 画像埋め込みの位置エンコーディングを補間するかどうかを指定します。
戻り値
キャプション (list)
長さ batch_size * num_captions の文字列のリスト。
generate関数をオーバーライドし、モデルを条件付きジェネレーターとして使用できるようにします。
get_video_features
< source >( pixel_values: FloatTensorqformer_input_ids: LongTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool | None = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithVisionQformerOutputs or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。 - qformer_input_ids (
torch.LongTensor、shape: (batch_size, sequence_length)) — Q-Former モジュールに投入されるプロンプトとして使用されるシーケンス。 - qformer_attention_mask (
torch.LongTensor、shape: (batch_size, sequence_length)、任意) — padding トークンのインデックスに対して attention を実行しないようにするためのマスク。 - interpolate_pos_encoding (
bool、省略可、デフォルトはFalse) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
戻り値
BaseModelOutputWithVisionQformerOutputs または tuple(torch.FloatTensor)
BaseModelOutputWithVisionQformerOutputs、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(InstructBlipVideoConfig)や入力に応じて、さまざまな要素で構成されます。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.FloatTensor、shape(batch_size, hidden_size)) — 補助事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態。例えば、BERT 系のモデルでは、線形層と tanh 活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次文予測(分類)目的から学習されます。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling、任意) — ビジョンエンコーダーの出力。qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions、任意) — Q-Former (Querying Transformer) の出力。
例:
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipVideoForConditionalGeneration

>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")

>>> messages = [
...     {
...         "role": "user", "content": [
...             {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Where is the cat standing?"},
...         ]
...     },
... ]

>>> inputs = processor.apply_chat_template(
...     messages,
...     tokenize=True,
...     return_dict=True,
...     return_tensors="pt",
...     add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]