
Transformers documentation
DETR condicional
Este modelo foi publicado no HF papers em 2021-08-13 e contribuído para o Hugging Face Transformers em 2022-09-22.
DETR condicional
Visão geral
O modelo Conditional DETR foi proposto em Conditional DETR for Fast Training Convergence por Depu Meng, Xiaokang Chen, Zejia Fan, Gang Zeng, Houqiang Li, Yuhui Yuan, Lei Sun, Jingdong Wang. O Conditional DETR apresenta um mecanismo de atenção cruzada condicional para o treinamento rápido do DETR. O Conditional DETR converge de 6,7× a 10× mais rápido que o DETR.
O resumo do artigo é o seguinte:
A abordagem DETR, desenvolvida recentemente, aplica a arquitetura de codificador e decodificador do transformer à detecção de objetos e alcança desempenho promissor. Neste artigo, abordamos o problema crítico da convergência lenta do treinamento e apresentamos um mecanismo de atenção cruzada condicional para o treinamento rápido do DETR. Nossa abordagem é motivada pelo fato de que a atenção cruzada no DETR depende fortemente dos embeddings de conteúdo para localizar as quatro extremidades e prever a caixa, o que aumenta a necessidade de embeddings de conteúdo de alta qualidade e, consequentemente, a dificuldade do treinamento. Nossa abordagem, denominada conditional DETR, aprende uma consulta espacial condicional a partir do embedding do decodificador para a atenção cruzada multi-cabeça do decodificador. O benefício é que, por meio da consulta espacial condicional, cada cabeça de atenção cruzada é capaz de prestar atenção a uma faixa contendo uma região distinta, por exemplo, uma extremidade do objeto ou uma região dentro da caixa do objeto. Isso reduz o intervalo espacial para localizar as regiões distintas para a classificação de objetos e a regressão da caixa, relaxando assim a dependência dos embeddings de conteúdo e facilitando o treinamento. Os resultados empíricos mostram que o conditional DETR converge 6,7× mais rápido para os backbones R50 e R101 e 10× mais rápido para backbones mais fortes, DC5-R50 e DC5-R101. O código está disponível em https://github.com/Atten4Vis/ConditionalDETR.
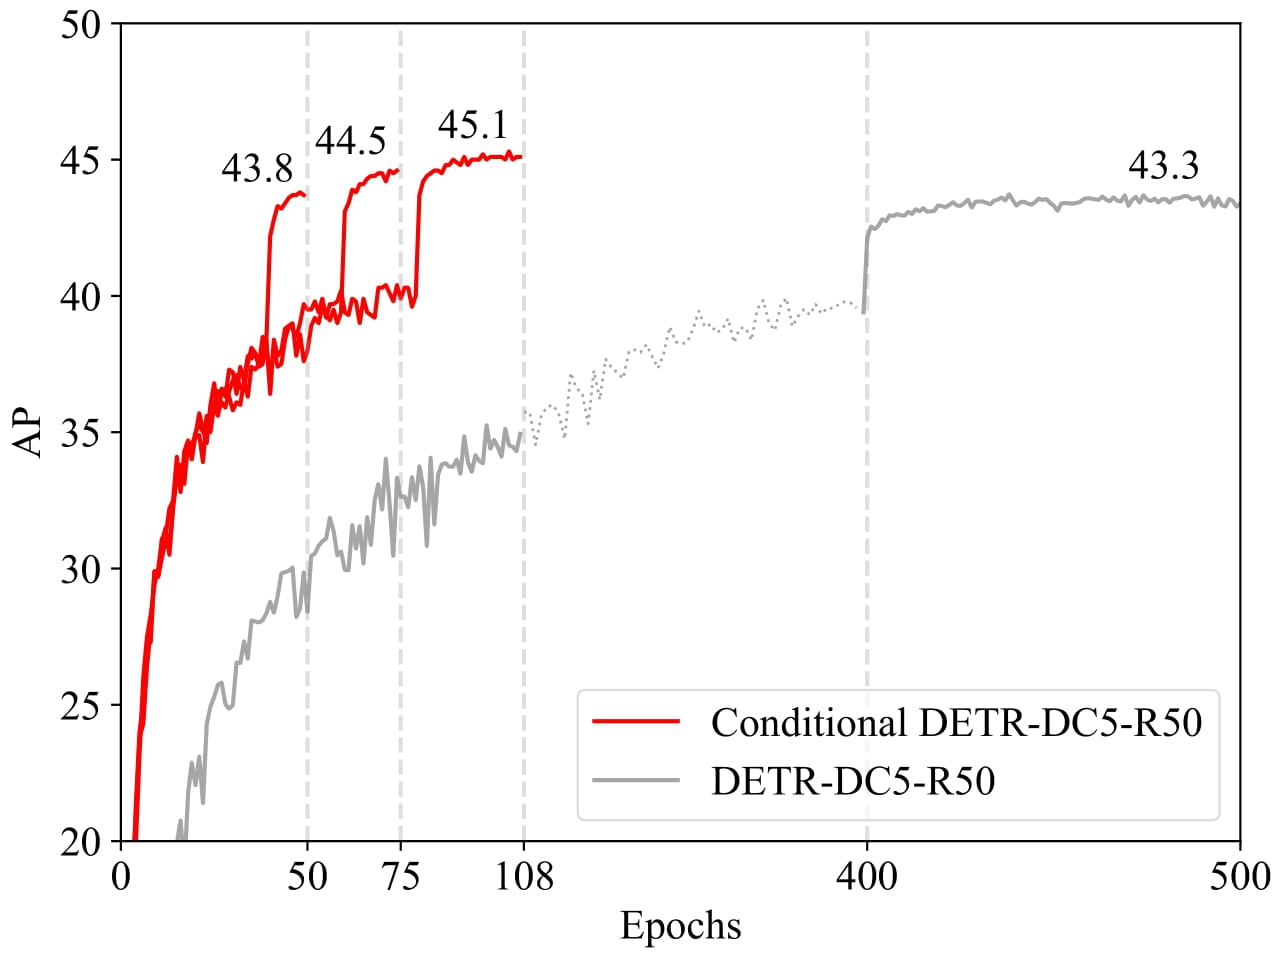 Conditional DETR shows much faster convergence compared to the original DETR. Taken from the original paper.
Este modelo foi contribuído por DepuMeng. O código original pode ser encontrado aqui.
Recursos
- Veja também: Guia da tarefa de detecção de objetos.
ConditionalDetrConfig
classe transformers.ConditionalDetrConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_channels: int = 3num_queries: int = 300encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8encoder_layerdrop: float | int = 0.0decoder_layerdrop: float | int = 0.0activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0init_std: float = 0.02init_xavier_std: float = 1.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'dilation: bool = Falseclass_cost: int = 2bbox_cost: int = 5giou_cost: int = 2mask_loss_coefficient: int = 1dice_loss_coefficient: int = 1cls_loss_coefficient: int = 2bbox_loss_coefficient: int = 5giou_loss_coefficient: int = 2focal_alpha: float = 0.25 )
Parâmetros
- is_encoder_decoder (
bool, opcional, padrãoTrue) — Indica se o modelo é usado como encoder/decoder ou não. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — A configuração do modelo backbone. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - num_queries (
int, opcional, padrão 300) — Número de consultas de objeto, ou seja, slots de detecção. Este é o número máximo de objetos que o ConditionalDetrModel pode detectar em uma única imagem. Para o COCO, recomendamos 100 consultas. - encoder_layers (
int, opcional, padrão6) — Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - encoder_ffn_dim (
int, opcional, padrão2048) — Dimensão da camada “intermediária” (frequentemente chamada de feed-forward) no encoder. - encoder_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no codificador do Transformer. - decoder_layers (
int, opcional, padrão6) — Número de camadas ocultas no decodificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - decoder_ffn_dim (
int, opcional, padrão2048) — Dimensão da camada “intermediária” (frequentemente chamada de feed-forward) no decoder. - decoder_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - encoder_layerdrop (
Union[float, int], opcional, padrão0.0) — A probabilidade de LayerDrop para o codificador. Consulte o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - decoder_layerdrop (
Union[float, int], opcional, padrão0.0) — A probabilidade de LayerDrop para o decoder. Consulte o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - activation_function (
str, opcional, padrãorelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - d_model (
int, opcional, padrão256) — Tamanho das camadas do codificador e da camada pooler. - dropout (
Union[float, int], opcional, padrão0.1) — A proporção para todas as camadas de dropout. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - activation_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as ativações dentro da camada totalmente conectada. - init_std (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - init_xavier_std (
float, opcional, padrão1.0) — Fator de escala usado na inicialização Xavier dos pesos de atenção cruzada. - auxiliary_loss (
bool, opcional, padrãoFalse) — Indica se as perdas de decodificação auxiliares (perda em cada camada do decodificador) devem ser utilizadas. - position_embedding_type (
str, opcional, padrão"sine") — Tipo de embeddings de posição a ser usado sobre os recursos da imagem. Um de"sine"ou"learned". - dilation (
bool, opcional, padrãoFalse) — Indica se a stride deve ser substituída por dilation no último bloco convolucional (DC5). Suportado apenas quandouse_timm_backbone=True. - class_cost (
int, opcional, padrão2) — Peso relativo do erro de classificação no custo de correspondência húngara. - bbox_cost (
int, opcional, padrão5) — Peso relativo do erro de caixa delimitadora L1 no custo de correspondência húngara. - giou_cost (
int, opcional, padrão2) — Peso relativo da perda de IoU generalizada no custo de correspondência húngara. - mask_loss_coefficient (
int, opcional, padrão1) — Peso relativo da focal loss na perda de segmentação panótica. - dice_loss_coefficient (
int, opcional, padrão1) — Peso relativo da perda dice na perda de segmentação panótica. - cls_loss_coefficient (
int, opcional, padrão2) — Peso relativo da perda de classificação na perda de segmentação panótica. - bbox_loss_coefficient (
int, opcional, padrão5) — Peso relativo da perda L1 da caixa delimitadora na perda de segmentação panótica. - giou_loss_coefficient (
int, opcional, padrão2) — Peso relativo da perda de IoU generalizada na perda de segmentação panótica. - focal_alpha (
float, opcional, padrão0.25) — Parâmetro alpha na focal loss.
Esta é a classe de configuração para armazenar a configuração de um ConditionalDetrModel. Ela é usada para instanciar um modelo Conditional Detr de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do microsoft/conditional-detr-resnet-50
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplos:
>>> from transformers import ConditionalDetrConfig, ConditionalDetrModel

>>> # Initializing a Conditional DETR microsoft/conditional-detr-resnet-50 style configuration
>>> configuration = ConditionalDetrConfig()

>>> # Initializing a model (with random weights) from the microsoft/conditional-detr-resnet-50 style configuration
>>> model = ConditionalDetrModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ConditionalDetrImageProcessor
classe transformers.ConditionalDetrImageProcessor
< source >( **kwargs: *<class 'transformers.models.conditional_detr.image_processing_conditional_detr.ConditionalDetrImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 800, 'longest_edge': 1333}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - format (
str, kwargs, opcional, padrãoAnnotationFormat.COCO_DETECTION) — Formato dos dados das anotações. Um de “coco_detection” ou “coco_panoptic”. - do_convert_annotations (
bool, kwargs, opcional, padrãoTrue) — Controla se as anotações devem ser convertidas para o formato esperado pelo modelo CONDITIONAL_DETR. Converte as bounding boxes para o formato(center_x, center_y, width, height)e no intervalo[0, 1]. Pode ser sobrescrito pelo parâmetrodo_convert_annotationsno métodopreprocess.
Constrói um processador de imagem ConditionalDetrImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = Nonereturn_segmentation_masks: bool | None = Nonemasks_path: str | pathlib.Path | None = None**kwargs: *<class 'transformers.models.conditional_detr.image_processing_conditional_detr.ConditionalDetrImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - annotations (
AnnotationTypeoulist[AnnotationType], opcional) — Anotações a serem transformadas de acordo com o padding aplicado às imagens. - return_segmentation_masks (
bool, opcional, padrãoself.return_segmentation_masks) — Se deve retornar máscaras de segmentação. - masks_path (
stroupathlib.Path, opcional) — Caminho para o diretório que contém as máscaras de segmentação. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - format (
str, kwargs, opcional, padrãoAnnotationFormat.COCO_DETECTION) — Formato dos dados das anotações. Um de “coco_detection” ou “coco_panoptic”. - do_convert_annotations (
bool, kwargs, opcional, padrãoTrue) — Controla se as anotações devem ser convertidas para o formato esperado pelo modelo CONDITIONAL_DETR. Converte as bounding boxes para o formato(center_x, center_y, width, height)e no intervalo[0, 1]. Pode ser sobrescrito pelo parâmetrodo_convert_annotationsno métodopreprocess.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
ConditionalDetrImageProcessorPil
classe transformers.ConditionalDetrImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.conditional_detr.image_processing_pil_conditional_detr.ConditionalDetrImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 800, 'longest_edge': 1333}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - format (
str, kwargs, opcional, padrãoAnnotationFormat.COCO_DETECTION) — Formato dos dados das anotações. Um de “coco_detection” ou “coco_panoptic”. - do_convert_annotations (
bool, kwargs, opcional, padrãoTrue) — Controla se as anotações devem ser convertidas para o formato esperado pelo modelo CONDITIONAL_DETR. Converte as bounding boxes para o formato(center_x, center_y, width, height)e no intervalo[0, 1]. Pode ser sobrescrito pelo parâmetrodo_convert_annotationsno métodopreprocess.
Constrói um processador de imagem ConditionalDetrImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = Nonereturn_segmentation_masks: bool | None = Nonemasks_path: str | pathlib.Path | None = None**kwargs: *<class 'transformers.models.conditional_detr.image_processing_pil_conditional_detr.ConditionalDetrImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - annotations (
AnnotationTypeoulist[AnnotationType], opcional) — Anotações a serem transformadas de acordo com o padding aplicado às imagens. - return_segmentation_masks (
bool, opcional, padrãoself.return_segmentation_masks) — Se deve retornar máscaras de segmentação. - masks_path (
stroupathlib.Path, opcional) — Caminho para o diretório que contém as máscaras de segmentação. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - format (
str, kwargs, opcional, padrãoAnnotationFormat.COCO_DETECTION) — Formato dos dados das anotações. Um de “coco_detection” ou “coco_panoptic”. - do_convert_annotations (
bool, kwargs, opcional, padrãoTrue) — Controla se as anotações devem ser convertidas para o formato esperado pelo modelo CONDITIONAL_DETR. Converte as bounding boxes para o formato(center_x, center_y, width, height)e no intervalo[0, 1]. Pode ser sobrescrito pelo parâmetrodo_convert_annotationsno métodopreprocess.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_object_detection
< source >( outputsthreshold: float = 0.5target_sizes: transformers.utils.generic.TensorType | list[tuple] = Nonetop_k: int = 100 ) → list[Dict]
Parâmetros
- outputs (
ConditionalDetrObjectDetectionOutput) — Saídas brutas do modelo. - threshold (
float, opcional) — Limiar de pontuação para manter as previsões de detecção de objetos. - target_sizes (
torch.Tensoroulist[tuple[int, int]], opcional) — Tensor de forma(batch_size, 2)ou lista de tuplas (tuple[int, int]) contendo o tamanho alvo (altura, largura) de cada imagem no lote. Se deixado como None, as previsões não serão redimensionadas. - top_k (
int, opcional, padrão 100) — Mantém apenas as k primeiras caixas delimitadoras antes da filtragem por limiar.
Retorna
list[Dict]
Uma lista de dicionários, em que cada dicionário contém as pontuações, rótulos e caixas para uma imagem do lote, conforme previsto pelo modelo.
Converte a saída bruta de ConditionalDetrForObjectDetection em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Suporta apenas PyTorch.
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → list[Dict]
Parâmetros
- outputs (ConditionalDetrForSegmentation) — Saídas brutas do modelo.
- threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se não for definido, as previsões não serão redimensionadas. - return_coco_annotation (
bool, opcional) — Padrão:False. Se definido comoTrue, os mapas de segmentação são retornados no formato de codificação por comprimento de execução (RLE) do COCO.
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — Um tensor de forma
(height, width)em que cada pixel representa umsegment_idoulist[List]codificação por comprimento de execução (RLE) do mapa de segmentação, se return_coco_annotation estiver definido comoTrue. Definido comoNonese nenhuma máscara for encontrada acima dothreshold. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — Um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — Um inteiro que representa o
Converte a saída de ConditionalDetrForSegmentation em previsões de segmentação de instâncias. Suporta apenas PyTorch.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (ConditionalDetrForSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Uma lista de tuplas (tuple[int, int]) contendo o tamanho alvo (altura, largura) de cada imagem no lote. Se não definido, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de ConditionalDetrForSegmentation em mapas de segmentação semântica. Suporta apenas PyTorch.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parâmetros
- outputs (ConditionalDetrForSegmentation) — As saídas de ConditionalDetrForSegmentation.
- threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - label_ids_to_fuse (
Set[int], opcional) — Os rótulos neste estado terão todas as suas instâncias fundidas em uma única. Por exemplo, podemos afirmar que pode haver apenas um céu em uma imagem, mas várias pessoas, de modo que o ID do rótulo para céu estaria nesse conjunto, mas não o de pessoa. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se não definido, as previsões não serão redimensionadas.
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_idouNonecaso nenhuma máscara seja encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente emtarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de ConditionalDetrForSegmentation em previsões de segmentação panótica de imagem. Suporta apenas PyTorch.
ConditionalDetrModel
classe transformers.ConditionalDetrModel
< source >( config: ConditionalDetrConfig )
Parâmetros
- config (ConditionalDetrConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo CONDITIONAL_DETR puro (consistindo de um backbone e um Transformer encoder-decoder) que produz estados ocultos brutos, sem nenhum head específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ConditionalDetrModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usandoimage_processor_class. Consulteimage_processor_class.__call__para mais detalhes (processor_classusaimage_processor_classpara processar as imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- decoder_attention_mask (
torch.Tensorde forma(batch_size, num_queries), opcional) — Não é usado por padrão. Pode ser usado para mascarar consultas de objetos. - encoder_outputs (
torch.Tensor, opcional) — A tupla consiste em (last_hidden_state, opcional:hidden_states, opcional:attentions)last_hidden_statede forma(batch_size, sequence_length, hidden_size), opcional) é uma sequência de hidden-states na saída da última camada do encoder. Usado na cross-attention do decoder. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passar o mapa de recursos achatado (saída do backbone + camada de projeção), você pode escolher passar diretamente uma representação achatada de uma imagem. - decoder_inputs_embeds (
torch.Tensorde forma(batch_size, num_queries, hidden_size), opcional) — Opcionalmente, em vez de inicializar as consultas com um tensor de zeros, você pode escolher passar diretamente uma representação incorporada.
Retorna
ConditionalDetrModelOutput ou tuple(torch.Tensor)
Um ConditionalDetrModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (None) e das entradas.
O método forward do ConditionalDetrModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do decodificador do modelo.Se
past_key_valuesfor usado, apenas o último hidden-state das sequências, com forma(batch_size, 1, hidden_size), é retornado.past_key_values (
EncoderDecoderCache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — Trata-se de uma instância de EncoderDecoderCache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas opcionais do embedding inicial.
decoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
cross_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas opcionais do embedding inicial.
encoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
intermediate_hidden_states (
torch.Tensorde forma(config.decoder_layers, batch_size, sequence_length, hidden_size), opcional, retornado quandoconfig.auxiliary_loss=True) — Ativações intermediárias do decodificador, ou seja, a saída de cada camada do decodificador, cada uma delas passando por um layernorm.reference_points (
torch.Tensorde forma(config.decoder_layers, batch_size, num_queries, 2 (anchor points))) — Pontos de referência (pontos de referência de cada camada do decoder).
Exemplos:
>>> from transformers import AutoImageProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/conditional-detr-resnet-50")
>>> model = AutoModel.from_pretrained("microsoft/conditional-detr-resnet-50")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # the last hidden states are the final query embeddings of the Transformer decoder
>>> # these are of shape (batch_size, num_queries, hidden_size)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
ConditionalDetrForObjectDetection
classe transformers.ConditionalDetrForObjectDetection
< source >( config: ConditionalDetrConfig )
Parâmetros
- config (ConditionalDetrConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo CONDITIONAL_DETR (composto por um backbone e um Transformer encoder-decoder) com cabeças de detecção de objetos no topo, para tarefas como a detecção COCO.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: list[dict] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ConditionalDetrObjectDetectionOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usandoimage_processor_class. Consulteimage_processor_class.__call__para mais detalhes (processor_classusaimage_processor_classpara processar as imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- decoder_attention_mask (
torch.Tensorde forma(batch_size, num_queries), opcional) — Não é usado por padrão. Pode ser usado para mascarar consultas de objetos. - encoder_outputs (
torch.Tensor, opcional) — A tupla consiste em (last_hidden_state, opcional:hidden_states, opcional:attentions)last_hidden_statede forma(batch_size, sequence_length, hidden_size), opcional) é uma sequência de hidden-states na saída da última camada do encoder. Usado na cross-attention do decoder. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passar o mapa de recursos achatado (saída do backbone + camada de projeção), você pode escolher passar diretamente uma representação achatada de uma imagem. - decoder_inputs_embeds (
torch.Tensorde forma(batch_size, num_queries, hidden_size), opcional) — Opcionalmente, em vez de inicializar as consultas com um tensor de zeros, você pode escolher passar diretamente uma representação incorporada. - labels (
list[Dict]de comprimento(batch_size,), opcional) — Rótulos para o cálculo da perda de correspondência bipartida. Lista de dicionários, em que cada dicionário contém pelo menos as seguintes 2 chaves: ‘class_labels’ e ‘boxes’ (os rótulos de classe e as caixas delimitadoras de uma imagem no lote, respectivamente). Os próprios rótulos de classe devem ser umtorch.LongTensorde comprimento(number of bounding boxes in the image,)e as caixas umtorch.Tensorde forma(number of bounding boxes in the image, 4).
Retorna
ConditionalDetrObjectDetectionOutput ou tuple(torch.Tensor)
Um ConditionalDetrObjectDetectionOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (None) e das entradas.
O método forward de ConditionalDetrForObjectDetection substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelssão fornecidas)) — Perda total como uma combinação linear de uma log-verossimilhança negativa (entropia cruzada) para a previsão de classe e uma perda de caixa delimitadora. Esta última é definida como uma combinação linear da perda L1 e da perda de IoU generalizada e invariante à escala.loss_dict (
Dict, opcional) — Um dicionário contendo as perdas individuais. Útil para registro de logs.logits (
torch.Tensorde forma(batch_size, num_queries, num_classes + 1)) — Logits de classificação (incluindo no-object) para todas as queries.pred_boxes (
torch.Tensorde forma(batch_size, num_queries, 4)) — Coordenadas normalizadas das caixas para todas as queries, representadas como (center_x, center_y, width, height). Esses valores são normalizados em [0, 1], relativos ao tamanho de cada imagem individual no lote (ignorando possível padding). Você pode usarpost_process_object_detection()para recuperar as caixas delimitadoras não normalizadas.auxiliary_outputs (
list[Dict], opcional) — Opcional, retornado apenas quando as perdas auxiliares são ativadas (ou seja,config.auxiliary_lossestá definido comoTrue) e os rótulos são fornecidos. É uma lista de dicionários contendo as duas chaves acima (logitsepred_boxes) para cada camada do decodificador.last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do decodificador do modelo.decoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
decoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
cross_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
encoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
>>> from transformers import AutoImageProcessor, AutoModelForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/conditional-detr-resnet-50")
>>> model = AutoModelForObjectDetection.from_pretrained("microsoft/conditional-detr-resnet-50")

>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)

>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
...     0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
...     box = [round(i, 2) for i in box.tolist()]
...     print(
...         f"Detected {model.config.id2label[label.item()]} with confidence "
...         f"{round(score.item(), 3)} at location {box}"
...     )
Detected remote with confidence 0.833 at location [38.31, 72.1, 177.63, 118.45]
Detected cat with confidence 0.831 at location [9.2, 51.38, 321.13, 469.0]
Detected cat with confidence 0.804 at location [340.3, 16.85, 642.93, 370.95]
Detected remote with confidence 0.683 at location [334.48, 73.49, 366.37, 190.01]
Detected couch with confidence 0.535 at location [0.52, 1.19, 640.35, 475.1]
ConditionalDetrForSegmentation
classe transformers.ConditionalDetrForSegmentation
< source >( config: ConditionalDetrConfig )
Parâmetros
- config (ConditionalDetrConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo CONDITIONAL_DETR (composto por um backbone e um Transformer encoder-decoder) com uma cabeça de segmentação no topo, para tarefas como a panoptic do COCO.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: list[dict] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ConditionalDetrSegmentationOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usandoimage_processor_class. Consulteimage_processor_class.__call__para mais detalhes (processor_classusaimage_processor_classpara processar as imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- decoder_attention_mask (
torch.Tensorde forma(batch_size, num_queries), opcional) — Máscara para evitar a execução de atenção em determinadas consultas de objeto no decoder. Valores de máscara selecionados em[0, 1]:- 1 para consultas que não estão mascaradas,
- 0 para consultas que estão mascaradas.
- encoder_outputs (
torch.Tensor, opcional) — A tupla consiste em (last_hidden_state, opcional:hidden_states, opcional:attentions)last_hidden_statede forma(batch_size, sequence_length, hidden_size), opcional) é uma sequência de hidden-states na saída da última camada do encoder. Usado na cross-attention do decoder. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Mantido para compatibilidade reversa, mas não pode ser usado para segmentação, pois a segmentação requer recursos multiescala do backbone que não estão disponíveis ao contorná-lo com inputs_embeds. - decoder_inputs_embeds (
torch.Tensorde forma(batch_size, num_queries, hidden_size), opcional) — Opcionalmente, em vez de inicializar as consultas com um tensor de zeros, você pode escolher passar diretamente uma representação incorporada. Útil para tarefas que exigem inicialização personalizada das consultas. - labels (
list[Dict]de comprimento(batch_size,), opcional) — Rótulos para o cálculo da perda de correspondência bipartida, perda DICE/F-1 e perda Focal. Lista de dicionários, cada dicionário contendo pelo menos as seguintes 3 chaves: ‘class_labels’, ‘boxes’ e ‘masks’ (os rótulos de classe, as caixas delimitadoras e as máscaras de segmentação de uma imagem no lote, respectivamente). Os próprios rótulos de classe devem ser umtorch.LongTensorde comprimento(number of bounding boxes in the image,), as caixas umtorch.Tensorde forma(number of bounding boxes in the image, 4)e as máscaras umtorch.Tensorde forma(number of bounding boxes in the image, height, width).
Retorna
ConditionalDetrSegmentationOutput ou tuple(torch.Tensor)
Um ConditionalDetrSegmentationOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (None) e das entradas.
O método forward de ConditionalDetrForSegmentation substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelssão fornecidas)) — Perda total como uma combinação linear de uma log-verossimilhança negativa (entropia cruzada) para a previsão de classe e uma perda de caixa delimitadora. Esta última é definida como uma combinação linear da perda L1 e da perda de IoU generalizada e invariante à escala.loss_dict (
Dict, opcional) — Um dicionário contendo as perdas individuais. Útil para registro de logs.logits (
torch.Tensorde forma(batch_size, num_queries, num_classes + 1)) — Logits de classificação (incluindo no-object) para todas as queries.pred_boxes (
torch.Tensorde forma(batch_size, num_queries, 4)) — Coordenadas normalizadas das caixas para todas as queries, representadas como (center_x, center_y, width, height). Esses valores são normalizados em [0, 1], relativos ao tamanho de cada imagem individual no lote (ignorando possível padding). Você pode usarpost_process_object_detection()para recuperar as caixas delimitadoras não normalizadas.pred_masks (
torch.Tensorde forma(batch_size, num_queries, height/4, width/4)) — Logits das máscaras de segmentação para todas as queries. Consulte tambémpost_process_semantic_segmentation()oupost_process_instance_segmentation()post_process_panoptic_segmentation()para avaliar as máscaras de segmentação semântica, de instância e panóptica, respectivamente.auxiliary_outputs (
list[Dict], opcional) — Opcional, retornado apenas quando as perdas auxiliares são ativadas (ou seja,config.auxiliary_lossestá definido comoTrue) e os rótulos são fornecidos. É uma lista de dicionários contendo as duas chaves acima (logitsepred_boxes) para cada camada do decodificador.last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do decodificador do modelo.decoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
decoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
cross_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
encoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
>>> import io
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> import numpy

>>> from transformers import AutoImageProcessor, ConditionalDetrForSegmentation
>>> from transformers.image_transforms import rgb_to_id

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/conditional_detr-resnet-50-panoptic")
>>> model = ConditionalDetrForSegmentation.from_pretrained("facebook/conditional_detr-resnet-50-panoptic")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # Use the `post_process_panoptic_segmentation` method of the `image_processor` to retrieve post-processed panoptic segmentation maps
>>> # Segmentation results are returned as a list of dictionaries
>>> result = image_processor.post_process_panoptic_segmentation(outputs, target_sizes=[(300, 500)])

>>> # A tensor of shape (height, width) where each value denotes a segment id, filled with -1 if no segment is found
>>> panoptic_seg = result[0]["segmentation"]
>>> panoptic_seg.shape
torch.Size([300, 500])
>>> # Get prediction score and segment_id to class_id mapping of each segment
>>> panoptic_segments_info = result[0]["segments_info"]
>>> len(panoptic_segments_info)
5