
Transformers documentation
SegFormer
Este modelo foi publicado no HF papers em 2021-05-31 e contribuído para o Hugging Face Transformers em 2021-10-28.
SegFormer
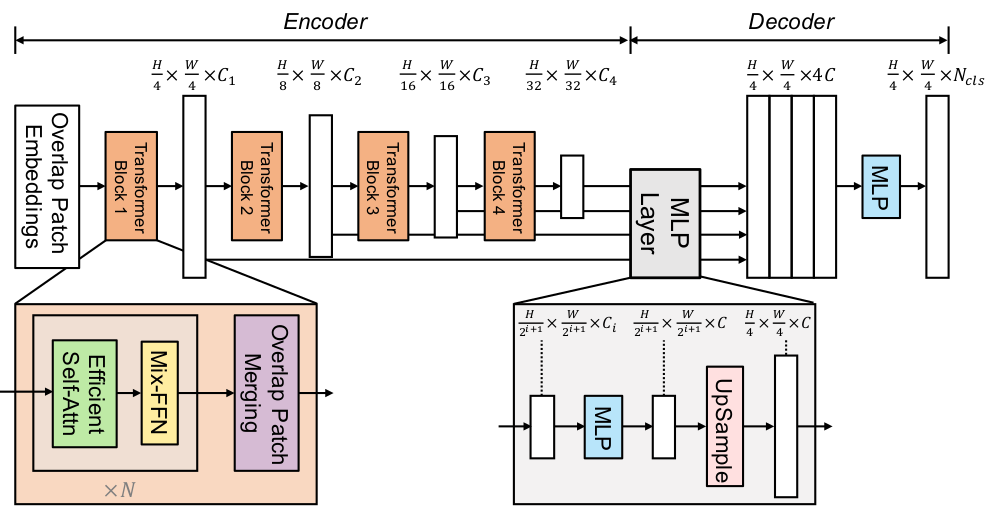
SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers é um modelo de segmentação semântica que combina um codificador Transformer hierárquico (Mix Transformer, MiT) com um decodificador leve baseado inteiramente em MLP. Ele evita codificações posicionais e decodificadores complexos, alcançando desempenho de estado da arte em benchmarks como ADE20K e Cityscapes. Esse design simples e leve é mais eficiente e escalável.
A figura abaixo ilustra a arquitetura do SegFormer.
Você pode encontrar todos os checkpoints originais do SegFormer na organização NVIDIA.
Este modelo foi contribuído por nielsr.
Clique nos modelos SegFormer na barra lateral à direita para ver mais exemplos de como aplicar o SegFormer a diferentes tarefas de visão.
O exemplo abaixo demonstra segmentação semântica com Pipeline ou a classe AutoModel.
from transformers import pipeline


pipeline = pipeline(task="image-segmentation", model="nvidia/segformer-b0-finetuned-ade-512-512")
pipeline("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg")import requests
from PIL import Image
from transformers import AutoModelForSemanticSegmentation, AutoProcessor
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = AutoProcessor.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512")
model = AutoModelForSemanticSegmentation.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512", device_map="auto")
inputs = processor(images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
logits = outputs.logits # shape [batch, num_labels, height, width]Observações
O SegFormer funciona com qualquer tamanho de entrada, preenchendo as entradas para que sejam divisíveis por
config.patch_sizes.A etapa de pré-processamento mais importante é recortar e preencher aleatoriamente todas as imagens até o mesmo tamanho (como 512x512 ou 640x640) e normalizá-las em seguida.
Alguns conjuntos de dados (ADE20k) usam o índice
0na segmentação anotada como fundo, mas não incluem a classe “background” em seus rótulos. O argumentodo_reduce_labelsemSegformerForImageProcessoré usado para reduzir todos os rótulos em1. Para garantir que nenhuma perda seja calculada para a classe de fundo, ele substitui0nos mapas anotados por255, que é oignore_indexda função de perda.Outros conjuntos de dados podem incluir uma classe de fundo e rótulo, caso em que
do_reduce_labelsdeve serFalse.
from transformers import SegformerImageProcessor


processor = SegformerImageProcessor(do_reduce_labels=True)
Recursos
- Código original do SegFormer (NVlabs)
- Post de blog sobre fine-tuning
- Notabooks de tutorial (Niels Rogge)
- Espaço de demonstração do Hugging Face
SegformerConfig
classe transformers.SegformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3num_encoder_blocks: int = 4depths: list[int] | tuple[int, ...] = (2, 2, 2, 2)sr_ratios: list[int] | tuple[int, ...] = (8, 4, 2, 1)hidden_sizes: list[int] | tuple[int, ...] = (32, 64, 160, 256)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)num_attention_heads: list[int] | tuple[int, ...] = (1, 2, 5, 8)mlp_ratios: list[int] | tuple[int, ...] = (4, 4, 4, 4)hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0classifier_dropout_prob: float | int = 0.1initializer_range: float = 0.02drop_path_rate: float | int = 0.1layer_norm_eps: float = 1e-06decoder_hidden_size: int = 256semantic_loss_ignore_index: int = 255reshape_last_stage: bool = True )
Parâmetros
- num_channels (
int, opcional, padrão3) — O número de canais de entrada. - num_encoder_blocks (
int, opcional, padrão 4) — O número de blocos do codificador (ou seja, os estágios no codificador do Mix Transformer). - depths (
list[int], opcional, padrão[2, 2, 2, 2]) — O número de camadas em cada bloco do codificador. - sr_ratios (
list[int], opcional, padrão[8, 4, 2, 1]) — Razões de redução de sequência em cada bloco do codificador. - hidden_sizes (
Union[list[int], tuple[int, ...]], opcional, padrão(32, 64, 160, 256)) — Dimensão (tamanho oculto) em cada etapa do modelo. - patch_sizes (
list[int], opcional, padrão[7, 3, 3, 3]) — Tamanho do patch antes de cada bloco do codificador. - strides (
list[int], opcional, padrão[4, 2, 2, 2]) — Passo antes de cada bloco do codificador. - num_attention_heads (
Union[list[int], tuple[int, ...]], opcional, padrão(1, 2, 5, 8)) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - mlp_ratios (
list[int], opcional, padrão[4, 4, 4, 4]) — Proporção entre o tamanho da camada oculta e o tamanho da camada de entrada dos Mix FFNs nos blocos do codificador. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - hidden_dropout_prob (
Union[float, int], opcional, padrão0.0) — A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no encoder e no pooler. - attention_probs_dropout_prob (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - classifier_dropout_prob (
Union[float, int], opcional, padrão0.1) — A taxa de dropout para o classificador. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - drop_path_rate (
Union[float, int], opcional, padrão0.1) — Taxa de drop path para a fusão de patches. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada. - decoder_hidden_size (
int, opcional, padrão256) — Dimensão das representações ocultas. - semantic_loss_ignore_index (
int, opcional, padrão255) — O índice que é ignorado pela função de perda do modelo de segmentação semântica. - reshape_last_stage (
bool, opcional, padrão True) — Se deve redimensionar as saídas do último estágio
Esta é a classe de configuração para armazenar a configuração de um SegformerModel. Ela é usada para instanciar um modelo Segformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do ByteDance-Seed/Seed-OSS-36B-Instruct
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import SegformerModel, SegformerConfig

>>> # Initializing a SegFormer nvidia/segformer-b0-finetuned-ade-512-512 style configuration
>>> configuration = SegformerConfig()

>>> # Initializing a model from the nvidia/segformer-b0-finetuned-ade-512-512 style configuration
>>> model = SegformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SegformerImageProcessor
classe transformers.SegformerImageProcessor
< source >( **kwargs: *<class 'transformers.models.segformer.image_processing_segformer.SegformerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'height' -- 512, 'width': 512}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoTrue) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrãoNone) — Tamanho da imagem de saída após aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional, padrãoNone) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - do_reduce_labels (
bool, kwargs, opcional, padrãoself.do_reduce_labels) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
Constrói um processador de imagem SegformerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.segformer.image_processing_segformer.SegformerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação a serem pré-processados. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - do_reduce_labels (
bool, kwargs, opcional, padrãoself.do_reduce_labels) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (SegformerForSemanticSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[Tuple]de comprimentobatch_size, opcional) — Lista de tuplas correspondentes ao tamanho final solicitado (altura, largura) de cada previsão. Se não definido, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de SegformerForSemanticSegmentation em mapas de segmentação semântica.
SegformerImageProcessorPil
classe transformers.SegformerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.segformer.image_processing_pil_segformer.SegformerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'height' -- 512, 'width': 512}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoTrue) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrãoNone) — Tamanho da imagem de saída após aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional, padrãoNone) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - do_reduce_labels (
bool, kwargs, opcional, padrãoself.do_reduce_labels) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
Constrói um processador de imagem SegformerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.segformer.image_processing_pil_segformer.SegformerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação a serem pré-processados. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - do_reduce_labels (
bool, kwargs, opcional, padrãoself.do_reduce_labels) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (SegformerForSemanticSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[Tuple]de comprimentobatch_size, opcional) — Lista de tuplas correspondentes ao tamanho final solicitado (altura, largura) de cada previsão. Se não definido, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de SegformerForSemanticSegmentation em mapas de segmentação semântica.
SegformerModel
classe transformers.SegformerModel
< source >( config: SegformerConfig )
Parâmetros
- config (SegformerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Segformer puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensor**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SegformerImageProcessor. Consulte SegformerImageProcessor.call() para obter detalhes (processor_classusa SegformerImageProcessor para processar imagens).
Retorna
BaseModelOutput ou tuple(torch.Tensor)
Um BaseModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (SegformerConfig) e das entradas.
O método forward do SegformerModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
SegformerDecodeHead
SegformerForImageClassification
classe transformers.SegformerForImageClassification
< source >( config: SegformerConfig )
Parâmetros
- config (SegformerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo SegFormer com uma cabeça de classificação de imagem no topo (uma camada linear sobre os estados ocultos finais), por exemplo, para o ImageNet.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SegFormerImageClassifierOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensors correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SegformerImageProcessor. Consulte SegformerImageProcessor.call() para mais detalhes (processor_classusa SegformerImageProcessor para processar imagens). - labels (
torch.LongTensorde forma(batch_size,), opcional) — Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels == 1, uma perda de regressão é calculada (perda de erro quadrático médio); seconfig.num_labels > 1, uma perda de classificação é calculada (entropia cruzada).
Retorna
SegFormerImageClassifierOutput ou tuple(torch.Tensor)
Um SegFormerImageClassifierOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (SegformerConfig) e das entradas.
O método forward de SegformerForImageClassification substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).logits (
torch.Tensorde forma(batch_size, config.num_labels)) — Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo na saída de cada estágio.attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, patch_size, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from transformers import AutoImageProcessor, SegformerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("ByteDance-Seed/Seed-OSS-36B-Instruct")
>>> model = SegformerForImageClassification.from_pretrained("ByteDance-Seed/Seed-OSS-36B-Instruct")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
SegformerForSemanticSegmentation
classe transformers.SegformerForSemanticSegmentation
< source >( config: SegformerConfig )
Parâmetros
- config (SegformerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo SegFormer: transformer com uma cabeça de decodificação totalmente MLP no topo, por exemplo, para ADE20k, CityScapes.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorlabels: typing.Optional[torch.LongTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SemanticSegmenterOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SegformerImageProcessor. Consulte SegformerImageProcessor.call() para obter detalhes (processor_classusa SegformerImageProcessor para processar imagens). - labels (
torch.LongTensorde forma(batch_size, height, width), opcional) — Mapas de segmentação semântica de verdade para o cálculo da perda. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels > 1, uma perda de classificação é calculada (Cross-Entropy).
Retorna
SemanticSegmenterOutput ou tuple(torch.Tensor)
Um SemanticSegmenterOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (SegformerConfig) e das entradas.
O método forward de SegformerForSemanticSegmentation substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).logits (
torch.Tensorde forma(batch_size, config.num_labels, logits_height, logits_width)) — Pontuações de classificação para cada pixel.Os logits retornados não necessariamente têm o mesmo tamanho que os
pixel_valuespassados como entradas. Isso é para evitar fazer duas interpolações e perder alguma qualidade quando um usuário precisa redimensionar os logits para o tamanho da imagem original como pós-processamento. Você deve sempre verificar a forma dos seus logits e redimensioná-los conforme necessário.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, patch_size, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, patch_size, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import AutoImageProcessor, SegformerForSemanticSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> image_processor = AutoImageProcessor.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512")
>>> model = SegformerForSemanticSegmentation.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits  # shape (batch_size, num_labels, height/4, width/4)
>>> list(logits.shape)
[1, 150, 128, 128]