
Transformers documentation
Dilated Neighborhood Attention Transformer
Este modelo foi publicado no HF papers em 2022-09-29 e contribuído para o Hugging Face Transformers em 2022-11-18.
Dilated Neighborhood Attention Transformer
Visão geral
O DiNAT foi proposto em Dilated Neighborhood Attention Transformer por Ali Hassani e Humphrey Shi.
Ele estende o NAT ao adicionar um padrão de Dilated Neighborhood Attention para capturar o contexto global, e demonstra melhorias significativas de desempenho em relação a ele.
O resumo do artigo é o seguinte:
Os Transformers estão se tornando rapidamente uma das arquiteturas de deep learning mais amplamente aplicadas entre modalidades, domínios e tarefas. Na visão computacional, além dos esforços contínuos em transformers puros, os transformers hierárquicos também ganharam atenção significativa, graças ao seu desempenho e à fácil integração em frameworks existentes. Esses modelos geralmente empregam mecanismos de atenção localizados, como a Neighborhood Attention (NA) de janela deslizante ou a Shifted Window Self Attention do Swin Transformer. Embora eficazes na redução da complexidade quadrática da self attention, a atenção local enfraquece duas das propriedades mais desejáveis da self attention: a modelagem de interdependências de longo alcance e o campo receptivo global. Neste artigo, introduzimos a Dilated Neighborhood Attention (DiNA), uma extensão natural, flexível e eficiente da NA que pode capturar mais contexto global e expandir campos receptivos exponencialmente sem custo adicional. A atenção local da NA e a atenção global esparsa da DiNA se complementam, e, portanto, introduzimos o Dilated Neighborhood Attention Transformer (DiNAT), um novo transformer hierárquico de visão construído sobre ambos. As variantes do DiNAT apresentam melhorias significativas em relação a baselines fortes, como NAT, Swin e ConvNeXt. Nosso modelo grande é mais rápido e supera seu equivalente Swin em 1,5% de box AP na detecção de objetos COCO, 1,3% de mask AP na segmentação de instâncias COCO e 1,1% de mIoU na segmentação semântica ADE20K. Junto com novos frameworks, nossa variante grande é o novo modelo de segmentação panóptica state of the art no COCO (58,2 PQ) e ADE20K (48,5 PQ), e o modelo de segmentação de instâncias no Cityscapes (44,5 AP) e ADE20K (35,4 AP) (sem dados extras). Ele também iguala os modelos especializados de segmentação semântica state of the art no ADE20K (58,2 mIoU) e ocupa a segunda posição no Cityscapes (84,5 mIoU) (sem dados extras).
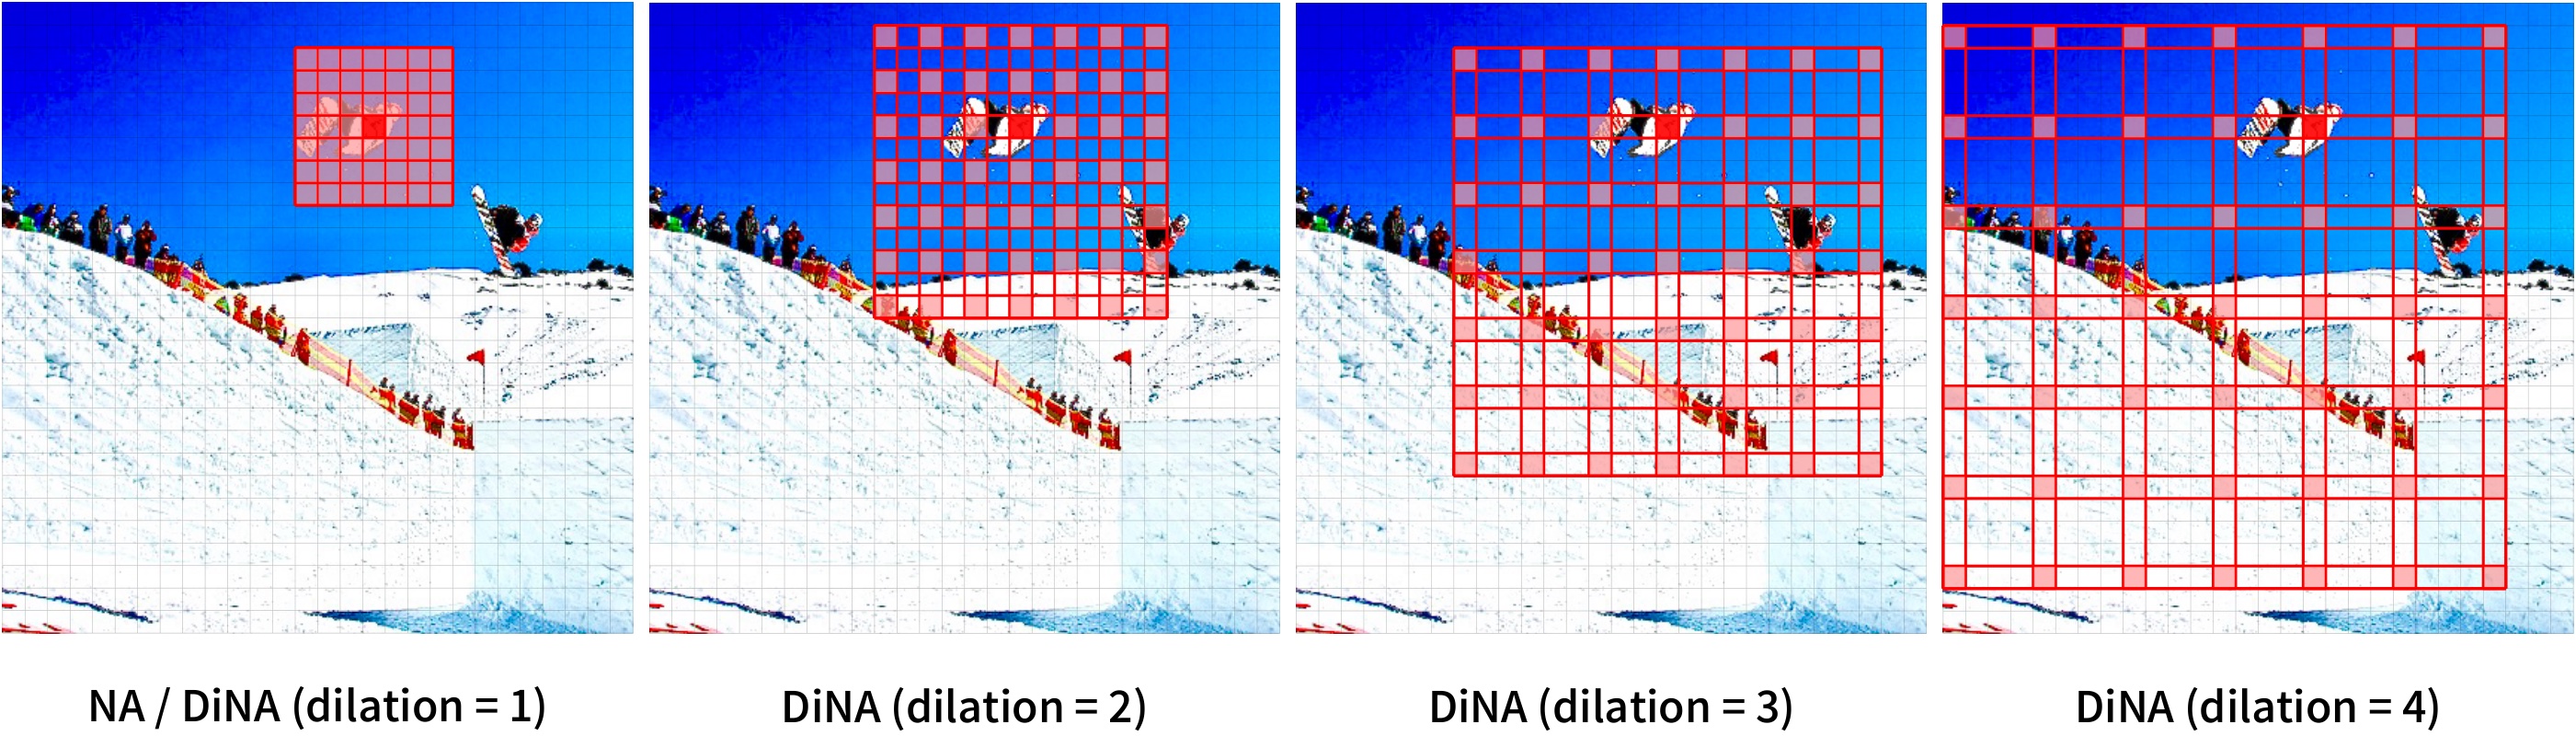 Neighborhood Attention with different dilation values.
Taken from the original paper.
Este modelo foi contribuído por Ali Hassani. O código original pode ser encontrado aqui.
Dicas de uso
O DiNAT pode ser usado como backbone. Quando output_hidden_states = True,
ele exibirá tanto hidden_states quanto reshaped_hidden_states. O reshaped_hidden_states tem a forma (batch, num_channels, height, width) em vez de (batch_size, height, width, num_channels).
Observações:
- O DiNAT depende da implementação de Neighborhood Attention e Dilated Neighborhood Attention do NATTEN.
Você pode instalá-lo com wheels pré-compilados para Linux consultando shi-labs.com/natten, ou compilá-lo no seu sistema executando
pip install natten. Observe que a segunda opção provavelmente levará tempo para compilar. O NATTEN ainda não suporta dispositivos Windows. - No momento, apenas o tamanho de patch 4 é suportado.
Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o DiNAT.
- DinatForImageClassification é suportado por este notebook.
- Veja também: Guia da tarefa de classificação de imagens
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
DinatConfig
classe transformers.DinatConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonepatch_size: int | list[int] | tuple[int, int] = 4num_channels: int = 3embed_dim: int = 64depths: list[int] | tuple[int, ...] = (3, 4, 6, 5)num_heads: list[int] | tuple[int, ...] = (2, 4, 8, 16)kernel_size: int = 7dilations: list | tuple | None = Nonemlp_ratio: float = 3.0qkv_bias: bool = Truehidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0drop_path_rate: float | int = 0.1hidden_act: str = 'gelu'initializer_range: float = 0.02layer_norm_eps: float = 1e-05layer_scale_init_value: float = 0.0_out_features: list[str] | None = None_out_indices: list[int] | None = None )
Parâmetros
- patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão4) — O tamanho (resolução) de cada patch. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - embed_dim (
int, opcional, padrão64) — Dimensão dos embeddings e dos estados ocultos. - depths (
Union[list[int], tuple[int, ...]], opcional, padrão(3, 4, 6, 5)) — Profundidade de cada camada no Transformer. - num_heads (
Union[list[int], tuple[int, ...]], opcional, padrão(2, 4, 8, 16)) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - kernel_size (
int, opcional, padrão7) — O tamanho do kernel de convolução. - dilations (
list[list[int]], opcional, padrão[[1, 8, 1], [1, 4, 1, 4], [1, 2, 1, 2, 1, 2], [1, 1, 1, 1, 1]]) — Valor de dilatação de cada camada NA no codificador do Transformer. - mlp_ratio (
float, opcional, padrão3.0) — Proporção entre a dimensão oculta do MLP e a dimensão de incorporação. - qkv_bias (
bool, opcional, padrãoTrue) — Se deve adicionar um viés às queries, keys e values. - hidden_dropout_prob (
Union[float, int], opcional, padrão0.0) — A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no encoder e no pooler. - attention_probs_dropout_prob (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - drop_path_rate (
Union[float, int], opcional, padrão0.1) — Taxa de drop path para a fusão de patches. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - layer_scale_init_value (
float, opcional, padrão0.0) — Escala a ser usada nas camadas de autoatenção. 0.1 para base, 1e-6 para grande. Defina 0 para desativar a escala da camada.
Esta é a classe de configuração para armazenar a configuração de um DinatModel. Ela é usada para instanciar um modelo Dinat de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do shi-labs/dinat-mini-in1k-224
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import DinatConfig, DinatModel

>>> # Initializing a Dinat shi-labs/dinat-mini-in1k-224 style configuration
>>> configuration = DinatConfig()

>>> # Initializing a model (with random weights) from the shi-labs/dinat-mini-in1k-224 style configuration
>>> model = DinatModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
DinatModel
classe transformers.DinatModel
< source >( config: DinatConfigadd_pooling_layer = True )
Parâmetros
- config (DinatConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
- add_pooling_layer (
bool, opcional, padrãoTrue) — Se deve adicionar uma camada de pooling
O modelo Dinat básico, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DinatModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ViTImageProcessor. Consulte ViTImageProcessor.call() para mais detalhes (processor_classusa ViTImageProcessor para processar as imagens). - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
DinatModelOutput ou tuple(torch.Tensor)
Um DinatModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (DinatConfig) e das entradas.
O método forward do DinatModel sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.Tensorde forma(batch_size, hidden_size), opcional, retornado quandoadd_pooling_layer=Trueé passado) — Pooling médio do estado oculto da última camada.hidden_states (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
reshaped_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, hidden_size, height, width).Estados ocultos do modelo na saída de cada camada, mais as saídas do embedding inicial, redimensionados para incluir as dimensões espaciais.
DinatForImageClassification
classe transformers.DinatForImageClassification
< source >( config: DinatConfig )
Parâmetros
- config (DinatConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo Dinat transformer com uma cabeça de classificação de imagem no topo (uma camada linear sobre o estado oculto final do token [CLS]), por exemplo, para o ImageNet.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DinatImageClassifierOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ViTImageProcessor. Consulte ViTImageProcessor.call() para mais detalhes (processor_classusa ViTImageProcessor para processar as imagens). - labels (
torch.LongTensorde forma(batch_size,), opcional) — Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels == 1, uma perda de regressão é calculada (perda de erro quadrático médio); seconfig.num_labels > 1, uma perda de classificação é calculada (entropia cruzada). - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
DinatImageClassifierOutput ou tuple(torch.Tensor)
Um DinatImageClassifierOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (DinatConfig) e das entradas.
O método forward de DinatForImageClassification sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).logits (
torch.Tensorde forma(batch_size, config.num_labels)) — Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).hidden_states (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
reshaped_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, hidden_size, height, width).Estados ocultos do modelo na saída de cada camada, mais as saídas do embedding inicial, redimensionados para incluir as dimensões espaciais.
Exemplo:
>>> from transformers import AutoImageProcessor, DinatForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("shi-labs/dinat-mini-in1k-224")
>>> model = DinatForImageClassification.from_pretrained("shi-labs/dinat-mini-in1k-224")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...