
Transformers documentation
MaskFormer
Este modelo foi publicado em papers do HF em 2021-07-13 e contribuído para o Hugging Face Transformers em 2022-03-02.
MaskFormer
Este é um modelo introduzido recentemente, portanto a API não foi testada extensivamente. Pode haver alguns bugs ou pequenas mudanças que quebram a compatibilidade para corrigir no futuro. Se você notar algo estranho, abra uma Github Issue.
Visão geral
O modelo MaskFormer foi proposto em Per-Pixel Classification is Not All You Need for Semantic Segmentation por Bowen Cheng, Alexander G. Schwing e Alexander Kirillov. O MaskFormer aborda a segmentação semântica com um paradigma de classificação de máscaras, em vez de realizar a classificação clássica em nível de pixel.
O resumo do artigo é o seguinte:
As abordagens modernas tipicamente formulam a segmentação semântica como uma tarefa de classificação por pixel, enquanto a segmentação em nível de instância é tratada com uma classificação de máscaras alternativa. Nossa principal intuição: a classificação de máscaras é suficientemente geral para resolver tanto tarefas de segmentação semântica quanto em nível de instância de forma unificada, usando exatamente o mesmo modelo, perda e procedimento de treinamento. Seguindo essa observação, propomos o MaskFormer, um modelo simples de classificação de máscaras que prevê um conjunto de máscaras binárias, cada uma associada a uma única previsão global de rótulo de classe. No geral, o método baseado em classificação de máscaras proposto simplifica o cenário de abordagens eficazes para tarefas de segmentação semântica e panótica e mostra excelentes resultados empíricos. Em particular, observamos que o MaskFormer supera as linhas de base de classificação por pixel quando o número de classes é grande. Nosso método baseado em classificação de máscaras supera tanto os modelos atuais de estado da arte em segmentação semântica (55,6 mIoU no ADE20K) quanto em segmentação panótica (52,7 PQ no COCO).
A figura abaixo ilustra a arquitetura do MaskFormer. Retirada do artigo original.
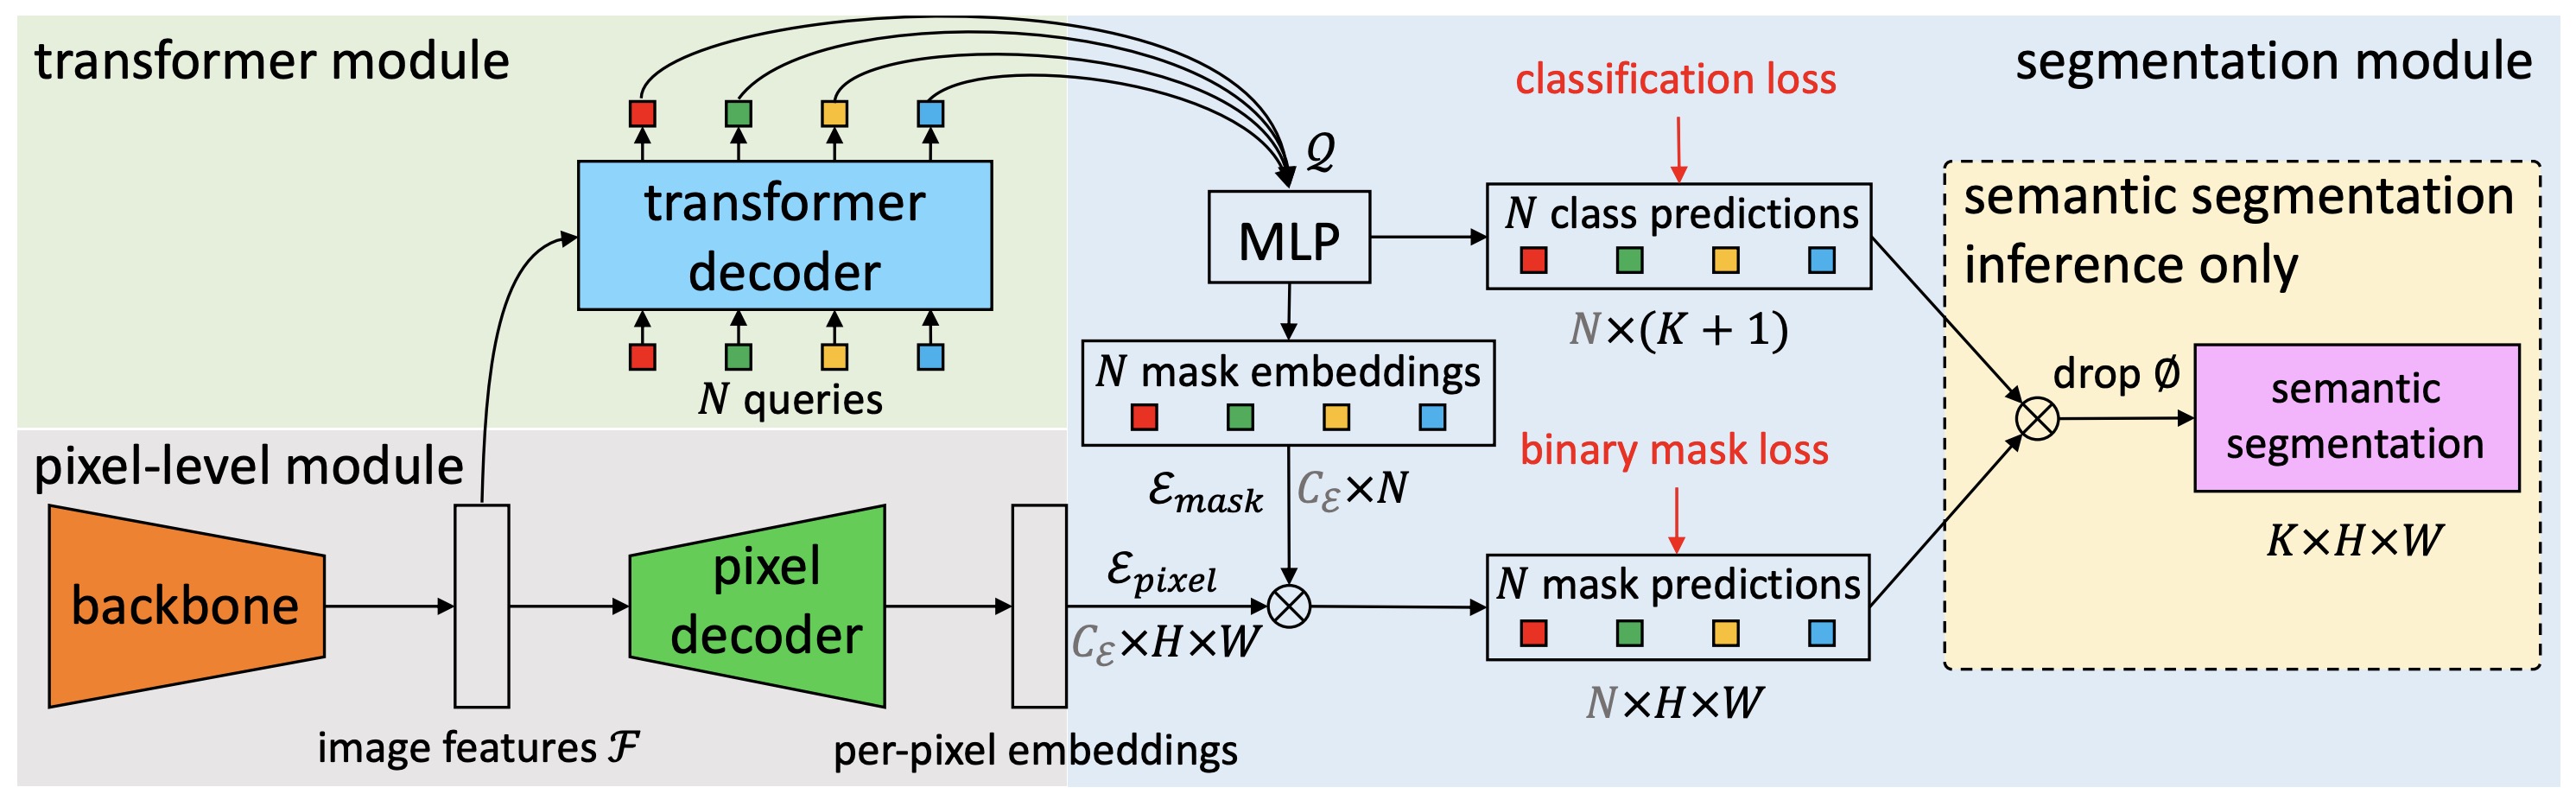
Este modelo foi contribuído por francesco. O código original pode ser encontrado aqui.
Dicas de uso
- O decodificador Transformer do MaskFormer é idêntico ao decodificador do DETR. Durante o treinamento, os autores do DETR constataram que era útil usar perdas auxiliares no decodificador, especialmente para ajudar o modelo a produzir o número correto de objetos de cada classe. Se você definir o parâmetro
use_auxiliary_lossde MaskFormerConfig comoTrue, redes neurais feedforward de previsão e perdas húngaras são adicionadas após cada camada do decodificador (com os FFNs compartilhando parâmetros). - Se você deseja treinar o modelo em um ambiente distribuído em vários nós, é necessário atualizar a função
get_num_masksdentro da classeMaskFormerLossemmodeling_maskformer.py. Ao treinar em vários nós, esse valor deve ser definido como o número médio de máscaras de referência entre todos os nós, conforme pode ser visto na implementação original aqui. - É possível usar MaskFormerImageProcessor para preparar as imagens e os alvos opcionais para o modelo.
- Para obter a segmentação final, dependendo da tarefa, você pode chamar post_process_semantic_segmentation() ou post_process_panoptic_segmentation(). Ambas as tarefas podem ser resolvidas usando a saída de MaskFormerForInstanceSegmentation; a segmentação panótica aceita um argumento opcional
label_ids_to_fusepara fundir instâncias do objeto/alvo (por exemplo, céu).
Recursos
- Todos os notebooks que ilustram a inferência, bem como o ajuste fino em dados personalizados com o MaskFormer, podem ser encontrados aqui.
Saídas específicas do MaskFormer
classe transformers.models.maskformer.modeling_maskformer.MaskFormerModelOutput
< source >( encoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonepixel_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonetransformer_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: tuple[torch.Tensor] | None = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = None )
Parâmetros
- encoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo codificador (backbone). - pixel_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador de pixels (FPN). - transformer_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador transformer. - encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, sequence_length, hidden_size). Hidden-states (também chamados de feature maps) do transformer decoder na saída de cada estágio. - hidden_states
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensorcontendoencoder_hidden_states,pixel_decoder_hidden_statesedecoder_hidden_states - hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Classe para as saídas de MaskFormerModel. Esta classe retorna todos os estados ocultos necessários para calcular os logits.
classe transformers.models.maskformer.modeling_maskformer.MaskFormerForInstanceSegmentationOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneclass_queries_logits: typing.Optional[torch.Tensor] = Nonemasks_queries_logits: typing.Optional[torch.Tensor] = Noneauxiliary_logits: typing.Optional[torch.Tensor] = Noneencoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonepixel_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonetransformer_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: tuple[torch.Tensor] | None = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = None )
Parâmetros
- loss (
torch.Tensor, opcional) — A perda calculada, retornada quando os rótulos estão presentes. - class_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, num_labels + 1)que representa as classes propostas para cada query. Observe que o+ 1é necessário porque incorporamos a classe nula. - masks_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, height, width)representando as máscaras propostas para cada query. - auxiliary_logits (
Dict[str, torch.Tensor], opcional, retornado quandooutput_auxiliary_logits=True) — Dicionário contendo as previsões auxiliares para cada camada do decodificador quando as perdas auxiliares estão habilitadas. - encoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo codificador (backbone). - pixel_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador de pixels (FPN). - transformer_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador transformer. - encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada etapa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos do decodificador do transformer na saída de cada etapa. - hidden_states
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensorcontendoencoder_hidden_states,pixel_decoder_hidden_statesedecoder_hidden_states. - hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Classe para as saídas de MaskFormerForInstanceSegmentation.
Esta saída pode ser passada diretamente para post_process_semantic_segmentation() ou post_process_instance_segmentation() ou post_process_panoptic_segmentation(), dependendo da tarefa. Consulte [`~MaskFormerImageProcessor] para obter detalhes sobre o uso.
MaskFormerDetrConfig
classe transformers.MaskFormerDetrConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_channels: int = 3num_queries: int = 100encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8encoder_layerdrop: float | int = 0.0decoder_layerdrop: float | int = 0.0activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0init_std: float = 0.02init_xavier_std: float = 1.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'dilation: bool = Falseclass_cost: int = 1bbox_cost: int = 5giou_cost: int = 2mask_loss_coefficient: int = 1dice_loss_coefficient: int = 1bbox_loss_coefficient: int = 5giou_loss_coefficient: int = 2eos_coefficient: float = 0.1 )
Parâmetros
- is_encoder_decoder (
bool, opcional, padrãoTrue) — Indica se o modelo é usado como encoder/decoder ou não. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — A configuração do modelo backbone. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - num_queries (
int, opcional, padrão 100) — Número de consultas de objetos, ou seja, slots de detecção. Este é o número máximo de objetos que o ConditionalDetrModel pode detectar em uma única imagem. Para o COCO, recomendamos 100 consultas. - encoder_layers (
int, opcional, padrão6) — Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - encoder_ffn_dim (
int, opcional, padrão2048) — Dimensão da camada “intermediária” (frequentemente chamada de feed-forward) no encoder. - encoder_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no codificador do Transformer. - decoder_layers (
int, opcional, padrão6) — Número de camadas ocultas no decodificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - decoder_ffn_dim (
int, opcional, padrão2048) — Dimensão da camada “intermediária” (frequentemente chamada de feed-forward) no decoder. - decoder_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - encoder_layerdrop (
Union[float, int], opcional, padrão0.0) — A probabilidade de LayerDrop para o codificador. Consulte o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - decoder_layerdrop (
Union[float, int], opcional, padrão0.0) — A probabilidade de LayerDrop para o decoder. Consulte o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - activation_function (
str, opcional, padrãorelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - d_model (
int, opcional, padrão256) — Tamanho das camadas do codificador e da camada pooler. - dropout (
Union[float, int], opcional, padrão0.1) — A proporção para todas as camadas de dropout. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - activation_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as ativações dentro da camada totalmente conectada. - init_std (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - init_xavier_std (
float, opcional, padrão1.0) — Fator de escala usado na inicialização Xavier dos pesos de atenção cruzada. - auxiliary_loss (
bool, opcional, padrãoFalse) — Indica se as perdas de decodificação auxiliares (perdas em cada camada do decodificador) devem ser utilizadas. - position_embedding_type (
str, opcional, padrão"sine") — Tipo de embeddings de posição a ser usado sobre os recursos da imagem. Um de"sine"ou"learned". - dilation (
bool, opcional, padrãoFalse) — Indica se a stride deve ser substituída por dilation no último bloco convolucional (DC5). Suportado apenas quandouse_timm_backbone=True. - class_cost (
int, opcional, padrão1) — Peso relativo do erro de classificação no custo de correspondência húngara. - bbox_cost (
int, opcional, padrão5) — Peso relativo do erro de caixa delimitadora L1 no custo de correspondência húngara. - giou_cost (
int, opcional, padrão2) — Peso relativo da perda de IoU generalizada no custo de correspondência húngara. - mask_loss_coefficient (
int, opcional, padrão1) — Peso relativo da focal loss na perda de segmentação panótica. - dice_loss_coefficient (
int, opcional, padrão1) — Peso relativo da perda dice na perda de segmentação panótica. - bbox_loss_coefficient (
int, opcional, padrão5) — Peso relativo da perda L1 da caixa delimitadora na perda de segmentação panótica. - giou_loss_coefficient (
int, opcional, padrão2) — Peso relativo da perda de IoU generalizada na perda de segmentação panótica. - eos_coefficient (
float, opcional, padrão0.1) — Peso de classificação relativo da classe 'no-object' na perda de detecção de objetos.
Esta é a classe de configuração para armazenar a configuração de um MaskFormerModel. Ela é usada para instanciar um modelo Maskformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/maskformer-swin-base-ade
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplos:
>>> from transformers import MaskFormerDetrConfig, MaskFormerDetrModel

>>> # Initializing a MASK_FORMER_DETR facebook/mask_former_detr-resnet-50 style configuration
>>> configuration = MaskFormerDetrConfig()

>>> # Initializing a model (with random weights) from the facebook/mask_former_detr-resnet-50 style configuration
>>> model = MaskFormerDetrModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MaskFormerConfig
classe transformers.MaskFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonefpn_feature_size: int = 256mask_feature_size: int = 256no_object_weight: float = 0.1use_auxiliary_loss: bool = Falsebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonedecoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinit_std: float = 0.02init_xavier_std: float = 1.0dice_weight: float = 1.0cross_entropy_weight: float = 1.0mask_weight: float = 20.0output_auxiliary_logits: bool | None = None )
Parâmetros
- fpn_feature_size (
int, opcional, padrão 256) — O tamanho dos recursos da Feature Pyramid Network. - mask_feature_size (
int, opcional, padrão 256) — O tamanho das features das máscaras; esse valor também será usado para especificar o tamanho das features da Feature Pyramid Network. - no_object_weight (
float, opcional, padrão0.1) — Peso de classificação relativo da classe sem objeto na perda de detecção de objetos. - use_auxiliary_loss (
bool, opcional, padrãoFalse) — Se deve calcular a perda usando as previsões intermediárias do decodificador do transformer. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — A configuração do modelo backbone. - decoder_config (
Dict, opcional) — A configuração passada ao modelo de decodificador do transformer; se não for definida, a configuração base paradetr-resnet-50será utilizada. - init_std (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - init_xavier_std (
float, opcional, padrão1.0) — Fator de escala usado na inicialização Xavier dos pesos de atenção cruzada. - dice_weight (
float, opcional, padrão1.0) — Peso relativo da perda dice na perda de segmentação panótica. - cross_entropy_weight (
float, opcional, padrão 1.0) — O peso para a perda de entropia cruzada. - mask_weight (
float, opcional, padrão20.0) — Peso relativo da focal loss na perda de segmentação panótica. - output_auxiliary_logits (
bool, opcional) — Indica se o modelo deve ou não produzir seusauxiliary_logits.
Exceções
ValueError
ValueError— Exceção lançada se o tipo de modelo de backbone selecionado não estiver em["swin"]ou se o tipo de modelo de decoder selecionado não estiver em["detr"]
Esta é a classe de configuração para armazenar a configuração de um MaskFormerModel. Ela é usada para instanciar um modelo Maskformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/maskformer-swin-base-ade
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplos:
>>> from transformers import MaskFormerConfig, MaskFormerModel

>>> # Initializing a MaskFormer facebook/maskformer-swin-base-ade configuration
>>> configuration = MaskFormerConfig()

>>> # Initializing a model (with random weights) from the facebook/maskformer-swin-base-ade style configuration
>>> model = MaskFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MaskFormerImageProcessor
classe transformers.MaskFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.maskformer.image_processing_maskformer.MaskFormerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 800, 'longest_edge': 1333}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
SizeDict, kwargs, opcional) — O tamanho para o qual as imagens devem ser preenchidas (padding). Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - ignore_index (
int, kwargs, opcional) — Rótulo a ser atribuído aos pixels de fundo em mapas de segmentação. Se fornecido, os pixels do mapa de segmentação denotados com 0 (fundo) serão substituídos porignore_index. - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser decrementados em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o fundo e o próprio fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo de fundo será substituído porignore_index. - num_labels (
int, kwargs, opcional) — O número de rótulos no mapa de segmentação. - size_divisor (
int, kwargs, opcional, padrão32) — Alguns backbones exigem que as imagens sejam divisíveis por um determinado número. Se não for fornecido, o valor padrão é o utilizado no Swin Transformer.
Constrói um processador de imagem MaskFormerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.maskformer.image_processing_maskformer.MaskFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], opcional) — Um mapeamento de IDs de instância para IDs semânticos. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
SizeDict, kwargs, opcional) — O tamanho para o qual as imagens devem ser preenchidas (padding). Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - ignore_index (
int, kwargs, opcional) — Rótulo a ser atribuído aos pixels de fundo em mapas de segmentação. Se fornecido, os pixels do mapa de segmentação denotados com 0 (fundo) serão substituídos porignore_index. - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser decrementados em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o fundo e o próprio fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo de fundo será substituído porignore_index. - num_labels (
int, kwargs, opcional) — O número de rótulos no mapa de segmentação. - size_divisor (
int, kwargs, opcional, padrão32) — Alguns backbones exigem que as imagens sejam divisíveis por um determinado número. Se não for fornecido, o valor padrão é o utilizado no Swin Transformer.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (MaskFormerForInstanceSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se deixado como None, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de MaskFormerForInstanceSegmentation em mapas de segmentação semântica. Suporta apenas PyTorch.
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = Falsereturn_binary_maps: bool | None = False ) → list[Dict]
Parâmetros
- outputs (MaskFormerForInstanceSegmentation) — Saídas brutas do modelo.
- threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se deixado como None, as previsões não serão redimensionadas. - return_coco_annotation (
bool, opcional, padrãoFalse) — Se definido comoTrue, os mapas de segmentação são retornados no formato de codificação por comprimento de execução (RLE) do COCO. - return_binary_maps (
bool, opcional, padrãoFalse) — Se definido comoTrue, os mapas de segmentação são retornados como um tensor concatenado de mapas de segmentação binários (um para cada instância detectada).
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — Um tensor de forma
(height, width)em que cada pixel representa umsegment_id, oulist[List]codificação por comprimento de execução (RLE) do mapa de segmentação, se return_coco_annotation estiver definido comoTrue, ou um tensor de forma(num_instances, height, width)se return_binary_maps estiver definido comoTrue. Definido comoNonese nenhuma máscara for encontrada acima dethreshold. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — Um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — Um inteiro que representa o
Converte a saída de MaskFormerForInstanceSegmentationOutput em previsões de segmentação de instâncias. Suporta apenas PyTorch. Se as instâncias puderem se sobrepor, defina return_coco_annotation ou return_binary_maps como True para obter o resultado de segmentação correto.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parâmetros
- outputs (
MaskFormerForInstanceSegmentationOutput) — As saídas de MaskFormerForInstanceSegmentation. - threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - label_ids_to_fuse (
Set[int], opcional) — Os rótulos neste estado terão todas as suas instâncias fundidas em uma única. Por exemplo, podemos afirmar que pode haver apenas um céu em uma imagem, mas várias pessoas, de modo que o ID do rótulo para céu estaria nesse conjunto, mas não o de pessoa. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se deixado como None, as previsões não serão redimensionadas.
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_id, definido comoNonese nenhuma máscara for encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente detarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de MaskFormerForInstanceSegmentationOutput em previsões de segmentação panótica de imagem. Suporta apenas PyTorch.
MaskFormerImageProcessorPil
classe transformers.MaskFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.maskformer.image_processing_pil_maskformer.MaskFormerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 800, 'longest_edge': 1333}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
SizeDict, kwargs, opcional) — O tamanho para o qual as imagens devem ser preenchidas (padding). Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - ignore_index (
int, kwargs, opcional) — Rótulo a ser atribuído aos pixels de fundo em mapas de segmentação. Se fornecido, os pixels do mapa de segmentação denotados com 0 (fundo) serão substituídos porignore_index. - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser decrementados em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o fundo e o próprio fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo de fundo será substituído porignore_index. - num_labels (
int, kwargs, opcional) — O número de rótulos no mapa de segmentação. - size_divisor (
int, kwargs, opcional, padrão32) — Alguns backbones exigem que as imagens sejam divisíveis por um determinado número. Se não for fornecido, o valor padrão é o utilizado no Swin Transformer.
Constrói um processador de imagem MaskFormerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.maskformer.image_processing_pil_maskformer.MaskFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], opcional) — Um mapeamento de IDs de instância para IDs semânticos. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
SizeDict, kwargs, opcional) — O tamanho para o qual as imagens devem ser preenchidas (padding). Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - ignore_index (
int, kwargs, opcional) — Rótulo a ser atribuído aos pixels de fundo em mapas de segmentação. Se fornecido, os pixels do mapa de segmentação denotados com 0 (fundo) serão substituídos porignore_index. - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Indica se todos os valores de rótulo dos mapas de segmentação devem ser decrementados em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o fundo e o próprio fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo de fundo será substituído porignore_index. - num_labels (
int, kwargs, opcional) — O número de rótulos no mapa de segmentação. - size_divisor (
int, kwargs, opcional, padrão32) — Alguns backbones exigem que as imagens sejam divisíveis por um determinado número. Se não for fornecido, o valor padrão é o utilizado no Swin Transformer.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (MaskFormerForInstanceSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se deixado como None, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de MaskFormerForInstanceSegmentation em mapas de segmentação semântica. Suporta apenas PyTorch.
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = Falsereturn_binary_maps: bool | None = False ) → list[Dict]
Parâmetros
- outputs (MaskFormerForInstanceSegmentation) — Saídas brutas do modelo.
- threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se deixado como None, as previsões não serão redimensionadas. - return_coco_annotation (
bool, opcional, padrãoFalse) — Se definido comoTrue, os mapas de segmentação são retornados no formato de codificação por comprimento de execução (RLE) do COCO. - return_binary_maps (
bool, opcional, padrãoFalse) — Se definido comoTrue, os mapas de segmentação são retornados como um tensor concatenado de mapas de segmentação binários (um para cada instância detectada).
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — Um tensor de forma
(height, width)em que cada pixel representa umsegment_id, oulist[List]codificação por comprimento de execução (RLE) do mapa de segmentação, se return_coco_annotation estiver definido comoTrue, ou um tensor de forma(num_instances, height, width)se return_binary_maps estiver definido comoTrue. Definido comoNonese nenhuma máscara for encontrada acima dethreshold. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — Um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — Um inteiro que representa o
Converte a saída de MaskFormerForInstanceSegmentationOutput em previsões de segmentação de instâncias. Suporta apenas PyTorch. Se as instâncias puderem se sobrepor, defina return_coco_annotation ou return_binary_maps como True para obter o resultado de segmentação correto.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parâmetros
- outputs (
MaskFormerForInstanceSegmentationOutput) — As saídas de MaskFormerForInstanceSegmentation. - threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - label_ids_to_fuse (
Set[int], opcional) — Os rótulos neste estado terão todas as suas instâncias fundidas em uma única. Por exemplo, podemos afirmar que pode haver apenas um céu em uma imagem, mas várias pessoas, de modo que o ID do rótulo para céu estaria nesse conjunto, mas não o de pessoa. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se deixado como None, as previsões não serão redimensionadas.
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_id, definido comoNonese nenhuma máscara for encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente detarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de MaskFormerForInstanceSegmentationOutput em previsões de segmentação panótica de imagem. Suporta apenas PyTorch.
MaskFormerModel
classe transformers.MaskFormerModel
< source >( config: MaskFormerConfig )
Parâmetros
- config (MaskFormerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Maskformer básico, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskFormerModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando MaskFormerImageProcessor. Consulte MaskFormerImageProcessor.call() para mais detalhes (processor_classusa MaskFormerImageProcessor para processar as imagens). - pixel_mask (
torch.Tensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
MaskFormerModelOutput ou tuple(torch.Tensor)
Um MaskFormerModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (MaskFormerConfig) e das entradas.
O método forward do MaskFormerModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
encoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo codificador (backbone).pixel_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador de pixels (FPN).transformer_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador transformer.encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio.pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com formato(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio.transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com forma(batch_size, sequence_length, hidden_size). Hidden-states (também chamados de feature maps) do transformer decoder na saída de cada estágio. hidden_statestuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True): Tupla detorch.Tensorcontendoencoder_hidden_states,pixel_decoder_hidden_statesedecoder_hidden_stateshidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import AutoImageProcessor, MaskFormerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on ADE20k semantic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-ade")
>>> model = MaskFormerModel.from_pretrained("facebook/maskformer-swin-base-ade")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = image_processor(image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # the decoder of MaskFormer outputs hidden states of shape (batch_size, num_queries, hidden_size)
>>> transformer_decoder_last_hidden_state = outputs.transformer_decoder_last_hidden_state
>>> list(transformer_decoder_last_hidden_state.shape)
[1, 100, 256]
MaskFormerForInstanceSegmentation
forward
< source >( pixel_values: Tensormask_labels: list[torch.Tensor] | None = Noneclass_labels: list[torch.Tensor] | None = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_auxiliary_logits: bool | None = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskFormerForInstanceSegmentationOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando MaskFormerImageProcessor. Consulte MaskFormerImageProcessor.call() para mais detalhes (processor_classusa MaskFormerImageProcessor para processar as imagens). - mask_labels (
list[torch.Tensor], opcional) — Lista de rótulos de máscara com forma(num_labels, height, width)para ser fornecida a um modelo - class_labels (
list[torch.LongTensor], opcional) — lista de rótulos de classe alvo com formato(num_labels, height, width)para ser fornecida a um modelo. Eles identificam os rótulos demask_labels, por exemplo, o rótulo demask_labels[i][j]seclass_labels[i][j]. - pixel_mask (
torch.Tensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- output_auxiliary_logits (
bool, opcional) — Indica se os logits auxiliares devem ser retornados. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
MaskFormerForInstanceSegmentationOutput ou tuple(torch.Tensor)
Um MaskFormerForInstanceSegmentationOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (MaskFormerConfig) e das entradas.
O método forward de MaskFormerForInstanceSegmentation substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensor, opcional) — A perda calculada, retornada quando os rótulos estão presentes.class_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, num_labels + 1)representando as classes propostas para cada query. Observe que o+ 1é necessário porque incorporamos a classe nula.masks_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, height, width)representando as máscaras propostas para cada consulta.auxiliary_logits (
Dict[str, torch.Tensor], opcional, retornado quandooutput_auxiliary_logits=True) — Dicionário contendo as previsões auxiliares para cada camada do decodificador quando as perdas auxiliares estão habilitadas.encoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo codificador (backbone).pixel_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador de pixels (FPN).transformer_decoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Últimos estados ocultos (mapa de recursos final) do último estágio do modelo de decodificador transformer.encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio.pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com formato(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio.transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada etapa) com forma(batch_size, sequence_length, hidden_size). Hidden-states do decodificador do transformer na saída de cada etapa. hidden_statestuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True): Tupla detorch.Tensorcontendoencoder_hidden_states,pixel_decoder_hidden_statesedecoder_hidden_states.hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
Exemplo de segmentação semântica:
>>> from transformers import AutoImageProcessor, MaskFormerForInstanceSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on ADE20k semantic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-ade")
>>> model = MaskFormerForInstanceSegmentation.from_pretrained("facebook/maskformer-swin-base-ade")

>>> url = (
...     "https://huggingface.co/datasets/hf-internal-testing/fixtures_ade20k/resolve/main/ADE_val_00000001.jpg"
... )
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to image_processor for postprocessing
>>> predicted_semantic_map = image_processor.post_process_semantic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]

>>> # we refer to the demo notebooks for visualization (see "Resources" section in the MaskFormer docs)
>>> list(predicted_semantic_map.shape)
[512, 683]
Exemplo de segmentação panóptica:
>>> from transformers import AutoImageProcessor, MaskFormerForInstanceSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on COCO panoptic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-coco")
>>> model = MaskFormerForInstanceSegmentation.from_pretrained("facebook/maskformer-swin-base-coco")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to image_processor for postprocessing
>>> result = image_processor.post_process_panoptic_segmentation(outputs, target_sizes=[(image.height, image.width)])[0]

>>> # we refer to the demo notebooks for visualization (see "Resources" section in the MaskFormer docs)
>>> predicted_panoptic_map = result["segmentation"]
>>> list(predicted_panoptic_map.shape)
[480, 640]