
Transformers documentation
SAM-HQ
Este modelo foi publicado no HF papers em 2023-06-02 e contribuído para o Hugging Face Transformers em 2025-04-28.
SAM-HQ
Visão geral
O SAM-HQ (High-Quality Segment Anything Model) foi proposto em Segment Anything in High Quality por Lei Ke, Mingqiao Ye, Martin Danelljan, Yifan Liu, Yu-Wing Tai, Chi-Keung Tang, Fisher Yu.
O modelo é uma melhoria em relação ao modelo SAM original, que produz máscaras de segmentação de qualidade significativamente superior, mantendo o design original do SAM, que permite prompts, sua eficiência e sua capacidade de generalização zero-shot.
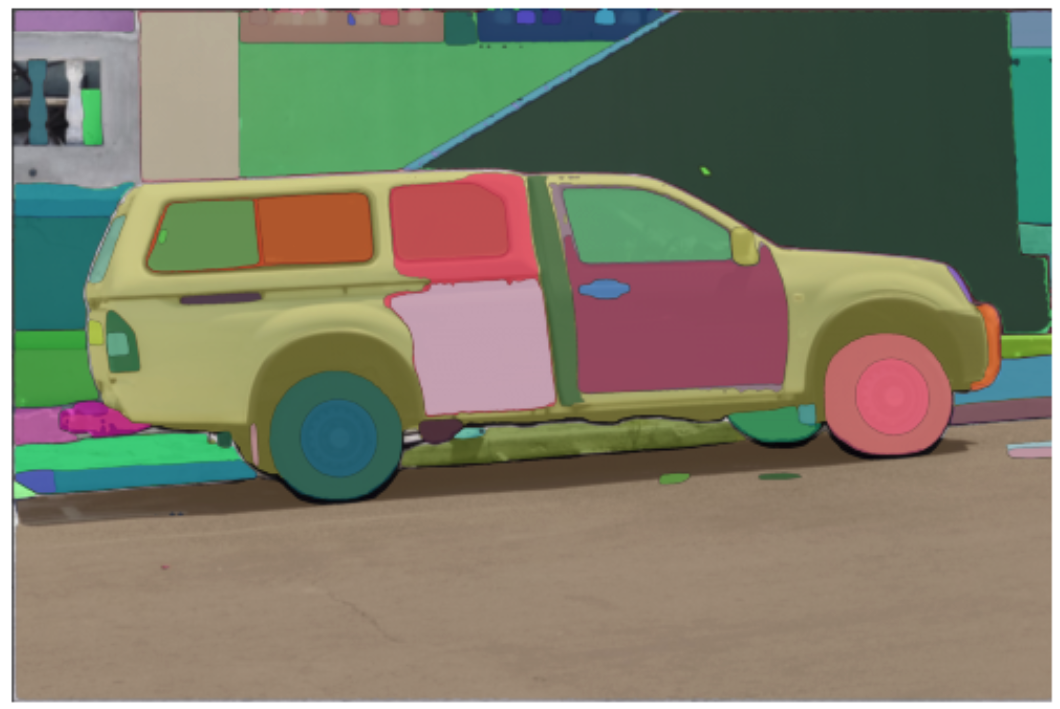
O SAM-HQ introduz várias melhorias importantes em relação ao modelo SAM original:
- Token de Saída de Alta Qualidade: Um token aprendível injetado no decodificador de máscaras do SAM para uma previsão de máscara de maior qualidade
- Fusão de recursos globais e locais: Combina recursos de diferentes estágios do modelo para melhorar os detalhes da máscara
- Dados de treinamento: Utiliza um conjunto de dados cuidadosamente curado com 44K máscaras de alta qualidade, em vez do SA-1B
- Eficiência: Adiciona apenas 0,5% de parâmetros extras, melhorando significativamente a qualidade da máscara
- Capacidade zero-shot: Mantém o forte desempenho zero-shot do SAM, ao mesmo tempo em que melhora a precisão
O resumo do artigo é o seguinte:
O recente Segment Anything Model (SAM) representa um grande avanço na escalabilidade de modelos de segmentação, permitindo capacidades poderosas de zero-shot e prompting flexível. Apesar de ter sido treinado com 1,1 bilhão de máscaras, a qualidade da previsão de máscaras do SAM fica aquém em muitos casos, especialmente ao lidar com objetos que possuem estruturas intrincadas. Propomos o HQ-SAM, que equipa o SAM com a capacidade de segmentar qualquer objeto com precisão, mantendo o design promptável original, a eficiência e a generalização zero-shot do SAM. Nosso design cuidadoso reutiliza e preserva os pesos do modelo pré-treinado do SAM, introduzindo apenas parâmetros e computação adicionais mínimos. Projetamos um High-Quality Output Token aprendível, que é injetado no decodificador de máscaras do SAM e é responsável por prever a máscara de alta qualidade. Em vez de aplicá-lo apenas nos recursos do decodificador de máscaras, primeiro os fundimos com os recursos iniciais e finais do ViT para melhorar os detalhes da máscara. Para treinar os parâmetros aprendíveis introduzidos, compomos um conjunto de dados com 44 mil máscaras de granularidade fina a partir de várias fontes. O HQ-SAM é treinado apenas no conjunto de dados introduzido de 44 mil máscaras, o que leva apenas 4 horas em 8 GPUs.
Dicas:
- O SAM-HQ produz máscaras de maior qualidade do que o modelo SAM original, especialmente para objetos com estruturas intrincadas e detalhes finos
- O modelo prevê máscaras binárias com bordas mais precisas e um melhor tratamento de estruturas finas
- Assim como o SAM, o modelo apresenta melhor desempenho com pontos 2D de entrada e/ou caixas delimitadoras de entrada
- Você pode inserir múltiplos pontos para a mesma imagem e prever uma única máscara de alta qualidade
- O modelo mantém as capacidades de generalização zero-shot do SAM
- O SAM-HQ adiciona apenas ~0,5% de parâmetros adicionais em comparação com o SAM
- O ajuste fino do modelo ainda não é suportado
Este modelo foi contribuído por sushmanth. O código original pode ser encontrado aqui.
Abaixo, há um exemplo de como executar a geração de máscaras a partir de uma imagem e de um ponto 2D:
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Você também pode processar suas próprias máscaras junto com as imagens de entrada no processador para serem passadas ao modelo:
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o SAM-HQ:
- Notebook de demonstração para usar o modelo (em breve)
- Implementação do paper e código: Repositório GitHub do SAM-HQ
SamHQConfig
classe transformers.SamHQConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
Parâmetros
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — O objeto de configuração ou dicionário do backbone de visão. - prompt_encoder_config (Union[
dict,SamHQPromptEncoderConfig], opcional) — Dicionário de opções de configuração usado para inicializar SamHQPromptEncoderConfig. - mask_decoder_config (Union[
dict,SamHQMaskDecoderConfig], opcional) — Dicionário de opções de configuração usado para inicializar SamHQMaskDecoderConfig. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo.
Esta é a classe de configuração para armazenar a configuração de um SamHQModel. Ela é usada para instanciar um modelo Sam Hq de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do syscv-community/sam-hq-vit-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
SamHQVisionConfig
classe transformers.SamHQVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
Parâmetros
- hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - output_channels (
int, opcional, padrão 256) — Dimensão dos canais de saída no Patch Encoder. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão1024) — O tamanho (resolução) de cada imagem. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão16) — O tamanho (resolução) de cada patch. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - initializer_range (
float, opcional, padrão1e-10) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - qkv_bias (
bool, opcional, padrãoTrue) — Se deve adicionar um viés às queries, keys e values. - mlp_ratio (
float, opcional, padrão4.0) — Proporção entre a dimensão oculta do MLP e a dimensão de incorporação. - use_abs_pos (
bool, opcional, padrãoTrue) — Se deve usar embeddings de posição absoluta. - use_rel_pos (
bool, opcional, padrãoTrue) — Se deve usar incorporação de posição relativa. - window_size (
int, opcional, padrão 14) — Tamanho da janela para posição relativa. - global_attn_indexes (
list[int], opcional, padrão[2, 5, 8, 11]) — Os índices das camadas de atenção global. - num_pos_feats (
int, opcional, padrão 128) — A dimensionalidade do embedding de posição. - mlp_dim (
int, opcional) — A dimensionalidade da camada MLP no codificador Transformer. SeNone, o valor padrão émlp_ratio * hidden_size.
Esta é a classe de configuração para armazenar a configuração de um SamHQModel. Ela é usada para instanciar um modelo Sam Hq de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do syscv-community/sam-hq-vit-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import (
...     SamHQVisionConfig,
...     SamHQVisionModel,
... )

>>> # Initializing a SamHQVisionConfig with `"facebook/sam_hq-vit-huge"` style configuration
>>> configuration = SamHQVisionConfig()

>>> # Initializing a SamHQVisionModel (with random weights) from the `"facebook/sam_hq-vit-huge"` style configuration
>>> model = SamHQVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamHQMaskDecoderConfig
classe transformers.SamHQMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06vit_dim: int = 768 )
Parâmetros
- hidden_size (
int, opcional, padrão256) — Dimensão das representações ocultas. - hidden_act (
str, opcional, padrãorelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - mlp_dim (
int, opcional, padrão 2048) — Dimensão da camada “intermediária” (ou seja, feed-forward) no codificador Transformer. - num_hidden_layers (
int, opcional, padrão2) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - attention_downsample_rate (
int, opcional, padrão 2) — A taxa de redução de amostragem da camada de atenção. - num_multimask_outputs (
int, opcional, padrão 3) — O número de saídas do móduloSamMaskDecoder. No paper do Segment Anything, esse valor é definido como 3. - iou_head_depth (
int, opcional, padrão 3) — O número de camadas no módulo de cabeçalho de IoU. - iou_head_hidden_dim (
int, opcional, padrão 256) — A dimensionalidade dos estados ocultos no módulo de cabeçalho de IoU. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada. - vit_dim (
int, opcional, padrão 768) — Dimensão do Vision Transformer (ViT) usado no móduloSamHQMaskDecoder.
Esta é a classe de configuração para armazenar a configuração de um SamHQModel. Ela é usada para instanciar um modelo Sam Hq de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do syscv-community/sam-hq-vit-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
SamHQPromptEncoderConfig
classe transformers.SamHQPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
Parâmetros
- hidden_size (
int, opcional, padrão256) — Dimensão das representações ocultas. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão1024) — O tamanho (resolução) de cada imagem. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão16) — O tamanho (resolução) de cada patch. - mask_input_channels (
int, opcional, padrão 16) — O número de canais a serem fornecidos ao móduloMaskDecoder. - num_point_embeddings (
int, opcional, padrão 4) — O número de incorporações de pontos a serem usadas. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-06) — O epsilon usado pelas camadas de normalização de camada.
Esta é a classe de configuração para armazenar a configuração de um SamHQModel. Ela é usada para instanciar um modelo Sam Hq de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do syscv-community/sam-hq-vit-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
SamHQProcessor
classe transformers.SamHQProcessor
< source >( image_processor )
Constrói um SamHQProcessor que encapsula um processador de imagem em um único processador.
SamHQProcessor oferece todas as funcionalidades de SamImageProcessor. Consulte ~SamImageProcessor para mais informações.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam_hq.processing_sam_hq.SamHQProcessorKwargs'> ) → ~feature_extraction_utils.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], opcional) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - segmentation_maps (
ImageInput, kwargs, opcional) — Mapas de segmentação de referência para processar junto com as imagens de entrada. Esses mapas são usados para fins de treinamento ou avaliação e são redimensionados e normalizados para corresponder às dimensões da imagem processada. - input_points (
NestedList, kwargs, opcional) — Pontos de entrada para segmentação baseada em prompt. Deve ser uma lista aninhada com a estrutura[image_level, object_level, point_level, [x, y]], em que cada ponto é especificado como coordenadas[x, y]no espaço da imagem original. Os pontos são normalizados para o tamanho da imagem de destino antes de serem passados ao modelo. - input_labels (
NestedList, kwargs, opcional) — Rótulos para os pontos de entrada, indicando se cada ponto é do primeiro plano (1) ou do plano de fundo (0). Deve ser uma lista aninhada com a estrutura[image_level, object_level, point_level]. Deve ter a mesma estrutura queinput_points(excluindo a dimensão de coordenadas). - input_boxes (
NestedList, kwargs, opcional) — Caixas delimitadoras para segmentação baseada em prompt. Deve ser uma lista aninhada com a estrutura[image_level, box_level, [x1, y1, x2, y2]], em que cada caixa é especificada pelas coordenadas[x1, y1, x2, y2]no espaço da imagem original. As caixas são normalizadas para o tamanho da imagem de destino antes de serem passadas ao modelo. - point_pad_value (
int, kwargs, opcional, padrãoNone) — O valor usado para preencher os pontos de entrada ao agrupar sequências de comprimentos diferentes. Esse valor marca as posições preenchidas e é preservado durante a normalização de coordenadas para distinguir pontos reais do preenchimento. SeNone, o valor de preenchimento padrão da configuração do processador é utilizado. - mask_size (
dict[str, *kwargs*, int], opcional) — Dicionário que especifica o tamanho da máscara de destino, com as chaves"height"e"width". Isso determina a resolução das máscaras de segmentação de saída geradas pelo modelo. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — Dicionário que especifica o tamanho do preenchimento para máscaras, com as chaves"height"e"width". Isso é usado ao agrupar máscaras de tamanhos diferentes para garantir dimensões consistentes. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
- **kwargs (ProcessingKwargs, opcional) — Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
Retorna
~feature_extraction_utils.BatchFeature
- data (
dict, opcional) — Dicionário de listas/arrays/tensors retornados pelos métodos call/pad (‘input_values’, ‘attention_mask’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização. - skip_tensor_conversion (
list[str]ouset[str], opcional) — Lista ou conjunto de chaves que NÃO devem ser convertidas em tensores, mesmo quandotensor_typefor especificado.
SamHQVisionModel
classe transformers.SamHQVisionModel
< source >( config: SamHQVisionConfig )
Parâmetros
- config (SamHQVisionConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo de visão do SamHQ, sem nenhum cabeçalho ou projeção no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamHQVisionEncoderOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SamImageProcessor. Consulte SamImageProcessor.call() para mais detalhes (SamHQProcessor usa SamImageProcessor para processar imagens).
Retorna
SamHQVisionEncoderOutput ou tuple(torch.Tensor)
Uma SamHQVisionEncoderOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (SamHQConfig) e das entradas.
O método forward do SamHQVisionModel sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
image_embeds (
torch.Tensorde forma(batch_size, output_dim)opcional retornado quando o modelo é inicializado comwith_projection=True) — Os embeddings de imagem obtidos ao aplicar a camada de projeção ao pooler_output.last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do modelo.hidden_states (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor, ...], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
intermediate_embeddings (
list(torch.Tensor), opcional) — Uma lista de embeddings intermediários coletados de determinados blocos dentro do modelo, tipicamente aqueles sem atenção com janela. Cada elemento da lista tem a forma(batch_size, sequence_length, hidden_size). Isso é específico do SAM-HQ e não está presente no SAM base.
SamHQModel
classe transformers.SamHQModel
< source >( config: SamHQConfig )
Parâmetros
- config (SamHQConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Segment Anything Model HQ (SAM-HQ) para gerar máscaras, dado uma imagem de entrada e localizações 2D e caixas delimitadoras opcionais.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Truehq_token_only: bool = Falseattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = Noneintermediate_embeddings: list[torch.Tensor] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> )
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando SamImageProcessor. Consulte SamImageProcessor.call() para mais detalhes (SamHQProcessor usa SamImageProcessor para processar imagens). - input_points (
torch.Tensorde forma(batch_size, num_points, 2)) — Pontos espaciais 2D de entrada, usados pelo codificador de prompt para codificar o prompt. Geralmente, isso resulta em muito melhores resultados. Os pontos podem ser obtidos passando uma lista de listas de listas para o processador, que criará os correspondentes tensorestorchde dimensão 4. A primeira dimensão é o tamanho do lote de imagens, a segunda dimensão é o tamanho do lote de pontos (ou seja, quantas máscaras de segmentação desejamos que o modelo preveja por ponto de entrada), a terceira dimensão é o número de pontos por máscara de segmentação (é possível passar múltiplos pontos para uma única máscara) e a última dimensão são as coordenadas x (vertical) e y (horizontal) do ponto. Se um número diferente de pontos for passado para cada imagem ou para cada máscara, o processador criará pontos “PAD” que corresponderão à coordenada (0, 0) e o cálculo do embedding será ignorado para esses pontos usando os rótulos. - input_labels (
torch.LongTensorde forma(batch_size, point_batch_size, num_points)) — Rótulos de entrada para os pontos, usados pelo codificador de prompt para codificar o prompt. De acordo com a implementação oficial, existem 3 tipos de rótulos1: o ponto é um ponto que contém o objeto de interesse0: o ponto é um ponto que não contém o objeto de interesse-1: o ponto corresponde ao fundo
Adicionamos o rótulo:
-10: o ponto é um ponto de preenchimento, portanto deve ser ignorado pelo codificador de prompt
Os rótulos de preenchimento devem ser feitos automaticamente pelo processador.
- input_boxes (
torch.Tensorde forma(batch_size, num_boxes, 4)) — Caixas de entrada para os pontos, usadas pelo prompt encoder para codificar o prompt. Geralmente, isso resulta em máscaras geradas muito melhores. As caixas podem ser obtidas passando uma lista de listas de listas para o processor, que gerará umtorchtensor, em que cada dimensão corresponde, respectivamente, ao tamanho do lote de imagens, ao número de caixas por imagem e às coordenadas do ponto superior esquerdo e do ponto inferior direito da caixa. Na ordem (x1,y1,x2,y2):x1: a coordenada x do ponto superior esquerdo da caixa de entraday1: a coordenada y do ponto superior esquerdo da caixa de entradax2: a coordenada x do ponto inferior direito da caixa de entraday2: a coordenada y do ponto inferior direito da caixa de entrada
- input_masks (
torch.Tensorde forma(batch_size, image_size, image_size)) — O modelo SAM_HQ também aceita máscaras de segmentação como entrada. A máscara será incorporada pelo prompt encoder para gerar um embedding correspondente, que será fornecido posteriormente ao mask decoder. Essas máscaras precisam ser fornecidas manualmente pelo usuário e devem ter a forma (batch_size,image_size,image_size). - image_embeddings (
torch.Tensorde forma(batch_size, output_channels, window_size, window_size)) — Incorporações de imagem, usadas pelo decodificador de máscara para gerar máscaras e pontuações de iou. Para um cálculo mais eficiente em termos de memória, os usuários podem primeiro recuperar as incorporações de imagem usando o métodoget_image_embeddingse, em seguida, fornecê-las ao métodoforwardem vez de fornecer ospixel_values. - multimask_output (
bool, opcional) — Na implementação e no artigo originais, o modelo sempre produz 3 máscaras por imagem (ou por ponto / por bounding box, quando aplicável). No entanto, é possível produzir apenas uma única máscara, que corresponde à máscara “melhor”, especificandomultimask_output=False. - hq_token_only (
bool, opcional, padrãoFalse) — Se deve usar apenas o caminho de token HQ para a geração da máscara. Quando False, combina os caminhos padrão e HQ. Isso é específico da arquitetura do SAM-HQ. - attention_similarity (
torch.Tensor, opcional) — Tensor de similaridade de atenção, a ser fornecido ao decodificador de máscara para atenção guiada por alvo, caso o modelo seja usado para personalização, conforme introduzido em PerSAM. - target_embedding (
torch.Tensor, opcional) — Embedding do conceito alvo, a ser fornecido ao decodificador de máscara para prompting semântico do alvo, caso o modelo seja usado para personalização, conforme introduzido em PerSAM. - intermediate_embeddings (
List[torch.Tensor], opcional) — Incorporações intermediárias dos blocos sem janela do codificador de visão, usadas pelo SAM-HQ para melhorar a qualidade das máscaras. Obrigatório ao fornecer image_embeddings pré-computados em vez de pixel_values.
O método forward do SamHQModel sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
Exemplo:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("sushmanth/sam_hq_vit_b")
>>> processor = AutoProcessor.from_pretrained("sushmanth/sam_hq_vit_b")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=image, input_points=input_points, return_tensors="pt")

>>> # Get high-quality segmentation mask
>>> outputs = model(**inputs)

>>> # For high-quality mask only
>>> outputs = model(**inputs, hq_token_only=True)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )