
Transformers documentation
Depth Anything V2
Este modelo foi publicado em HF papers em 2024-06-13 e contribuído para Hugging Face Transformers em 2024-07-05.
Depth Anything V2
Visão geral
Depth Anything V2 foi introduzido em o artigo homônimo por Lihe Yang et al. Ele utiliza a mesma arquitetura do modelo original Depth Anything, mas emprega dados sintéticos e um modelo teacher de maior capacidade para alcançar previsões de profundidade muito mais finas e robustas.
O resumo do artigo é o seguinte:
Este trabalho apresenta o Depth Anything V2. Sem recorrer a técnicas elaboradas, nosso objetivo é revelar descobertas cruciais para abrir caminho para a construção de um modelo poderoso de estimativa de profundidade monocular. Notavelmente, em comparação com a V1, esta versão produz previsões de profundidade muito mais finas e robustas por meio de três práticas-chave: 1) substituir todas as imagens reais rotuladas por imagens sintéticas, 2) aumentar a capacidade do nosso modelo teacher e 3) ensinar modelos student por meio da ponte de imagens reais pseudo-rotuladas em larga escala. Em comparação com os modelos mais recentes construídos sobre o Stable Diffusion, nossos modelos são significativamente mais eficientes (mais de 10x mais rápidos) e mais precisos. Oferecemos modelos de diferentes escalas (variando de 25M a 1,3B de parâmetros) para suportar cenários extensos. Beneficiando-se de sua forte capacidade de generalização, fazemos o fine-tuning deles com rótulos de profundidade métrica para obter nossos modelos de profundidade métrica. Além de nossos modelos, considerando a diversidade limitada e o ruído frequente nos conjuntos de teste atuais, construímos um benchmark de avaliação versátil com anotações precisas e cenas diversas para facilitar pesquisas futuras.
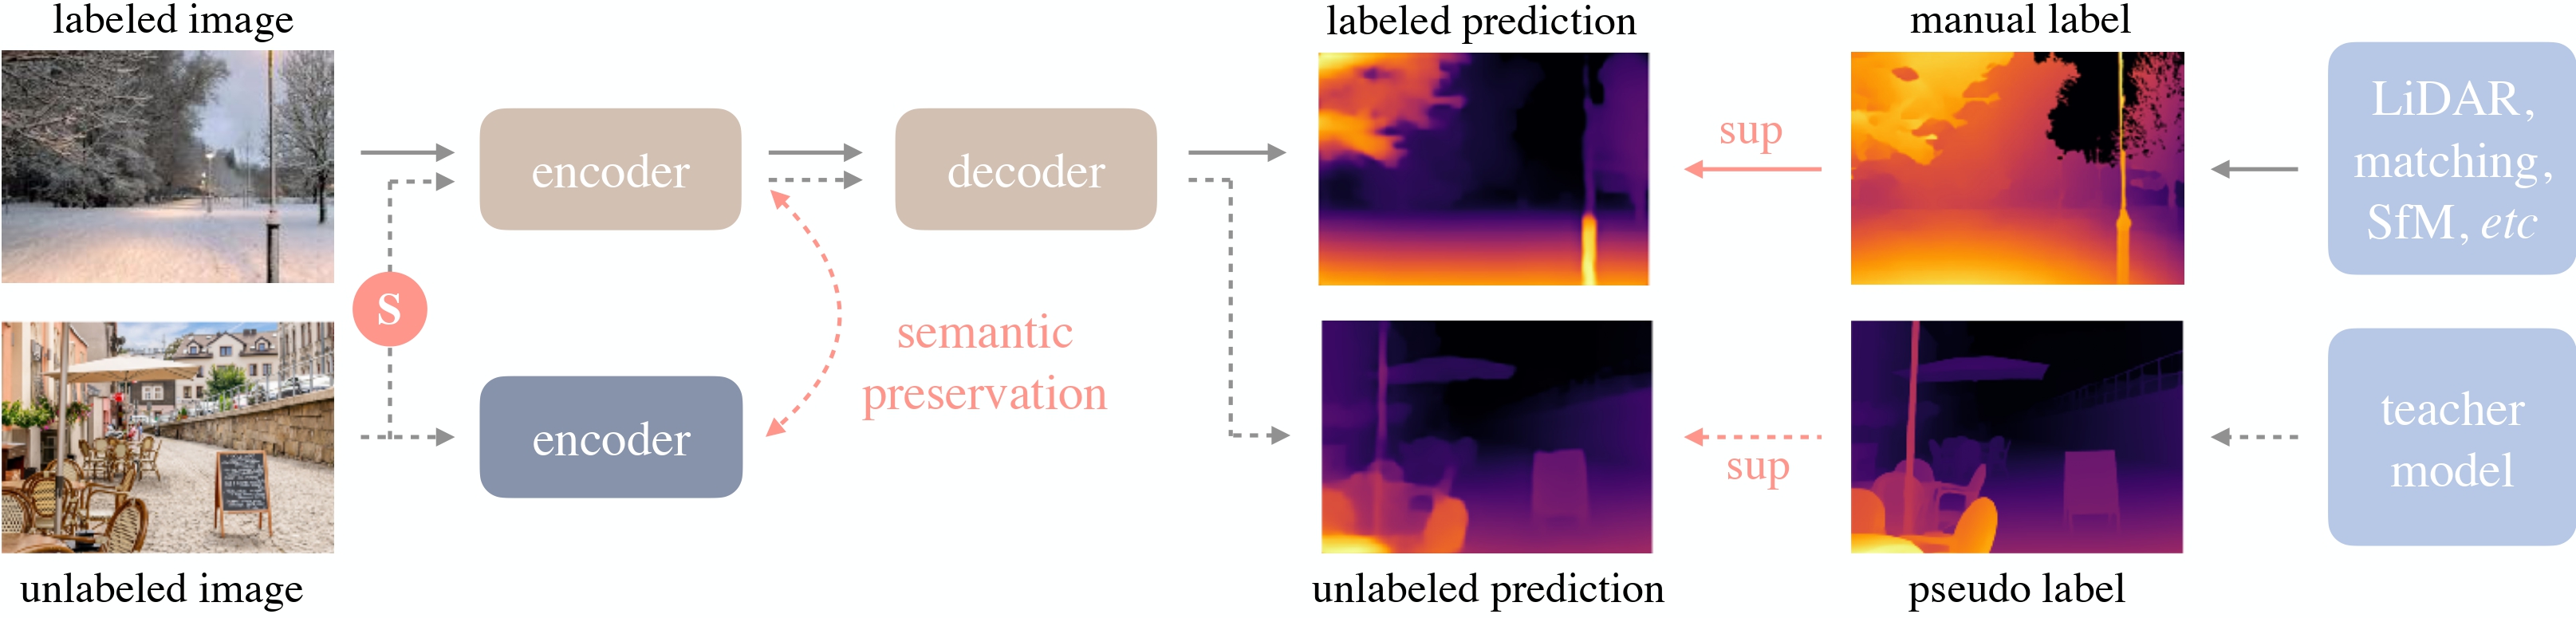 Depth Anything overview. Taken from the original paper.
Os modelos Depth Anything foram contribuídos por nielsr. O código original pode ser encontrado aqui.
Exemplo de uso
Existem 2 maneiras principais de usar o Depth Anything V2: seja usando a API de pipeline, que abstrai toda a complexidade para você, ou usando a classe DepthAnythingForDepthEstimation diretamente.
API de Pipeline
O pipeline permite usar o modelo em poucas linhas de código:
import requests
from PIL import Image

from transformers import pipeline


# load pipe
pipe = pipeline(task="depth-estimation", model="depth-anything/Depth-Anything-V2-Small-hf")

# load image
url = 'http://images.cocodataset.org/val2017/000000039769.jpg'
image = Image.open(requests.get(url, stream=True).raw)

# inference
depth = pipe(image)["depth"]
Usando o modelo por conta própria
Se você quiser fazer o pré-processamento e o pós-processamento por conta própria, veja como fazer isso:
import requests
import torch
from PIL import Image

from transformers import AutoImageProcessor, AutoModelForDepthEstimation


url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)

image_processor = AutoImageProcessor.from_pretrained("depth-anything/Depth-Anything-V2-Small-hf")
model = AutoModelForDepthEstimation.from_pretrained("depth-anything/Depth-Anything-V2-Small-hf", device_map="auto")

# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

# interpolate to original size and visualize the prediction
post_processed_output = image_processor.post_process_depth_estimation(
    outputs,
    target_sizes=[(image.height, image.width)],
)

predicted_depth = post_processed_output[0]["predicted_depth"]
depth = (predicted_depth - predicted_depth.min()) / (predicted_depth.max() - predicted_depth.min())
depth = depth.detach().cpu().numpy() * 255
depth = Image.fromarray(depth.astype("uint8"))
Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o Depth Anything.
- Guia da tarefa de estimativa de profundidade monocular
- Demonstração do Depth Anything V2.
- Um notebook demonstrando inferência com DepthAnythingForDepthEstimation pode ser encontrado aqui. 🌎
- Conversão para Core ML da variante
smallpara uso em Apple Silicon.
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
DepthAnythingConfig
classe transformers.DepthAnythingConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonepatch_size: int | list[int] | tuple[int, int] = 14initializer_range: float = 0.02reassemble_hidden_size: int = 384reassemble_factors: list[int | float] | tuple[int | float, ...] = (4, 2, 1, 0.5)neck_hidden_sizes: list[int] | tuple[int, ...] = (48, 96, 192, 384)fusion_hidden_size: int = 64head_in_index: int = -1head_hidden_size: int = 32depth_estimation_type: str = 'relative'max_depth: int | None = 1 )
Parâmetros
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — A configuração do modelo backbone. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão14) — O tamanho (resolução) de cada patch. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - reassemble_hidden_size (
int, opcional, padrão 384) — O número de canais de entrada das camadas de reassemble. - reassemble_factors (
list[int], opcional, padrão[4, 2, 1, 0.5]) — Fatores de up/downsampling das camadas de reassemble. - neck_hidden_sizes (
list[str], opcional, padrão[48, 96, 192, 384]) — Os tamanhos ocultos para os quais as feature maps do backbone devem ser projetadas. - fusion_hidden_size (
int, opcional, padrão 64) — O número de canais antes da fusão. - head_in_index (
int, opcional, padrão -1) — O índice dos recursos a serem usados na cabeça de estimativa de profundidade. - head_hidden_size (
int, opcional, padrão 32) — O número de canais de saída na segunda convolução da cabeça de estimativa de profundidade. - depth_estimation_type (
str, opcional, padrão"relative") — O tipo de estimativa de profundidade a ser usado. Pode ser um dos valores["relative", "metric"]. - max_depth (
float, opcional) — A profundidade máxima a ser usada para a cabeça de estimativa de profundidade “metric”. Deve-se usar 20 para modelos de ambientes internos e 80 para modelos de ambientes externos. Para a estimativa de profundidade “relative”, esse valor é ignorado.
Esta é a classe de configuração para armazenar a configuração de um Depth AnythingModel. Ela é usada para instanciar um modelo Depth Anything de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do LiheYoung/depth-anything-small-hf
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import DepthAnythingConfig, DepthAnythingForDepthEstimation

>>> # Initializing a DepthAnything small style configuration
>>> configuration = DepthAnythingConfig()

>>> # Initializing a model from the DepthAnything small style configuration
>>> model = DepthAnythingForDepthEstimation(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
DepthAnythingForDepthEstimation
classe transformers.DepthAnythingForDepthEstimation
< source >( config: DepthAnythingConfig )
Parâmetros
- config (DepthAnythingConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo Depth Anything com uma cabeça de estimativa de profundidade no topo (consistindo em 3 camadas convolucionais), por exemplo, para KITTI, NYUv2.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensorlabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DepthEstimatorOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando DPTImageProcessor. Veja DPTImageProcessor.call() para detalhes (processor_classusa DPTImageProcessor para processar imagens). - labels (
torch.LongTensorde forma(batch_size, height, width), opcional) — Mapas de estimativa de profundidade reais para o cálculo da perda. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
DepthEstimatorOutput ou tuple(torch.Tensor)
Um DepthEstimatorOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (DepthAnythingConfig) e das entradas.
O método forward de DepthAnythingForDepthEstimation substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).predicted_depth (
torch.Tensorde forma(batch_size, height, width)) — Profundidade prevista para cada pixel.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, num_channels, height, width).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, patch_size, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import AutoImageProcessor, AutoModelForDepthEstimation
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("LiheYoung/depth-anything-small-hf")
>>> model = AutoModelForDepthEstimation.from_pretrained("LiheYoung/depth-anything-small-hf")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> # interpolate to original size
>>> post_processed_output = image_processor.post_process_depth_estimation(
...     outputs,
...     target_sizes=[(image.height, image.width)],
... )

>>> # visualize the prediction
>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = predicted_depth * 255 / predicted_depth.max()
>>> depth = depth.detach().cpu().numpy()
>>> depth = Image.fromarray(depth.astype("uint8"))