
Transformers documentation
MaskFormer
このモデルは2021年7月13日にHF papersで公開され、2022年3月2日にHugging Face Transformersに貢献されました。
MaskFormer
これは最近導入されたモデルのため、APIは十分にテストされていません。将来の修正において、いくつかのバグや軽微な破壊的変更が発生する可能性があります。不審な点が見つかった場合は、Github Issueを起票してください。
概要
The MaskFormer model was proposed in Per-Pixel Classification is Not All You Need for Semantic Segmentation by Bowen Cheng, Alexander G. Schwing, Alexander Kirillov. MaskFormer addresses semantic segmentation with a mask classification paradigm instead of performing classic pixel-level classification.
論文の抄録は以下の通りです。
近年のアプローチでは、セマンティックセグメンテーションはピクセル単位の分類タスクとして定式化されることが一般的であり、インスタンスレベルのセグメンテーションは別のマスク分類手法で処理されています。私たちの重要な洞察は、マスク分類は、セマンティックレベルおよびインスタンスレベルのセグメンテーションタスクの両方を、完全に同一のモデル、損失関数、および学習手順を用いて統一的に解決するほど十分に汎用的であるという点です。この観察に基づき、私たちはMaskFormerを提案します。MaskFormerは、各マスクが単一のグローバルなクラスラベル予測に関連付けられる一連のバイナリマスクを予測する、シンプルなマスク分類モデルです。全体として、提案するマスク分類ベースの手法は、セマンティックセグメンテーションおよびパノプティックセグメンテーションタスクにおける有効なアプローチの状況を簡素化し、優れた実証結果を示しています。特に、クラス数が大きい場合、MaskFormerはピクセル単位の分類ベースラインを上回ることを確認しました。私たちのマスク分類ベースの手法は、現在の最先端のセマンティックセグメンテーションモデル(ADE20Kで55.6 mIoU)およびパノプティックセグメンテーションモデル(COCOで52.7 PQ)の両方を上回っています。
下图展示了MaskFormer的架构。引用自原始论文。
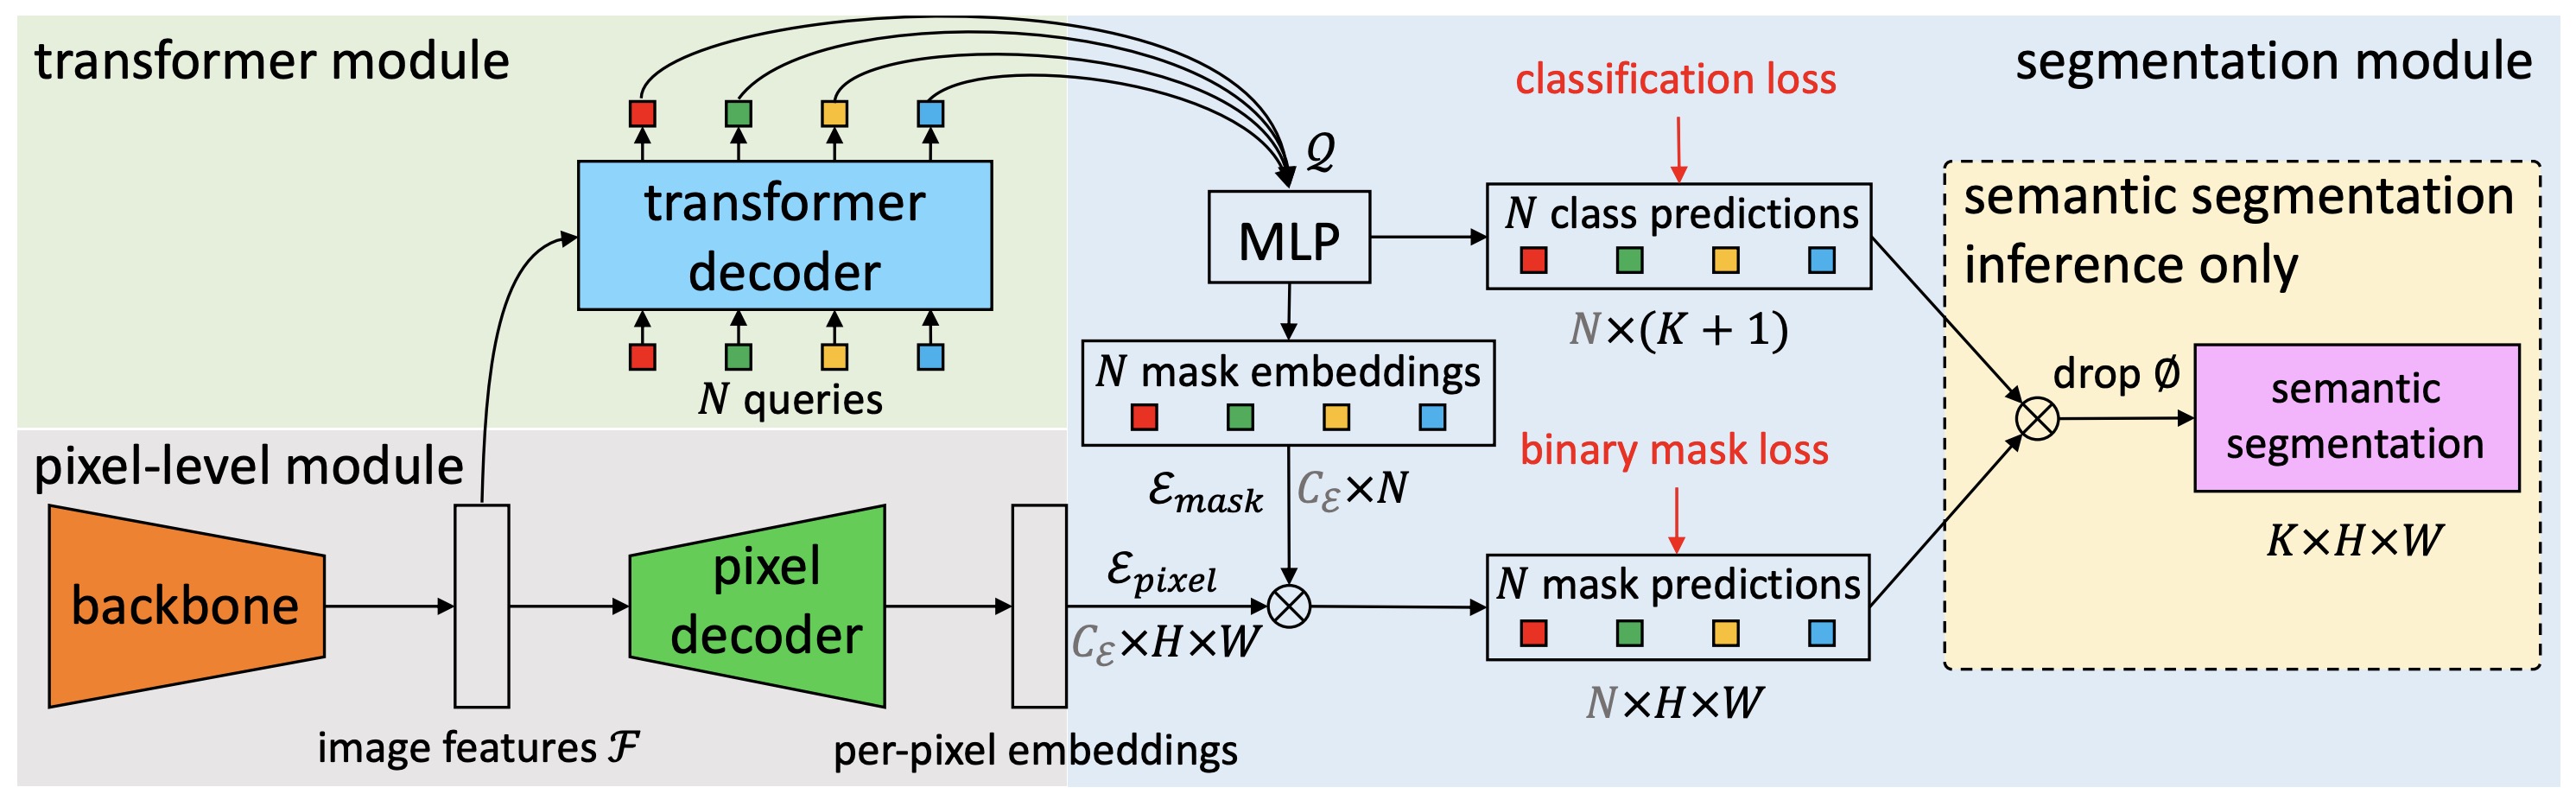
このモデルはfrancescoによって提供されました。元のコードはこちらで確認できます。
使用のコツ
- MaskFormerのTransformerデコーダーは、DETRのデコーダーと同一です。DETRの著者たちは、学習中にデコーダーで補助損失を使用することが有効であると報告しています。特に、モデルが各クラスの正しい数のオブジェクトを出力するのを助けるためにです。MaskFormerConfigのパラメータ
use_auxiliary_lossをTrueに設定すると、各デコーダー層の後に予測用のフィードフォワードニューラルネットワークとハンガリー損失が追加されます(FFNはパラメータを共有します)。 - モデルを複数ノードにまたがる分散環境で学習する場合、
modeling_maskformer.pyのMaskFormerLossクラス内のget_num_masks関数を更新する必要があります。複数ノードでの学習では、こちらの元の実装にあるように、この値を全ノードにわたるターゲットマスクの平均数に設定する必要があります。 - MaskFormerImageProcessor を使用して、モデル用の画像および任意のターゲットを準備できます。
- 最終的なセグメンテーションを取得するには、タスクに応じて post_process_semantic_segmentation() または post_process_panoptic_segmentation() を呼び出すことができます。どちらのタスクも MaskFormerForInstanceSegmentation の出力を使用して解決でき、パンノプティックセグメンテーションでは、対象オブジェクト(例:空)のインスタンスを融合するための任意の引数
label_ids_to_fuseを受け取ります。
リソース
- MaskFormer を用いた推論およびカスタムデータでのファインチューニングを説明するすべてのノートブックは、こちらで確認できます。
MaskFormer固有の出力
class transformers.models.maskformer.modeling_maskformer.MaskFormerModelOutput
< source >( encoder_last_hidden_state: typing.Optional[torch.FloatTensor] = Nonepixel_decoder_last_hidden_state: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_last_hidden_state: typing.Optional[torch.FloatTensor] = Noneencoder_hidden_states: tuple[torch.FloatTensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.FloatTensor] | None = Nonetransformer_decoder_hidden_states: tuple[torch.FloatTensor] | None = Nonehidden_states: tuple[torch.FloatTensor] | None = Noneattentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- encoder_last_hidden_state (
torch.FloatTensor、形状(batch_size, num_channels, height, width)) — エンコーダーモデル(バックボーン)の最終ステージの最後の隠れ状態(最終特徴マップ)。 - pixel_decoder_last_hidden_state (
torch.FloatTensor、形状(batch_size, num_channels, height, width)) — ピクセルデコーダーモデル(FPN)の最終ステージの最終隠れ状態(最終特徴マップ)。 - transformer_decoder_last_hidden_state (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)) — transformer decoder モデルの最終ステージの最後の隠れ状態(最終特徴マップ)です。 - encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。 ピクセルデコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, sequence_length, hidden_size)です。 transformer decoder の各ステージの出力における hidden states(feature maps とも呼ばれます)。 - hidden_states
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます —torch.FloatTensorのタプルで、encoder_hidden_states、pixel_decoder_hidden_statesおよびdecoder_hidden_statesを含みます - hidden_states (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_hidden_states=Trueが渡された場合、またはconfig.output_hidden_states=True) — のタプルtorch.FloatTensor((埋め込み層を持つモデルの場合は埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は(batch_size, sequence_length, hidden_size).各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
MaskFormerModelの出力用のクラスです。このクラスは、logitsを計算するために必要なすべてのhidden statesを返します。
クラス transformers.models.maskformer.modeling_maskformer.MaskFormerForInstanceSegmentationOutput
< source >( loss: typing.Optional[torch.FloatTensor] = Noneclass_queries_logits: typing.Optional[torch.FloatTensor] = Nonemasks_queries_logits: typing.Optional[torch.FloatTensor] = Noneauxiliary_logits: typing.Optional[torch.FloatTensor] = Noneencoder_last_hidden_state: typing.Optional[torch.FloatTensor] = Nonepixel_decoder_last_hidden_state: typing.Optional[torch.FloatTensor] = Nonetransformer_decoder_last_hidden_state: typing.Optional[torch.FloatTensor] = Noneencoder_hidden_states: tuple[torch.FloatTensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.FloatTensor] | None = Nonetransformer_decoder_hidden_states: tuple[torch.FloatTensor] | None = Nonehidden_states: tuple[torch.FloatTensor] | None = Noneattentions: tuple[torch.FloatTensor] | None = None )
パラメータ
- loss (
torch.Tensor, 任意) — ラベルが存在する場合に返される、計算された損失。 - class_queries_logits (
torch.FloatTensor, 任意) — 各クエリに対して提案されるクラスを表す、形状が(batch_size, num_queries, num_labels + 1)のテンソルです。+ 1は、nullクラスを組み込む必要があるためです。 - masks_queries_logits (
torch.FloatTensor, 任意) — 各クエリに対する提案マスクを表す、形状(batch_size, num_queries, height, width)のテンソル。 - auxiliary_logits (
Dict[str, torch.FloatTensor], 任意、output_auxiliary_logits=Trueの場合のみ返却) — 補助損失が有効な場合、各デコーダ層の補助予測を含む辞書。 - encoder_last_hidden_state (
torch.FloatTensor、形状(batch_size, num_channels, height, width)) — エンコーダーモデル(バックボーン)の最終ステージの最後の隠れ状態(最終特徴マップ)。 - pixel_decoder_last_hidden_state (
torch.FloatTensor、形状(batch_size, num_channels, height, width)) — ピクセルデコーダーモデル(FPN)の最終ステージの最終隠れ状態(最終特徴マップ)。 - transformer_decoder_last_hidden_state (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)) — transformer decoder モデルの最終ステージの最後の隠れ状態(最終特徴マップ)です。 - encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, num_channels, height, width)です。 ピクセルデコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 - transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)で、 形状は(batch_size, sequence_length, hidden_size)です。各ステージの出力における transformer decoder の隠れ状態です。 - hidden_states
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます —encoder_hidden_states、pixel_decoder_hidden_statesおよびdecoder_hidden_statesを含むtorch.FloatTensorのタプル。 - hidden_states (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_hidden_states=Trueが渡された場合、またはconfig.output_hidden_states=True) — のタプルtorch.FloatTensor((埋め込み層を持つモデルの場合は埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は(batch_size, sequence_length, hidden_size).各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- attentions (
tuple[torch.FloatTensor], 省略可能, が返されるのはoutput_attentions=Trueが渡された場合、またはconfig.output_attentions=True) — のタプルtorch.FloatTensor(の形状を持つ、各レイヤーごとに1つの(batch_size, num_heads, sequence_length, sequence_length).アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
MaskFormerForInstanceSegmentation の出力用のクラスです。
この出力は、タスクに応じて、post_process_semantic_segmentation()、post_process_instance_segmentation()、または post_process_panoptic_segmentation() に直接渡すことができます。使用法の詳細については、[`~MaskFormerImageProcessor] を参照してください。
MaskFormerDetrConfig
クラス transformers.MaskFormerDetrConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_channels: int = 3num_queries: int = 100encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8encoder_layerdrop: float | int = 0.0decoder_layerdrop: float | int = 0.0activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0init_std: float = 0.02init_xavier_std: float = 1.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'dilation: bool = Falseclass_cost: int = 1bbox_cost: int = 5giou_cost: int = 2mask_loss_coefficient: int = 1dice_loss_coefficient: int = 1bbox_loss_coefficient: int = 5giou_loss_coefficient: int = 2eos_coefficient: float = 0.1 )
パラメータ
- is_encoder_decoder (
bool、任意、デフォルトはTrue) — モデルがエンコーダー/デコーダーとして使用されるかどうかを示します。 - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - num_queries (
int、任意、デフォルトは 100)— オブジェクトクエリ数、すなわち検出スロットの数です。これは、ConditionalDetrModel が 1 枚の画像内で検出できるオブジェクトの最大数を示します。COCO の場合は、100 クエリを推奨します。 - encoder_layers (
int、任意、デフォルトは6) — Transformer エンコーダーの隠れ層の数です。設定されていない場合は、num_layersと同じ値が使用されます。 - encoder_ffn_dim (
int、任意、デフォルトは2048) — エンコーダー内の「中間」層(フィードフォワード層と呼ばれることが多い)の次元数。 - encoder_attention_heads (
int、任意、デフォルトは8) — Transformer エンコーダーの各アテンション層におけるアテンションヘッドの数。 - decoder_layers (
int、任意、デフォルトは6) — Transformer デコーダーの隠れ層の数です。設定されていない場合、num_layersと同じ値が使用されます。 - decoder_ffn_dim (
int、任意、デフォルトは2048) — デコーダー内の「中間」(feed-forward と呼ばれることが多い) レイヤーの次元数。 - decoder_attention_heads (
int、任意、デフォルトは8) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - encoder_layerdrop (
Union[float, int]、任意、デフォルトは0.0) — エンコーダーの LayerDrop 確率です。詳細は [LayerDrop の論文](https://huggingface.co/papers/1909.11556 を参照)をご覧ください。 - decoder_layerdrop (
Union[float, int]、省略可、デフォルト値は0.0) — デコーダーの LayerDrop 確率です。詳細は [LayerDrop の論文](https://huggingface.co/papers/1909.11556 を参照)をご覧ください。 - activation_function (
str、任意、デフォルトはrelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - d_model (
int、省略可、デフォルトは256) — エンコーダ層とプーラ層のサイズ。 - dropout (
Union[float, int]、任意、デフォルト値は0.1) — すべての dropout レイヤーの比率です。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - activation_dropout (
Union[float, int]、任意、デフォルトは0.0) — 全結合層内の活性化に対する dropout 率です。 - init_std (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - init_xavier_std (
float、任意、デフォルトは1.0) — クロスアテンションの重みの Xavier 初期化に使用されるスケーリング係数です。 - auxiliary_loss (
bool、任意、デフォルトはFalse) — 補助デコーディング損失(各デコーダ層での損失)を使用するかどうかを指定します。 - position_embedding_type (
str, 任意、デフォルトは"sine") — 画像特徴の上に適用する位置埋め込みの種類。"sine"または"learned"のいずれかです。 - dilation (
bool、任意、デフォルトはFalse) — 最後の畳み込みブロック(DC5)で stride の代わりに dilation を使用するかを指定します。use_timm_backbone=Trueの場合のみサポートされます。 - class_cost (
int、省略可能、デフォルトは1) — ハンガリー法によるマッチングコストにおける、分類誤差の相対的な重み。 - bbox_cost (
int、任意、デフォルトは5) — ハンガリー法によるマッチングコストにおける、L1バウンディングボックス誤差の相対的な重みです。 - giou_cost (
int、任意、デフォルト値は2) — ハンガリー法によるマッチングコストにおける、汎化 IoU ロスの相対的な重み。 - mask_loss_coefficient (
int、任意、デフォルトは1) — パノプティックセグメンテーション損失におけるfocal lossの相対的な重み。 - dice_loss_coefficient (
int, 任意、デフォルトは1) — パンノミックセグメンテーション損失における dice loss の相対的な重み。 - bbox_loss_coefficient (
int、任意、デフォルトは5) — パノプティックセグメンテーション損失における L1 バウンディングボックス損失の相対的な重み。 - giou_loss_coefficient (
int、任意、デフォルトは2) — パノラミックセグメンテーション損失における汎化 IoU 損失の相対的な重み。 - eos_coefficient (
float、任意、デフォルトは0.1) — オブジェクト検出の損失における「no-object」クラスの相対的な分類重み。
This is the configuration class to store the configuration of a MaskFormerModel. It is used to instantiate a Maskformer model according to the specified arguments, defining the model architecture. Instantiating a configuration with the defaults will yield a similar configuration to that of the facebook/maskformer-swin-base-ade
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import MaskFormerDetrConfig, MaskFormerDetrModel

>>> # Initializing a MASK_FORMER_DETR facebook/mask_former_detr-resnet-50 style configuration
>>> configuration = MaskFormerDetrConfig()

>>> # Initializing a model (with random weights) from the facebook/mask_former_detr-resnet-50 style configuration
>>> model = MaskFormerDetrModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MaskFormerConfig
クラス transformers.MaskFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonefpn_feature_size: int = 256mask_feature_size: int = 256no_object_weight: float = 0.1use_auxiliary_loss: bool = Falsebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonedecoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinit_std: float = 0.02init_xavier_std: float = 1.0dice_weight: float = 1.0cross_entropy_weight: float = 1.0mask_weight: float = 20.0output_auxiliary_logits: bool | None = None )
パラメータ
- fpn_feature_size (
int, 任意、デフォルトは 256) — Feature Pyramid Network の特徴量サイズです。 - mask_feature_size (
int、任意、デフォルトは 256) — マスクのフィーチャサイズです。この値は、Feature Pyramid Network のフィーチャサイズを指定するためにも使用されます。 - no_object_weight (
float、任意、デフォルト値は0.1) — オブジェクト検出の損失における、no-object クラスの相対的な分類重み。 - use_auxiliary_loss (
bool、任意、デフォルトはFalse) — transformer decoder の中間予測を用いて損失を計算するかどうか。 - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - decoder_config (
Dict, 任意) — transformer デコーダーモデルに渡す設定です。未設定の場合、detr-resnet-50のベース設定が使用されます。 - init_std (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - init_xavier_std (
float、任意、デフォルトは1.0) — クロスアテンションの重みの Xavier 初期化に使用されるスケーリング係数です。 - dice_weight (
float、任意、デフォルトは1.0) — パノラミックセグメンテーション損失における dice loss の相対的な重み。 - cross_entropy_weight (
float、任意、デフォルト値は 1.0) — クロスエントロピー損失の重みです。 - mask_weight (
float、任意、デフォルトは20.0) — パノプティックセグメンテーション損失における focal loss の相対的な重み。 - output_auxiliary_logits (
bool, 省略可) — モデルがauxiliary_logitsを出力するかどうかを指定します。
例外
ValueError
ValueError— 選択されたバックボーンモデルの種類が["swin"]に含まれていない場合、または選択されたデコーダーモデルの種類が["detr"]に含まれていない場合に発生します。
This is the configuration class to store the configuration of a MaskFormerModel. It is used to instantiate a Maskformer model according to the specified arguments, defining the model architecture. Instantiating a configuration with the defaults will yield a similar configuration to that of the facebook/maskformer-swin-base-ade
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import MaskFormerConfig, MaskFormerModel

>>> # Initializing a MaskFormer facebook/maskformer-swin-base-ade configuration
>>> configuration = MaskFormerConfig()

>>> # Initializing a model (with random weights) from the facebook/maskformer-swin-base-ade style configuration
>>> model = MaskFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MaskFormerImageProcessor
class transformers.MaskFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.maskformer.image_processing_maskformer.MaskFormerImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 800, 'longest_edge': 1333}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, デフォルトは2) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
SizeDict、kwargs、任意) — 画像をパディングするサイズです。前処理に提供されたすべての画像サイズより大きい必要があります。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップの背景ピクセルに割り当てられるラベルです。指定された場合、セグメンテーションマップ内で 0(背景)と示されたピクセルはignore_indexに置き換えられます。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — セグメンテーションマップのすべてのラベル値を 1 減らすかどうかを指定します。通常、0 が背景に使用され、かつ背景自体がデータセットのすべてのクラスに含まれていないデータセット(例: ADE20k)で使用されます。背景ラベルはignore_indexに置き換えられます。 - num_labels (
int、kwargs、任意) — セグメンテーションマップにおけるラベルの数。 - size_divisor (
int, kwargs, optional, デフォルト値は32) — 一部の backbone は、特定の整数で割り切れる画像サイズを必要とします。指定されない場合、Swin Transformer で使用される値がデフォルトとして使用されます。
MaskFormerImageProcessor 画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.maskformer.image_processing_maskformer.MaskFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - segmentation_maps (
ImageInput、任意) — セグメンテーションマップです。 - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], 省略可) — インスタンス ID からセマンティック ID へのマッピングです。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
SizeDict、kwargs、任意) — 画像をパディングするサイズです。前処理に提供されたすべての画像サイズより大きい必要があります。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップの背景ピクセルに割り当てられるラベルです。指定された場合、セグメンテーションマップ内で 0(背景)と示されたピクセルはignore_indexに置き換えられます。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — セグメンテーションマップのすべてのラベル値を 1 減らすかどうかを指定します。通常、0 が背景に使用され、かつ背景自体がデータセットのすべてのクラスに含まれていないデータセット(例: ADE20k)で使用されます。背景ラベルはignore_indexに置き換えられます。 - num_labels (
int、kwargs、任意) — セグメンテーションマップにおけるラベルの数。 - size_divisor (
int, kwargs, optional, デフォルト値は32) — 一部の backbone は、特定の整数で割り切れる画像サイズを必要とします。指定されない場合、Swin Transformer で使用される値がデフォルトとして使用されます。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
パラメータ
- outputs (MaskFormerForInstanceSegmentation) — モデルの生出力。
- target_sizes (
list[tuple[int, int]]、省略可) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_segmentation_scores (
bool、省略可、デフォルトはFalse) — セグメンテーションマップとともにセグメンテーションスコアを返すかどうか。Trueの場合、返されるリストの各要素は、segmentation(クラス ID、形状(height, width))とsegmentation_scores(形状(num_classes, height, width))というフィールドを持つSemanticSegmentationPostProcessorOutputです。
戻り値
list[torch.Tensor] または list[SemanticSegmentationPostProcessorOutput]
return_segmentation_scores=False(デフォルト)の場合、各要素がクラス ID を持つ (height, width) の形状のセグメンテーションマップである、長さ batch_size のリストが返されます。return_segmentation_scores=True の場合、フィールド segmentation(クラス ID、形状 (height, width))と segmentation_scores(形状 (num_classes, height, width))を持つ SemanticSegmentationPostProcessorOutput のリストが返されます。どちらの場合も、(height, width) はターゲットサイズ(target_sizes が指定されている場合)に対応します。
MaskFormerForInstanceSegmentationの出力をセマンティックセグメンテーションマップに変換します。PyTorchのみサポートしています。
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = Falsereturn_binary_maps: bool | None = False ) → list[Dict]
パラメータ
- outputs (MaskFormerForInstanceSegmentation) — モデルの生出力です。
- threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - target_sizes (
list[Tuple]、任意) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_coco_annotation (
bool、省略可能、デフォルトはFalse) —Trueに設定すると、セグメンテーションマップは COCO のランレングスエンコーディング (RLE) 形式で返されます。 - return_binary_maps (
bool、任意、デフォルトはFalse) —Trueに設定すると、セグメンテーションマップは、検出された各インスタンスに対応するバイナリセグメンテーションマップの連結テンソルとして返されます。
戻り値
list[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。または、return_coco_annotationがTrueに設定されている場合は、セグメンテーションマップのlist[List]形式のランレングス符号化(RLE)。または、return_binary_mapsがTrueに設定されている場合は、形状(num_instances, height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - score —
segment_idを持つセグメントの予測スコア。
- id —
MaskFormerForInstanceSegmentationOutput の出力をインスタンスセグメンテーションの予測に変換します。PyTorch のみサポートしています。インスタンスが重なる可能性がある場合は、正しいセグメンテーション結果を得るために、return_coco_annotation または return_binary_maps のいずれかを True に設定してください。
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
パラメータ
- outputs (
MaskFormerForInstanceSegmentationOutput) — MaskFormerForInstanceSegmentationからの出力です。 - threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - label_ids_to_fuse (
Set[int]、省略可) — この状態にあるラベルは、すべてのインスタンスが融合されます。例えば、画像には空が1つしか存在しませんが、人物は複数存在し得るため、空のラベル ID はこのセットに含まれますが、人物のラベル ID は含まれません。 - target_sizes (
list[Tuple], 任意) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、バッチ内の各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。
戻り値
list[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。target_sizesが指定されている場合、segmentationは対応するtarget_sizesのエントリにリサイズされます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - was_fused — 論理値。
label_idがlabel_ids_to_fuseに含まれていた場合はTrue、それ以外の場合はFalse。 同一クラス/ラベルの複数のインスタンスが融合され、単一のsegment_idが割り当てられました。 - score —
segment_idを持つセグメントの予測スコア。
- id —
MaskFormerForInstanceSegmentationOutputの出力を、画像のパンノセグメンテーション予測に変換します。PyTorchのみサポートしています。
MaskFormerImageProcessorPil
クラス transformers.MaskFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.maskformer.image_processing_pil_maskformer.MaskFormerImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 800, 'longest_edge': 1333}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, デフォルトは2) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
SizeDict、kwargs、任意) — 画像をパディングするサイズです。前処理に提供されたすべての画像サイズより大きい必要があります。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップの背景ピクセルに割り当てられるラベルです。指定された場合、セグメンテーションマップ内で 0(背景)と示されたピクセルはignore_indexに置き換えられます。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — セグメンテーションマップのすべてのラベル値を 1 減らすかどうかを指定します。通常、0 が背景に使用され、かつ背景自体がデータセットのすべてのクラスに含まれていないデータセット(例: ADE20k)で使用されます。背景ラベルはignore_indexに置き換えられます。 - num_labels (
int、kwargs、任意) — セグメンテーションマップにおけるラベルの数。 - size_divisor (
int, kwargs, optional, デフォルト値は32) — 一部の backbone は、特定の整数で割り切れる画像サイズを必要とします。指定されない場合、Swin Transformer で使用される値がデフォルトとして使用されます。
MaskFormerImageProcessor 画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.maskformer.image_processing_pil_maskformer.MaskFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - segmentation_maps (
ImageInput、任意) — セグメンテーションマップです。 - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], 省略可) — インスタンス ID からセマンティック ID へのマッピングです。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
SizeDict、kwargs、任意) — 画像をパディングするサイズです。前処理に提供されたすべての画像サイズより大きい必要があります。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - ignore_index (
int、kwargs、任意) — セグメンテーションマップの背景ピクセルに割り当てられるラベルです。指定された場合、セグメンテーションマップ内で 0(背景)と示されたピクセルはignore_indexに置き換えられます。 - do_reduce_labels (
bool、kwargs、optional、デフォルトはFalse) — セグメンテーションマップのすべてのラベル値を 1 減らすかどうかを指定します。通常、0 が背景に使用され、かつ背景自体がデータセットのすべてのクラスに含まれていないデータセット(例: ADE20k)で使用されます。背景ラベルはignore_indexに置き換えられます。 - num_labels (
int、kwargs、任意) — セグメンテーションマップにおけるラベルの数。 - size_divisor (
int, kwargs, optional, デフォルト値は32) — 一部の backbone は、特定の整数で割り切れる画像サイズを必要とします。指定されない場合、Swin Transformer で使用される値がデフォルトとして使用されます。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
パラメータ
- outputs (MaskFormerForInstanceSegmentation) — モデルの生出力です。
- target_sizes (
list[tuple[int, int]]、省略可) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_segmentation_scores (
bool、省略可、デフォルトはFalse) — セグメンテーションマップとともにセグメンテーションスコアを返すかどうか。Trueの場合、返されるリストの各要素は、segmentation(クラス ID、形状(height, width))とsegmentation_scores(形状(num_classes, height, width))というフィールドを持つSemanticSegmentationPostProcessorOutputです。
戻り値
list[torch.Tensor] または list[SemanticSegmentationPostProcessorOutput]
return_segmentation_scores=False(デフォルト)の場合、各要素がクラス ID を持つ (height, width) の形状のセグメンテーションマップである、長さ batch_size のリストが返されます。return_segmentation_scores=True の場合、フィールド segmentation(クラス ID、形状 (height, width))と segmentation_scores(形状 (num_classes, height, width))を持つ SemanticSegmentationPostProcessorOutput のリストが返されます。どちらの場合も、(height, width) はターゲットサイズ(target_sizes が指定されている場合)に対応します。
MaskFormerForInstanceSegmentationの出力をセマンティックセグメンテーションマップに変換します。PyTorchのみサポートしています。
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = Falsereturn_binary_maps: bool | None = False ) → list[Dict]
パラメータ
- outputs (MaskFormerForInstanceSegmentation) — モデルの生出力です。
- threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - target_sizes (
list[Tuple]、任意) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、各予測の要求される最終サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。 - return_coco_annotation (
bool、省略可能、デフォルトはFalse) —Trueに設定すると、セグメンテーションマップは COCO のランレングスエンコーディング (RLE) 形式で返されます。 - return_binary_maps (
bool、任意、デフォルトはFalse) —Trueに設定すると、セグメンテーションマップは、検出された各インスタンスに対応するバイナリセグメンテーションマップの連結テンソルとして返されます。
戻り値
list[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。または、return_coco_annotationがTrueに設定されている場合は、セグメンテーションマップのlist[List]形式のランレングス符号化(RLE)。または、return_binary_mapsがTrueに設定されている場合は、形状(num_instances, height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - score —
segment_idを持つセグメントの予測スコア。
- id —
MaskFormerForInstanceSegmentationOutput の出力をインスタンスセグメンテーションの予測に変換します。PyTorch のみサポートしています。インスタンスが重なる可能性がある場合は、正しいセグメンテーション結果を得るために、return_coco_annotation または return_binary_maps のいずれかを True に設定してください。
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
パラメータ
- outputs (
MaskFormerForInstanceSegmentationOutput) — MaskFormerForInstanceSegmentationからの出力です。 - threshold (
float、任意、デフォルト値は 0.5) — 予測されたインスタンスマスクを保持するための確率スコアの閾値です。 - mask_threshold (
float、任意、デフォルトは 0.5) — 予測されたマスクをバイナリ値に変換する際に使用する閾値。 - overlap_mask_area_threshold (
float、任意、デフォルト値は 0.8) — 各バイナリインスタンスマスク内の小さな非連結部分をマージまたは破棄するための、オーバーラップマスクの面積しきい値です。 - label_ids_to_fuse (
Set[int]、省略可) — この状態にあるラベルは、すべてのインスタンスが融合されます。例えば、画像には空が1つしか存在しませんが、人物は複数存在し得るため、空のラベル ID はこのセットに含まれますが、人物のラベル ID は含まれません。 - target_sizes (
list[Tuple], 任意) — 長さ (batch_size) のリストで、各リストの要素 (tuple[int, int]]) は、バッチ内の各予測の最終的な要求サイズ (高さ、幅) に対応します。None の場合、予測はリサイズされません。
戻り値
list[Dict]
画像ごとに1つずつの辞書のリストで、各辞書には2つのキーが含まれます:
- segmentation — 各ピクセルが
segment_idを表す、形状(height, width)のテンソル。thresholdを超えるマスクが見つからない場合はNoneに設定されます。target_sizesが指定されている場合、segmentationは対応するtarget_sizesのエントリにリサイズされます。 - segments_info — 各セグメントに関する追加情報を含む辞書。
- id —
segment_idを表す整数。 - label_id —
segment_idに対応するラベル/セマンティッククラスIDを表す整数。 - was_fused — 論理値。
label_idがlabel_ids_to_fuseに含まれていた場合はTrue、それ以外の場合はFalse。 同一クラス/ラベルの複数のインスタンスが融合され、単一のsegment_idが割り当てられました。 - score —
segment_idを持つセグメントの予測スコア。
- id —
MaskFormerForInstanceSegmentationOutputの出力を、画像のパンノセグメンテーション予測に変換します。PyTorchのみサポートしています。
MaskFormerModel
class transformers.MaskFormerModel
< source >( config: MaskFormerConfig )
パラメータ
- config (MaskFormerConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する素のMaskformer Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskFormerModelOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は MaskFormerImageProcessor を使用して取得できます。詳細は MaskFormerImageProcessor.call() を参照してください(processor_classは画像の処理に MaskFormerImageProcessor を使用します)。 - pixel_mask (
torch.Tensorの形状(batch_size, height, width), 、任意) — パディングピクセル値に対するアテンションの適用を回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
MaskFormerModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または MaskFormerModelOutput。設定(MaskFormerConfig)や入力に応じて、さまざまな要素で構成されます。
MaskFormerModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, num_channels, height, width)) — エンコーダーモデル(バックボーン)の最終ステージの最終隠れ状態(最終特徴マップ)。pixel_decoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, num_channels, height, width)) — pixel decoder モデル(FPN)の最終ステージの最終 hidden states(最終 feature map)。transformer_decoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — Transformerデコーダーモデルの最終ステージの最終隠れ状態(最終特徴マップ)。encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。ピクセルデコーダーモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, sequence_length, hidden_size)です。transformer デコーダーの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。 hidden_statestuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます:encoder_hidden_states、pixel_decoder_hidden_states、decoder_hidden_statesを含むtorch.FloatTensorのタプルhidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoImageProcessor, MaskFormerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on ADE20k semantic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-ade")
>>> model = MaskFormerModel.from_pretrained("facebook/maskformer-swin-base-ade")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = image_processor(image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # the decoder of MaskFormer outputs hidden states of shape (batch_size, num_queries, hidden_size)
>>> transformer_decoder_last_hidden_state = outputs.transformer_decoder_last_hidden_state
>>> list(transformer_decoder_last_hidden_state.shape)
[1, 100, 256]
MaskFormerForInstanceSegmentation
forward
< source >( pixel_values: Tensormask_labels: list[torch.Tensor] | None = Noneclass_labels: list[torch.Tensor] | None = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_auxiliary_logits: bool | None = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskFormerForInstanceSegmentationOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は MaskFormerImageProcessor を使用して取得できます。詳細は MaskFormerImageProcessor.call() を参照してください(processor_classは画像の処理に MaskFormerImageProcessor を使用します)。 - mask_labels (
list[torch.Tensor]、任意) — モデルに渡す、(num_labels, height, width)の形状を持つマスクラベルのリスト - class_labels (
list[torch.LongTensor]、任意) — モデルに渡す、(num_labels, height, width)の形状を持つターゲットクラスラベルのリストです。mask_labelsのラベルを識別します。例えば、class_labels[i][j]が真の場合、mask_labels[i][j]のラベルを示します。 - pixel_mask (
torch.Tensorの形状(batch_size, height, width), 、任意) — パディングピクセル値に対するアテンションの適用を回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- output_auxiliary_logits (
bool, 省略可) — 補助 logits を出力するかどうか。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
MaskFormerForInstanceSegmentationOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または MaskFormerForInstanceSegmentationOutput。設定(MaskFormerConfig)と入力に応じて、さまざまな要素で構成されます。
MaskFormerForInstanceSegmentationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.Tensor, optional) — ラベルが存在する場合に返される、計算された損失。class_queries_logits (
torch.FloatTensor, optional) — 各クエリに対して提案されるクラスを表す、形状が(batch_size, num_queries, num_labels + 1)のテンソル。nullクラスを組み込む必要があるため、+ 1が必要です。masks_queries_logits (
torch.FloatTensor, オプション) — 各クエリに対する提案マスクを表す、形状が(batch_size, num_queries, height, width)のテンソル。auxiliary_logits (
Dict[str, torch.FloatTensor]、任意、output_auxiliary_logits=Trueの場合のみ返されます) — 補助損失が有効な場合、各デコーダ層の補助予測を含む辞書。encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, num_channels, height, width)) — エンコーダーモデル(バックボーン)の最終ステージの最終隠れ状態(最終特徴マップ)。pixel_decoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, num_channels, height, width)) — pixel decoder モデル(FPN)の最終ステージの最終 hidden states(最終 feature map)。transformer_decoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — Transformerデコーダーモデルの最終ステージの最後の隠れ状態(最終特徴マップ)。encoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。エンコーダモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。pixel_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, num_channels, height, width)です。ピクセルデコーダーモデルの各ステージの出力における隠れ状態(特徴マップとも呼ばれます)。transformer_decoder_hidden_states (
tuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込みの出力用 1 つ + 各ステージの出力用 1 つ)、形状は(batch_size, sequence_length, hidden_size)です。各ステージの出力における transformer decoder の hidden states です。 hidden_statestuple(torch.FloatTensor)、任意、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます:encoder_hidden_states、pixel_decoder_hidden_statesおよびdecoder_hidden_statesを含むtorch.FloatTensorのタプルです。hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
セマンティックセグメンテーションの例:
>>> from transformers import AutoImageProcessor, MaskFormerForInstanceSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on ADE20k semantic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-ade")
>>> model = MaskFormerForInstanceSegmentation.from_pretrained("facebook/maskformer-swin-base-ade")

>>> url = (
...     "https://huggingface.co/datasets/hf-internal-testing/fixtures_ade20k/resolve/main/ADE_val_00000001.jpg"
... )
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to image_processor for postprocessing
>>> predicted_semantic_map = image_processor.post_process_semantic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]

>>> # we refer to the demo notebooks for visualization (see "Resources" section in the MaskFormer docs)
>>> list(predicted_semantic_map.shape)
[512, 683]
パンノセグメンテーションの例:
>>> from transformers import AutoImageProcessor, MaskFormerForInstanceSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on COCO panoptic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-coco")
>>> model = MaskFormerForInstanceSegmentation.from_pretrained("facebook/maskformer-swin-base-coco")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to image_processor for postprocessing
>>> result = image_processor.post_process_panoptic_segmentation(outputs, target_sizes=[(image.height, image.width)])[0]

>>> # we refer to the demo notebooks for visualization (see "Resources" section in the MaskFormer docs)
>>> predicted_panoptic_map = result["segmentation"]
>>> list(predicted_panoptic_map.shape)
[480, 640]