
Transformers documentation
PoolFormer
このモデルは2021年11月22日にHF papersで公開され、2022年2月17日にHugging Face Transformersに貢献されました。
PoolFormer
概要
The PoolFormer model was proposed in MetaFormer is Actually What You Need for Vision by Sea AI Labs. Instead of designing complicated token mixer to achieve SOTA performance, the target of this work is to demonstrate the competence of transformer models largely stem from the general architecture MetaFormer.
論文の抄録は以下の通りです。
Transformers はコンピュータビジョンタスクにおいて大きな可能性を示しています。一般的には、アテンションベースのトークンミキサーモジュールがその能力に最も大きく寄与すると考えられています。しかし、最近の研究では、Transformers のアテンションベースモジュールを空間 MLP に置き換えても、得られるモデルは依然としてかなり良好な性能を発揮することが示されています。この観察に基づき、私たちは、モデルの性能にとってより本質的なのは、特定のトークンミキサーモジュールではなく、Transformers の一般的なアーキテクチャであるという仮説を立てました。これを検証するため、私たちは意図的に Transformers のアテンションモジュールを、非常に単純な空間プーリング演算子に置き換え、最も基本的なトークンミキシングのみを行うようにしました。驚くべきことに、導出されたモデルである PoolFormer は、複数のコンピュータビジョンタスクで競争力のある性能を達成していることが観察されました。例えば、ImageNet-1K では、PoolFormer は 82.1% の top-1 精度を達成し、適切にチューニングされた vision transformer/MLP 類似のベースラインである DeiT-B/ResMLP-B24 を、それぞれ 0.3%/1.1% の精度で上回ると同時に、パラメータ数を 35%/52% 削減し、MACs を 48%/60% 削減しています。PoolFormer の有効性は私たちの仮説を検証し、トークンミキサーを指定せずに Transformers から抽象化された一般的なアーキテクチャである「MetaFormer」という概念の提唱を促しました。広範な実験に基づき、私たちは、MetaFormer が、最近の vision タスクにおける transformer および MLP 類似モデルの優れた結果達成における鍵であると考えています。この研究は、トークンミキサーモジュールに焦点を当てるのではなく、MetaFormer の改善に特化した今後の研究を呼びかけています。さらに、提案した PoolFormer は、今後の MetaFormer アーキテクチャ設計の出発点となるベースラインとして機能し得ます。
下図は、PoolFormerのアーキテクチャを示しています。元の論文より引用。
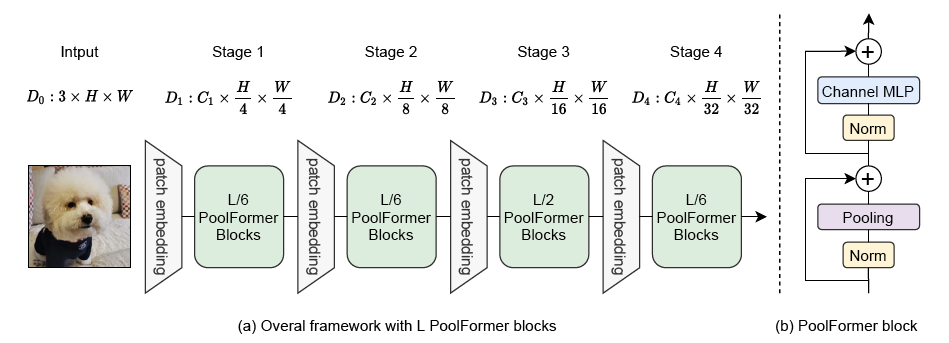
このモデルは heytanay によって提供されました。元のコードは こちら で確認できます。
使用のコツ
- PoolFormerは階層型アーキテクチャを備えており、Attentionの代わりにシンプルなAverage Pooling層が配置されています。このモデルのすべてのチェックポイントはhubで確認できます。
- モデル用の画像を準備するには、PoolFormerImageProcessorを使用できます。
- ほとんどのモデルと同様に、PoolFormerは異なるサイズが用意されており、その詳細は以下の表に記載されています。
| モデルのバリアント | 深度 | 隠れ層サイズ | パラメータ数 (M) | ImageNet-1k Top 1 |
|---|---|---|---|---|
| s12 | [2, 2, 6, 2] | [64, 128, 320, 512] | 12 | 77.2 |
| s24 | [4, 4, 12, 4] | [64, 128, 320, 512] | 21 | 80.3 |
| s36 | [6, 6, 18, 6] | [64, 128, 320, 512] | 31 | 81.4 |
| m36 | [6, 6, 18, 6] | [96, 192, 384, 768] | 56 | 82.1 |
| m48 | [8, 8, 24, 8] | [96, 192, 384, 768] | 73 | 82.5 |
リソース
PoolFormerの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです。
- PoolFormerForImageClassification は、この ノートブック でサポートされています。
- 関連項目: 画像分類タスクガイド
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
PoolFormerConfig
class transformers.PoolFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16stride: int = 16pool_size: int = 3mlp_ratio: float = 4.0depths: list[int] | tuple[int, ...] = (2, 2, 6, 2)hidden_sizes: list[int] | tuple[int, ...] = (64, 128, 320, 512)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)padding: list[int] | tuple[int, ...] = (2, 1, 1, 1)num_encoder_blocks: int = 4drop_path_rate: float | int = 0.0hidden_act: str = 'gelu'use_layer_scale: bool = Truelayer_scale_init_value: float = 1e-05initializer_range: float = 0.02 )
パラメータ
- num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは16) — 各パッチのサイズ(解像度)です。 - stride (
int、任意、デフォルトは 16) — 入力パッチのストライドです。 - pool_size (
int、任意、デフォルトは 3) — プーリングウィンドウのサイズです。 - mlp_ratio (
float、任意、デフォルトは4.0) — MLP の隠れ層の次元と埋め込み次元の比率です。 - depths (
Union[list[int], tuple[int, ...]]、任意、デフォルトは(2, 2, 6, 2)) — Transformerの各層の深さ。 - hidden_sizes (
Union[list[int], tuple[int, ...]]、任意、デフォルトは(64, 128, 320, 512)) — モデルの各ステージにおける次元数(hidden size)。 - patch_sizes (
list、任意、デフォルトは[7, 3, 3, 3]) — 各エンコーダーブロックのインプットパッチのサイズです。 - strides (
list、任意、デフォルトは[4, 2, 2, 2]) — 各エンコーダーブロックにおける入力パッチのストライドです。 - padding (
list、任意、デフォルトは[2, 1, 1, 1]) — 各エンコーダーブロックのインプットパッチのパディングです。 - num_encoder_blocks (
int、任意、デフォルトは 4) — エンコーダーブロックの数です。 - drop_path_rate (
Union[float, int]、任意、デフォルトは0.0) — パッチ融合におけるドロップパスの率。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - use_layer_scale (
bool、任意、デフォルトはTrue) — layer scale を使用するかどうか。 - layer_scale_init_value (
float、任意、デフォルトは1e-05) — 自己アテンション層で使用するスケール値です。base モデルでは 0.1、large モデルでは 1e-6 を使用します。0 に設定すると、layer scale が無効になります。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。
これは PoolFormerModel の設定を保存するための設定クラスです。指定された引数に基づいて Poolformer モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、sail/poolformer_s12 と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import PoolFormerConfig, PoolFormerModel

>>> # Initializing a PoolFormer sail/poolformer_s12 style configuration
>>> configuration = PoolFormerConfig()

>>> # Initializing a model (with random weights) from the sail/poolformer_s12 style configuration
>>> model = PoolFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PoolFormerImageProcessor
クラス transformers.PoolFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_poolformer.PoolFormerImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意、デフォルトはNone) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 224}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'height' -- 224, 'width': 224}):center_cropを適用した後の出力画像のサイズです。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool、kwargs、optional、デフォルトはTrue) — 画像を中央クロップするかどうか。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - crop_pct (
float、kwargs、任意、デフォルトはself.crop_pct) — 画像をクロップする割合。do_resizeがTrueに設定されている場合のみ有効です。
PoolFormerImageProcessor イメージプロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - image_like_kwargs (
dict[str, Any], 省略可) — 追加の画像類似入力を前処理対象に含めるための開発者向けフラグです。引数として入力値を渡す方法が機能しない場合のみ使用してください。例えば、preprocess(images, masks=masks)が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりにpreprocess(images, image_like_inputs={"masks": masks})を使用できます。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
PoolFormerImageProcessorPil
クラス transformers.PoolFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_pil_poolformer.PoolFormerImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意、デフォルトはNone) — 画像を RGB に変換するかどうか。 - do_resize (
bool、kwargs、任意、デフォルトはTrue) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'shortest_edge' -- 224}): モデルへの最大入力サイズを指定します。 - default_to_square (
bool、kwargs、任意、デフォルトはFalse) — size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs、デフォルトは{'height' -- 224, 'width': 224}):center_cropを適用した後の出力画像のサイズです。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs、デフォルトは3) — 画像のリサイズ時に使用するリサンプリングフィルタです。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ、効果が現れます。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.485, 0.456, 0.406]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.229, 0.224, 0.225]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool、kwargs、optional、デフォルトはTrue) — 画像を中央クロップするかどうか。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - crop_pct (
float、kwargs、任意、デフォルトはself.crop_pct) — 画像をクロップする割合。do_resizeがTrueに設定されている場合のみ有効です。
PoolFormerImageProcessor イメージプロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - image_like_kwargs (
dict[str, Any], 省略可) — 追加の画像類似入力を前処理対象に含めるための開発者向けフラグです。引数として入力値を渡す方法が機能しない場合のみ使用してください。例えば、preprocess(images, masks=masks)が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりにpreprocess(images, image_like_inputs={"masks": masks})を使用できます。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
PoolFormerModel
class transformers.PoolFormerModel
< source >( config: PoolFormerConfig )
パラメータ
- config (PoolFormerConfig) — モデルのパラメータをすべて含むモデル設定クラス。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する素のPoolformerモデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithNoAttention or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、shape(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は PoolFormerImageProcessor を使用して取得できます。詳細は PoolFormerImageProcessor.call() を参照してください(processor_classは画像の処理に PoolFormerImageProcessor を使用します)。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
BaseModelOutputWithNoAttention または tuple(torch.FloatTensor)
BaseModelOutputWithNoAttention、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)で、設定(PoolFormerConfig)や入力に応じて、さまざまな要素で構成されます。
PoolFormerModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, num_channels, height, width)) — モデルの最終層の出力における隠れ状態のシーケンス。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, num_channels, height, width)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
PoolFormerForImageClassification
クラス transformers.PoolFormerForImageClassification
< source >( config: PoolFormerConfig )
パラメータ
- config (PoolFormerConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
PoolFormer モデルは、その上に画像分類ヘッドを備えた transformer です
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は PoolFormerImageProcessor を使用して取得できます。詳細については PoolFormerImageProcessor.call() を参照してください(processor_classは画像の処理に PoolFormerImageProcessor を使用します)。 - labels (
torch.LongTensor、shape(batch_size,)、任意) — 画像分類/回帰の損失を計算するためのラベル。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels == 1の場合は回帰損失(平均二乗誤差)が計算され、config.num_labels > 1の場合は分類損失(クロスエントロピー)が計算されます。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
ImageClassifierOutputWithNoAttention または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)、または ImageClassifierOutputWithNoAttention。設定(PoolFormerConfig)や入力に応じて、さまざまな要素で構成されます。
PoolFormerForImageClassificationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。 - logits (
torch.FloatTensor、shape(batch_size, config.num_labels)) — SoftMax 適用前の分類スコア(config.num_labels==1 の場合は回帰スコア)。 - hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各ステージの出力用がそれぞれ 1 つずつ)で、形状は(batch_size, num_channels, height, width)です。各ステージの出力におけるモデルの隠れ状態(特徴マップとも呼ばれる)です。
例:
>>> from transformers import AutoImageProcessor, PoolFormerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("sail/poolformer_s12")
>>> model = PoolFormerForImageClassification.from_pretrained("sail/poolformer_s12")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...