
Transformers documentation
Swin2SR
このモデルは2022年9月22日にHF papersで公開され、2022年12月16日にHugging Face Transformersに貢献されました。
Swin2SR
概要
Swin2SRモデルは、Marcos V. Conde、Ui-Jin Choi、Maxime Burchi、Radu Timofte によって提案された Swin2SR: SwinV2 Transformer for Compressed Image Super-Resolution and Restoration に記載されています。 Swin2SRは、Swin Transformer v2 レイヤーを取り入れることで、SwinIR モデルを改善しています。これにより、トレーニングの不安定性、事前学習とファインチューニング間の解像度の乖離、データへの依存性といった問題が軽減されます。
論文の抄録は以下の通りです。
圧縮は、ストリーミングサービス、バーチャルリアリティ、ビデオゲームなどの帯域制限システムを介した画像や動画の効率的な伝送と保存において重要な役割を果たします。しかし、圧縮は必ずアーティファクトの発生や元の情報の損失を伴い、視覚的な品質を著しく低下させる可能性があります。これらの理由から、圧縮画像の品質向上は人気のある研究トピックとなっています。最新の画像復元手法の多くは畳み込みニューラルネットワークに基づいていますが、SwinIRなどの他のTransformerベースの手法も、これらのタスクにおいて印象的な性能を示しています。 本論文では、画像スーパーリゾリューション、特に圧縮入力シナリオにおけるSwinIRの改善のために、新しいSwin Transformer V2を探索します。この手法を用いることで、Transformerビジョンモデルの学習における主要な課題、すなわち学習の不安定性、事前学習とファインチューニング間の解像度のギャップ、そしてデータへの依存性を克服できます。JPEG圧縮アーティファクトの除去、画像スーパーリゾリューション(古典的および軽量)、圧縮画像スーパーリゾリューションという3つの代表的なタスクで実験を実施しました。実験結果は、私たちの手法であるSwin2SRがSwinIRの学習収束と性能を向上させ、「AIM 2022 Challenge on Super-Resolution of Compressed Image and Video」でトップ5のソリューションであることを示しています。
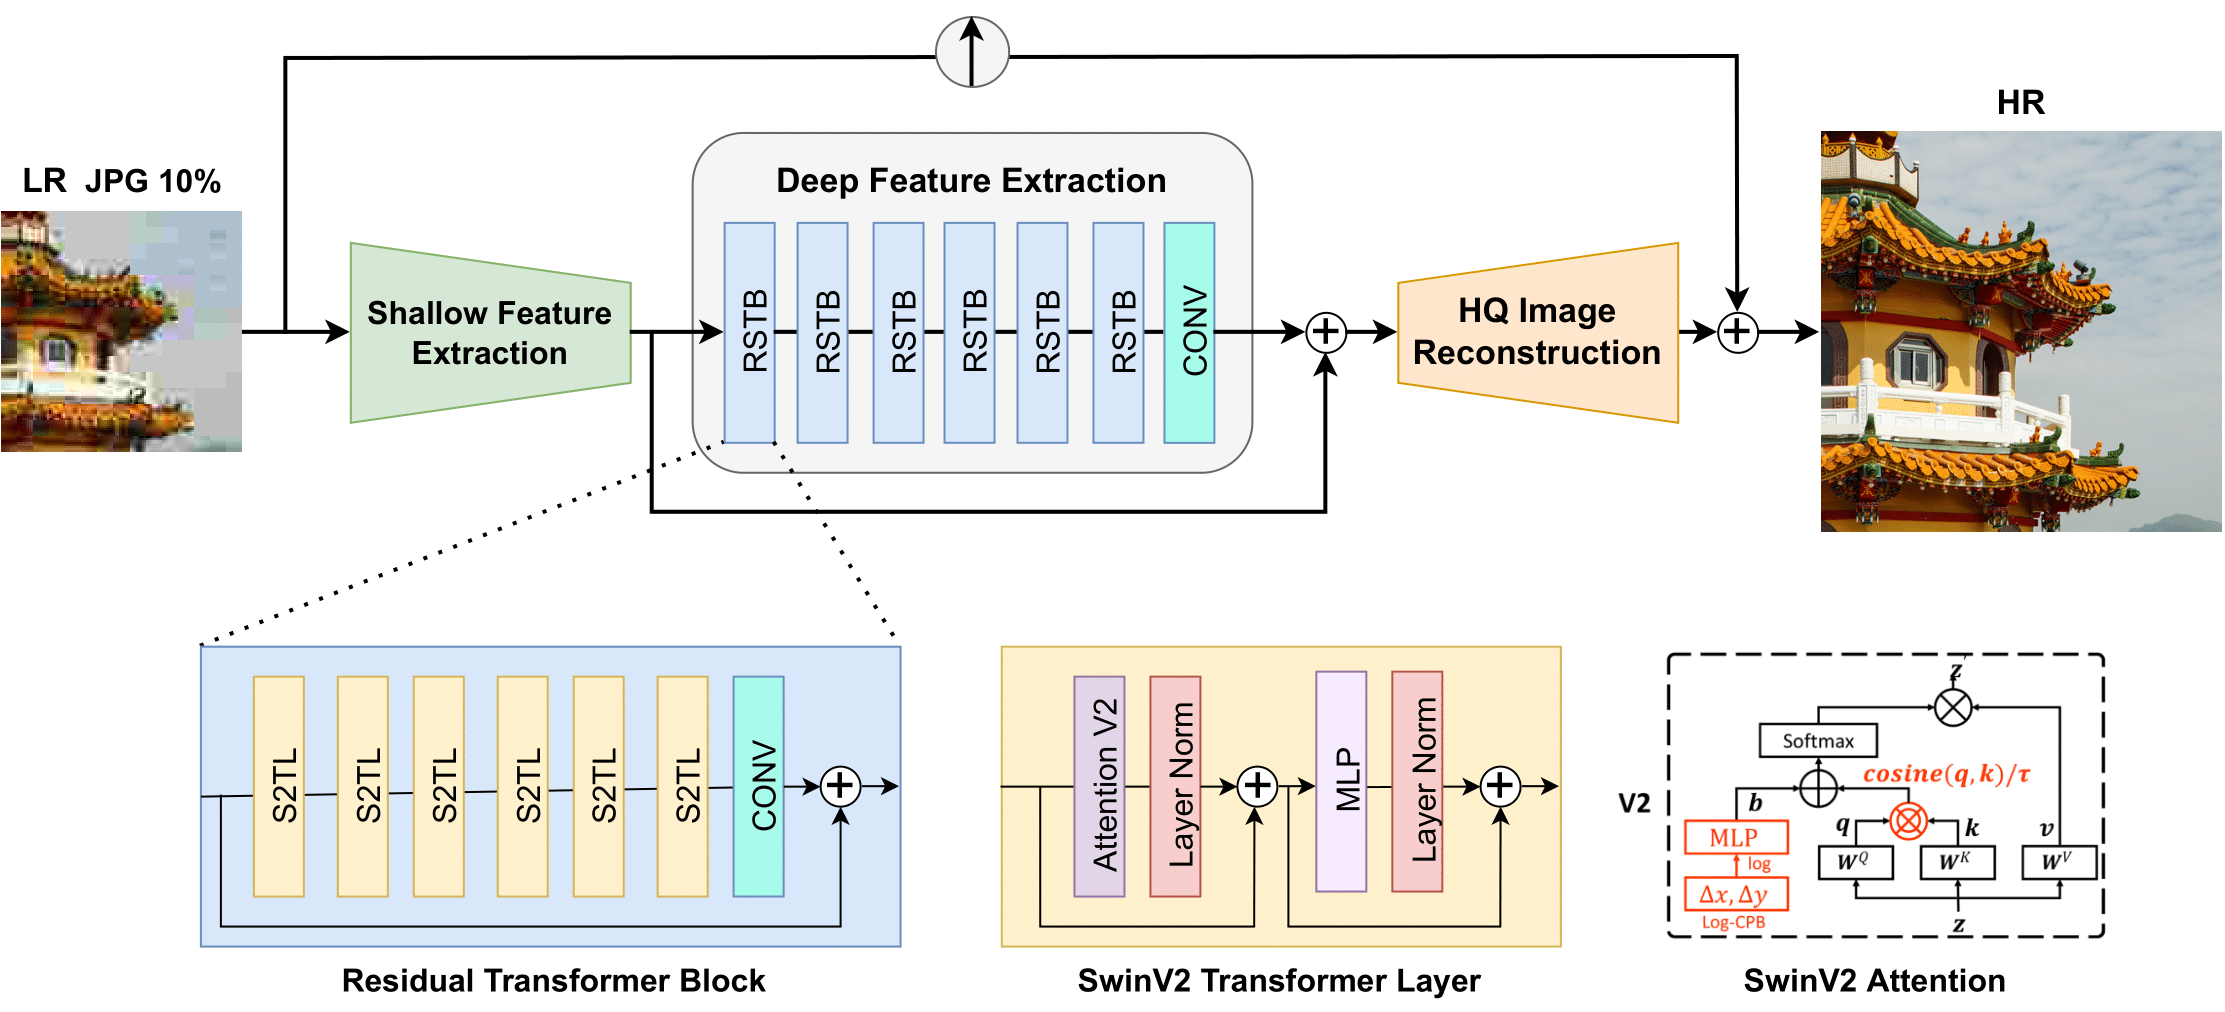 Swin2SR architecture. Taken from the original paper.
このモデルはnielsrによって提供されました。 元のコードはこちらで確認できます。
リソース
Swin2SRのデモノートブックはこちらで確認できます。
SwinSRによる画像超解像のデモSpaceはこちらで確認できます。
Swin2SRImageProcessor
class transformers.Swin2SRImageProcessor
< source >( **kwargs: *<class 'transformers.models.swin2sr.image_processing_swin2sr.Swin2SRImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool、kwargs、optional、デフォルトはTrue) — 画像をパディングするかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int, kwargs, optional, デフォルトはself.size_divisor) — パディングを行う際に、高さと幅を割り切れるようにするためのサイズです。
Swin2SRImageProcessor の画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.swin2sr.image_processing_swin2sr.Swin2SRImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int, kwargs, optional, デフォルトはself.size_divisor) — パディングを行う際に、高さと幅を割り切れるようにするためのサイズです。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
Swin2SRImageProcessorPil
クラス transformers.Swin2SRImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.swin2sr.image_processing_pil_swin2sr.Swin2SRImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool、kwargs、optional、デフォルトはTrue) — 画像をパディングするかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int, kwargs, optional, デフォルトはself.size_divisor) — パディングを行う際に、高さと幅を割り切れるようにするサイズです。
Swin2SRImageProcessor の画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.swin2sr.image_processing_pil_swin2sr.Swin2SRImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int, kwargs, optional, デフォルトはself.size_divisor) — パディングを行う際に、高さと幅を割り切れるようにするサイズです。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
Swin2SRConfig
クラス transformers.Swin2SRConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneimage_size: int | list[int] | tuple[int, int] = 64patch_size: int | list[int] | tuple[int, int] = 1num_channels: int = 3num_channels_out: int | None = Noneembed_dim: int = 180depths: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6)num_heads: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6)window_size: int = 8mlp_ratio: float = 2.0qkv_bias: bool = Truehidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0drop_path_rate: float | int = 0.1hidden_act: str = 'gelu'use_absolute_embeddings: bool = Falseinitializer_range: float = 0.02layer_norm_eps: float = 1e-05upscale: int = 2img_range: float = 1.0resi_connection: str = '1conv'upsampler: str = 'pixelshuffle' )
パラメータ
- image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは64) — 各画像のサイズ(解像度)。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは1) — 各パッチのサイズ(解像度)。 - num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - num_channels_out (
int、任意、デフォルトはnum_channels) — 出力チャネル数です。設定されていない場合、num_channelsに設定されます。 - embed_dim (
int、任意、デフォルトは180) — 埋め込みおよび隠れ状態の次元数。 - depths (
list(int)、任意、デフォルトは[6, 6, 6, 6, 6, 6]) — Transformer エンコーダーの各レイヤーの深さです。 - num_heads (
list(int)、任意、デフォルトは[6, 6, 6, 6, 6, 6]) — Transformerエンコーダーの各層におけるアテンションヘッドの数です。 - window_size (
int、任意、デフォルトは 8) — ウィンドウのサイズ。 - mlp_ratio (
float、任意、デフォルトは2.0) — MLP の隠れ層の次元と埋め込み次元の比率です。 - qkv_bias (
bool、省略可、デフォルトはTrue) — クエリ、キー、バリューにバイアスを追加するかどうか。 - hidden_dropout_prob (
Union[float, int]、任意、デフォルト値は0.0) — embeddings、encoder、pooler 内のすべての全結合層における dropout 確率です。 - attention_probs_dropout_prob (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - drop_path_rate (
Union[float, int]、省略可、デフォルトは0.1) — パッチ融合におけるドロップパス率。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - use_absolute_embeddings (
bool、任意、デフォルトはFalse) — 絶対位置埋め込みを使用するかどうか。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - layer_norm_eps (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - upscale (
int、任意、デフォルトは 2) — 画像のアップスケール係数です。画像スーパーレゾリューションには 2/3/4/8、ノイズ除去や圧縮アーティファクトの低減には 1 を指定します。 - img_range (
float、任意、デフォルト値は 1.0)— 入力画像の値の範囲です。 - resi_connection (
str、省略可、デフォルトは"1conv") — 各ステージの残差接続の前に使用する畳み込みブロックです。 - upsampler (
str、任意、デフォルトは"pixelshuffle") — 再構成モジュールです。‘pixelshuffle’/‘pixelshuffledirect’/‘nearest+conv’/None のいずれかを指定できます。
これは caidas/swin2sr-classicalsr-x2-64 と同様の設定をデフォルト値でインスタンス化した場合に得られる、Swin2SRModel の設定を保存するための設定クラスです。指定された引数に基づいて Swin2Sr モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import Swin2SRConfig, Swin2SRModel

>>> # Initializing a Swin2SR caidas/swin2sr-classicalsr-x2-64 style configuration
>>> configuration = Swin2SRConfig()

>>> # Initializing a model (with random weights) from the caidas/swin2sr-classicalsr-x2-64 style configuration
>>> model = Swin2SRModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Swin2SRModel
クラス transformers.Swin2SRModel
< source >( config: Swin2SRConfig )
パラメータ
- config (Swin2SRConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する素のSwin2Sr Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: FloatTensoroutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、shape(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は Swin2SRImageProcessor を使用して取得できます。詳細は Swin2SRImageProcessor.call() を参照してください(processor_classは画像の処理に Swin2SRImageProcessor を使用します)。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
BaseModelOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル、または BaseModelOutput (return_dict=False が渡された場合、または config.return_dict=False の場合)。設定 (Swin2SRConfig) と入力に応じて、さまざまな要素で構成されます。
Swin2SRModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
Swin2SRForImageSuperResolution
クラス transformers.Swin2SRForImageSuperResolution
< source >( config: Swin2SRConfig )
パラメータ
- config (Swin2SRConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
画像の超解像と復元のために、アップサンプラーヘッドを上部に備えたSwin2SRモデルのtransformerです。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageSuperResolutionOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は Swin2SRImageProcessor を使用して取得できます。詳細については Swin2SRImageProcessor.call() を参照してください(processor_classは画像の処理に Swin2SRImageProcessor を使用します)。 - labels (
torch.LongTensor、shape(batch_size, sequence_length)、任意) — マスク言語モデリング損失を計算するためのラベルです。インデックスは[0, ..., config.vocab_size]の範囲内であるか、-100 である必要があります(input_idsの docstring を参照)。インデックスが-100に設定されたトークンは無視(マスク)され、損失は[0, ..., config.vocab_size]の範囲内のラベルを持つトークンに対してのみ計算されます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
ImageSuperResolutionOutput または tuple(torch.FloatTensor)
ImageSuperResolutionOutput または、torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)。設定(Swin2SRConfig)や入力に応じて、さまざまな要素で構成されます。
Swin2SRForImageSuperResolutionのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 再構成損失。reconstruction (
torch.FloatTensor、shape(batch_size, num_channels, height, width)) — 再構成された画像(アップスケールされている場合あり)。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各ステージの出力用がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各ステージの出力におけるモデルの隠れ状態(特徴マップとも呼ばれます)。attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, patch_size, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>> from io import BytesIO

>>> from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution

>>> processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")

>>> url = "https://huggingface.co/spaces/jjourney1125/swin2sr/resolve/main/samples/butterfly.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> # prepare image for the model
>>> inputs = processor(image, return_tensors="pt")

>>> # forward pass
>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> output = outputs.reconstruction.data.squeeze().float().cpu().clamp_(0, 1).numpy()
>>> output = np.moveaxis(output, source=0, destination=-1)
>>> output = (output * 255.0).round().astype(np.uint8)  # float32 to uint8
>>> # you can visualize `output` with `Image.fromarray`