
Transformers documentation
ViTMatte
このモデルは2023年5月24日にHF papersで公開され、2023年9月19日にHugging Face Transformersに貢献されました。
ViTMatte
概要
ViTMatteモデルは、Jingfeng Yao、Xinggang Wang、Shusheng Yang、Baoyuan Wang による論文 Boosting Image Matting with Pretrained Plain Vision Transformers で提案されました。 ViTMatteは、画像や動画における前景オブジェクトを正確に推定するプロセスである画像マッティングのタスクに、プレーンな Vision Transformers を活用しています。
論文の抄録は以下の通りです。
最近、強力なモデリング能力と大規模な事前学習のおかげで、プレーンなビジョンTransformer(ViT)はさまざまなコンピュータビジョンタスクにおいて目覚ましい性能を示しています。しかし、画像マッティングの問題についてはまだ解決されていません。画像マッティングもViTによって性能向上が期待できると仮定し、ViTベースの新しい効率的かつ頑健なマッティングシステム「ViTMatte」を提案します。本手法では、(i) マッティングタスクにおいてViTが優れた性能と計算量のトレードオフを実現できるよう、ハイブリッドなアテンション機構とコンボリューションネックを組み合わせます。(ii) さらに、マッティングに必要な詳細情報を補完するための詳細キャプチャモジュールを導入します。これは単純な軽量なコンボリューションのみで構成されています。我々の知る限り、ViTMatteは簡潔な適応によりViTのポテンシャルを画像マッティングで解き放つ初の取り組みです。ViTからマッティングへ、さまざまな事前学習戦略、簡潔なアーキテクチャ設計、柔軟な推論戦略など、多くの優れた特性を継承しています。画像マッティングで最もよく使われるベンチマークであるComposition-1kとDistinctions-646でViTMatteを評価したところ、本手法は最先端の性能を達成し、従来のマッティング手法を大きく上回りました。
このモデルはnielsrによって提供されました。 元のコードはこちらで確認できます。
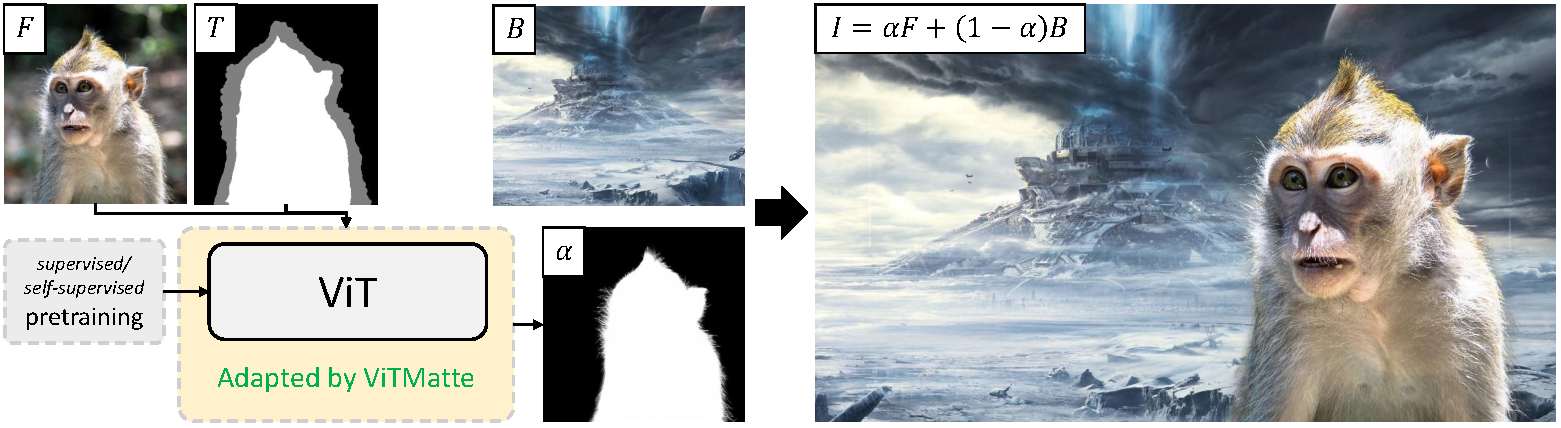 ViTMatte high-level overview. Taken from the original paper.
リソース
ViTMatteの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示す)のリソースのリストです。
- VitMatteForImageMattingを用いた推論に関するデモノートブック(背景の差し替えを含む)は、こちらで確認できます。
モデルは、画像とトリマップ(連結済み)の両方を入力として期待します。この目的には
ViTMatteImageProcessorを使用してください。
VitMatteConfig
クラス transformers.VitMatteConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonehidden_size: int = 384batch_norm_eps: float = 1e-05initializer_range: float = 0.02convstream_hidden_sizes: list[int] | tuple[int, ...] = (48, 96, 192)fusion_hidden_sizes: list[int] | tuple[int, ...] = (256, 128, 64, 32) )
パラメータ
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - hidden_size (
int、任意、デフォルトは384) — 隠れ表現の次元数。 - batch_norm_eps (
float、任意、デフォルトは 1e-05) — バッチ正規化レイヤーで使用する epsilon です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - convstream_hidden_sizes (
list[int]、任意、デフォルトは[48, 96, 192]) — ConvStream モジュールの出力チャネル数です。 - fusion_hidden_sizes (
list[int]、任意、デフォルトは[256, 128, 64, 32]) — Fusion ブロックの出力チャネル数です。
これは VitmatteModel の設定を保存するための設定クラスです。指定された引数に基づいて Vitmatte モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、hustvl/vitmatte-small-composition-1k と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import VitMatteConfig, VitMatteForImageMatting

>>> # Initializing a ViTMatte hustvl/vitmatte-small-composition-1k style configuration
>>> configuration = VitMatteConfig()

>>> # Initializing a model (with random weights) from the hustvl/vitmatte-small-composition-1k style configuration
>>> model = VitMatteForImageMatting(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
VitMatteImageProcessor
class transformers.VitMatteImageProcessor
< source >( **kwargs: *<class 'transformers.models.vitmatte.image_processing_vitmatte.VitMatteImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、任意、デフォルトは[0.5, 0.5, 0.5]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.5, 0.5, 0.5]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool、kwargs、optional、デフォルトはTrue) — 画像をパディングするかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int、kwargs、任意、デフォルトはself.size_divisor) — 画像の幅と高さは、この数で割り切れるようにパディングされます。
VitMatteImageProcessor の画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.vitmatte.image_processing_vitmatte.VitMatteImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - trimaps (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理を行うトリマップです。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int、kwargs、任意、デフォルトはself.size_divisor) — 画像の幅と高さは、この数で割り切れるようにパディングされます。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
VitMatteImageProcessorPil
class transformers.VitMatteImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.vitmatte.image_processing_pil_vitmatte.VitMatteImageProcessorKwargs'> )
パラメータ
- do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意、デフォルトはTrue) — size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうかを指定します。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、任意、デフォルトはTrue) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意、デフォルト値は0.00392156862745098) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数です。 - do_normalize (
bool、kwargs、optional、デフォルトはTrue) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、任意、デフォルトは[0.5, 0.5, 0.5]) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]]、kwargs、optional、デフォルト値は[0.5, 0.5, 0.5]) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool、kwargs、optional、デフォルトはTrue) — 画像をパディングするかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int、kwargs、任意、デフォルトはself.size_divisor) — 画像の幅と高さは、この数で割り切れるようにパディングされます。
VitMatteImageProcessor の画像プロセッサを構築します。
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.vitmatte.image_processing_pil_vitmatte.VitMatteImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - trimaps (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — 前処理対象のトリマップです。 - do_convert_rgb (
bool、kwargs、任意) — 画像を RGB に変換するかどうかを指定します。 - do_resize (
bool、kwargs、optional) — 画像をリサイズするかどうか。 - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — モデルへの最大入力次元を記述します。 - default_to_square (
bool、kwargs、任意) — サイズが整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。 - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropを適用した後の出力画像のサイズ。 - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 画像のリサイズ時に使用するリサンプリングフィルタ。PILImageResamplingの列挙型のいずれかを使用できます。do_resizeがTrueに設定されている場合のみ有効です。 - do_rescale (
bool、kwargs、optional) — 画像をリスケールするかどうかを指定します。 - rescale_factor (
float、kwargs、任意) —do_rescaleがTrueに設定されている場合、画像をリスケールするための係数。 - do_normalize (
bool, kwargs, optional) — 画像を正規化するかどうかを指定します。 - image_mean (
Union[float, list[float], tuple[float, ...]]、kwargs、optional) — 正規化に使用する画像の平均値。do_normalizeがTrueに設定されている場合のみ有効です。 - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — 正規化に使用する画像の標準偏差。do_normalizeがTrueに設定されている場合のみ有効です。 - do_pad (
bool, kwargs, optional) — 画像をパディングするかどうかを指定します。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。具体的なパディング戦略はモデルによって異なります。 - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 画像をパディングする{"height": int, "width" int}のサイズです。前処理に提供されるすべての画像サイズより大きくなければなりません。pad_sizeが指定されない場合、バッチ内の最大の幅と高さにパディングされます。do_pad=True.の場合のみ適用されます。 - do_center_crop (
bool, kwargs, optional) — 画像を中央クロップするかどうかを指定します。 - data_format (
Union[str, ~image_utils.ChannelDimension]、kwargs、任意) — サポートされているのはChannelDimension.FIRSTのみです。slow processors との互換性のために追加されました。 - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 省略可) — 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推測されます。次のいずれかになります:"channels_first"またはChannelDimension.FIRST: (num_channels, height, width) 形式の画像。"channels_last"またはChannelDimension.LAST: (高さ, 幅, チャネル数) 形式の画像。"none"またはChannelDimension.NONE: (height, width) 形式の画像。
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。 - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。 - disable_grouping (
bool、kwargs、任意) — サイズごとに画像をグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうか。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている経験則に基づいています。 - image_seq_length (
int、kwargs、任意) — 入力内の各画像に使用される画像トークンの数です。 後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。 - size_divisor (
int、kwargs、任意、デフォルトはself.size_divisor) — 画像の幅と高さは、この数で割り切れるようにパディングされます。
戻り値
~image_processing_base.BatchFeature
- data (
dict) — call メソッド(‘pixel_values’ など)によって返される、リスト/配列/テンソルの辞書。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
VitMatteForImageMatting
class transformers.VitMatteForImageMatting
< source >( config: VitMatteConfig )
パラメータ
- config (VitMatteConfig) — モデルのパラメータをすべて含む、モデルの設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ADE20kやCityScapesなどの任意のビジョンバックボーンを活用するViTMatteフレームワーク。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs )
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は VitMatteImageProcessor を使用して取得できます。詳細については VitMatteImageProcessor.call() を参照してください(processor_classは画像の処理に VitMatteImageProcessor を使用します)。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、形状(batch_size, height, width)、任意) — 損失の計算に使用する正解画像のマットングです。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
VitMatteForImageMattingのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
例:
>>> from transformers import VitMatteImageProcessor, VitMatteForImageMatting
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download

>>> processor = VitMatteImageProcessor.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> model = VitMatteForImageMatting.from_pretrained("hustvl/vitmatte-small-composition-1k")

>>> filepath = hf_hub_download(
...     repo_id="hf-internal-testing/image-matting-fixtures", filename="image.png", repo_type="dataset"
... )
>>> image = Image.open(filepath).convert("RGB")
>>> filepath = hf_hub_download(
...     repo_id="hf-internal-testing/image-matting-fixtures", filename="trimap.png", repo_type="dataset"
... )
>>> trimap = Image.open(filepath).convert("L")

>>> # prepare image + trimap for the model
>>> inputs = processor(images=image, trimaps=trimap, return_tensors="pt")

>>> with torch.no_grad():
...     alphas = model(**inputs).alphas
>>> print(alphas.shape)
torch.Size([1, 1, 640, 960])