
Transformers documentation
UPerNet
このモデルは2018年7月26日にHF papersで公開され、2023年1月16日にHugging Face Transformersに貢献されました。
UPerNet
概要
UPerNetモデルは、Tete Xiao、Yingcheng Liu、Bolei Zhou、Yuning Jiang、Jian Sun による Unified Perceptual Parsing for Scene Understanding で提案されました。UPerNetは、ConvNeXt や Swin などの任意のビジョンバックボーンを活用して、画像から幅広い概念を効果的にセグメントするための汎用的なフレームワークです。
論文の抄録は以下の通りです。
人間は複数のレベルで視覚的世界を認識しています。シーン(場面)を分類し、その中のオブジェクトを検出することは容易ですが、同時にオブジェクトのテクスチャや表面、そしてそれらを構成する異なる部分も識別しています。本論文では、Unified Perceptual Parsing という新しいタスクを研究します。このタスクでは、与えられた画像から可能な限り多くの視覚的概念を認識することが機械ビジョンシステムに求められます。異質な画像アノテーションから学習するために、マルチタスクフレームワークである UPerNet と学習戦略を開発しました。Unified Perceptual Parsing においてフレームワークをベンチマークし、画像から幅広い概念を効果的にセグメントできることを示しました。訓練されたネットワークは、さらに自然なシーンにおける視覚的知識の発見に応用されています。
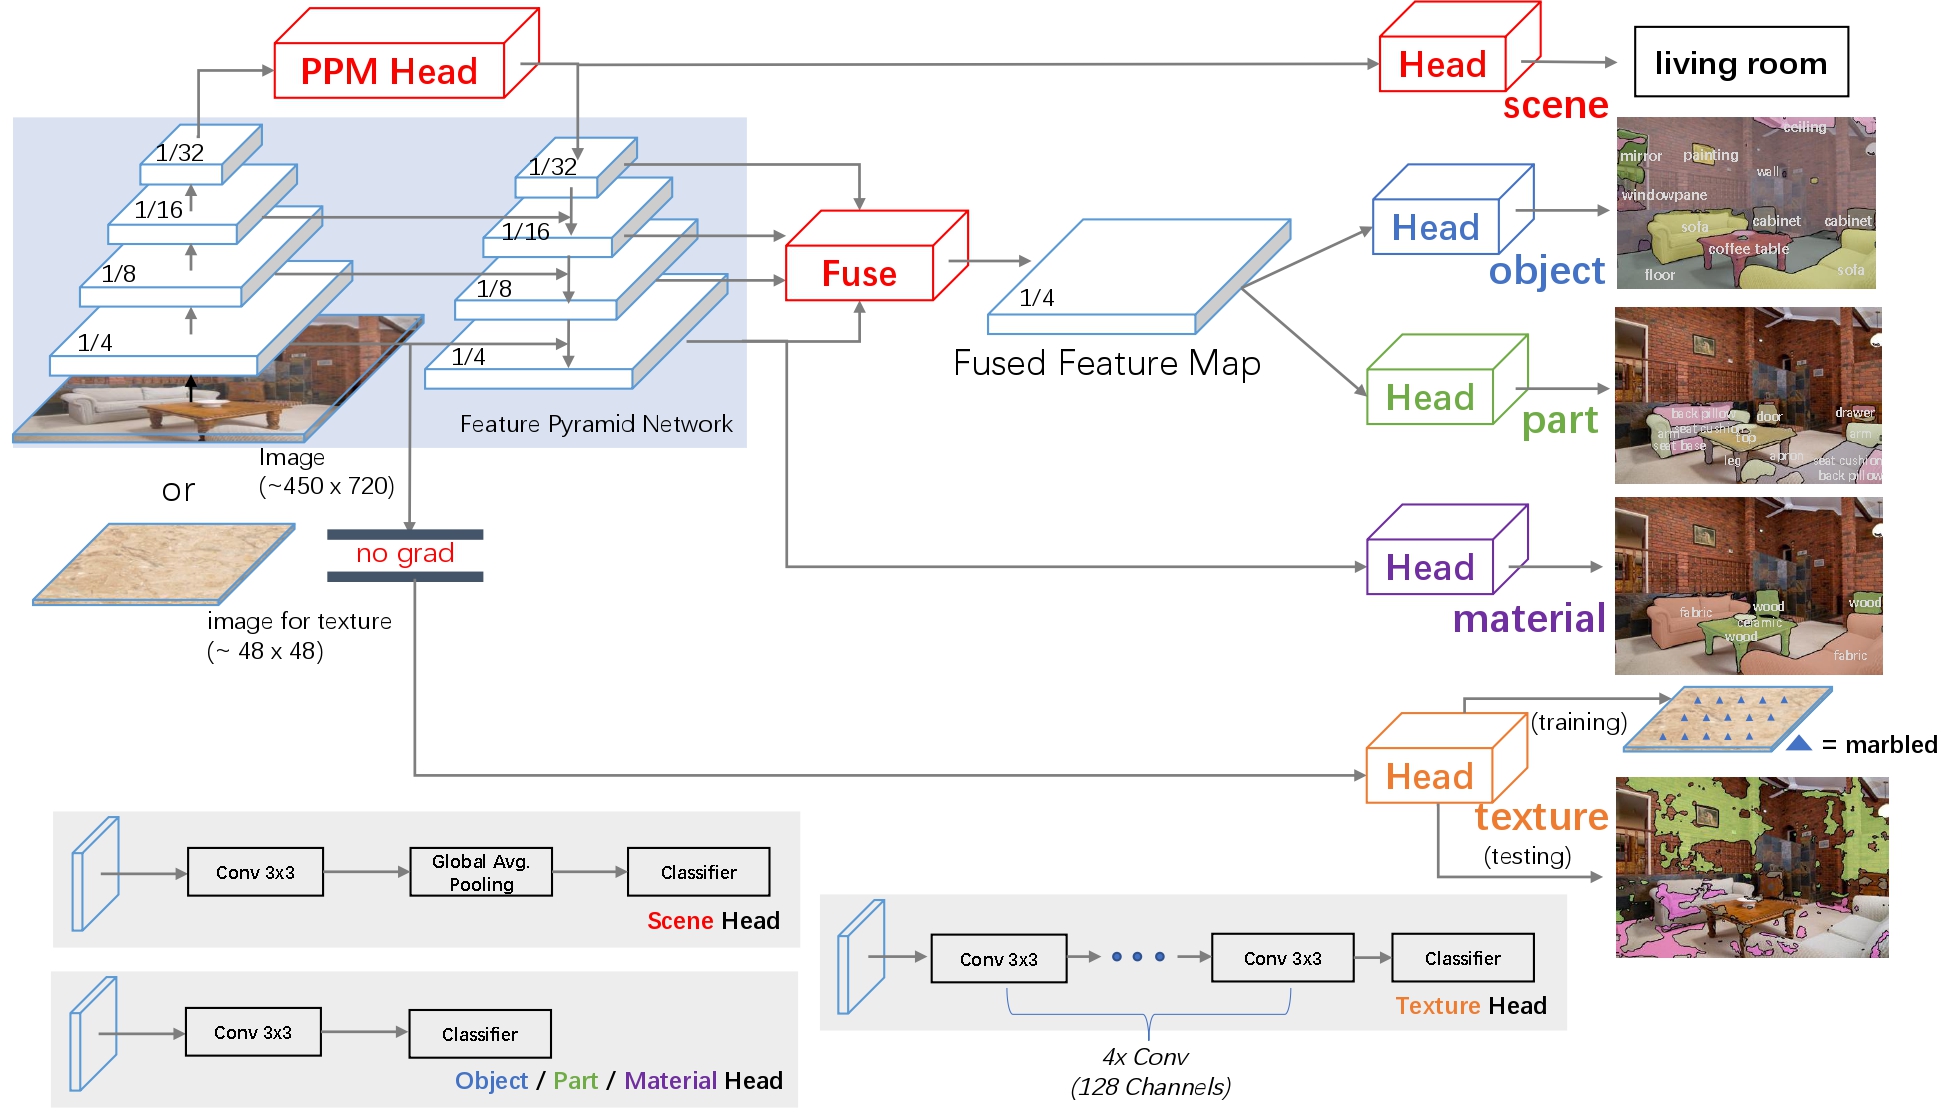 UPerNet framework. Taken from the original paper.
このモデルは nielsr によって提供されました。元のコードは OpenMMLab の mmsegmentation に基づいており、こちら で確認できます。
使用例
UPerNetはセマンティックセグメンテーションのための汎用的なフレームワークです。以下のように、任意のビジョンバックボーンと組み合わせて使用できます。
from transformers import SwinConfig, UperNetConfig, UperNetForSemanticSegmentation


backbone_config = SwinConfig(out_features=["stage1", "stage2", "stage3", "stage4"])

config = UperNetConfig(backbone_config=backbone_config)
model = UperNetForSemanticSegmentation(config)
ConvNeXt などの別のビジョンバックボーンを使用するには、適切なバックボーンを指定してモデルをインスタンス化してください。
from transformers import ConvNextConfig, UperNetConfig, UperNetForSemanticSegmentation


backbone_config = ConvNextConfig(out_features=["stage1", "stage2", "stage3", "stage4"])

config = UperNetConfig(backbone_config=backbone_config)
model = UperNetForSemanticSegmentation(config)
これはモデルのすべての重みをランダムに初期化します。
リソース
🌎でコミュニティのものを示し、UPerNetの入門を支援する公式Hugging Faceおよびコミュニティのリソースのリストです。
- UPerNetのデモノートブックはこちらで確認できます。
- UperNetForSemanticSegmentation は、この ノートブック でサポートされています。
- 関連項目: セマンティックセグメンテーションタスクガイド
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
UperNetConfig
class transformers.UperNetConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonehidden_size: int = 512initializer_range: float = 0.02pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6)use_auxiliary_head: bool = Trueauxiliary_loss_weight: float = 0.4auxiliary_in_channels: int | None = Noneauxiliary_channels: int = 256auxiliary_num_convs: int = 1auxiliary_concat_input: bool = Falseloss_ignore_index: int = 255 )
パラメータ
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - hidden_size (
int、任意、デフォルトは512) — 隠れ表現の次元数。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - pool_scales (
tuple[int]、任意、デフォルトは[1, 2, 3, 6]) — 最後のフィーチャマップに適用される Pooling Pyramid Module で使用されるプーリングスケールです。 - use_auxiliary_head (
bool、任意、デフォルトはTrue) — 学習中に補助ヘッドを使用するかどうか。 - auxiliary_loss_weight (
float、任意、デフォルト値は 0.4)— 補助ヘッドのクロスエントロピー損失の重み。 - auxiliary_in_channels (
int、省略可、デフォルトは 256) — 補助ヘッドの入力チャネル数。 - auxiliary_channels (
int, 任意、デフォルトは 256) — 補助ヘッドで使用するチャネル数。 - auxiliary_num_convs (
int、任意、デフォルト値は 1) — 補助ヘッドで使用する畳み込み層の数。 - auxiliary_concat_input (
bool、省略可、デフォルトはFalse) — 分類層の前に、補助ヘッドの出力を入力と連結するかどうかを指定します。 - loss_ignore_index (
int、省略可能、デフォルト値は 255) — 損失関数によって無視されるインデックスです。
これは UpernetModel の設定を保存するための設定クラスです。指定された引数に基づいて Upernet モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、openmmlab/upernet-convnext-tiny と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import UperNetConfig, UperNetForSemanticSegmentation

>>> # Initializing a configuration
>>> configuration = UperNetConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = UperNetForSemanticSegmentation(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
UperNetForSemanticSegmentation
class transformers.UperNetForSemanticSegmentation
< source >( config: UperNetConfig )
パラメータ
- config (UperNetConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを確認してください。
ADE20kやCityScapesなど、任意のビジョンバックボーンを活用するUperNetフレームワーク。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs ) → SemanticSegmenterOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は SegformerImageProcessor を使用して取得できます。詳細については SegformerImageProcessor.call() を参照してください(processor_classは画像の処理に SegformerImageProcessor を使用します)。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - labels (
torch.LongTensor、shape(batch_size, height, width)、任意) — 損失の計算に使用する正解のセマンティックセグメンテーションマップです。インデックスは[0, ..., config.num_labels - 1]の範囲である必要があります。config.num_labels > 1の場合、分類損失(Cross-Entropy)が計算されます。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
SemanticSegmenterOutput または tuple(torch.FloatTensor)
torch.FloatTensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)または SemanticSegmenterOutput。設定(UperNetConfig)と入力に応じて、さまざまな要素で構成されます。
UperNetForSemanticSegmentationのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — 分類損失(config.num_labels==1 の場合は回帰損失)。logits (
torch.FloatTensor、形状(batch_size, config.num_labels, logits_height, logits_width)) — 各ピクセルの分類スコアです。pixel_valuesとして入力に渡されたものと同じサイズであるとは限らない logits が返されます。これは、ユーザーが後処理として logits を元の画像サイズにリサイズする必要がある場合に、2回の補間処理を行って品質を失うことを避けるためです。常に logits の形状を確認し、必要に応じてリサイズしてください。hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, patch_size, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, patch_size, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoImageProcessor, UperNetForSemanticSegmentation
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download

>>> image_processor = AutoImageProcessor.from_pretrained("openmmlab/upernet-convnext-tiny")
>>> model = UperNetForSemanticSegmentation.from_pretrained("openmmlab/upernet-convnext-tiny")

>>> filepath = hf_hub_download(
...     repo_id="hf-internal-testing/fixtures_ade20k", filename="ADE_val_00000001.jpg", repo_type="dataset"
... )
>>> image = Image.open(filepath).convert("RGB")

>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)

>>> logits = outputs.logits  # shape (batch_size, num_labels, height, width)
>>> list(logits.shape)
[1, 150, 512, 512]