
Transformers documentation
SAM-HQ
このモデルは2023年6月2日にHF papersで公開され、2025年4月28日にHugging Face Transformersに貢献されました。
SAM-HQ
概要
SAM-HQ (High-Quality Segment Anything Model) は、Lei Ke、Mingqiao Ye、Martin Danelljan、Yifan Liu、Yu-Wing Tai、Chi-Keung Tang、Fisher Yu によって Segment Anything in High Quality で提案されました。
このモデルは、元のSAMモデルの強化版であり、SAMの元のプロンプト可能設計、効率性、ゼロショット汎用性を維持しながら、はるかに高品質なセグメンテーションマスクを生成します。
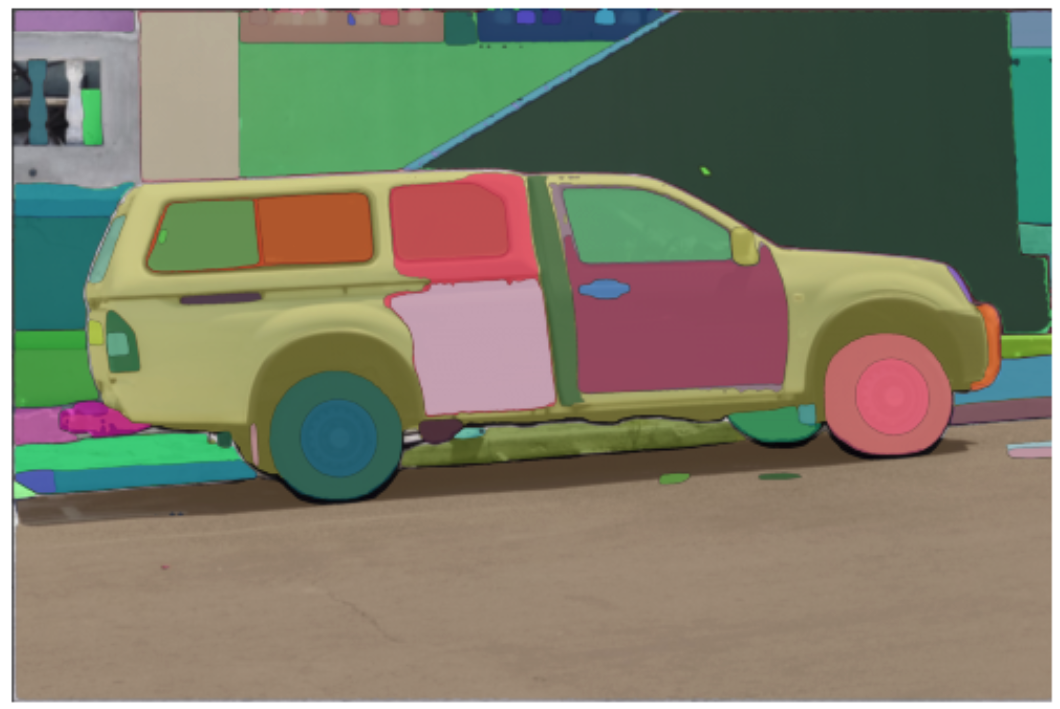
SAM-HQは、元のSAMモデルに対していくつかの重要な改善を導入しています:
- 高品質な出力トークン: より高品質なマスク予測のためにSAMのマスクデコーダーに注入される学習可能なトークン
- グローバル・ローカル特徴融合: モデルの異なる段階からの特徴を組み合わせることで、マスクの詳細を改善します
- 学習データ: SA-1Bではなく、44Kの高品質なマスクからなる慎重にキュレーションされたデータセットを使用します
- 効率性: マスクの品質を大幅に向上させながら、追加パラメータはわずか0.5%のみ
- Zero-shot 能力: SAM の優れた Zero-shot 性能を維持しつつ、精度を向上させます
論文の抄録は以下の通りです。
最近登場した Segment Anything Model (SAM) は、セグメンテーションモデルのスケーリングにおいて大きな飛躍を遂げ、強力なゼロショット機能と柔軟なプロンプティングを可能にしました。11億個のマスクで訓練されているにもかかわらず、SAM のマスク予測品質は多くの場合で不足しており、特に複雑な構造を持つオブジェクトを扱う際に顕著です。我々は HQ-SAM を提案し、SAM の元のプロンプタブルな設計、効率性、ゼロショット汎化性を維持したまま、任意のオブジェクトを正確にセグメントする能力を SAM に付与します。我々の慎重な設計により、SAM の事前学習済みモデルの重みは再利用・保持され、追加されるパラメータと計算量は最小限に抑えられます。学習可能な High-Quality Output Token を設計し、これを SAM のマスクデコーダに注入することで、高品質なマスクの予測を担当させます。マスクデコーダの特徴量にのみ適用するのではなく、マスクの詳細を向上させるため、まず初期および最終的な ViT 特徴量と融合させます。導入した学習可能なパラメータを訓練するために、複数のソースから 44K 個の細粒度マスクで構成されるデータセットを作成しました。HQ-SAM はこの 44k マスクのデータセットのみで訓練され、8 つの GPU 上でわずか 4 時間で完了します。
ヒント:
- SAM-HQ は、元の SAM モデルよりも高品質なマスクを生成します。特に、複雑な構造や細部を持つオブジェクトにおいてその優位性が顕著です。
- モデルは、より正確な境界線と、細い構造のより良い処理により、バイナリマスクを予測します
- SAMと同様に、このモデルは入力として2Dの点および/またはバウンディングボックスを与えることで、より高いパフォーマンスを発揮します。
- 同じ画像に対して複数のポイントをプロンプトとして指定し、1つの高品質なマスクを予測できます
- モデルはSAMのゼロショット汎化能力を維持します
- SAM-HQ は SAM と比べて、パラメータが約 0.5% しか増加しません
- モデルのファインチューニングは現在サポートされていません
このモデルは sushmanth によって提供されました。 元のコードは こちら で確認できます。
画像と2次元の点を与えてマスクを生成する方法の例を以下に示します。
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
プロセッサでは、入力画像と並行して独自のマスクも処理し、モデルに渡すことができます。
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
リソース
SAM-HQの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです:
- モデルの使用方法を示すデモノートブック(近日公開予定)
- 論文の実装とコード: SAM-HQ GitHub リポジトリ
SamHQConfig
class transformers.SamHQConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
パラメータ
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig]、任意) — ビジョンバックボーンの config オブジェクトまたは辞書です。 - prompt_encoder_config (Union[
dict,SamHQPromptEncoderConfig], 省略可) — SamHQPromptEncoderConfigを初期化するために使用される設定オプションの辞書です。 - mask_decoder_config (Union[
dict,SamHQMaskDecoderConfig], 省略可) — SamHQMaskDecoderConfigを初期化するために使用される設定オプションの辞書です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - tie_word_embeddings (
bool、任意、デフォルトはTrue) — モデルのtied_weights_keysマッピングに従って重み埋め込みを共有するかどうかを指定します。
これは SamHQModel の設定を保存するための設定クラスです。指定された引数に基づいて Sam Hq モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、syscv-community/sam-hq-vit-base と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
SamHQVisionConfig
class transformers.SamHQVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
パラメータ
- hidden_size (
int、任意、デフォルトは768) — 隠れ表現の次元数。 - output_channels (
int、任意、デフォルトは 256) — Patch Encoder の出力チャネルの次元数。 - num_hidden_layers (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは12) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは1024) — 各画像のサイズ(解像度)です。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは16) — 各パッチのサイズ(解像度)です。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - layer_norm_eps (
float、任意、デフォルトは1e-06) — レイヤーノーマル層で使用する epsilon です。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - initializer_range (
float、任意、デフォルトは1e-10) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - qkv_bias (
bool、省略可、デフォルトはTrue) — クエリ、キー、バリューにバイアスを追加するかどうか。 - mlp_ratio (
float、任意、デフォルトは4.0) — MLP の隠れ層の次元と埋め込み次元の比率です。 - use_abs_pos (
bool、任意、デフォルトはTrue) — 絶対位置埋め込みを使用するかどうか。 - use_rel_pos (
bool、任意、デフォルトはTrue) — 相対位置埋め込みを使用するかどうかを指定します。 - window_size (
int, 任意、デフォルト値は 14)— 相対位置のウィンドウサイズです。 - global_attn_indexes (
list[int]、任意、デフォルトは[2, 5, 8, 11]) — グローバルアテンションレイヤーのインデックスです。 - num_pos_feats (
int、任意、デフォルトは 128) — 位置埋め込みの次元数です。 - mlp_dim (
int, 任意) — Transformer エンコーダーにおける MLP レイヤーの次元数です。Noneの場合、デフォルトでmlp_ratio * hidden_sizeになります。
これは SamHQModel の設定を保存するための設定クラスです。指定された引数に基づいて Sam Hq モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、syscv-community/sam-hq-vit-base と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import (
...     SamHQVisionConfig,
...     SamHQVisionModel,
... )

>>> # Initializing a SamHQVisionConfig with `"facebook/sam_hq-vit-huge"` style configuration
>>> configuration = SamHQVisionConfig()

>>> # Initializing a SamHQVisionModel (with random weights) from the `"facebook/sam_hq-vit-huge"` style configuration
>>> model = SamHQVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamHQMaskDecoderConfig
class transformers.SamHQMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06vit_dim: int = 768 )
パラメータ
- hidden_size (
int、任意、デフォルトは256) — 隠れ表現の次元数。 - hidden_act (
str、任意、デフォルトはrelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - mlp_dim (
int、任意、デフォルト値は 2048) — Transformer エンコーダーにおける「中間」(すなわちフィードフォワード) 層の次元数。 - num_hidden_layers (
int、任意、デフォルトは2) — Transformerデコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは8) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - attention_downsample_rate (
int、任意、デフォルトは 2) — アテンション層のダウンサンプリング率です。 - num_multimask_outputs (
int、任意、デフォルトは 3) —SamMaskDecoderモジュールからの出力数です。Segment Anything の論文では、この値は 3 に設定されています。 - iou_head_depth (
int、任意、デフォルトは 3) — IoU ヘッドモジュールの層数です。 - iou_head_hidden_dim (
int, 任意、デフォルトは 256) — IoU head モジュールにおける隠れ状態の次元数です。 - layer_norm_eps (
float、任意、デフォルトは1e-06) — レイヤーノーマル層で使用する epsilon です。 - vit_dim (
int、任意、デフォルト値は 768) —SamHQMaskDecoderモジュールで使用される Vision Transformer (ViT) の次元数。
これは SamHQModel の設定を保存するための設定クラスです。指定された引数に基づいて Sam Hq モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、syscv-community/sam-hq-vit-base と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
SamHQPromptEncoderConfig
class transformers.SamHQPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
パラメータ
- hidden_size (
int、任意、デフォルトは256) — 隠れ表現の次元数。 - image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは1024) — 各画像のサイズ(解像度)です。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは16) — 各パッチのサイズ(解像度)です。 - mask_input_channels (
int、任意、デフォルトは 16)—MaskDecoderモジュールに渡すチャネル数です。 - num_point_embeddings (
int、任意、デフォルトは 4) — 使用する point embeddings の数です。 - hidden_act (
str、任意、デフォルトはgelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - layer_norm_eps (
float、任意、デフォルトは1e-06) — レイヤーノーマル層で使用する epsilon です。
これは SamHQModel の設定を保存するための設定クラスです。指定された引数に基づいて Sam Hq モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、syscv-community/sam-hq-vit-base と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
SamHQProcessor
class transformers.SamHQProcessor
< source >( image_processor )
画像プロセッサーを単一のプロセッサーにラップするSamHQProcessorを構築します。
SamHQProcessor は SamImageProcessor のすべての機能を提供します。詳細については、~SamImageProcessor を参照してください。
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam_hq.processing_sam_hq.SamHQProcessorKwargs'> ) → ~feature_extraction_utils.BatchFeature
パラメータ
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], 任意) — 前処理対象の画像です。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、do_rescale=Falseを設定してください。 - segmentation_maps (
ImageInput、kwargs、任意) — 入力画像と並行して処理する正解セグメンテーションマップです。これらのマップは学習または評価のために使用され、処理後の画像の寸法に合わせてリサイズおよび正規化されます。 - input_points (
NestedList, kwargs, optional) — プロンプトベースのセグメンテーション用の入力ポイントです。構造が[image_level, object_level, point_level, [x, y]]のネストされたリストである必要があります。各ポイントは、元の画像空間における[x, y]座標で指定されます。ポイントは、モデルに渡される前に、ターゲットの画像サイズに正規化されます。 - input_labels (
NestedList, kwargs, 任意) — 入力ポイントのラベル。各ポイントが前景 (1) であるか背景 (0) であるかを示します。[image_level, object_level, point_level]という構造を持つネストされたリストである必要があります。input_pointsと同じ構造 (座標次元を除く) である必要があります。 - input_boxes (
NestedList、kwargs、optional) — プロンプトベースのセグメンテーション用のバウンディングボックスです。構造が[image_level, box_level, [x1, y1, x2, y2]]のネストされたリストである必要があります。各ボックスは、元の画像空間における[x1, y1, x2, y2]座標で指定されます。ボックスは、モデルに渡される前にターゲット画像サイズに正規化されます。 - point_pad_value (
int、kwargs、任意、デフォルトはNone) — 長さの異なるシーケンスをバッチ処理する際に、入力ポイントのパディングに使用される値です。この値はパディングされた位置を示し、座標正規化の際にも保持されることで、実データのパディングを区別するために使用されます。Noneの場合、プロセッサ設定のデフォルトのパディング値が使用されます。 - mask_size (
dict[str, *kwargs*, int], 任意) —"height"と"width"をキーとして、ターゲットのマスクサイズを指定する辞書です。これにより、モデルが生成する出力セグメンテーションマスクの解像度が決定されます。 - mask_pad_size (
dict[str, *kwargs*, int]、任意) —"height"と"width"をキーとして、マスクのパディングサイズを指定する辞書です。異なるサイズのマスクをバッチ処理する際に、次元を揃えるために使用されます。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、特定のフレームワークのテンソルを返します。使用可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': NumPyのnp.ndarrayオブジェクトを返します。
- **kwargs (ProcessingKwargs、任意) — 各モダリティ(テキスト、画像、動画、音声)の追加処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDictクラスを参照してください。
戻り値
~feature_extraction_utils.BatchFeature
- data (
dict、任意) — call/pad メソッドによって返されるリスト/配列/テンソルの辞書(‘input_values’、‘attention_mask’ など)。 - tensor_type (
Union[None, str, TensorType]、省略可) — 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。 - skip_tensor_conversion (
list[str]またはset[str]、任意) —tensor_typeが指定されている場合でも、テンソルに変換すべきでないキーのリストまたはセット。
SamHQVisionModel
class transformers.SamHQVisionModel
< source >( config: SamHQVisionConfig )
パラメータ
- config (SamHQVisionConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ヘッドや投影が上に乗せられていないSamHQのビジョンモデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamHQVisionEncoderOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は SamImageProcessor を使用して取得できます。詳細は SamImageProcessor.call() を参照してください(SamHQProcessor は画像の処理に SamImageProcessor を使用します)。
戻り値
SamHQVisionEncoderOutput または tuple(torch.FloatTensor)
SamHQVisionEncoderOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(SamHQConfig)と入力に応じて、さまざまな要素で構成されます。
SamHQVisionModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
image_embeds (
torch.FloatTensor、shape(batch_size, output_dim)、optional、モデルがwith_projection=Trueで初期化された場合に返されます)— pooler_output に投影層を適用して得られる画像埋め込みです。last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルの最終層の出力における隠れ状態のシーケンス。hidden_states (
tuple[torch.FloatTensor, ...]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple[torch.FloatTensor, ...]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)です。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
intermediate_embeddings (
list(torch.FloatTensor)、任意) — モデル内の特定のブロック(通常はウィンドウ付きアテンションを持たないブロック)から収集された中間埋め込みのリストです。リストの各要素の形状は(batch_size, sequence_length, hidden_size)です。 これは SAM-HQ に特有のものであり、ベースの SAM には存在しません。
SamHQModel
class transformers.SamHQModel
< source >( config: SamHQConfig )
パラメータ
- config (SamHQConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
入力画像と任意の2D位置およびバウンディングボックスを指定してマスクを生成するためのSegment Anything Model HQ (SAM-HQ)。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Noneinput_points: typing.Optional[torch.FloatTensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.FloatTensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.FloatTensor] = Nonemultimask_output: bool = Truehq_token_only: bool = Falseattention_similarity: typing.Optional[torch.FloatTensor] = Nonetarget_embedding: typing.Optional[torch.FloatTensor] = Noneintermediate_embeddings: list[torch.FloatTensor] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> )
パラメータ
- pixel_values (
torch.FloatTensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は SamImageProcessor を使用して取得できます。詳細は SamImageProcessor.call() を参照してください(SamHQProcessor は画像の処理に SamImageProcessor を使用します)。 - input_points (
torch.FloatTensor、shape(batch_size, num_points, 2)) — 入力となる 2 次元空間上の点です。プロンプトエンコーダがプロンプトをエンコードするために使用されます。一般的に、これによりはるかに良い結果が得られます。点は、リストのリストのリストをプロセッサに渡すことで取得でき、これにより次元 4 の対応するtorchテンソルが作成されます。最初の次元は画像のバッチサイズ、2 番目の次元は点のバッチサイズ(つまり、入力点ごとにモデルに予測させたいセグメンテーションマスクの数)、3 番目の次元はセグメンテーションマスクごとの点の数(1 つのマスクに対して複数の点を渡すことも可能です)、最後の次元は点の x(縦)および y(横)座標です。画像ごと、またはマスクごとに異なる数の点が渡された場合、プロセッサは (0, 0) 座標に対応する「PAD」点を作成し、これらの点についてはラベルを使用して埋め込みの計算をスキップします。 - input_labels (
torch.LongTensorの形状(batch_size, point_batch_size, num_points)) — ポイントの入力ラベルです。プロンプトエンコーダーによってプロンプトをエンコードするために使用されます。公式実装によると、ラベルには 3 種類あります1: 対象オブジェクトを含む点0: 対象オブジェクトを含まない点-1: 背景に対応する点
ラベルを追加しました:
-10: その点はパディングポイントであるため、プロンプトエンコーダーによって無視されるべきです
パディングラベルは、プロセッサによって自動的に処理されるべきです。
- input_boxes (
torch.FloatTensorの形状(batch_size, num_boxes, 4)) — ポイント用の入力ボックスです。プロンプトエンコーダーによってプロンプトをエンコードするために使用されます。一般的に、より優れた生成マスクが得られます。ボックスは、リストのリストのリストをプロセッサーに渡すことで取得でき、torchテンソルが生成されます。各次元は、それぞれ画像のバッチサイズ、画像ごとのボックス数、およびボックスの左上と右下の点の座標に対応します。順序は (x1,y1,x2,y2):x1: 入力ボックスの左上の点のx座標y1: 入力ボックスの左上の点のy座標x2: 入力ボックスの右下の点のx座標y2: 入力ボックスの右下隅の y 座標
- input_masks (
torch.FloatTensor、shape(batch_size, image_size, image_size)) — SAM_HQ モデルは、セグメンテーションマスクも入力として受け入れます。マスクはプロンプトエンコーダーによって埋め込まれ、対応する埋め込みが生成されます。この埋め込みは、後でマスクデコーダーに渡されます。これらのマスクはユーザーが手動で渡す必要があり、shape は (batch_size,image_size,image_size) である必要があります。 - image_embeddings (
torch.FloatTensor、shape(batch_size, output_channels, window_size, window_size)) — 画像埋め込みです。マスクデコーダーがマスクと IoU スコアを生成するために使用されます。メモリ効率の高い計算を行うには、まずget_image_embeddingsメソッドで画像埋め込みを取得し、pixel_valuesを渡す代わりに、それをforwardメソッドに渡すことができます。 - multimask_output (
bool, 任意) — 元の実装および論文では、モデルは常に1枚の画像ごとに3つのマスクを出力します(関連する場合は、ポイントごとまたはバウンディングボックスごと)。ただし、multimask_output=Falseを指定することで、「最良」のマスクに相当する単一のマスクのみを出力することも可能です。 - hq_token_only (
bool、任意、デフォルトはFalse) — マスク生成に HQ トークンパスのみを使用するかどうかを指定します。False の場合、標準パスと HQ パスの両方を組み合わせます。これは SAM-HQ のアーキテクチャ固有のものです。 - attention_similarity (
torch.FloatTensor, 任意) — ターゲットガイドドアテンションのためにマスクデコーダーに渡すアテンション類似度テンソル。モデルがPerSAMで導入されたパーソナライゼーションに使用される場合に指定します。 - target_embedding (
torch.FloatTensor, 任意) — ターゲット概念の埋め込み。モデルがPerSAMで導入されたパーソナライゼーションに使用される場合、ターゲット意味プロンプティングのためにマスクデコーダーに提供されます。 - intermediate_embeddings (
List[torch.FloatTensor]、任意) — ビジュアルエンコーダーのウィンドウなしブロックからの中間埋め込み。SAM-HQ により、マスク品質の向上に使用されます。 pixel_values の代わりに事前計算済みの image_embeddings を指定する場合に必要です。
SamHQModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
例:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("sushmanth/sam_hq_vit_b")
>>> processor = AutoProcessor.from_pretrained("sushmanth/sam_hq_vit_b")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=image, input_points=input_points, return_tensors="pt")

>>> # Get high-quality segmentation mask
>>> outputs = model(**inputs)

>>> # For high-quality mask only
>>> outputs = model(**inputs, hq_token_only=True)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )