
Transformers documentation
Table Transformer
このモデルは2021年9月30日にHF papersで公開され、2022年10月18日にHugging Face Transformersに貢献されました。
Table Transformer
概要
Table Transformer モデルは、Brandon Smock、Rohith Pesala、Robin Abraham による PubTables-1M: Towards comprehensive table extraction from unstructured documents で提案されました。著者らは、非構造化ドキュメントからのテーブル抽出、テーブル構造認識、機能解析における進歩をベンチマークするために、新しいデータセット PubTables-1M を紹介しています。著者らは、テーブル検出用とテーブル構造認識用の 2 つの DETR モデルを訓練し、これらを Table Transformers と呼んでいます。
論文の抄録は以下の通りです。
最近、非構造化ドキュメントからのテーブル構造の推論と抽出という問題に機械学習を適用する分野で、大きな進歩が遂げられています。 しかしながら、最大の課題の一つとして、大規模かつ完全で曖昧さのない正解データ(ground truth)の作成が依然として残っています。この課題に対処するため、テーブル抽出のためのより包括的な新しいデータセット、PubTables-1M を開発しました。PubTables-1M は科学論文から得られた約100万枚のテーブルを含み、複数の入力モダリティに対応しています。また、テーブル構造の詳細なヘッダー情報や位置情報を含むため、幅広いモデリング手法に有用です。さらに、従来のデータセットで観察されてきた正解データの不整合の主要な原因である過剰分割(oversegmentation)の問題を、新しい正規化(canonicalization)手順を用いて解決しています。これらの改善により、テーブル構造認識における学習性能の大幅な向上と、評価時のモデル性能のより信頼できる推定が可能になることを示しました。さらに、PubTables-1M で学習させた Transformer ベースのオブジェクト検出モデルは、これらのタスクに特別なカスタマイズを施すことなく、検出、構造認識、機能解析という3つのタスクすべてで優れた結果を出すことを示しました。
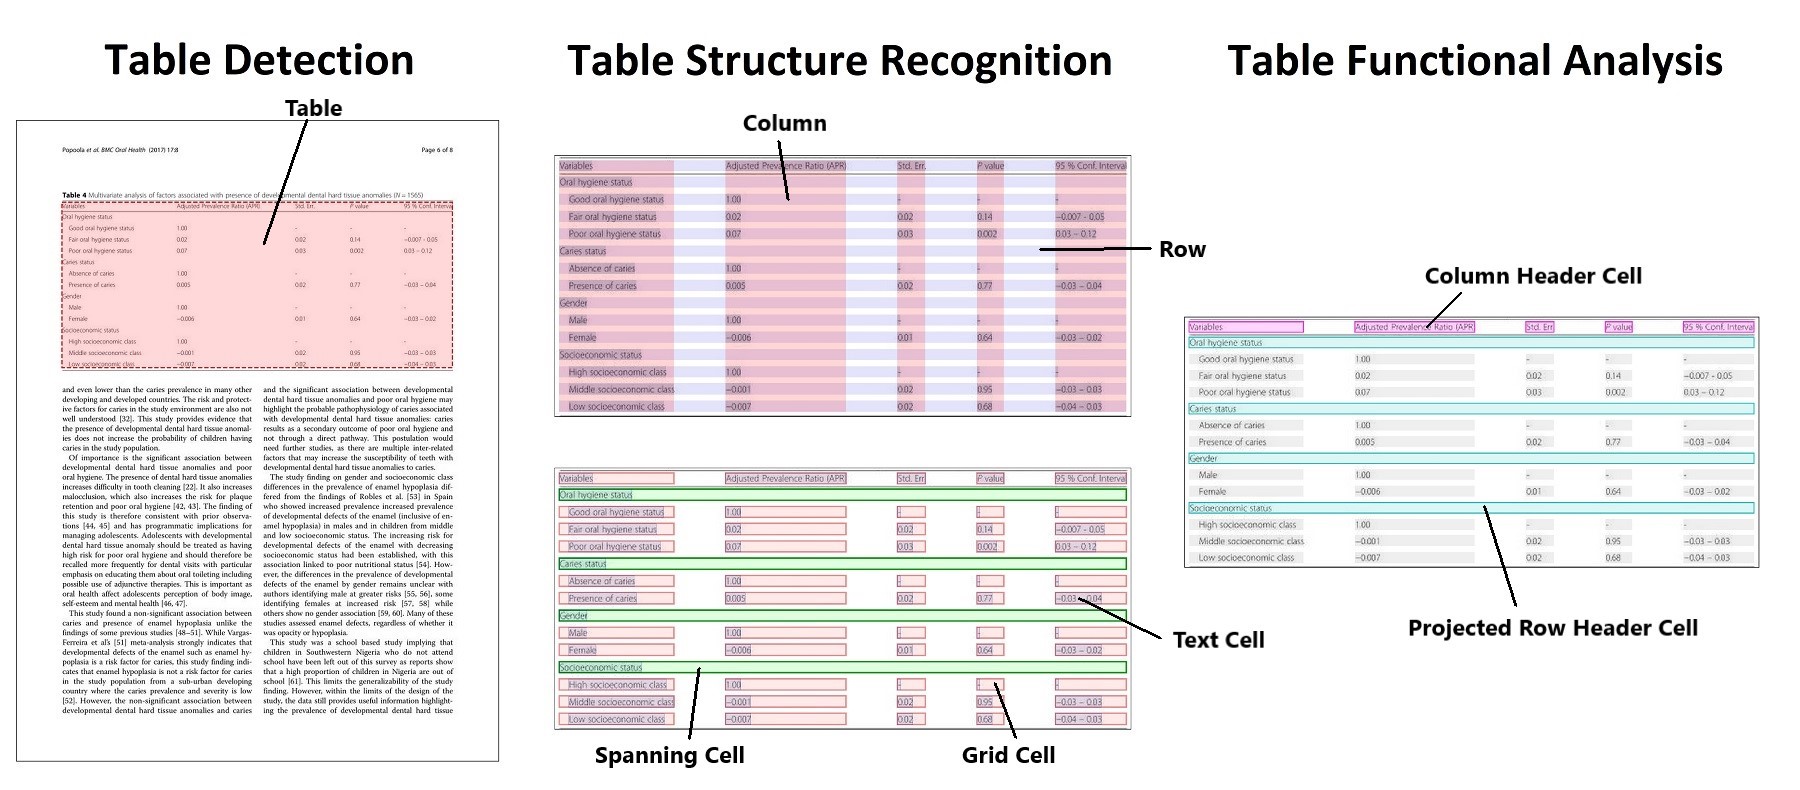 Table detection and table structure recognition clarified. Taken from the original paper.
著者は2つのモデルを公開しました。1つは文書におけるテーブル検出用のもので、もう1つはテーブル構造認識(テーブル内の個々の行や列などを認識するタスク)用のものでした。
このモデルはnielsrによって提供されました。元のコードはこちらで確認できます。
use_kernels=Trueを from_pretrained() に設定すると、対応するレイヤーが Hub からの最適化されたカーネルに置き換えられます。詳細は カーネルの読み込み を参照してください。
リソース
- Table Transformerのデモノートブックはこちらで確認できます。
- 画像のパディングは検出において非常に重要であることが判明しました。著者からの返信を含む興味深いGithubスレッドはこちらで確認できます。
TableTransformerConfig
class transformers.TableTransformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_channels: int = 3num_queries: int = 100encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8encoder_layerdrop: float | int = 0.0decoder_layerdrop: float | int = 0.0activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0init_std: float = 0.02init_xavier_std: float = 1.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'dilation: bool = Falseclass_cost: int = 1bbox_cost: int = 5giou_cost: int = 2mask_loss_coefficient: int = 1dice_loss_coefficient: int = 1bbox_loss_coefficient: int = 5giou_loss_coefficient: int = 2eos_coefficient: float = 0.1 )
パラメータ
- is_encoder_decoder (
bool、任意、デフォルトはTrue) — モデルがエンコーダー/デコーダーとして使用されるかどうかを示します。 - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 任意) — バックボーンモデルの設定です。 - num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - num_queries (
int、任意、デフォルト値は 100)— オブジェクトクエリ数、すなわち検出スロットの数です。これは、TableTransformerModel が 1 枚の画像内で検出できるオブジェクトの最大数を表します。COCO の場合、100 クエリを推奨します。 - encoder_layers (
int、任意、デフォルトは6) — Transformer エンコーダーの隠れ層の数です。設定されていない場合は、num_layersと同じ値が使用されます。 - encoder_ffn_dim (
int、任意、デフォルトは2048) — エンコーダー内の「中間」層(フィードフォワード層と呼ばれることが多い)の次元数。 - encoder_attention_heads (
int、任意、デフォルトは8) — Transformer エンコーダーの各アテンション層におけるアテンションヘッドの数。 - decoder_layers (
int、任意、デフォルトは6) — Transformer デコーダーの隠れ層の数です。設定されていない場合、num_layersと同じ値が使用されます。 - decoder_ffn_dim (
int、任意、デフォルトは2048) — デコーダー内の「中間」(feed-forward と呼ばれることが多い) レイヤーの次元数。 - decoder_attention_heads (
int、任意、デフォルトは8) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - encoder_layerdrop (
Union[float, int]、任意、デフォルトは0.0) — エンコーダーの LayerDrop 確率です。詳細は [LayerDrop の論文](https://huggingface.co/papers/1909.11556 を参照)をご覧ください。 - decoder_layerdrop (
Union[float, int]、省略可、デフォルト値は0.0) — デコーダーの LayerDrop 確率です。詳細は [LayerDrop の論文](https://huggingface.co/papers/1909.11556 を参照)をご覧ください。 - activation_function (
str、任意、デフォルトはrelu) — デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、"gelu"、"relu"、"silu"など。 - d_model (
int、省略可、デフォルトは256) — エンコーダ層とプーラ層のサイズ。 - dropout (
Union[float, int]、任意、デフォルト値は0.1) — すべての dropout レイヤーの比率です。 - attention_dropout (
Union[float, int]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - activation_dropout (
Union[float, int]、任意、デフォルトは0.0) — 全結合層内の活性化に対する dropout 率です。 - init_std (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - init_xavier_std (
float、任意、デフォルトは1.0) — クロスアテンションの重みの Xavier 初期化に使用されるスケーリング係数です。 - auxiliary_loss (
bool、任意、デフォルトはFalse) — 補助デコーディング損失(各デコーダ層での損失)を使用するかどうかを指定します。 - position_embedding_type (
str, 任意、デフォルトは"sine") — 画像特徴の上に適用する位置埋め込みの種類。"sine"または"learned"のいずれかです。 - dilation (
bool、任意、デフォルトはFalse) — 最後の畳み込みブロック(DC5)で stride の代わりに dilation を使用するかを指定します。use_timm_backbone=Trueの場合のみサポートされます。 - class_cost (
int、省略可能、デフォルトは1) — ハンガリー法によるマッチングコストにおける、分類誤差の相対的な重み。 - bbox_cost (
int、任意、デフォルトは5) — ハンガリー法によるマッチングコストにおける、L1バウンディングボックス誤差の相対的な重みです。 - giou_cost (
int、任意、デフォルト値は2) — ハンガリー法によるマッチングコストにおける、汎化 IoU ロスの相対的な重み。 - mask_loss_coefficient (
int、任意、デフォルトは1) — パノプティックセグメンテーション損失におけるfocal lossの相対的な重み。 - dice_loss_coefficient (
int, 任意、デフォルトは1) — パンノミックセグメンテーション損失における dice loss の相対的な重み。 - bbox_loss_coefficient (
int、任意、デフォルトは5) — パノプティックセグメンテーション損失における L1 バウンディングボックス損失の相対的な重み。 - giou_loss_coefficient (
int、任意、デフォルトは2) — パノラミックセグメンテーション損失における汎化 IoU 損失の相対的な重み。 - eos_coefficient (
float、任意、デフォルトは0.1) — オブジェクト検出の損失における「no-object」クラスの相対的な分類重み。
これは、Table Transformerモデルの設定を保存するための設定クラスです。指定された引数に基づいてTable Transformerモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、microsoft/table-transformer-detection と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import TableTransformerModel, TableTransformerConfig

>>> # Initializing a Table Transformer microsoft/table-transformer-detection style configuration
>>> configuration = TableTransformerConfig()

>>> # Initializing a model from the microsoft/table-transformer-detection style configuration
>>> model = TableTransformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
TableTransformerModel
class transformers.TableTransformerModel
< source >( config: TableTransformerConfig )
パラメータ
- config (TableTransformerConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する、バックボーンとencoder-decoder Transformerで構成される素のTable Transformer Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: FloatTensorpixel_mask: typing.Optional[torch.FloatTensor] = Nonedecoder_attention_mask: typing.Optional[torch.FloatTensor] = Noneencoder_outputs: typing.Optional[torch.FloatTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TableTransformerModelOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、shape(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は DetrImageProcessor を使用して取得できます。詳細は DetrImageProcessor.call() を参照してください(processor_classは画像の処理に DetrImageProcessor を使用します)。 - pixel_mask (
torch.FloatTensorの形状(batch_size, height, width), 、任意) — パディングピクセル値へのアテンションを回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- decoder_attention_mask (
torch.FloatTensor、shape(batch_size, num_queries)、任意) — デフォルトでは使用されません。オブジェクトクエリをマスクするために使用できます。 - encoder_outputs (
torch.FloatTensor、任意) —last_hidden_state、任意:hidden_states、任意:attentionsのタプルlast_hidden_stateは形状(batch_size, sequence_length, hidden_size)、任意 のシーケンスで、エンコーダーの最終層の出力における隠れ状態の列です。デコーダーのクロスアテンションで使用されます。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) — フラット化された特徴マップ(バックボーンと投影層の出力)を渡す代わりに、画像のフラット化された表現を直接渡すこともできます。 - decoder_inputs_embeds (
torch.FloatTensor、shape(batch_size, num_queries, hidden_size)、任意) — クエリをゼロのテンソルで初期化する代わりに、埋め込み表現を直接渡すこともできます。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
TableTransformerModelOutput または tuple(torch.FloatTensor)
TableTransformerModelOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(TableTransformerConfig)と入力に応じて、さまざまな要素で構成されます。
TableTransformerModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)) — モデルのデコーダーの最終層の出力における、隠れ状態のシーケンス。past_key_valuesが使用されている場合、出力されるのは、形状(batch_size, 1, hidden_size)のシーケンスの最後の隠れ状態のみです。past_key_values (
EncoderDecoderCache、任意、use_cache=Trueが渡された場合またはconfig.use_cache=Trueの場合に返されます) — EncoderDecoderCache のインスタンスです。詳細については、kv cache ガイドを参照してください。自己注意ブロックおよび相互注意ブロック内のキーとバリューの事前計算済み隠れ状態(hidden-states)を保持しており、シーケンシャルデコーディングを高速化するために使用できます(
past_key_values入力参照)。decoder_hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるデコーダーのHidden-states、および任意の初期埋め込み出力。
decoder_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
cross_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのエンコーダーの最終層の出力における、隠れ状態のシーケンス。encoder_hidden_states (
tuple(torch.FloatTensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返される) —torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるエンコーダーのHidden-states、および任意の初期埋め込み出力。
encoder_attentions (
tuple(torch.FloatTensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返される) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmaxを適用した後のエンコーダーのアテンション重み。自己アテンションヘッドにおける加重平均の計算に使用されます。
intermediate_hidden_states (
torch.FloatTensor、shape(config.decoder_layers, batch_size, sequence_length, hidden_size)、optional、config.auxiliary_loss=Trueの場合に返される) — 中間デコーダ活性化、すなわち各デコーダ層の出力であり、それぞれが layernorm を通ったものです。
例:
>>> from transformers import AutoImageProcessor, TableTransformerModel
>>> from huggingface_hub import hf_hub_download
>>> from PIL import Image

>>> file_path = hf_hub_download(repo_id="nielsr/example-pdf", repo_type="dataset", filename="example_pdf.png")
>>> image = Image.open(file_path).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/table-transformer-detection")
>>> model = TableTransformerModel.from_pretrained("microsoft/table-transformer-detection")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # the last hidden states are the final query embeddings of the Transformer decoder
>>> # these are of shape (batch_size, num_queries, hidden_size)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 15, 256]
TableTransformerForObjectDetection
class transformers.TableTransformerForObjectDetection
< source >( config: TableTransformerConfig )
パラメータ
- config (TableTransformerConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
Table Transformer Model(バックボーンとエンコーダー・デコーダー型 Transformer で構成され、その上にオブジェクト検出ヘッドを備えたモデル)は、COCO 検出などのタスクに使用されます。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: FloatTensorpixel_mask: typing.Optional[torch.FloatTensor] = Nonedecoder_attention_mask: typing.Optional[torch.FloatTensor] = Noneencoder_outputs: typing.Optional[torch.FloatTensor] = Noneinputs_embeds: typing.Optional[torch.FloatTensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.FloatTensor] = Nonelabels: list[dict] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TableTransformerObjectDetectionOutput or tuple(torch.FloatTensor)
パラメータ
- pixel_values (
torch.FloatTensor、shape(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は DetrImageProcessor を使用して取得できます。詳細は DetrImageProcessor.call() を参照してください(processor_classは画像の処理に DetrImageProcessor を使用します)。 - pixel_mask (
torch.FloatTensorの形状(batch_size, height, width), 、任意) — パディングピクセル値へのアテンションを回避するためのマスク。[0, 1]:- 実在するピクセル(つまり、マスクされていない)に対して1
- padding(つまり、マスクされている)ピクセルは0です。
- decoder_attention_mask (
torch.FloatTensor、shape(batch_size, num_queries)、任意) — デフォルトでは使用されません。オブジェクトクエリをマスクするために使用できます。 - encoder_outputs (
torch.FloatTensor、任意) —last_hidden_state、任意:hidden_states、任意:attentionsのタプルlast_hidden_stateは形状(batch_size, sequence_length, hidden_size)、任意 のシーケンスで、エンコーダーの最終層の出力における隠れ状態の列です。デコーダーのクロスアテンションで使用されます。 - inputs_embeds (
torch.FloatTensor、形状(batch_size, sequence_length, hidden_size)、任意) — フラット化された特徴マップ(バックボーンと投影層の出力)を渡す代わりに、画像のフラット化された表現を直接渡すこともできます。 - decoder_inputs_embeds (
torch.FloatTensor、shape(batch_size, num_queries, hidden_size)、任意) — クエリをゼロのテンソルで初期化する代わりに、埋め込み表現を直接渡すこともできます。 - labels (
list[Dict]、長さ(batch_size,)、任意) — 二部マッチング損失を計算するためのラベルです。辞書のリストで、各辞書には少なくとも以下の 2 つのキーが含まれます: ‘class_labels’ と ‘boxes’ (それぞれバッチ内の画像のクラスラベルとバウンディングボックスです)。クラスラベル自体は長さ(number of bounding boxes in the image,)のtorch.LongTensorであり、ボックスは形状(number of bounding boxes in the image, 4)のtorch.FloatTensorである必要があります。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。
戻り値
TableTransformerObjectDetectionOutput または tuple(torch.FloatTensor)
TableTransformerObjectDetectionOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(TableTransformerConfig)や入力に応じて、さまざまな要素で構成されます。
TableTransformerForObjectDetectionのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが提供された場合に返されます) — クラス予測の負の対数尤度(クロスエントロピー)とバウンディングボックス損失の線形結合による総損失です。後者は、L1損失と汎用スケール不変IoU損失の線形結合として定義されます。loss_dict (
Dict, 任意) — 個別の損失を含む辞書です。ログ出力に便利です。logits (
torch.FloatTensor、shape(batch_size, num_queries, num_classes + 1)) — すべてのクエリに対する分類 logits(no-object を含む)。pred_boxes (
torch.FloatTensor、shape(batch_size, num_queries, 4)) — すべてのクエリに対する正規化されたボックス座標で、(center_x, center_y, width, height) として表されます。これらの値は、バッチ内の各画像のサイズに対して [0, 1] の範囲で正規化されています(パディングは考慮されません)。正規化されていないバウンディングボックスを取得するには、~TableTransformerImageProcessor.post_process_object_detectionを使用できます。auxiliary_outputs (
list[Dict]、optional) — オプション。補助損失が有効化されている場合(つまりconfig.auxiliary_lossがTrueに設定されている場合)かつラベルが提供されている場合にのみ返されます。各デコーダ層について、上記の2つのキー(logitsとpred_boxes)を含む辞書のリストです。last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのデコーダーの最終層の出力における、隠れ状態のシーケンス。decoder_hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力における、デコーダーの隠れ状態。
decoder_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
cross_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのエンコーダーの最終層の出力における、隠れ状態のシーケンス。encoder_hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力におけるエンコーダーの隠れ状態。
encoder_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmaxを適用した後のエンコーダーのアテンション重み。自己アテンションヘッドにおける加重平均の計算に使用されます。
例:
>>> from huggingface_hub import hf_hub_download
>>> from transformers import AutoImageProcessor, TableTransformerForObjectDetection
>>> import torch
>>> from PIL import Image

>>> file_path = hf_hub_download(repo_id="nielsr/example-pdf", repo_type="dataset", filename="example_pdf.png")
>>> image = Image.open(file_path).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/table-transformer-detection")
>>> model = TableTransformerForObjectDetection.from_pretrained("microsoft/table-transformer-detection")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)

>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.9, target_sizes=target_sizes)[
...     0
... ]

>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
...     box = [round(i, 2) for i in box.tolist()]
...     print(
...         f"Detected {model.config.id2label[label.item()]} with confidence "
...         f"{round(score.item(), 3)} at location {box}"
...     )
Detected table with confidence 1.0 at location [202.1, 210.59, 1119.22, 385.09]