
Transformers documentation
BLIP-2
نُشر هذا النموذج في أوراق HF في 30 يناير 2023، وأُضيف إلى مكتبة Hugging Face Transformers في 9 فبراير 2023.

BLIP-2
نظرة عامة
قُدِّم نموذج BLIP-2 في BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models بواسطة Junnan Li وDongxu Li وSilvio Savarese وSteven Hoi. يستفيد BLIP-2 من مشفّرات الصور المُسبقة التدريب المجمّدة ونماذج اللغة الكبيرة (LLMs) من خلال تدريب مشفّر Transformer خفيف الوزن يتكوّن من 12 طبقة بينهما، مما يحقق أداءً متقدماً على مستوى الحالة الفنية في مهام الرؤية واللغة المختلفة. وبشكل خاص، يحسّن BLIP-2 أداء Flamingo، وهو نموذج يتكوّن من 80 مليار معامل، بنسبة 8.7% في مهمة VQAv2 بدون تدريب مسبق، مع استخدام عدد أقل من المعاملات القابلة للتدريب بمقدار 54 ضعفاً.
المستخلص من الورقة البحثية هو كالتالي:
The cost of vision-and-language pre-training has become increasingly prohibitive due to end-to-end training of large-scale models. This paper proposes BLIP-2, a generic and efficient pre-training strategy that bootstraps vision-language pre-training from off-the-shelf frozen pre-trained image encoders and frozen large language models. BLIP-2 bridges the modality gap with a lightweight Querying Transformer, which is pre-trained in two stages. The first stage bootstraps vision-language representation learning from a frozen image encoder. The second stage bootstraps vision-to-language generative learning from a frozen language model. BLIP-2 achieves state-of-the-art performance on various vision-language tasks, despite having significantly fewer trainable parameters than existing methods. For example, our model outperforms Flamingo80B by 8.7% on zero-shot VQAv2 with 54x fewer trainable parameters. We also demonstrate the model’s emerging capabilities of zero-shot image-to-text generation that can follow natural language instructions.
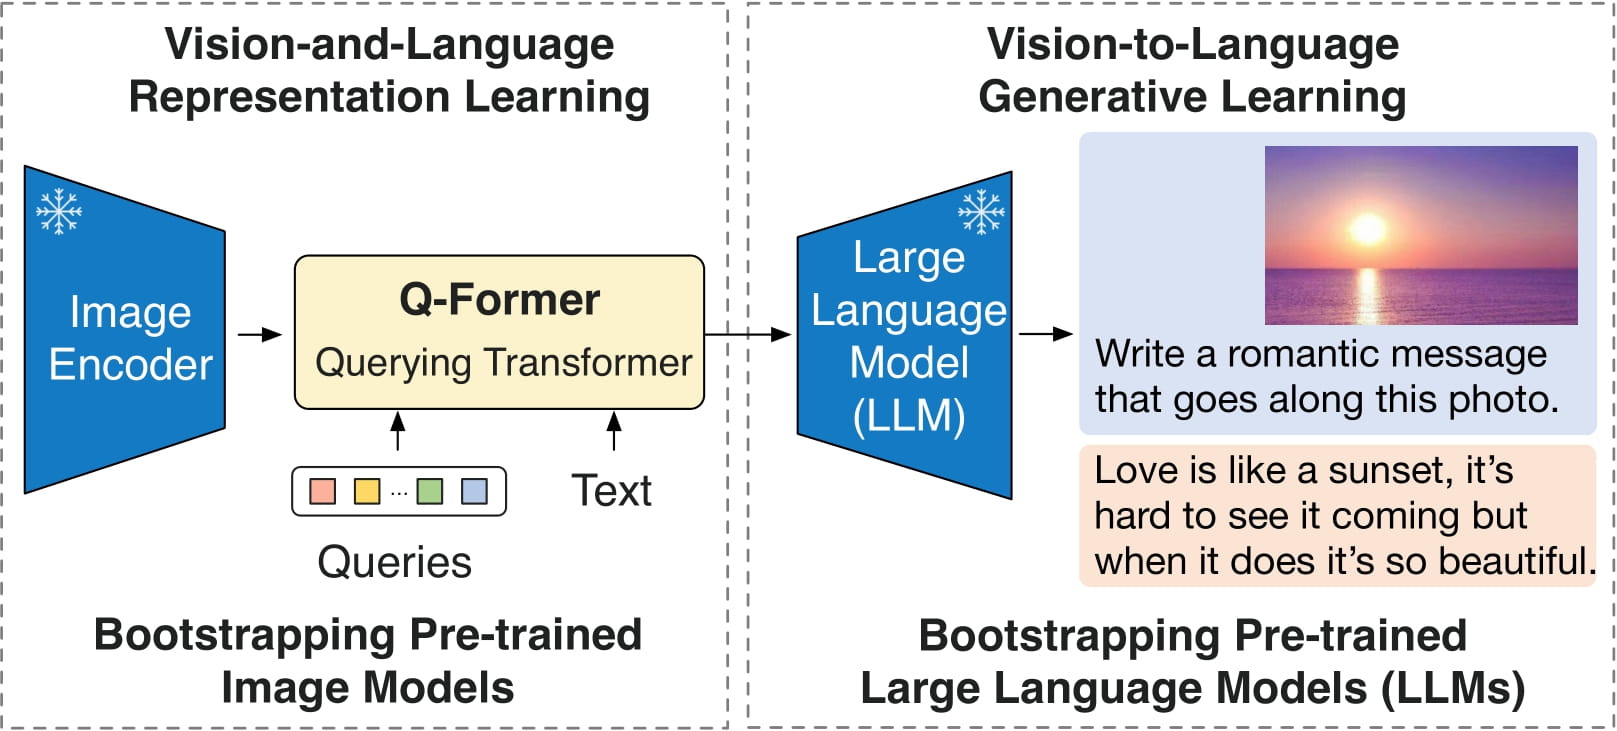 BLIP-2 architecture. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- يمكن استخدام BLIP-2 لتوليد النص الشرطي بناءً على صورة وموجّه نصي اختياري. يُوصى عند الاستدلال باستخدام طريقة
generate. - يمكن استخدام Blip2Processor لتحضير الصور للنموذج، وفك ترميز معرفات الرموز المتوقعة مرة أخرى إلى نص.
ستُصدر نماذج BLIP بعد الإصدار v4.46 تحذيرات بشأن إضافة
processor.num_query_tokens = {{num_query_tokens}}وتوسيع طبقة تضمينات النموذج لإضافة رمز<image>الخاص. يُوصى بشدة بإضافة هذه السمات إلى المعالج إذا كنت تمتلك نقطة التفتيش الخاصة بالنموذج، أو فتح طلب سحب (PR) إذا لم تكن تمتلكه. تعني إضافة هذه السمات أن BLIP سيضيف عدد رموز الاستعلام المطلوبة لكل صورة، وسيوسّع النص بعدد من محددات الموقع<image>يساوي عدد رموز الاستعلام. عادةً ما يكون هذا العدد حوالي 500 رمز لكل صورة، لذا تأكد من عدم اقتطاع النص، وإلا فسيحدث فشل عند دمج التضمينات. يمكن الحصول على السمات من إعدادات النموذج، على سبيل المثالmodel.config.num_query_tokens، ويمكن تنفيذ توسيع تضمينات النموذج باتباع هذا الرابط.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء مع BLIP-2.
- يمكن العثور على كراسات تجريبية لـ BLIP-2 لتوصيف الصور، والإجابة على الأسئلة البصرية (VQA)، والمحادثة بأسلوب الدردشة هنا.
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
Blip2Config
فئة transformers.Blip2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneqformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_query_tokens: int = 32image_text_hidden_size: int = 256image_token_index: int | None = Noneinitializer_factor: float = 1.0initializer_range: float = 0.02 )
المعاملات
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — كائن الإعدادات أو قاموس العمود الفقري البصري. - qformer_config (
dict، اختياري) — قاموس لخيارات التهيئة المستخدمة في تهيئة Blip2QFormerConfig. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]، اختياري) — كائن الإعدادات أو قاموس العمود الفقري النصي. - num_query_tokens (
int، اختياري، القيمة الافتراضية 32) — عدد رموز الاستعلام التي تمر عبر Transformer. - image_text_hidden_size (
int, اختياري، القيمة الافتراضية 256) — أبعاد الحالة المخفية لطبقة دمج النص والصورة. - image_token_index (
int, اختياري) — مؤشر رمز الصورة المستخدم كعلامة بديلة للصور المدخلة. - initializer_factor (
float، اختياري، القيمة الافتراضية1.0) — عامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة). - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Blip 2. تُستخدم لاستحداث نموذج Blip 2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Salesforce/blip2-opt-2.7b
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     Blip2VisionConfig,
...     Blip2QFormerConfig,
...     OPTConfig,
...     Blip2Config,
...     Blip2ForConditionalGeneration,
... )

>>> # Initializing a Blip2Config with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2Config()

>>> # Initializing a Blip2ForConditionalGeneration (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2ForConditionalGeneration(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a Blip2Config from a Blip2VisionConfig, Blip2QFormerConfig and any PreTrainedConfig

>>> # Initializing BLIP-2 vision, BLIP-2 Q-Former and language model configurations
>>> vision_config = Blip2VisionConfig()
>>> qformer_config = Blip2QFormerConfig()
>>> text_config = OPTConfig()

>>> config = Blip2Config(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
Blip2VisionConfig
فئة transformers.Blip2VisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1408intermediate_size: int = 6144num_hidden_layers: int = 39num_attention_heads: int = 16image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 14hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = True )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية1408) — أبعاد التمثيلات المخفية. - intermediate_size (
int، اختياري، القيمة الافتراضية6144) — أبعاد تمثيلات MLP. - num_hidden_layers (
int، اختياري، القيمة الافتراضية39) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية14) — حجم (دقة) كل رقعة. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية1e-10) — انحراف معياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Blip 2. تُستخدم لاستحداث نموذج Blip 2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Salesforce/blip2-opt-2.7b
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import Blip2VisionConfig, Blip2VisionModel

>>> # Initializing a Blip2VisionConfig with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2VisionConfig()

>>> # Initializing a Blip2VisionModel (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2VisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Blip2QFormerConfig
فئة transformers.Blip2QFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 512initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0cross_attention_frequency: int = 2encoder_hidden_size: int = 1408use_qformer_text_input: bool = False )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية30522) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - max_position_embeddings (
int، اختياري، القيمة الافتراضية512) — أقصى طول تسلسل قد يُستخدم مع هذا النموذج. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - pad_token_id (
int، اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم للتعبئة في المفردات. - cross_attention_frequency (
int، اختياري، القيمة الافتراضية 2) — تكرار إضافة الانتباه المتقاطع إلى طبقات Transformer. - encoder_hidden_size (
int، اختياري، القيمة الافتراضية1408) — أبعاد التمثيلات المخفية. - use_qformer_text_input (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام ترميزات من نمط BERT.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Blip 2. تُستخدم لاستحداث نموذج Blip 2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Salesforce/blip2-opt-2.7b
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import Blip2QFormerConfig, Blip2QFormerModel

>>> # Initializing a BLIP-2 Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2QFormerConfig()

>>> # Initializing a model (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2QFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
Blip2Processor
فئة transformers.Blip2Processor
< source >( image_processortokenizernum_query_tokens = None**kwargs )
ينشئ Blip2Processor الذي يجمع معالج الصور ومعالج الرموز في معالج واحد.
يوفر Blip2Processor جميع وظائف BlipImageProcessor وGPT2Tokenizer. راجع ~BlipImageProcessor و~GPT2Tokenizer لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | None = None**kwargs: *<class 'transformers.models.blip_2.processing_blip_2.Blip2ProcessorKwargs'> ) → ~tokenization_utils_base.BatchEncoding
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى رموز). إذا مررت مدخلًا مُقسَّمًا مسبقًا إلى رموز، فاضبطis_split_into_words=Trueلتجنب الغموض مع المدخلات الدفعية. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
يعيد
~tokenization_utils_base.BatchEncoding
- data (
dict، اختياري) — قاموس من القوائم/المصفوفات/الموترات التي تُعاد بواسطة طرق__call__/encode_plus/batch_encode_plus(مثل ‘input_ids’، ‘attention_mask’، وما إلى ذلك). - ترميز (
tokenizers.EncodingأوSequence[tokenizers.Encoding]، اختياري) — إذا كان مُرمِّز الكلمات (tokenizer) من النوع السريع الذي يُخرج معلومات إضافية مثل التحويل من مساحة الكلمات/الأحرف إلى مساحة الرموز (tokens)، فإن كائنtokenizers.Encodingأو قائمة بالكائنات (في حالة الدفعات) تحتفظ بهذه المعلومات. - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة. - prepend_batch_axis (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة محور الدفعة عند التحويل إلى متجهات (انظرtensor_typeأعلاه). لاحظ أن لهذا المعامل تأثيرًا إذا تم تعيين المعاملtensor_type، وإلا فلا يكون له أي تأثير. - n_sequences (
int, اختياري) — عدد تسلسلات الإدخال التي يُمثّلها كل ترميز (Noneفي حال عدم المعرفة، و1لتسلسل واحد، و2لزوج من التسلسلات).
Blip2VisionModel
فئة transformers.Blip2VisionModel
< source >( config: Blip2VisionConfig )
المعاملات
- config (Blip2VisionConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Blip 2 الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Blip2Config) والمدخلات.
تتجاوز طريقة Blip2VisionModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
Blip2QFormerModel
فئة transformers.Blip2QFormerModel
< source >( config: Blip2QFormerConfig )
المعاملات
- config (Blip2QFormerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
BLIP-2 محوّل الاستعلام (Q-Former).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( query_embeds: Tensorquery_length: int | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPoolingAndCrossAttentions or tuple(torch.Tensor)
المعاملات
- query_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — حالات مخفية تُستخدم في حساب الانتباه. إذا كان الانتباه متقاطعًا، فستُستخدم للاستعلام (أي أن المفتاح والقيمة ستستخدمان encoder_hidden_states). - query_length (
int, اختياري) — طول الاستعلام، وهو عادةً مبني على عدد رموز الاستعلام. إذا لم يتم تقديم قيمة، فسيتم استنتاج query_length بواسطة query_embeds. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- encoder_hidden_states (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر. تُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. - encoder_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
BaseModelOutputWithPoolingAndCrossAttentions أو tuple(torch.Tensor)
BaseModelOutputWithPoolingAndCrossAttentions أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Blip2Config) والمدخلات.
تتجاوز طريقة Blip2QFormerModel الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueوconfig.add_cross_attention=Trueأو عندconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.
Blip2Model
فئة transformers.Blip2Model
< source >( config: Blip2Config )
المعاملات
- config (Blip2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج BLIP-2 لتوليد ميزات النص والصورة. يتكون النموذج من مشفّر بصري، ومحوّل الاستعلام (Q-Former)، ونموذج لغوي.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorinput_ids: Tensorattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Blip2ForConditionalGenerationModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور). - input_ids (
torch.Tensorبشكل(batch_size, sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- decoder_attention_mask (
torch.BoolTensorبشكل(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: إنشاء متجه يتجاهل رموز الحشو فيdecoder_input_ids. سيتم استخدام قناع سببي أيضًا بشكل افتراضي.تنطبق هذه الحالة فقط عند استخدام نموذج لغة مُشفِّر-مُفكِّك (مثل T5).
- labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
Blip2ForConditionalGenerationModelOutput أو tuple(torch.Tensor)
Blip2ForConditionalGenerationModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على التهيئة (Blip2Config) والمدخلات.
تتجاوز طريقة Blip2Model الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensor، اختياري، يُعاد عند تقديمlabels،torch.Tensorمن الشكل(1,)) — خسارة نمذجة اللغة من نموذج اللغة. - logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة في نموذج اللغة. - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات مُشفِّر الرؤية. - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions، اختياري) — مخرجات Q-Former (Querying Transformer). - language_model_outputs (
CausalLMOutputWithPastأوSeq2SeqLMOutput) — مخرجات نموذج اللغة.
أمثلة:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2Model
>>> import torch

>>> device = "cuda" if torch.cuda.is_available() else "cpu"

>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b", dtype=torch.float16)
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, torch.float16)

>>> outputs = model(**inputs)
get_text_features
< source >( input_ids: Tensorattention_mask: typing.Optional[torch.Tensor] = Nonedecoder_input_ids: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس النموذج. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات مدخلات المُفكِّك؟ يستخدم T5 رمز pad_token_id كرمز بدء لتوليد decoder_input_ids. إذا تم استخدام past_key_values، فيجب إدخال decoder_input_ids الأخيرة فقط بشكل اختياري (راجع past_key_values). لمعرفة المزيد حول كيفية تحضير decoder_input_ids للتدريب المسبق، اطّلع على T5 Training.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
ما هي معرّفات مدخلات المُفكِّك؟
يستخدم T5 الرمز
pad_token_idكرمز بداية لتوليدdecoder_input_ids. إذا تم استخدامpast_key_values، فبشكل اختياري لا يتعين إدخال سوى آخرdecoder_input_ids(انظرpast_key_values).لمعرفة المزيد حول كيفية تحضير
decoder_input_idsللتدريب المسبق، راجع تدريب T5. - decoder_attention_mask (
torch.BoolTensorof shape(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو فيdecoder_input_ids. كما سيتم استخدام قناع سببي (Causal mask) افتراضيًا. - labels (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس إما ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي تكون فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size].
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Blip2Config) والمدخلات.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import AutoTokenizer, Blip2Model

>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> tokenizer = AutoTokenizer.from_pretrained("Salesforce/blip2-opt-2.7b")

>>> inputs = tokenizer(["a photo of a cat"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
...     text_features = model.get_text_features(**inputs)
get_image_features
< source >( pixel_values: Tensorinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Blip2Config) والمدخلات.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image

>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")

>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
...     image_outputs = model.get_image_features(**inputs)
get_qformer_features
< source >( pixel_values: Tensorinterpolate_pos_encoding: bool = False ) → qformer_outputs (torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
qformer_outputs (torch.Tensor)
حالات المخفية لطبقة النموذج Q-Former الأخيرة.
أمثلة:
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image

>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
...     qformer_outputs = model.get_qformer_features(**inputs)
Blip2ForConditionalGeneration
فئة transformers.Blip2ForConditionalGeneration
< source >( config: Blip2Config )
المعاملات
- config (Blip2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج BLIP-2 لتوليد النص بناءً على صورة وموجّه نصي اختياري. يتكوّن النموذج من مشفّر بصري، ومحوّل الاستعلام (Q-Former)، ونموذج لغوي.
يمكن للمرء اختيارياً تمرير input_ids إلى النموذج، حيث تعمل كموجّه نصي، لجعل نموذج اللغة يستكمل الموجّه. وإلا، يبدأ نموذج اللغة بتوليد النص من رمز [BOS] (بداية التسلسل).
لاحظ أن نقاط التفتيش الخاصة بـ Flan-T5 لا يمكن تحويلها إلى float16. فقد تم تدريبها مسبقًا باستخدام bfloat16.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorinput_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool = Falsemm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Blip2ForConditionalGenerationModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور). - input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في مفردات نموذج اللغة. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي يمكن لنموذج اللغة أن يستمر في توليده.يمكن الحصول على الفهارس باستخدام Blip2Processor. راجع Blip2Processor.call() للحصول على التفاصيل.
- attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- decoder_attention_mask (
torch.BoolTensorبشكل(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: إنشاء متجه يتجاهل رموز الحشو فيdecoder_input_ids. سيتم استخدام قناع سببي أيضًا بشكل افتراضي.تنطبق هذه الحالة فقط عند استخدام نموذج لغة مُشفِّر-مُفكِّك (مثل T5).
- inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], اختياري) — قاموس تكون مفاتيحه الأنماط المدعومة وقيمها المخرجات المُرمّزة لكل نمط. كل مخرَج مُرمَّز هو مجموعة (tuple) تتكون من (pooler_output، اختياري:last_hidden_states، اختياري:hidden_states، اختياري:attentions)pooler_outputذو الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من الميزات متعددة الوسائط للمُشفِّر المُدمجة مع تضمينات النص.
يعيد
Blip2ForConditionalGenerationModelOutput أو tuple(torch.Tensor)
Blip2ForConditionalGenerationModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على التهيئة (Blip2Config) والمدخلات.
تُعيد طريقة Blip2ForConditionalGeneration الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensor، اختياري، يُعاد عند تقديمlabels،torch.Tensorمن الشكل(1,)) — خسارة نمذجة اللغة من نموذج اللغة. - logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة في نموذج اللغة. - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات مُشفِّر الرؤية. - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions، اختياري) — مخرجات Q-Former (Querying Transformer). - language_model_outputs (
CausalLMOutputWithPastأوSeq2SeqLMOutput) — مخرجات نموذج اللغة.
أمثلة:
تجهيز المعالج والنموذج ومدخل الصورة
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2ForConditionalGeneration
>>> import torch

>>> device = "cuda" if torch.cuda.is_available() else "cpu"

>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2ForConditionalGeneration.from_pretrained(
...     "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.float16
... )  # doctest: +IGNORE_RESULT

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
وصف الصور (دون تقديم موجه نصي):
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)

>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two cats laying on a couch
الإجابة البصرية على الأسئلة (الموجّه = السؤال):
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.float16)

>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
لاحظ أن الاستدلال بـ int8 مدعوم أيضًا من خلال bitsandbytes. يقلل هذا بشكل كبير من كمية الذاكرة التي يستخدمها النموذج مع الحفاظ على الأداء نفسه.
>>> model = Blip2ForConditionalGeneration.from_pretrained(
...     "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.bfloat16
... )  # doctest: +IGNORE_RESULT

>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.bfloat16)

>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
generate
< source >( pixel_values: Tensorinput_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**generate_kwargs ) → captions (list)
المعاملات
- pixel_values (
torch.Tensorof shape (batch_size, num_channels, height, width)) — الصور المدخلة التي سيتم معالجتها. - input_ids (
torch.LongTensorمن الشكل (batch_size, sequence_length)، اختياري) — التسلسل المستخدم كموجّه (prompt) للتوليد. - attention_mask (
torch.LongTensorمن الشكل (batch_size, sequence_length)، اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تمثيل مضمّن للمدخلات. يجب أن يكون من نوع float وليس رموز int. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء الترميز الموضعي لتضمينات الصورة.
يعيد
التسميات (قائمة)
قائمة من السلاسل النصية بطول batch_size * num_captions.
يتجاوز دالة generate ليتمكّن من استخدام النموذج كمولّد مشروط.
get_image_features
< source >( pixel_values: Tensorinterpolate_pos_encoding: bool | None = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithVisionQformerOutputs or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithVisionQformerOutputs أو tuple(torch.Tensor)
BaseModelOutputWithVisionQformerOutputs أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (Blip2Config) والمدخلات.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات مُشفِّر الرؤية.qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions، اختياري) — مخرجات Q-Former (Querying Transformer).
مثال:
>>> from PIL import Image
>>> from transformers import AutoProcessor, Blip2ForConditionalGeneration

>>> model = Blip2ForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")

>>> messages = [
...     {
...         "role": "user", "content": [
...             {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Where is the cat standing?"},
...         ]
...     },
... ]

>>> inputs = processor.apply_chat_template(
...     messages,
...     tokenize=True,
...     return_dict=True,
...     return_tensors="pt",
...     add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
Blip2ForImageTextRetrieval
فئة transformers.Blip2ForImageTextRetrieval
< source >( config: Blip2Config )
المعاملات
- config (Blip2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج BLIP-2 مزوّد بمشروع (projector) للرؤية والنص، ورأس تصنيف (classification head) في الأعلى. يُستخدم النموذج في سياق استرجاع النص من الصور. عند تقديم صورة ونص، يعيد النموذج احتمال أن يكون النص ذا صلة بالصورة.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorinput_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Noneuse_image_text_matching_head: bool | None = Falseoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → Blip2ImageTextMatchingModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور). - input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في مفردات نموذج اللغة. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي يمكن لنموذج اللغة أن يستمر في توليده.يمكن الحصول على الفهارس باستخدام Blip2Processor. راجع Blip2Processor.call() للحصول على التفاصيل.
- attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- use_image_text_matching_head (
bool, اختياري) — ما إذا كان يجب إرجاع درجات مطابقة الصورة والنص أو درجات التباين. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
Blip2ImageTextMatchingModelOutput أو tuple(torch.Tensor)
Blip2ImageTextMatchingModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Blip2Config) والمدخلات.
تتجاوز طريقة Blip2ForImageTextRetrieval الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensorof shape(1,), اختياري, يُعاد عندما يكونreturn_lossهوTrue) — خسارة تباينية لتقدير التشابه بين الصورة والنص. - logits_per_image (
torch.Tensorمن الشكل(image_batch_size, text_batch_size)) — درجات ضرب النقاط المُقيَّسة بينimage_embedsوtext_embeds. يمثل هذا درجات التشابه بين الصورة والنص. - logits_per_text (
torch.Tensorمن الشكل(text_batch_size, image_batch_size)) — درجات ضرب النقطة المُقيَّسة بينtext_embedsوimage_embeds. يمثل هذا درجات التشابه بين النص والصورة. - text_embeds (
torch.Tensorمن الشكل(batch_size, output_dim) — تمثيلات النص (embeddings) التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط (projection layer) على المخرجات المجمعة (pooled output). - image_embeds (
torch.Tensorمن الشكل(batch_size, output_dim) — تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على المخرجات المجمعة. - text_model_output (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات Blip2QFormerModel. - vision_model_output (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات Blip2VisionModel.
أمثلة:
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Blip2ForImageTextRetrieval

>>> device = "cuda" if torch.cuda.is_available() else "cpu"

>>> model = Blip2ForImageTextRetrieval.from_pretrained("Salesforce/blip2-itm-vit-g", dtype=torch.float16)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")

>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> text = "two cats laying on a pink blanket"

>>> inputs = processor(images=image, text=text, return_tensors="pt").to(device, torch.float16)
>>> itm_out = model(**inputs, use_image_text_matching_head=True)
>>> logits_per_image = torch.nn.functional.softmax(itm_out.logits_per_image, dim=1)
>>> probs = logits_per_image.softmax(dim=1)  # we can take the softmax to get the label probabilities

>>> print(f"{probs[0][0]:.1%} that image 0 is not '{text}'")
26.9% that image 0 is not 'two cats laying on a pink blanket'

>>> print(f"{probs[0][1]:.1%} that image 0 is '{text}'")
73.0% that image 0 is 'two cats laying on a pink blanket'

>>> texts = ["a photo of a cat", "a photo of a dog"]

>>> inputs = processor(images=image, text=texts, return_tensors="pt").to(device, torch.float16)
>>> itc_out = model(**inputs, use_image_text_matching_head=False)
>>> logits_per_image = itc_out.logits_per_image  # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1)  # we can take the softmax to get the label probabilities

>>> print(f"{probs[0][0]:.1%} that image 0 is '{texts[0]}'")
55.3% that image 0 is 'a photo of a cat'

>>> print(f"{probs[0][1]:.1%} that image 0 is '{texts[1]}'")
44.7% that image 0 is 'a photo of a dog'
Blip2TextModelWithProjection
فئة transformers.Blip2TextModelWithProjection
< source >( config: Blip2Config )
المعاملات
- config (Blip2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Blip 2 مع طبقة إسقاط في الأعلى (طبقة خطية فوق المخرجات المجمعة).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Blip2TextModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1].
يعيد
Blip2TextModelOutput أو tuple(torch.Tensor)
Blip2TextModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Blip2Config) والمدخلات.
تتجاوز طريقة Blip2TextModelWithProjection الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
text_embeds (
torch.Tensorمن الشكل(batch_size, output_dim)اختياري يُعاد عند تهيئة النموذج معwith_projection=True) — تمثيلات النص (embeddings) التي يتم الحصول عليها من خلال تطبيق طبقة الإسقاط (projection layer) على pooler_output.last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import AutoProcessor, Blip2TextModelWithProjection

>>> device = "cuda" if torch.cuda.is_available() else "cpu"

>>> model = Blip2TextModelWithProjection.from_pretrained(
...     "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )

>>> model.to(device)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")

>>> inputs = processor(text=["a photo of a cat", "a photo of a dog"], return_tensors="pt").to(device)

>>> outputs = model(**inputs)
>>> text_embeds = outputs.text_embeds
>>> print(text_embeds.shape)
torch.Size([2, 7, 256])
Blip2VisionModelWithProjection
فئة transformers.Blip2VisionModelWithProjection
< source >( config: Blip2Config )
المعاملات
- config (Blip2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Blip 2 مع طبقة إسقاط في الأعلى (طبقة خطية فوق المخرجات المجمعة).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Blip2VisionModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (Blip2Processor يستخدم BlipImageProcessor لمعالجة الصور).
يعيد
Blip2VisionModelOutput أو tuple(torch.Tensor)
Blip2VisionModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على التهيئة (Blip2Config) والمدخلات.
تتجاوز طريقة Blip2VisionModelWithProjection الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
image_embeds (
torch.Tensorمن الشكل(batch_size, output_dim)اختياري يُعاد عند تهيئة النموذج معwith_projection=True) — تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على pooler_output.last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import AutoProcessor, Blip2VisionModelWithProjection
>>> from transformers.image_utils import load_image

>>> device = "cuda" if torch.cuda.is_available() else "cpu"

>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model = Blip2VisionModelWithProjection.from_pretrained(
...     "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)

>>> with torch.inference_mode():
...     outputs = model(**inputs)
>>> image_embeds = outputs.image_embeds
>>> print(image_embeds.shape)
torch.Size([1, 32, 256])