
Transformers documentation
Perceiver
نُشر هذا النموذج في أوراق HF في 30 يوليو 2021، وأُضيف إلى مكتبة Hugging Face Transformers في 8 ديسمبر 2021.
Perceiver
نظرة عامة
قُدِّم نموذج Perceiver IO في Perceiver IO: A General Architecture for Structured Inputs & Outputs بواسطة Andrew Jaegle وSebastian Borgeaud وJean-Baptiste Alayrac وCarl Doersch وCatalin Ionescu وDavid Ding وSkanda Koppula وDaniel Zoran وAndrew Brock وEvan Shelhamer وOlivier Hénaff وMatthew M. Botvinick وAndrew Zisserman وOriol Vinyals وJoão Carreira.
Perceiver IO هو تعميم لـ Perceiver للتعامل مع مخرجات غير محددة بالإضافة إلى مدخلات غير محددة. كان Perceiver الأصلي ينتج تسمية تصنيف واحدة فقط. بالإضافة إلى تسميات التصنيف، يمكن لـ Perceiver IO أن ينتج (على سبيل المثال) لغة، وتدفقًا بصريًا، وفيديوهات متعددة الوسائط مع صوت. يتم ذلك باستخدام نفس المكونات الأساسية المستخدمة في Perceiver الأصلي. التعقيد الحسابي لـ Perceiver IO خطي بالنسبة لحجم المدخلات والمخرجات، وتحدث معظم عمليات المعالجة في الفضاء الكامن، مما يتيح لنا معالجة مدخلات ومخرجات أكبر بكثير مما يمكن للـ Transformers القياسية التعامل معه. وهذا يعني، على سبيل المثال، أن Perceiver IO يمكنه تنفيذ نمذجة لغة مقنّعة بأسلوب BERT مباشرةً باستخدام البايتات بدلاً من المدخلات المرمّزة.
المستخلص من الورقة البحثية هو كالتالي:
يحقق نموذج Perceiver الذي طُرح مؤخرًا نتائج جيدة في عدة مجالات (الصور، الصوت، متعدد الوسائط، سحابة النقاط) مع التوسع خطيًا في الحساب والذاكرة مع حجم المدخلات. وعلى الرغم من أن Perceiver يدعم أنواعًا عديدة من المدخلات، إلا أنه لا يستطيع إنتاج مخرجات معقدة بل مخرجات بسيطة جدًا مثل درجات التصنيف. يتغلب Perceiver IO على هذه القيود دون التضحية بالخصائص الجاذبة للنموذج الأصلي من خلال تعلّم الاستعلام المرن عن الفضاء الكامن للنموذج لإنتاج مخرجات بحجم ودلالات تعسفية. لا يزال Perceiver IO يفصل عمق النموذج عن حجم البيانات ولا يزال يتوسع خطيًا مع حجم البيانات، لكن الآن بالنسبة لكل من حجم المدخلات والمخرجات. يحقق نموذج Perceiver IO الكامل نتائج قوية في المهام ذات فضاءات المخرجات عالية البنية، مثل اللغة الطبيعية والفهم البصري، وStarCraft II، والمجالات متعددة المهام ومتعددة الوسائط. ومن أبرز النتائج، يطابق Perceiver IO خط الأساس BERT القائم على Transformer في معيار GLUE اللغوي دون الحاجة إلى تقسيم المدخلات إلى رموز، ويحقق أداءً متقدمًا في تقدير التدفق الضوئي في Sintel.
إليك ملخص موجز يوضح كيفية عمل Perceiver:
المشكلة الرئيسية في آلية الانتباه الذاتي (self-attention) في نموذج Transformer هي أن متطلبات الوقت والذاكرة تتضاعف بشكل تربيعي مع طول التسلسل. ولذلك، فإن نماذج مثل BERT وRoBERTa محدودة بطول تسلسل أقصى يبلغ 512 رمزًا. يهدف Perceiver إلى حل هذه المشكلة من خلال تنفيذ الانتباه الذاتي على مجموعة من المتغيرات الكامنة (latent variables) بدلاً من تطبيقه على المدخلات، واستخدام المدخلات فقط للانتباه المتقاطع (cross-attention). وبهذه الطريقة، لم تعد متطلبات الوقت والذاكرة تعتمد على طول المدخلات، حيث يتم استخدام كمية ثابتة من المتغيرات الكامنة، مثل 256 أو 512. تُهيّأ هذه المتغيرات عشوائيًا في البداية، ثم تُدرَّب من النهاية إلى النهاية باستخدام الانتشار العكسي (backpropagation).
داخليًا، سيقوم PerceiverModel بإنشاء المتغيرات الكامنة (latents)، وهي متجه (tensor) بأبعاد (batch_size, num_latents, d_latents). يجب تقديم inputs (قد تكون نصوصًا أو صورًا أو صوتًا، أو أي شيء آخر!) إلى النموذج، الذي سيستخدمها لأداء الانتباه المتقاطع (cross-attention) مع المتغيرات الكامنة. يكون ناتج مشفر Perceiver متجهًا بنفس الأبعاد. ثم يمكن، على غرار BERT، تحويل حالات الإخفاء الأخيرة (last hidden states) للمتغيرات الكامنة إلى قيم تصنيف (classification logits) عن طريق أخذ المتوسط على بُعد التسلسل، ووضع طبقة خطية فوق ذلك لإسقاط d_latents إلى num_labels.
كانت هذه فكرة ورقة Perceiver الأصلية. غير أنها كانت لا تستطيع سوى إخراج قيم التصنيف (logits). في عمل لاحق، PerceiverIO، عمّموا الفكرة للسماح للنموذج أيضاً بإنتاج مخرجات بحجم عشوائي. كيف ذلك، كما قد تسأل؟ الفكرة في الواقع بسيطة نسبياً: يُعرَّف مخرجات بحجم عشوائي، ثم يُطبَّق الانتباه المتقاطع (cross-attention) مع الحالات المخفية الأخيرة للكائنات الكامنة (latents)، باستخدام المخرجات كاستعلامات (queries)، والكائنات الكامنة كمفاتيح (keys) وقيم (values).
لنفترض أن المرء يريد تنفيذ نمذجة اللغة المقنّعة (بنمط BERT) باستخدام Perceiver. وبما أن طول مدخلات Perceiver لن يؤثر على زمن حساب طبقات الانتباه الذاتي، يمكن تقديم بايتات خام، بحيث تكون inputs المقدمة إلى النموذج بطول 2048. وإذا قُنعّعت الآن بعض هذه الرموز الـ 2048، يمكن تعريف outputs على أنها ذات الشكل: (batch_size, 2048, 768). ثم يُنفَّذ الانتباه المتقاطع مع الحالات المخفية النهائية للكائنات الكامنة لتحديث متجه outputs. وبعد الانتباه المتقاطع، لا يزال لدينا متجه ذو الشكل (batch_size, 2048, 768). يمكن بعد ذلك وضع رأس نمذجة لغة عادي في الأعلى، لإسقاط البُعد الأخير إلى حجم مفردات النموذج، أي إنشاء متجهات logits ذات الشكل (batch_size, 2048, 262) (لأن Perceiver يستخدم حجم مفردات يبلغ 262 معرّف بايت).
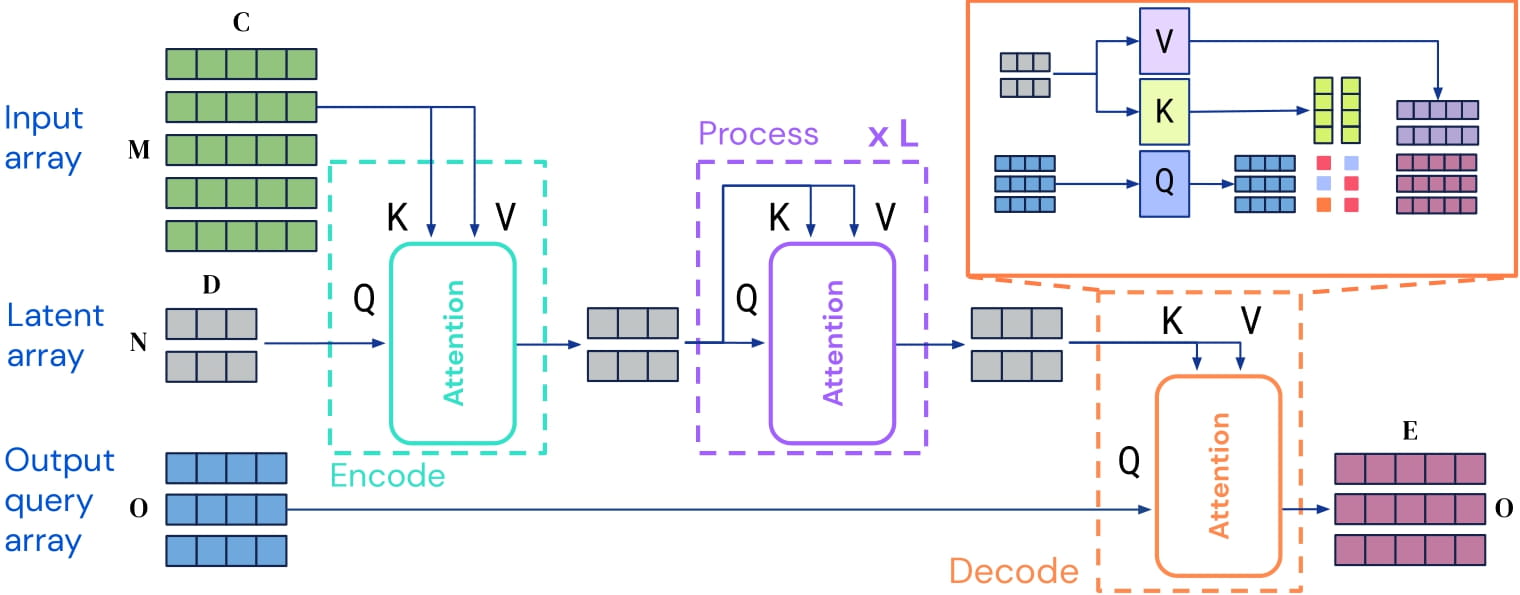 Perceiver IO architecture. Taken from the original paper
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
Perceiver does not work with
torch.nn.DataParalleldue to a bug in PyTorch, see issue #36035
الموارد
- أسرع طريقة للبدء باستخدام Perceiver هي الاطلاع على دواوين التعليم.
- راجع المنشور على المدونة إذا كنت ترغب في فهم كيفية عمل النموذج وكيفية تنفيذه في المكتبة بشكل كامل. لاحظ أن النماذج المتاحة في المكتبة تعرض بعض الأمثلة فقط لما يمكنك القيام به باستخدام Perceiver. هناك حالات استخدام أكثر بكثير، بما في ذلك الإجابة على الأسئلة، والتعرف على الكيانات المسمّاة، والكشف عن الأشياء، وتصنيف الصوت، وتصنيف الفيديو، وغيرها.
- دليل مهمة تصنيف النصوص
- دليل مهمة نمذجة اللغة المقنّعة
- دليل مهمة تصنيف الصور
المخرجات الخاصة بـ Perceiver
فئة transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput
< source >( logits: typing.Optional[torch.Tensor] = Nonelast_hidden_state: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = Nonecross_attentions: tuple[torch.Tensor] | None = None )
المعاملات
- logits (
torch.Tensorمن الشكل(batch_size, num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax). - last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات الإخفاء عند مخرج الطبقة الأخيرة من النموذج. - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- cross_attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات نموذج Perceiver الأساسي، مع حالات مخفية محتملة، وانتباه، وانتباه متقاطع.
فئة transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput
< source >( logits: typing.Optional[torch.Tensor] = Nonecross_attentions: tuple[torch.Tensor] | None = None )
المعاملات
- logits (
torch.Tensorمن الشكل(batch_size, num_labels)) — مخرج المُفكِّك الأساسي. - cross_attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات فاحص Perceiver، مع احتمالية وجود انتباه متقاطع.
فئة transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput
< source >( loss: typing.Optional[torch.Tensor] = Nonelogits: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = Nonecross_attentions: tuple[torch.Tensor] | None = None )
المعاملات
- loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة نمذجة اللغة المقنّعة (MLM). - logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax). - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- cross_attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات نموذج اللغة المقنّع الخاص بـ Perceiver.
فئة transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput
< source >( loss: typing.Optional[torch.Tensor] = Nonelogits: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = Nonecross_attentions: tuple[torch.Tensor] | None = None )
المعاملات
- loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1). - logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax). - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- cross_attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات Perceiver لنماذج تصنيف التسلسل/الصورة، والتدفق البصري، والترميز الذاتي متعدد الوسائط.
PerceiverConfig
فئة transformers.PerceiverConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_latents: int = 256d_latents: int = 1280d_model: int = 768num_blocks: int = 1num_self_attends_per_block: int = 26num_self_attention_heads: int = 8num_cross_attention_heads: int = 8qk_channels: int | None = Nonev_channels: int | None = Nonecross_attention_shape_for_attention: str = 'kv'self_attention_widening_factor: int = 1cross_attention_widening_factor: int = 1hidden_act: str = 'gelu'attention_probs_dropout_prob: float | int = 0.1initializer_range: float = 0.02layer_norm_eps: float = 1e-12use_query_residual: bool = Truevocab_size: int = 262max_position_embeddings: int = 2048image_size: int | list[int] | tuple[int, int] = 56train_size: list[int] | tuple[int, ...] = (368, 496)num_frames: int = 16audio_samples_per_frame: int = 1920samples_per_patch: int = 16output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224)output_num_channels: int = 512_label_trainable_num_channels: int = 1024 )
المعاملات
- num_latents (
int، اختياري، القيمة الافتراضية 256) — عدد الكمونيات. - d_latents (
int، اختياري، القيمة الافتراضية 1280) — أبعاد التضمينات الكامنة. - d_model (
int، اختياري، القيمة الافتراضية768) — حجم طبقات المُشفِّر وطبقة المُجمِّع. - num_blocks (
int، اختياري، القيمة الافتراضية 1) — عدد الكتل في مُشفِّر Transformer. - num_self_attends_per_block (
int، اختياري، القيمة الافتراضية 26) — عدد طبقات الانتباه الذاتي في كل كتلة. - num_self_attention_heads (
int، اختياري، القيمة الافتراضية 8) — عدد رؤوس الانتباه في كل طبقة انتباه ذاتي داخل مُشفِّر Transformer. - num_cross_attention_heads (
int، اختياري، القيمة الافتراضية 8) — عدد رؤوس الانتباه لكل طبقة انتباه متقاطع في مُشفِّر Transformer. - qk_channels (
int، اختياري) — البُعد الذي تُسقط عليه الاستعلامات + المفاتيح قبل تطبيق الانتباه في طبقات الانتباه المتقاطع والانتباه الذاتي داخل المُشفِّر. إذا لم يُحدَّد، فسيتم افتراضياً الحفاظ على بُعد الاستعلامات. - v_channels (
int, اختياري) — البُعد الذي تُسقط إليه القيم قبل تطبيق الانتباه في طبقات الانتباه المتقاطع والانتباه الذاتي في المُشفِّر. إذا لم يُحدَّد، فسيتم افتراضياً الحفاظ على بُعد الاستعلامات. - cross_attention_shape_for_attention (
str، اختياري، القيمة الافتراضية"kv") — البُعد المستخدم عند تقليل حجم الاستعلامات والمفاتيح في طبقة الانتباه المتقاطع (cross-attention) داخل المُشفِّر. - self_attention_widening_factor (
int، اختياري، القيمة الافتراضية 1) — بعد طبقة التغذية الأمامية في طبقة الانتباه المتقاطع في مُشفِّر Transformer. - cross_attention_widening_factor (
int، اختياري، القيمة الافتراضية 1) — أبعاد طبقة التغذية الأمامية في طبقات الانتباه الذاتي لمشفّر Transformer. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - use_query_residual (
float, اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة بقية الاستعلام (query residual) في طبقة الانتباه المتقاطع (cross-attention) داخل المُشفِّر (encoder). - vocab_size (
int، اختياري، القيمة الافتراضية262) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - max_position_embeddings (
int، اختياري، القيمة الافتراضية2048) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج. - image_size (
int، اختياري، القيمة الافتراضية 56) — حجم الصور بعد المعالجة المسبقة، وذلك لـ PerceiverForImageClassificationLearned. - train_size (
list[int]، اختياري، القيمة الافتراضية[368, 496]) — حجم التدريب للصور في نموذج التدفق الضوئي. - num_frames (
int، اختياري، القيمة الافتراضية 16) — عدد إطارات الفيديو المستخدمة في نموذج الترميز التلقائي متعدد الوسائط. - audio_samples_per_frame (
int, اختياري، القيمة الافتراضية 1920) — عدد عينات الصوت لكل إطار في نموذج الترميز التلقائي متعدد الوسائط. - samples_per_patch (
int، اختياري، القيمة الافتراضية 16) — عدد عينات الصوت لكل رقعة عند المعالجة المسبقة للصوت لنموذج الترميز التلقائي متعدد الوسائط. - output_shape (
list[int]، اختياري، القيمة الافتراضية[1, 16, 224, 224]) — شكل المخرجات (batch_size, num_frames, height, width) لاستعلامات فاحص الفيديو في نموذج الترميز التلقائي متعدد الوسائط. يستثني هذا بُعد القناة. - output_num_channels (
int، اختياري، القيمة الافتراضية 512) — عدد قنوات الإخراج لكل مُفكِّك نمط.
هذه فئة الإعدادات المخزنة لإعدادات PerceiverModel. تُستخدم لتوليد نموذج Perceiver وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ deepmind/language-perceiver
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import PerceiverModel, PerceiverConfig

>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()

>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PerceiverTokenizer
فئة transformers.PerceiverTokenizer
< source >( pad_token = '[PAD]'bos_token = '[BOS]'eos_token = '[EOS]'mask_token = '[MASK]'cls_token = '[CLS]'sep_token = '[SEP]'model_max_length = 2048**kwargs )
المعاملات
- pad_token (
str، اختياري، القيمة الافتراضية"[PAD]") — الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة. - bos_token (
str، اختياري، القيمة الافتراضية"[BOS]") — رمز بداية الجملة (محجوز في قاموس الرموز، لكنه غير مستخدم فعليًا). - eos_token (
str, اختياري, الافتراضي هو"[EOS]") — رمز نهاية التسلسل (محجوز في قاموس الرموز، لكنه غير مستخدم فعليًا). عند بناء تسلسل باستخدام الرموز الخاصة، لا يُستخدم هذا الرمز لنهاية التسلسل، بل يُستخدم رمز الفاصل (sep_token) لهذا الغرض.عند بناء تسلسل باستخدام الرموز الخاصة، لا يُستخدم هذا الرمز لنهاية التسلسل. الرمز المستخدم هو
sep_token. - mask_token (
str، اختياري، القيمة الافتراضية"[MASK]") — رمز MASK، وهو مفيد لنمذجة اللغة المقنّعة. - cls_token (
str، اختياري، القيمة الافتراضية"[CLS]") — رمز CLS (محجوز في المفردات، لكنه غير مستخدم فعليًا). - sep_token (
str، اختياري، القيمة الافتراضية"[SEP]") — رمز الفاصل، الذي يُستخدم عند بناء تسلسل من تسلسلين.
أنشئ مُرمِّز Perceiver. يستخدم Perceiver ببساطة ترميز البايتات الخام utf-8.
يرث هذا المُجزِّئ من PreTrainedTokenizer الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
المعاملات
- text (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نصوص مُقسّمة مسبقًا إلى رموز). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسّمة مسبقًا)، فيجب تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_pair (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نصوص مُقسّمة مسبقًا إلى رموز). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسّمة مسبقًا)، فيجب تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_target (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات التي سيتم ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُقسَّمة مسبقًا)، فيجب عليك تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_pair_target (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات التي سيتم ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُقسَّمة مسبقًا)، فيجب عليك تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - tokenizer_kwargs (
dict[str, Any], اختياري) — معاملات إضافية (kwargs) تُمرَّر إلى مُجزِّئ النص (tokenizer). سيتم دمج هذه المعاملات مع المعاملات الصريحة ومعاملات أخرى، مع إعطاء الأولوية للمعاملات الصريحة. - add_special_tokens (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسيةPretrainedTokenizerBase.build_inputs_with_special_tokens، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. يكون هذا مفيدًا إذا كنت ترغب في إضافة رموزbosأوeosتلقائيًا. - padding (
bool,strأو PaddingStrategy, اختياري, الافتراضي هوFalse) — يُفعّل التحكم في الحشو. يقبل القيم التالية:Trueأو'longest': يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).'max_length': يتم ملء النص حتى الطول الأقصى المحدد عبر الحجةmax_lengthأو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.Falseأو'do_not_pad'(الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
- truncation (
bool,strأو TruncationStrategy, اختياري, الافتراضي هوFalse) — تفعيل التحكم في القص. يقبل القيم التالية:Trueأو'longest_first': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. يتم هذا القص رمزًا تلو الآخر، حيث يُزال رمز من أطول تسلسل في الزوج إذا كان قد قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).'only_first': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يُقصّ هذا الخيار سوى التسلسل الأول من الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).'only_second': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يتم قصّ النص الثاني من الزوج إلا إذا قُدِّم زوج من النصوص (أو دفعة من الأزواج).Falseأو'do_not_truncate'(الافتراضي): لا يوجد اقتطاع (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال في النموذج).
- max_length (
int, اختياري) — يتحكم في الحد الأقصى للطول الذي ستستخدمه إحدى معاملات القص/الحشو.إذا تُرك غير مُعيَّن أو عُدِّل إلى
None، فسيتم استخدام الطول الأقصى المُعرَّف مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب طولًا أقصى. وإذا لم يكن للنموذج طول إدخال أقصى محدد (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى طول أقصى. - stride (
int، اختياري، القيمة الافتراضية 0) — إذا تم تعيينه إلى رقم معmax_length، فستحتوي الرموز الزائدة المُعاد عندreturn_overflowing_tokens=Trueعلى بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة. - is_split_into_words (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان المدخل مُجزَّأً مسبقاً (على سبيل المثال، مقسَّماً إلى كلمات). إذا تم ضبطه علىTrue، يفترض المُجزِّئ أن المدخل مقسَّم بالفعل إلى كلمات (على سبيل المثال، عن طريق تقسيمه على المسافات) وسيُجزِّئها. هذا مفيد لتصنيف الكيانات الاسمية أو تصنيف الرموز. - pad_to_multiple_of (
int, اختياري) — إذا تم ضبطه، سيتم توسيط التسلسل إلى مضاعف للقيمة المقدمة. يتطلب تفعيلpadding. هذا مفيد بشكل خاص لتمكين استخدام نوى Tensor على أجهزة NVIDIA التي تتمتع بقابلية حساب>= 7.5(Volta). - padding_side (
str، اختياري) — الجهة التي يجب تطبيق الحشو عليها في النموذج. يجب اختيارها من بين [‘right’، ‘left’]. القيمة الافتراضية تُختار من سمة الفئة التي تحمل الاسم نفسه. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات بدلاً من قائمة من الأعداد الصحيحة في Python. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن نوع Numpy.
- return_token_type_ids (
bool, اختياري) — ما إذا كان يجب إرجاع معرّفات أنواع الرموز. إذا تُركت القيمة الافتراضية، فسيتم إرجاع معرّفات أنواع الرموز وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما تحددها خاصيةreturn_outputs. - return_attention_mask (
bool, اختياري) — ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما هو معرّف بواسطةreturn_outputsالخاصية. - return_overflowing_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم إرجاع تسلسلات الرموز الزائدة أم لا. إذا تم تقديم زوج من تسلسلات معرفات الإدخال (أو دفعة من الأزواج) معtruncation_strategy = longest_firstأوTrue، فسيتم رفع خطأ بدلاً من إرجاع الرموز الزائدة. - return_special_tokens_mask (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع معلومات قناع الرموز الخاصة أم لا. - return_offsets_mapping (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان يجب إرجاع(char_start, char_end)لكل رمز.يتوفر هذا فقط على مُرمّزيات سريعة ترث من PreTrainedTokenizerFast، فإذا كنت تستخدم مُرمّزي Python، فسيُطلق هذا الدالة
NotImplementedError. - return_length (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع أطوال المدخلات المُرمّزة أم لا. - verbose (
bool، اختياري، الافتراضيTrue) — ما إذا كان يجب طباعة مزيد من المعلومات والتحذيرات أم لا. - **kwargs — تُمرَّر إلى طريقة
self.tokenize()
يعيد
BatchEncoding يحتوي على الحقول التالية:
-
input_ids — قائمة معرّفات الرموز التي تُغذّى بها النموذج.
-
token_type_ids — قائمة معرّفات أنواع الرموز التي تُمرَّر إلى النموذج (عندما يكون
return_token_type_ids=Trueأو إذا كان “token_type_ids” ضمنself.model_input_names). -
attention_mask — قائمة بالفهارس تحدد الرموز التي ينبغي للنموذج الانتباه إليها (عندما يكون
return_attention_mask=Trueأو إذا كان “attention_mask” ضمنself.model_input_names). -
overflowing_tokens — قائمة تسلسلات الرموز المتجاوزة (عند تحديد
max_lengthوreturn_overflowing_tokens=True). -
num_truncated_tokens — عدد الرموز المقصوصة (عند تحديد
max_lengthوreturn_overflowing_tokens=True). -
special_tokens_mask — قائمة من الأصفار والواحدات، حيث تشير الواحدة إلى الرموز الخاصة المضافة وتصفّر إلى رموز التسلسل العادية (عندما يكون
add_special_tokens=Trueوreturn_special_tokens_mask=True). -
length — طول المدخلات (عندما يكون
return_length=True)
الطريقة الرئيسية لتجزئة (tokenization) وتجهيز تسلسل واحد أو عدة تسلسلات، أو زوج واحد أو عدة أزواج من التسلسلات، للنموذج.
PerceiverImageProcessor
فئة transformers.PerceiverImageProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 256, 'width': 256}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية3) — مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enumPILImageResampling. لا يؤثر إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور PerceiverImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - image_like_kwargs (
dict[str, Any], اختياري) — علامة مخصّصة للمطوّرين لإدخال مدخلات إضافية مشابهة للصور ستخضع أيضاً للمعالجة المسبقة. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجج اسمية (kwargs). على سبيل المثال،preprocess(images, masks=masks)هو الخيار المفضّل، لكنه قد يسبّب مشاكل في أولوية الحُجج لبعض النماذج. في تلك الحالات يمكن استخدامpreprocess(images, image_like_inputs={"masks": masks})بدلاً منه. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
PerceiverImageProcessorPil
فئة transformers.PerceiverImageProcessorPil
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 256, 'width': 256}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية3) — مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enumPILImageResampling. لا يؤثر إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور PerceiverImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - image_like_kwargs (
dict[str, Any], اختياري) — علامة مخصّصة للمطوّرين لإدخال مدخلات إضافية مشابهة للصور ستخضع أيضاً للمعالجة المسبقة. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجج اسمية (kwargs). على سبيل المثال،preprocess(images, masks=masks)هو الخيار المفضّل، لكنه قد يسبّب مشاكل في أولوية الحُجج لبعض النماذج. في تلك الحالات يمكن استخدامpreprocess(images, image_like_inputs={"masks": masks})بدلاً منه. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
PerceiverTextPreprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — إعدادات النموذج.
معالجة النصوص المسبقة لمُشفِّر Perceiver. يمكن استخدامه لتضمين inputs وإضافة الترميزات الموضعية.
تُحدَّد أبعاد التضمينات من خلال خاصية d_model في الإعداد.
PerceiverImagePreprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor
< source >( configprep_type = 'conv'spatial_downsample: int = 4temporal_downsample: int = 1position_encoding_type: str = 'fourier'in_channels: int = 3out_channels: int = 64conv_after_patching: bool = Falseconv_after_patching_in_channels: int = 54conv2d_use_batchnorm: bool = Trueconcat_or_add_pos: str = 'concat'project_pos_dim: int = -1**position_encoding_kwargs )
المعاملات
- config ([PerceiverConfig]) — إعدادات النموذج.
- prep_type (
str، اختياري، القيمة الافتراضية"conv") — نوع المعالجة المسبقة. يمكن أن يكون “conv1x1” أو “conv” أو “patches” أو “pixels”. - spatial_downsample (
int، اختياري، القيمة الافتراضية 4) — معامل تقليل الدقة المكانية. - temporal_downsample (
int, اختياري، القيمة الافتراضية 1) — معامل تقليل العينات الزمنية (لا ينطبق إلا في حال وجود بُعد زمني). - position_encoding_type (
str، اختياري، القيمة الافتراضية"fourier") — نوع ترميز الموضع. يمكن أن يكون"fourier"أو "trainable". - in_channels (
int، اختياري، القيمة الافتراضية 3) — عدد القنوات في المدخلات. - out_channels (
int، اختياري، القيمة الافتراضية 64) — عدد القنوات في المخرجات. - conv_after_patching (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تطبيق طبقة تجميعية (convolutional layer) بعد التقطيع (patching). - conv_after_patching_in_channels (
int، اختياري، القيمة الافتراضية 54) — عدد القنوات في مدخل طبقة الالتفاف بعد تطبيق الباتشينغ. - conv2d_use_batchnorm (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام تطبيع الدفعة في الطبقة الالتفافية. - concat_or_add_pos (
str, optional, defaults to"concat") — How to concatenate the position encoding to the input. Can be “concat” or “add”. - project_pos_dim (
int، اختياري، القيمة الافتراضية -1) — البُعد الذي يُسقط عليه ترميز الموضع. إذا كانت القيمة -1، فلا يُطبَّق إسقاط. - **position_encoding_kwargs (
Dict, اختياري) — معلمات الكلمات المفتاحية لتشفير الموقع.
معالجة الصور المسبقة لمُشفِّر Perceiver.
ملاحظة: يشير الحُجّة out_channels إلى قنوات المخرجات لطبقة الالتفاف، إذا تم ضبط prep_type على “conv1x1” أو “conv”. عند إضافة تضمينات الموضع المطلق، يجب التأكد من ضبط num_channels في معاملات الترميز الموضعي (position encoding kwargs) بحيث تساوي out_channels.
PerceiverOneHotPreprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — إعدادات النموذج.
معالج مسبق بنمط One-hot لمُشفِّر Perceiver. يمكن استخدامه لإبعاد مؤشر وهمي إلى المدخلات.
PerceiverAudioPreprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor
< source >( configprep_type: str = 'patches'samples_per_patch: int = 96position_encoding_type: str = 'fourier'concat_or_add_pos: str = 'concat'out_channels = 64project_pos_dim = -1**position_encoding_kwargs )
المعاملات
- config ([PerceiverConfig]) — إعدادات النموذج.
- prep_type (
str، اختياري، القيمة الافتراضية"patches") — نوع المعالج المسبق للاستخدام. النوع المدعوم الوحيد هو"patches". - samples_per_patch (
int، اختياري، القيمة الافتراضية 96) — عدد العينات لكل رقعة. - position_encoding_type (
str, optional, defaults to"fourier") — Type of position encoding to use. Can be “trainable” or “fourier”. - concat_or_add_pos (
str, optional, defaults to"concat") — How to concatenate the position encoding to the input. Can be “concat” or “add”. - out_channels (
int، اختياري، القيمة الافتراضية 64) — عدد القنوات في المخرجات. - project_pos_dim (
int، اختياري، القيمة الافتراضية -1) — البُعد الذي يُسقط عليه ترميز الموضع. إذا كانت القيمة -1، فلا يُطبَّق إسقاط. - **position_encoding_kwargs (
Dict, اختياري) — معلمات الكلمات المفتاحية لتشفير الموقع.
معالجة مسبقة للصوت لمُشفِّر Perceiver.
PerceiverMultimodalPreprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor
< source >( modalities: Mappingmask_probs: collections.abc.Mapping[str, float] | None = Nonemin_padding_size: int = 2 )
المعاملات
- modalities (
Mapping[str, PreprocessorType]) — قاموس يربط اسم النمط (modality) بمعالج ما قبل المعالجة (preprocessor). - mask_probs (
dict[str, float]) — قاموس يربط اسم النمط (modality) باحتمالية الإخفاء (masking) الخاصة بذلك النمط. - min_padding_size (
int، اختياري، القيمة الافتراضية 2) — أدنى حجم للتعبئة (padding) لجميع الأنماط (modalities). سيكون عدد القنوات (num_channels) في المخرجات النهائية مساوياً لأقصى عدد للقنوات عبر جميع الأنماط مضافاً إليه min_padding_size.
المعالجة المسبقة متعددة الوسائط لمشفّر Perceiver.
تُعالَج المدخلات الخاصة بكل نمط مسبقاً، ثم تُملأ بتضمينات مواقع قابلة للتدريب بحيث تمتلك جميعها العدد نفسه من القنوات.
PerceiverProjectionDecoder
فئة transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder
< source >( config )
المعاملات
- config (PerceiverConfig) — إعدادات النموذج.
مفكك التنبؤ الأساسي (بدون الانتباه المتقاطع).
PerceiverBasicDecoder
فئة transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder
< source >( config: PerceiverConfigoutput_num_channels: intposition_encoding_type: str | None = 'trainable'output_index_dims: int | None = Nonenum_channels: int | None = 128subsampled_index_dims: int | None = Noneqk_channels: int | None = Nonev_channels: int | None = Nonenum_heads: int | None = 1widening_factor: int | None = 1use_query_residual: bool | None = Falseconcat_preprocessed_input: bool | None = Falsefinal_project: bool | None = Trueposition_encoding_only: bool | None = False**position_encoding_kwargs )
المعاملات
- config ([PerceiverConfig]) — إعدادات النموذج.
- output_num_channels (
int، اختياري) — عدد القنوات في المخرجات. لن يُستخدم إلا إذا تم تعيين final_project إلىTrue. - position_encoding_type (
str، اختياري، القيمة الافتراضية هي “trainable”) — نوع ترميز الموضع المستخدم. يمكن أن يكون “trainable” أو “fourier” أو “none”. - output_index_dims (
int، اختياري) — عدد أبعاد الاستعلامات في المخرجات. يتم تجاهله إذا كان ‘position_encoding_type’ == ‘none’. - num_channels (
int، اختياري، القيمة الافتراضية 128) — عدد قنوات استعلامات المُفكِّك. يتم تجاهله إذا كانت ‘position_encoding_type’ == ‘none’. - qk_channels (
int، اختياري) — عدد قنوات الاستعلامات والمفاتيح في طبقة الانتباه المتقاطع. - v_channels (
int، اختياري) — عدد القنوات للقيم في طبقة الانتباه المتقاطع. - num_heads (
int، اختياري، القيمة الافتراضية 1) — عدد رؤوس الانتباه في طبقة الانتباه المتقاطع. - widening_factor (
int, اختياري، القيمة الافتراضية 1) — معامل توسيع طبقة الانتباه المتقاطع. - use_query_residual (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام اتصال متبقي بين الاستعلام ومخرج طبقة الانتباه المتقاطع. - concat_preprocessed_input (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب دمج المدخلات المُعالَجة مسبقًا مع الاستعلام. - final_project (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم إسقاط مخرجات طبقة الانتباه المتقاطع إلى بُعد مستهدف. - position_encoding_only (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام هذه الفئة فقط لتعريف استعلامات الإخراج.
مفكك يعتمد على الانتباه المتقاطع. يمكن استخدام هذه الفئة لفك ترميز الحالات المخفية النهائية للكائنات الكامنة باستخدام عملية انتباه متقاطع، حيث تنتج الكائنات الكامنة المفاتيح والقيم.
يعتمد شكل المخرجات لهذه الفئة على كيفية تعريف استعلامات المخرجات (المعروفة أيضاً باستعلامات المُفكِّك).
PerceiverClassificationDecoder
فئة transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder
< source >( config**decoder_kwargs )
المعاملات
- config (PerceiverConfig) — إعدادات النموذج.
مفكك تصنيف يعتمد على الانتباه المتقاطع. غلاف خفيف الوزن لـPerceiverBasicDecoder لإخراج القيم اللوغاريتمية.
يحوّل مخرج مشفر Perceiver الذي يكون على شكل (batch_size, num_latents, d_latents) إلى متجه من
الشكل (batch_size, num_labels). تكون الاستعلامات على شكل (batch_size, 1, num_labels).
PerceiverOpticalFlowDecoder
فئة transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder
< source >( configoutput_image_shapeoutput_num_channels = 2rescale_factor = 100.0**decoder_kwargs )
مفكك تدفق بصري يعتمد على الانتباه المتقاطع.
PerceiverBasicVideoAutoencodingDecoder
فئة transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder
< source >( config: PerceiverConfigoutput_shape: listposition_encoding_type: str**decoder_kwargs )
مفكّك ترميز فيديو ذاتي يعتمد على الانتباه المتقاطع. غلاف خفيف الوزن لـ [PerceiverBasicDecoder] يتضمن منطق إعادة تشكيل الفيديو.
PerceiverMultimodalDecoder
فئة transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder
< source >( config: PerceiverConfigmodalities: dictnum_outputs: intoutput_num_channels: intmin_padding_size: int | None = 2subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None**decoder_kwargs )
المعاملات
- config ([PerceiverConfig]) — إعدادات النموذج.
- modalities (
dict[str, PerceiverAbstractDecoder]) — قاموس يربط اسم النمط (modality) بفكّ الترميز (decoder) الخاص بذلك النمط. - num_outputs (
int) — عدد مخرجات المُفكِّك. - output_num_channels (
int) — عدد القنوات في المخرجات. - min_padding_size (
int، اختياري، القيمة الافتراضية 2) — أدنى حجم للتعبئة (padding) لجميع الأنماط (modalities). سيكون عدد القنوات (num_channels) في المخرجات النهائية مساوياً لأقصى عدد للقنوات عبر جميع الأنماط مضافاً إليه min_padding_size. - subsampled_index_dims (
dict[str, PerceiverAbstractDecoder]، اختياري) — قاموس يربط اسم النمط بأبعاد الفهرس المُخفَّضة التي تُستخدم لاستعلام المُفكِّك الخاص بذلك النمط.
فكّ الترميز متعدد الوسائط من خلال تركيب مفكّكات الترميز أحادية الوسائط. يُشكّل الحُجّة modalities في مُنشئ الكائن قاموساً يربط اسم كل وسائط بمُفكّك الترميز الخاص بها. يُستخدم هذا المفكّك لبناء الاستعلامات (queries) الخاصة بتلك الوسائط. تُملأ الاستعلامات الخاصة بكل وسائط بمعلمات قابلة للتدريب ومخصصة لكل وسائط، ثم تُدمج (concatenated) على طول بُعد الزمن.
بعد ذلك، توجد عملية انتباه متقاطع مشتركة عبر جميع الأنماط.
PerceiverProjectionPostprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor
< source >( in_channels: intout_channels: int )
معالجة ما بعد الإسقاط لـ Perceiver. يمكن استخدامه لإسقاط قنوات مخرج المُفكِّك إلى بُعد أدنى.
PerceiverAudioPostprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor
< source >( config: PerceiverConfigin_channels: intpostproc_type: str = 'patches' )
معالجة ما بعد الصوت لنموذج Perceiver. يمكن استخدامه لتحويل مخرجات المُفكِّك إلى ميزات صوتية.
PerceiverClassificationPostprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor
< source >( config: PerceiverConfigin_channels: int )
معالجة ما بعد التصنيف لنموذج Perceiver. يمكن استخدامه لتحويل مخرج المُفكِّك إلى قيم احتمالات التصنيف.
PerceiverMultimodalPostprocessor
فئة transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor
< source >( modalities: Mappinginput_is_dict: bool = False )
المعاملات
- modalities (
Mapping[str, PostprocessorType]) — قاموس يربط اسم النمط (modality) بفئة المعالج اللاحق (postprocessor) الخاصة بذلك النمط. - input_is_dict (
bool، اختياري، القيمة الافتراضيةFalse) — إذا كانت القيمة True، يُفترض أن المدخلات ذات بنية قاموسية، وتحتفظ المخرجات بنفس شكل القاموس. أما إذا كانت False، فإن المدخلات هي tensor يتم تقطيعه أثناء المعالجة اللاحقة بواسطة modality_sizes.
معالجة لاحقة متعددة الوسائط لـ Perceiver. يمكن استخدامه لدمج المعالجات اللاحقة الخاصة بكل نمط في معالج لاحق واحد.
PerceiverModel
فئة transformers.PerceiverModel
< source >( config: PerceiverConfigdecoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = Noneinput_preprocessor: Callable = Noneoutput_postprocessor: Callable = None )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
- decoder (
PerceiverDecoder، اختياري) — وحدة فك الترميز التي تحوّل التمثيلات الكامنة إلى تنبؤات للمهمة. - input_preprocessor (
PreprocessorType، اختياري) — معالج مسبق يشفّر المدخلات الخام إلى متجهات (تensors) للنموذج. - output_postprocessor (
PostprocessorType، اختياري) — معالج ما بعد المعالجة الذي يحوّل مخرجات النموذج إلى تنبؤات نهائية.
المُدرِك: بنية قابلة للتوسع وتعتمد بالكامل على آلية الانتباه.
لاحظ أنه من الممكن ضبط Perceiver على صور بدقة أعلى من تلك التي تم تدريبه عليها، وذلك عن طريق تعيين
interpolate_pos_encodingإلىTrueفي استدعاء forward للنموذج. سيقوم هذا بتقريب التضمينات الموضعية المُدرَّبة مسبقاً إلى الدقة الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: Tensorattention_mask: typing.Optional[torch.Tensor] = Nonesubsampled_output_points: dict[str, torch.Tensor] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Noneinterpolate_pos_encoding: bool = Falsereturn_dict: bool | None = None**kwargs ) → PerceiverModelOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- subsampled_output_points (
dict[str, torch.Tensor], اختياري) — قاموس من الموترات (tensors) يُستخدم كاستعلامات (queries) لفك الترميز. يقوم فك الترميز بربط هذه الاستعلامات بالتعبير الكامن (latent representation) للنموذج. يُستخدم في فك الترميز المُجزّأ (subsampled decoding)، على سبيل المثال عند فك ترميز بقع (patches) محددة من الصورة فقط. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
PerceiverModelOutput أو tuple(torch.Tensor)
PerceiverModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (PerceiverConfig) والمدخلات.
تتجاوز طريقة PerceiverModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
logits (
torch.Tensorمن الشكل(batch_size, num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
...     PerceiverTextPreprocessor,
...     PerceiverImagePreprocessor,
...     PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image

>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
...     config,
...     num_channels=config.d_latents,
...     trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
...     use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)

>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids

>>> with torch.no_grad():
...     outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]

>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()

>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)

>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
...     config,
...     prep_type="conv1x1",
...     spatial_downsample=1,
...     out_channels=256,
...     position_encoding_type="trainable",
...     concat_or_add_pos="concat",
...     project_pos_dim=256,
...     trainable_position_encoding_kwargs=dict(
...         num_channels=256,
...         index_dims=config.image_size**2,
...     ),
... )

>>> model = PerceiverModel(
...     config,
...     input_preprocessor=preprocessor,
...     decoder=PerceiverClassificationDecoder(
...         config,
...         num_channels=config.d_latents,
...         trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
...         use_query_residual=True,
...     ),
... )

>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values

>>> with torch.no_grad():
...     outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]

>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()

>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
PerceiverForMaskedLM
فئة transformers.PerceiverForMaskedLM
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver لنمذجة اللغة المقنّعة.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneinput_ids: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverMaskedLMOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor, اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[-100, 0, ..., config.vocab_size](انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
يعيد
PerceiverMaskedLMOutput أو tuple(torch.Tensor)
PerceiverMaskedLMOutput أو مجموعة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (PerceiverConfig) والمدخلات.
تتجاوز طريقة PerceiverForMaskedLM الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة المقنّعة (MLM).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")

>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids

>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87

>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]

>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")

>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id

>>> # forward pass
>>> with torch.no_grad():
...     outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]

>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
PerceiverForSequenceClassification
فئة transformers.PerceiverForSequenceClassification
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف النصوص.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneinput_ids: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor، اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة التصنيف/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
يعيد
PerceiverClassifierOutput أو tuple(torch.Tensor)
PerceiverClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (PerceiverConfig) والمدخلات.
تُعيد طريقة PerceiverForSequenceClassification الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")

>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
PerceiverForImageClassificationLearned
فئة transformers.PerceiverForImageClassificationLearned
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف الصور، لمهام مثل ImageNet.
يستخدم هذا النموذج تضمينات مواقع متعلَّمة. بعبارة أخرى، لا يُمنح هذا النموذج أي معلومات مميَّزة حول بنية الصور. وكما هو موضح في الورقة البحثية، يمكن لهذا النموذج تحقيق دقة من الدرجة الأولى (top-1) تبلغ 72.7 على مجموعة بيانات ImageNet.
يستخدم PerceiverForImageClassificationLearned المعالج المسبق PerceiverImagePreprocessor (مع prep_type="conv1x1") لمعالجة الصور المدخلة مسبقاً، وPerceiverClassificationDecoder لفك ترميز التمثيل الكامن لـPerceiverModel إلى قيم التصنيف (logits).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = Falsereturn_dict: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor, اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام PerceiverImageProcessor. راجع PerceiverImageProcessor.call() للتفاصيل (يستخدمprocessor_classPerceiverImageProcessor لمعالجة الصور).
يعيد
PerceiverClassifierOutput أو tuple(torch.Tensor)
PerceiverClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (PerceiverConfig) والمدخلات.
تتجاوز طريقة PerceiverForImageClassificationLearned الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")

>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
PerceiverForImageClassificationFourier
فئة transformers.PerceiverForImageClassificationFourier
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف الصور، لمهام مثل ImageNet.
يستخدم هذا النموذج تضمينات موضع ثنائية الأبعاد ثابتة من نوع فورييه. وكما هو موضح في الورقة البحثية، يمكن لهذا النموذج تحقيق دقة من الدرجة الأولى (top-1) تبلغ 79.0 على مجموعة بيانات ImageNet، و84.5 عند تدريبه مسبقاً على مجموعة بيانات واسعة النطاق (أي JFT).
يستخدم PerceiverForImageClassificationLearned المعالج المسبق PerceiverImagePreprocessor (مع prep_type="pixels") لمعالجة الصور المدخلة مسبقاً، ويستخدم PerceiverClassificationDecoder لفك الترميز التمثيلي الكامن لـ PerceiverModel إلى قيم التصنيف (logits).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor، اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام PerceiverImageProcessor. راجع PerceiverImageProcessor.call() للتفاصيل (يستخدمprocessor_classPerceiverImageProcessor لمعالجة الصور).
يعيد
PerceiverClassifierOutput أو tuple(torch.Tensor)
PerceiverClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (PerceiverConfig) والمدخلات.
تتجاوز طريقة PerceiverForImageClassificationFourier الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")

>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
PerceiverForImageClassificationConvProcessing
فئة transformers.PerceiverForImageClassificationConvProcessing
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف الصور، لمهام مثل ImageNet.
يستخدم هذا النموذج شبكة معالجة مسبقة تعتمد على التمرير ثنائي الأبعاد conv+maxpool. وكما هو موضح في الورقة البحثية، يمكن لهذا النموذج تحقيق دقة من الدرجة الأولى top-1 تبلغ 82.1 على مجموعة بيانات ImageNet.
يستخدم PerceiverForImageClassificationLearned المعالج المسبق PerceiverImagePreprocessor (مع prep_type="conv") لمعالجة الصور المدخلة مسبقاً، ويستخدم PerceiverClassificationDecoder لفك ترميز التمثيل الكامن لـ PerceiverModel إلى قيم التصنيف (logits).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor، اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام PerceiverImageProcessor. راجع PerceiverImageProcessor.call() للتفاصيل (يستخدمprocessor_classPerceiverImageProcessor لمعالجة الصور).
يعيد
PerceiverClassifierOutput أو tuple(torch.Tensor)
PerceiverClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (PerceiverConfig) والمدخلات.
تتجاوز طريقة PerceiverForImageClassificationConvProcessing الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")

>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
PerceiverForOpticalFlow
فئة transformers.PerceiverForOpticalFlow
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتدفق الضوء، لمهام مثل Sintel وKITTI. يستخدم PerceiverForOpticalFlow PerceiverImagePreprocessor (مع prep_type=“patches”) لمعالجة الصور المدخلة مسبقاً، وPerceiverOpticalFlowDecoder لفك ترميز التمثيل الكامن لـPerceiverModel.
كمدخل، يتم دمج إطارين متتاليين على طول بُعد القناة واستخراج رقعة 3 x 3 حول كل بكسل (مما يؤدي إلى 3 x 3 x 3 x 2 = 54 قيمة لكل بكسل). تُستخدم ترميزات موضع فورييه ثابتة لترميز موضع كل بكسل داخل الرقعة. بعد ذلك، يُطبَّق مُرمِّز Perceiver. ولإجراء فك الترميز، يُستعلم عن التمثيل الكامن باستخدام نفس الترميز المستخدم للمدخل.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor، اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة التدفق البصري. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
PerceiverClassifierOutput أو tuple(torch.Tensor)
PerceiverClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (PerceiverConfig) والمدخلات.
تُعيد طريقة PerceiverForOpticalFlow الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import PerceiverForOpticalFlow
>>> import torch

>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")

>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
PerceiverForMultimodalAutoencoding
فئة transformers.PerceiverForMultimodalAutoencoding
< source >( config: PerceiverConfig )
المعاملات
- config (PerceiverConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مثال على استخدام Perceiver للتشفير التلقائي متعدد الوسائط (فيديو)، لمهام مثل Kinetics-700.
يستخدم PerceiverForMultimodalAutoencoding المعالج المسبق PerceiverMultimodalPreprocessor لمعالجة الأنماط الثلاثة مسبقاً: الصور والصوت ووسوم الفئات. يستخدم هذا المعالج المسبق معالجات مسبقة مخصصة لكل نمط لمعالجة كل نمط على حدة، ثم يتم دمجها معاً. تُستخدم تضمينات المواقع القابلة للتدريب لتعبئة كل نمط إلى نفس عدد القنوات، مما يجعل الدمج على طول بُعد الزمن ممكناً. بعد ذلك، يُطبَّق مُشفِّر Perceiver.
يُستخدم PerceiverMultimodalDecoder لفك ترميز التمثيل الكامن لـ PerceiverModel. يستخدم هذا المُفكِّرم كل مُفكِّرم خاص بنوع البيانات (modality) لبناء الاستعلامات. يتم إنشاء استعلامات المُفكِّرم بناءً على المدخلات بعد المعالجة المسبقة. ومع ذلك، فإن فك ترميز فيديو كامل في مسار أمامي واحد غير ممكن من الناحية الحسابية، لذا يُستخدم جزء فقط من استعلامات المُفكِّرم لتنفيذ الانتباه المتقاطع (cross-attention) مع التمثيل الكامن. يتم تحديد ذلك بواسطة الفهارس المُخفَّضة (subsampled indices) لكل نوع بيانات، والتي يمكن تقديمها كمدخل إضافي للمسار الأمامي لـ PerceiverForMultimodalAutoencoding.
يقوم PerceiverMultimodalDecoder أيضًا بتعبئة استعلامات المُفكِّك الخاصة بالأنماط المختلفة إلى نفس عدد القنوات، وذلك من أجل دمجها على طول بُعد الزمن. ثم يتم تنفيذ الانتباه المتقاطع مع التمثيل الكامن لـ PerceiverModel.
أخيرًا، يُستخدم ~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor لتحويل هذا الموتر إلى فيديو فعلي. فهو أولًا يقسم المخرجات إلى الأنماط المختلفة، ثم يطبّق المعالج اللاحق المناسب لكل نمط.
لاحظ أنه، من خلال إخفاء تسمية التصنيف أثناء التقييم (أي ببساطة تقديم متجه من الأصفار لوضع "label")، يصبح هذا النموذج الترميزي التلقائي مصنفًا للفيديو في مجموعة بيانات Kinetics 700.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( inputs: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonesubsampled_output_points: dict[str, torch.Tensor] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs ) → PerceiverClassifierOutput or tuple(torch.Tensor)
المعاملات
- inputs (
torch.Tensor، اختياري) — المدخلات الخاصة بالمستشعر. يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- subsampled_output_points (
dict[str, torch.Tensor], اختياري) — قاموس من الموترات (tensors) يُستخدم كاستعلامات (queries) لفك الترميز. يقوم فك الترميز بربط هذه الاستعلامات بالتعبير الكامن (latent representation) للنموذج. يُستخدم في فك الترميز المُجزّأ (subsampled decoding)، على سبيل المثال عند فك ترميز بقع (patches) محددة من الصورة فقط. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
PerceiverClassifierOutput أو tuple(torch.Tensor)
PerceiverClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (PerceiverConfig) والمدخلات.
تتجاوز طريقة PerceiverForMultimodalAutoencoding الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
أمثلة:
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np

>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))

>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")

>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
...     "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
...     "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
...     "label": None,
... }

>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]

>>> list(logits["image"].shape)
[1, 6272, 3]

>>> list(logits["label"].shape)
[1, 700]