
Transformers documentation
InstructBLIP
نُشر هذا النموذج في أوراق HF في 11 مايو 2023، وأُضيف إلى مكتبة Hugging Face Transformers في 26 يونيو 2023.


InstructBLIP
نظرة عامة
قُدِّم نموذج InstructBLIP في InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning بواسطة Wenliang Dai وJunnan Li وDongxu Li وAnthony Meng Huat Tiong وJunqi Zhao وWeisheng Wang وBoyang Li وPascale Fung وSteven Hoi. يعتمد InstructBLIP على بنية BLIP-2 لضبط التعليمات البصرية.
المستخلص من الورقة البحثية هو كالتالي:
برزت نماذج لغوية عامة قادرة على حل مهام متنوعة في مجال اللغة مدفوعةً بخط أنابيب التدريب المسبق والتدريب على التعليمات. ومع ذلك، فإن بناء نماذج رؤية-لغة عامة يمثل تحدياً بسبب زيادة التباين في المهام الناجم عن إدخال مدخلات بصرية إضافية. وعلى الرغم من أن التدريب المسبق للرؤية-اللغة قد خضع لدراسة واسعة النطاق، إلا أن التدريب على التعليمات للرؤية-اللغة لا يزال أقل استكشافاً نسبياً. في هذه الورقة، نقوم بإجراء دراسة منهجية وشاملة حول التدريب على التعليمات للرؤية-اللغة بناءً على نماذج BLIP-2 المدرَّبة مسبقاً. قمنا بجمع مجموعة واسعة من 26 مجموعة بيانات متاحة للجمهور، وتحويلها إلى صيغة التدريب على التعليمات، وتصنيفها إلى مجموعتين: واحدة للتدريب على التعليمات ضمن نطاق الاختبار، والأخرى للتقييم الصفر-اللقطات خارج نطاق الاختبار. بالإضافة إلى ذلك، نطرح استخراج الميزات البصرية الواعي بالتعليمات، وهو أسلوب حاسم يمكّن النموذج من استخراج ميزات معلوماتية مصممة خصيصاً وفقاً للتعليمات المقدمة. تحقق نماذج InstructBLIP الناتجة عن ذلك من أداء صفر-اللقطات متقدم على مستوى الحالة الفنية عبر جميع مجموعات البيانات الـ 13 خارج نطاق الاختبار، متفوقةً بشكل كبير على BLIP-2 والنموذج الأكبر Flamingo. كما تقود نماذجنا إلى أداء متقدم على مستوى الحالة الفنية عند ضبطها الدقيق على مهام فرعية فردية (مثل دقة 90.7% في ScienceQA IMG). علاوة على ذلك، نوضح نوعياً مزايا InstructBLIP مقارنةً بنماذج متعددة الوسائط المتزامنة.
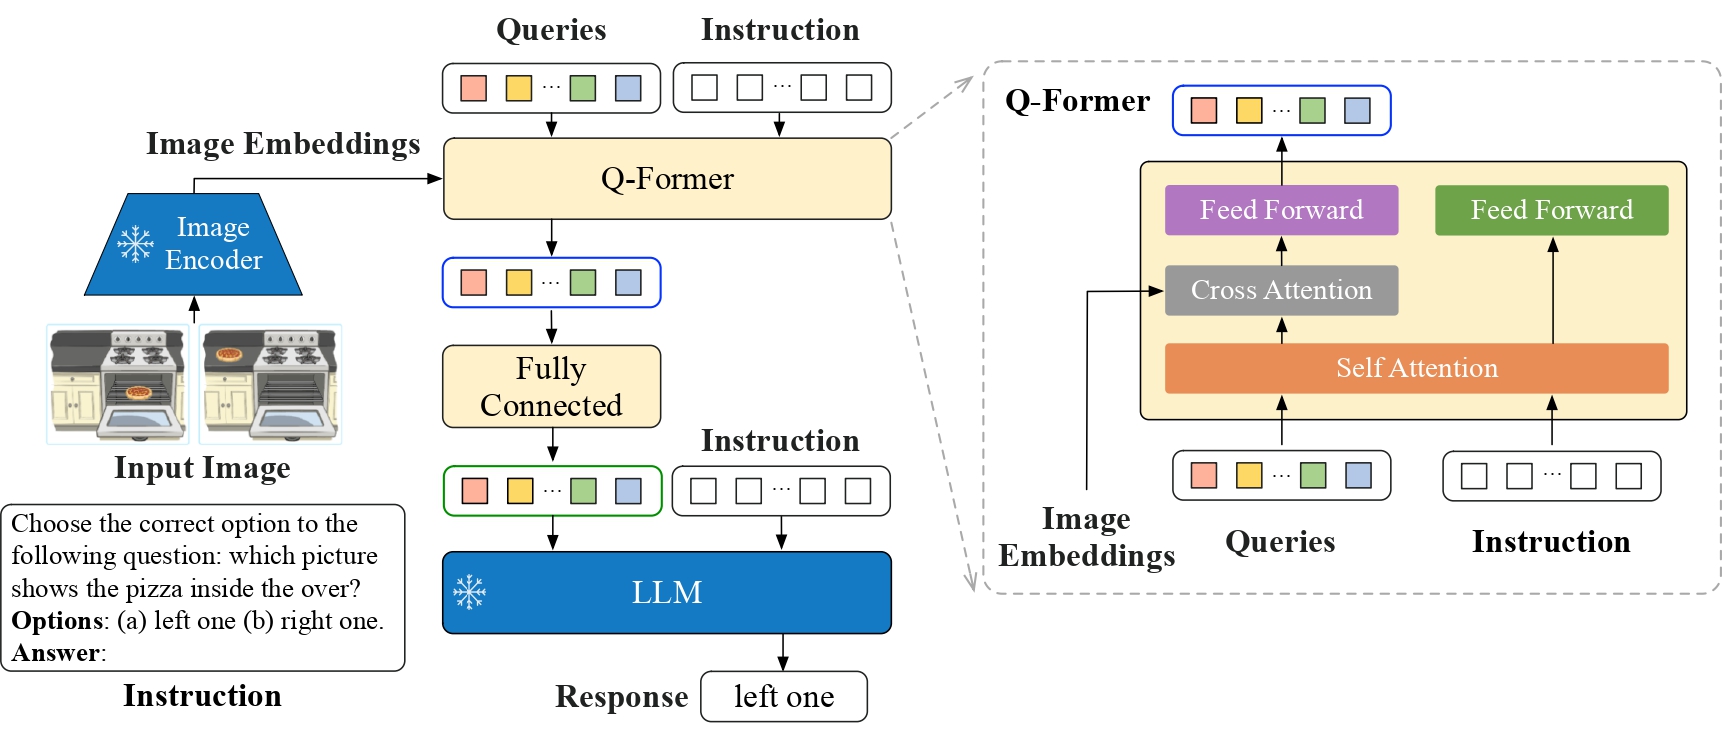 InstructBLIP architecture. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
يستخدم InstructBLIP نفس البنية المعمارية لـ BLIP-2 مع فرق صغير لكنه مهم: فهو يغذي أيضًا النص التوجيهي (التعليمات) إلى Q-Former.
ستُصدر نماذج BLIP بعد الإصدار v4.46 تحذيرات بشأن إضافة
processor.num_query_tokens = {{num_query_tokens}}وتوسيع طبقة تضمينات النموذج لإضافة رمز<image>الخاص. يُوصى بشدة بإضافة هذه السمات إلى المعالج إذا كنت تمتلك نقطة التفتيش الخاصة بالنموذج، أو فتح طلب سحب (PR) إذا لم تكن تمتلكه. تعني إضافة هذه السمات أن BLIP سيضيف عدد رموز الاستعلام المطلوبة لكل صورة، وسيوسّع النص بعدد من محددات الموقع<image>يساوي عدد رموز الاستعلام. عادةً ما يكون هذا العدد حوالي 500 رمز لكل صورة، لذا تأكد من عدم اقتطاع النص، وإلا فسيحدث فشل عند دمج التضمينات. يمكن الحصول على السمات من إعدادات النموذج، على سبيل المثالmodel.config.num_query_tokens، ويمكن تنفيذ توسيع تضمينات النموذج باتباع هذا الرابط.
InstructBlipConfig
فئة transformers.InstructBlipConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneqformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_query_tokens: int = 32image_token_index: int | None = Noneinitializer_factor: float = 1.0initializer_range: float = 0.02 )
المعاملات
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — كائن الإعدادات أو قاموس العمود الفقري البصري. - qformer_config (
dict، اختياري) — قاموس لخيارات التهيئة المستخدمة في تهيئة InstructBlipQFormerConfig. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]، اختياري) — كائن الإعدادات أو قاموس العمود الفقري النصي. - num_query_tokens (
int، اختياري، القيمة الافتراضية 32) — عدد رموز الاستعلام التي تمر عبر Transformer. - image_token_index (
int, اختياري) — مؤشر رمز الصورة المستخدم كعلامة بديلة للصور المدخلة. - initializer_factor (
float، اختياري، القيمة الافتراضية1.0) — عامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة). - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات نموذج InstructBlipModel. تُستخدم لاستحداث نموذج Instructblip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Salesforce/instructblip-flan-t5-xl
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     InstructBlipVisionConfig,
...     InstructBlipQFormerConfig,
...     OPTConfig,
...     InstructBlipConfig,
...     InstructBlipForConditionalGeneration,
... )

>>> # Initializing a InstructBlipConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipConfig()

>>> # Initializing a InstructBlipForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipForConditionalGeneration(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a InstructBlipConfig from a InstructBlipVisionConfig, InstructBlipQFormerConfig and any PreTrainedConfig

>>> # Initializing InstructBLIP vision, InstructBLIP Q-Former and language model configurations
>>> vision_config = InstructBlipVisionConfig()
>>> qformer_config = InstructBlipQFormerConfig()
>>> text_config = OPTConfig()

>>> config = InstructBlipConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
InstructBlipVisionConfig
فئة transformers.InstructBlipVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1408intermediate_size: int = 6144num_hidden_layers: int = 39num_attention_heads: int = 16image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 14hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = True )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية1408) — أبعاد التمثيلات المخفية. - intermediate_size (
int، اختياري، القيمة الافتراضية6144) — أبعاد تمثيلات MLP. - num_hidden_layers (
int، اختياري، القيمة الافتراضية39) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية14) — حجم (دقة) كل رقعة. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية1e-10) — انحراف معياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم.
هذه فئة الإعدادات المخزنة لإعدادات نموذج InstructBlipModel. تُستخدم لاستحداث نموذج Instructblip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Salesforce/instructblip-flan-t5-xl
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import InstructBlipVisionConfig, InstructBlipVisionModel

>>> # Initializing a InstructBlipVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVisionConfig()

>>> # Initializing a InstructBlipVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
InstructBlipQFormerConfig
فئة transformers.InstructBlipQFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 512initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0cross_attention_frequency: int = 2encoder_hidden_size: int = 1408 )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية30522) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - max_position_embeddings (
int، اختياري، القيمة الافتراضية512) — أقصى طول تسلسل قد يُستخدم مع هذا النموذج. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - pad_token_id (
int، اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم للتعبئة في المفردات. - cross_attention_frequency (
int، اختياري، القيمة الافتراضية 2) — تكرار إضافة الانتباه المتقاطع إلى طبقات Transformer. - encoder_hidden_size (
int, اختياري، القيمة الافتراضية 1408) — حجم الحالة المخفية لحالات الانتباه المتقاطع.
هذه فئة الإعدادات المخزنة لإعدادات نموذج InstructBlipModel. تُستخدم لاستحداث نموذج Instructblip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Salesforce/instructblip-flan-t5-xl
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import InstructBlipQFormerConfig, InstructBlipQFormerModel

>>> # Initializing a InstructBLIP Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipQFormerConfig()

>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
InstructBlipProcessor
فئة transformers.InstructBlipProcessor
< source >( image_processortokenizerqformer_tokenizernum_query_tokens = None**kwargs )
المعاملات
- image_processor (
BlipImageProcessor) — معالج الصور هو مدخل إلزامي. - tokenizer (
GPT2Tokenizer) — مُجزِّئ الرموز هو مدخل إلزامي. - qformer_tokenizer (
AutoTokenizer) — مثال من [‘PreTrainedTokenizer`]. مُجزِّئ Q-Former هو مدخل مطلوب. - num_query_tokens (
int, اختياري) — ” عدد الرموز التي يستخدمها Qformer كاستعلامات، ويجب أن يكون مطابقًا لما هو محدد في إعدادات النموذج.
ينشئ InstructBlipProcessor الذي يجمع معالج الصور ومعالج الرموز ومعالج رموز qformer في معالج واحد.
يوفر InstructBlipProcessor جميع وظائف BlipImageProcessor وGPT2Tokenizer و{qformer_tokenizer_class}. راجع ~BlipImageProcessor و~GPT2Tokenizer و~{qformer_tokenizer_class} لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] = None**kwargs: *<class 'transformers.models.instructblip.processing_instructblip.InstructBlipProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str], list[list[str]]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصاً أو قائمة من النصوص (نص مُقسَّم مسبقاً إلى رموز). إذا مرّرت مدخلاً مُقسَّماً مسبقاً إلى رموز، فعيّنis_split_into_words=Trueلتجنّب الغموض مع المدخلات المُجمَّعة في دفعات. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
InstructBlipVisionModel
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (InstructBlipProcessor يستخدم BlipImageProcessor لمعالجة الصور). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (InstructBlipConfig) والمدخلات.
تتجاوز طريقة InstructBlipVisionModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
InstructBlipQFormerModel
Querying Transformer (Q-Former)، المستخدم في InstructBLIP. تم تعديله قليلاً عن BLIP-2 لأنه يستقبل التعليمات أيضاً كمدخلات.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonequery_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPoolingAndCrossAttentions or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - query_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — حالات مخفية تُستخدم في حساب الانتباه. إذا كان الانتباه متقاطعًا، فستُستخدم للاستعلام (أي أن المفتاح والقيمة ستستخدمان encoder_hidden_states). - encoder_hidden_states (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر. تُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. - encoder_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
BaseModelOutputWithPoolingAndCrossAttentions أو tuple(torch.Tensor)
BaseModelOutputWithPoolingAndCrossAttentions أو مجموعة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (InstructBlipConfig) والمدخلات.
تتجاوز طريقة InstructBlipQFormerModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueوconfig.add_cross_attention=Trueأو عندconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.
InstructBlipModel
فئة transformers.InstructBlipModel
< source >( config: InstructBlipConfig )
المعاملات
- config (InstructBlipConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج InstructBLIP الأساسي المكوّن من نموذج لغوي ووحدة qformer ومشفّر بصري.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorqformer_input_ids: Tensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.modeling_flash_attention_utils.FlashAttentionKwargs'> ) → InstructBlipForConditionalGenerationModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (InstructBlipProcessor يستخدم BlipImageProcessor لمعالجة الصور). - qformer_input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس Q-Former. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي، والذي سيُشفّره نموذج Q-Former.يمكن الحصول على الفهارس باستخدام InstructBlipProcessor. راجع InstructBlipProcessor.call() للاطلاع على التفاصيل.
- qformer_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- decoder_attention_mask (
torch.BoolTensorبشكل(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: إنشاء متجه يتجاهل رموز الحشو فيdecoder_input_ids. سيتم استخدام قناع سببي أيضًا بشكل افتراضي.تنطبق هذه الحالة فقط عند استخدام نموذج لغة مُشفِّر-مُفكِّك (مثل T5).
- inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
InstructBlipForConditionalGenerationModelOutput أو tuple(torch.Tensor)
InstructBlipForConditionalGenerationModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (InstructBlipConfig) والمدخلات.
تتجاوز طريقة InstructBlipModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensor، اختياري، يُعاد عند تقديمlabels،torch.Tensorمن الشكل(1,)) — خسارة نمذجة اللغة من نموذج اللغة. - logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة في نموذج اللغة. - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات مُشفِّر الرؤية. - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions، اختياري) — مخرجات Q-Former (Querying Transformer). - language_model_outputs (
CausalLMOutputWithPastأوSeq2SeqLMOutput) — مخرجات نموذج اللغة.
يحصل على قناع العنصر الوهمي متعدد الوسائط من input_ids أو inputs_embeds.
InstructBlipForConditionalGeneration
فئة transformers.InstructBlipForConditionalGeneration
< source >( config: InstructBlipConfig )
المعاملات
- config (InstructBlipConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج InstructBLIP لتوليد النص بناءً على صورة وموجّه نصي اختياري. يتكوّن النموذج من مشفّر بصري، ومحوّل استعلام (Q-Former)، ونموذج لغوي.
يمكن للمرء اختيارياً تمرير input_ids إلى النموذج، حيث تعمل كموجّه نصي، لجعل نموذج اللغة يستكمل الموجّه. وإلا، يبدأ نموذج اللغة بتوليد النص من رمز [BOS] (بداية التسلسل).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorqformer_input_ids: Tensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool = Falsemm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InstructBlipForConditionalGenerationModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BlipImageProcessor. راجع BlipImageProcessor.call() للتفاصيل (InstructBlipProcessor يستخدم BlipImageProcessor لمعالجة الصور). - qformer_input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس Q-Former. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي، والذي سيُشفّره نموذج Q-Former.يمكن الحصول على الفهارس باستخدام InstructBlipProcessor. راجع InstructBlipProcessor.call() للاطلاع على التفاصيل.
- qformer_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- decoder_attention_mask (
torch.BoolTensorبشكل(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: إنشاء متجه يتجاهل رموز الحشو فيdecoder_input_ids. سيتم استخدام قناع سببي أيضًا بشكل افتراضي.تنطبق هذه الحالة فقط عند استخدام نموذج لغة مُشفِّر-مُفكِّك (مثل T5).
- inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة نمذجة اللغة. يجب أن تكون الفهارس ضمن[-100, 0, ..., config.vocab_size - 1]. يتم تجاهل (إخفاء) جميع التسميات المضبوطة على-100، ولا تُحسب الخسارة إلا للتسميات الموجودة ضمن[0, ..., config.vocab_size] - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], اختياري) — قاموس تكون مفاتيحه الأنماط المدعومة وقيمها المخرجات المُرمّزة لكل نمط. كل مخرَج مُرمَّز هو مجموعة (tuple) تتكون من (pooler_output، اختياري:last_hidden_states، اختياري:hidden_states، اختياري:attentions)pooler_outputذو الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من الميزات متعددة الوسائط للمُشفِّر المُدمجة مع تضمينات النص.
يعيد
InstructBlipForConditionalGenerationModelOutput أو tuple(torch.Tensor)
InstructBlipForConditionalGenerationModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (InstructBlipConfig) والمدخلات.
تتجاوز طريقة InstructBlipForConditionalGeneration الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensor، اختياري، يُعاد عند تقديمlabels،torch.Tensorمن الشكل(1,)) — خسارة نمذجة اللغة من نموذج اللغة. - logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة في نموذج اللغة. - vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات مُشفِّر الرؤية. - qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions، اختياري) — مخرجات Q-Former (Querying Transformer). - language_model_outputs (
CausalLMOutputWithPastأوSeq2SeqLMOutput) — مخرجات نموذج اللغة.
أمثلة:
>>> from transformers import InstructBlipProcessor, InstructBlipForConditionalGeneration
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> processor = InstructBlipProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")

>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model.to(device)
>>> url = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/lavis_confusing_pictures.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")
>>> prompt = "What is unusual about this image?"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)

>>> outputs = model.generate(
...     **inputs,
...     do_sample=False,
...     num_beams=5,
...     max_length=256,
...     min_length=1,
...     top_p=0.9,
...     repetition_penalty=1.5,
...     length_penalty=1.0,
...     temperature=1,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
The unusual aspect of this image is that a man is ironing clothes on the back of a yellow SUV, which is parked in the middle of a busy city street. This is an unconventional approach to ironing clothes, as it requires the man to balance himself and his ironing equipment on top of the vehicle while navigating through traffic. Additionally, the presence of taxis and other vehicles in the scene further emphasizes the unusual nature of this situation.
generate
< source >( pixel_values: Tensorqformer_input_ids: typing.Optional[torch.LongTensor] = Noneqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinput_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**generate_kwargs ) → captions (list)
المعاملات
- pixel_values (
torch.Tensorof shape (batch_size, num_channels, height, width)) — الصور المدخلة التي سيتم معالجتها. - qformer_input_ids (
torch.LongTensorمن الشكل (batch_size, sequence_length)، اختياري) — التسلسل المستخدم كموجّه يُغذّى إلى وحدة Q-Former. - qformer_attention_mask (
torch.LongTensorمن الشكل (batch_size, sequence_length)، اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. - input_ids (
torch.LongTensorمن الشكل (batch_size, sequence_length)، اختياري) — التسلسل المستخدم كموجّه (prompt) للتوليد. - attention_mask (
torch.LongTensorمن الشكل (batch_size, sequence_length)، اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تمثيل مضمّن للمدخلات. يجب أن يكون من نوع float وليس رموز int. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء الترميز الموضعي لتضمينات الصورة.
يعيد
التسميات (قائمة)
قائمة من السلاسل النصية بطول batch_size * num_captions.
يتجاوز دالة generate ليتمكّن من استخدام النموذج كمولّد مشروط.
get_image_features
< source >( pixel_values: Tensorqformer_input_ids: LongTensorqformer_attention_mask: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool | None = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithVisionQformerOutputs or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. - qformer_input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس Q-Former. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي، والذي سيُشفّره نموذج Q-Former.يمكن الحصول على الفهارس باستخدام InstructBlipProcessor. راجع InstructBlipProcessor.call() للاطلاع على التفاصيل.
- qformer_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithVisionQformerOutputs أو tuple(torch.Tensor)
BaseModelOutputWithVisionQformerOutputs أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (InstructBlipConfig) والمدخلات.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
vision_outputs (
~modeling_outputs.BaseModelOutputWithPooling، اختياري) — مخرجات مُشفِّر الرؤية.qformer_outputs (
~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions، اختياري) — مخرجات Q-Former (Querying Transformer).
مثال:
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipForConditionalGeneration

>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")

>>> messages = [
...     {
...         "role": "user", "content": [
...             {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Where is the cat standing?"},
...         ]
...     },
... ]

>>> inputs = processor.apply_chat_template(
...     messages,
...     tokenize=True,
...     return_dict=True,
...     return_tensors="pt",
...     add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]