
Transformers documentation
UDOP
نُشر هذا النموذج في أوراق HF في 2022-12-05 وسُهم به في Hugging Face Transformers في 2024-03-04.
UDOP
نظرة عامة
قُدِّم نموذج UDOP في Unifying Vision, Text, and Layout for Universal Document Processing من قِبل Zineng Tang وZiyi Yang وGuoxin Wang وYuwei Fang وYang Liu وChenguang Zhu وMichael Zeng وCha Zhang وMohit Bansal. يعتمد UDOP على بنية Transformer من نوع encoder-decoder مبنية على T5 لمهام ذكاء المستندات مثل تصنيف صور المستندات وتحليل المستندات والإجابة البصرية على أسئلة المستندات.
المستخلص من الورقة البحثية هو كالتالي:
نقترح نموذج الذكاء الاصطناعي التأسيسي للمعالجة الشاملة للمستندات (UDOP)، وهو نموذج يوحّد بين أنماط النص والصورة والتخطيط مع تنويع صيغ المهام، بما في ذلك فهم المستندات وتوليدها. يستفيد UDOP من الارتباط المكاني بين المحتوى النصي وصورة المستند لنمذجة أنماط الصورة والنص والتخطيط باستخدام تمثيل موحد واحد. ومن خلال محول رؤية-نص-تخطيط (Vision-Text-Layout Transformer) مبتكر، يوحّد UDOP بين ما قبل التدريب والمهام متعددة المجالات التي تليها في مخطط توليد تسلسلي قائم على التلميحات (prompts). يخضع UDOP لما قبل التدريب على كلا من مجموعات بيانات المستندات غير الموسومة واسعة النطاق باستخدام أهداف ذاتية الإشراف مبتكرة، وعلى بيانات موسومة متنوعة. كما يتعلم UDOP توليد صور المستندات من أنماط النص والتخطيط عبر إعادة بناء الصور المقنّعة (masked image reconstruction). وإلى حد علمنا، هذه هي المرة الأولى في مجال الذكاء الاصطناعي للمستندات التي يحقق فيها نموذج واحد في آنٍ واحد تحريرًا عصبيًا عالي الجودة للمستندات وتخصيصًا للمحتوى. تحقّق منهجيتنا مستوى الأداء الحالي (state-of-the-art) في 9 مهام للذكاء الاصطناعي للمستندات، مثل فهم المستندات والأسئلة والأجوبة، عبر مجالات بيانات متنوعة مثل التقارير المالية والأوراق الأكاديمية والمواقع الإلكترونية. يحتل UDOP المرتبة الأولى في لوحة الصدارة لمعيار فهم المستندات (DUE).*
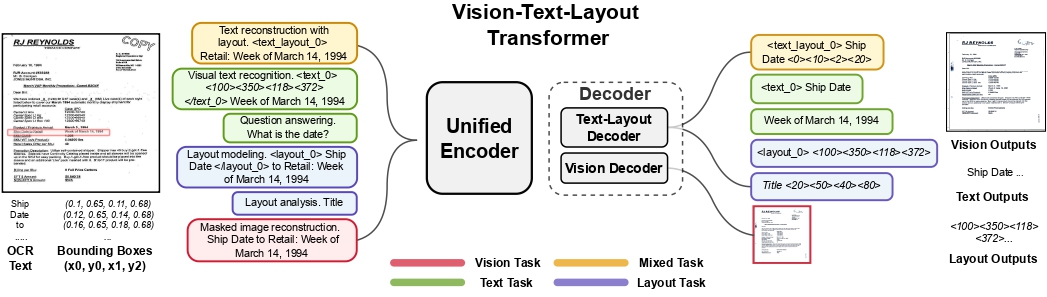 UDOP architecture. Taken from the original paper.
نصائح للاستخدام
- بالإضافة إلى input_ids، يتوقع UdopForConditionalGeneration أيضاً إدخال
bbox، وهي صناديق الحدود (أي المواضع ثنائية الأبعاد) للرموز المدخلة. يمكن الحصول عليها باستخدام محرك OCR خارجي مثل Tesseract من Google (يتوفر Python wrapper). يجب أن يكون كل صندوق حدود بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. لاحظ أنه يجب أولاً تطبيع صناديق الحدود لتكون على مقياس من 0 إلى 1000. لتطبيعها، يمكنك استخدام الدالة التالية:
def normalize_bbox(bbox, width, height):
    return [
        int(1000 * (bbox[0] / width)),
        int(1000 * (bbox[1] / height)),
        int(1000 * (bbox[2] / width)),
        int(1000 * (bbox[3] / height)),
    ]
هنا، width وheight يتوافقان مع عرض وارتفاع المستند الأصلي الذي يظهر فيه الرمز. ويمكن الحصول عليهما باستخدام مكتبة Python Image Library (PIL) على سبيل المثال، على النحو التالي:
from PIL import Image


# Document can be a png, jpg, etc. PDFs must be converted to images.
image = Image.open(name_of_your_document).convert("RGB")

width, height = image.size
يمكن استخدام UdopProcessor لتحضير الصور والنصوص للنموذج، حيث يتولى هذا الأمر بالكامل. افتراضياً، تستخدم هذه الفئة محرك Tesseract لاستخراج قائمة بالكلمات والصناديق (الإحداثيات) من مستند معيّن. وتكافئ وظيفتها وظيفة LayoutLMv3Processor، لذا فهي تدعم تمرير apply_ocr=False إذا كنت تفضّل استخدام محرك OCR خاص بك، أو apply_ocr=True إذا كنت تريد استخدام محرك OCR الافتراضي. راجع دليل استخدام LayoutLMv2 لمعرفة جميع حالات الاستخدام الممكنة (حيث أن وظيفة UdopProcessor متطابقة تماماً).
- إذا كنت تستخدم محرك OCR خاصًا بك، فإن أحد التوصيات هو Read API من Azure، والذي يدعم ما يُسمى بالمقاطع السطرية. عادةً ما يؤدي استخدام تضمينات مواقع المقاطع إلى أداء أفضل.
- عند الاستدلال، يُوصى باستخدام طريقة
generateلتوليد النص بشكل ذاتي التراجع بناءً على صورة المستند. - تم تدريب النموذج مسبقًا على كلا الهدفين: الإشرافي الذاتي والإشرافي. يمكن استخدام بادئات المهام (الموجّهات) المختلفة المستخدمة أثناء التدريب المسبق لاختبار القدرات الجاهزة للاستخدام. على سبيل المثال، يمكن توجيه النموذج بعبارة «إجابة الأسئلة. ما هو التاريخ؟»، حيث أن «إجابة الأسئلة.» هي بادئة المهمة المستخدمة أثناء التدريب المسبق لمهمة DocVQA. راجع الورقة البحثية (الجدول 1) لمعرفة جميع بادئات المهام.
- يمكن أيضًا ضبط UdopEncoderModel، وهو الجزء الخاص بالمُشفِّر فقط في UDOP، والذي يمكن اعتباره مُشفِّر Transformer مشابهًا لـ LayoutLMv3. للمهام التمييزية، يكفي إضافة مُصنِّف خطي فوقه وضبطه على مجموعة بيانات مُوسومة.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد من المجتمع (مُشار إليها بـ 🌎) لمساعدتك على البدء مع UDOP. إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب (Pull Request) وسنقوم بمراجعته! يُفضّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
- يمكن العثور على دفاتر ملاحظات توضيحية تتعلق بـ UDOP هنا، والتي تُظهر كيفية ضبط UDOP على مجموعة بيانات مخصصة بالإضافة إلى الاستدلال. 🌎
- دليل مهمة الإجابة عن الأسئلة من المستندات
UdopConfig
فئة transformers.UdopConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truevocab_size: int = 33201d_model: int = 1024d_kv: int = 64d_ff: int = 4096num_layers: int = 24num_decoder_layers: int | None = Nonenum_heads: int = 16relative_attention_num_buckets: int = 32relative_attention_max_distance: int = 128relative_bias_args: list[dict] | None = Nonedropout_rate: float | int = 0.1layer_norm_epsilon: float = 1e-06initializer_factor: float = 1.0feed_forward_proj: str = 'relu'use_cache: bool = Truepad_token_id: int | None = 0eos_token_id: int | list[int] | None = 1max_2d_position_embeddings: int = 1024image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3is_decoder: bool = Falseadd_cross_attention: bool = Falsetie_word_embeddings: bool = True )
المعاملات
- is_encoder_decoder (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا. - vocab_size (
int، اختياري، القيمة الافتراضية33201) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - d_model (
int، اختياري، القيمة الافتراضية1024) — حجم طبقات المُشفِّر وطبقة المُجمِّع. - d_kv (
int، اختياري، القيمة الافتراضية64) — حجم إسقاطات المفتاح والاستعلام والقيمة لكل رأس انتباه. سيتم تعريفinner_dimلطبقة الإسقاط على أنهnum_heads * d_kv. - d_ff (
int، اختياري، القيمة الافتراضية4096) — بعد تمثيلات MLP. - num_layers (
int، اختياري، القيمة الافتراضية24) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_decoder_layers (
int, اختياري) — عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمةnum_layersإذا لم يتم تعيينه. - num_heads (
int، اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - relative_attention_num_buckets (
int، اختياري، القيمة الافتراضية 32) — عدد الدلاء المستخدمة في كل طبقة انتباه. - relative_attention_max_distance (
int, اختياري، القيمة الافتراضية 128) — أقصى مسافة للتسلسلات الأطول لفصل الدلاء. - relative_bias_args (
list[dict]، اختياري، القيمة الافتراضية[{'type' -- '1d'}, {'type': 'horizontal'}, {'type': 'vertical'}]): قائمة من القواميس تحتوي على الحُجج الخاصة بطبقات الانحياز النسبي. - dropout_rate (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — النسبة لجميع طبقات dropout. - layer_norm_epsilon (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - initializer_factor (
float، اختياري، القيمة الافتراضية1.0) — عامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة). - feed_forward_proj (
string، اختياري، القيمة الافتراضية"relu") — نوع طبقة التغذية الأمامية المستخدمة. يجب أن تكون واحدة من"relu"أو"gated-gelu". يستخدم Udopv1.1 إسقاط التغذية الأمامية"gated-gelu". بينما يستخدم Udop الأصلي"relu". - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط. - pad_token_id (
int، اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم للتعبئة في المفردات. - eos_token_id (
Union[int, list[int]]، اختياري، القيمة الافتراضية1) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - max_2d_position_embeddings (
int، اختياري، القيمة الافتراضية 1024) — الحد الأقصى لتضمينات الموضع المطلقة لتشفير الموضع النسبي. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - is_decoder (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان النموذج يُستخدم كمفكّك (decoder) أم لا. إذا كانت القيمةFalse، يُستخدم النموذج كمُرمِّز (encoder). - add_cross_attention (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة طبقات الانتباه المتقاطع إلى النموذج. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج UdopModel. تُستخدم لاستحداث نموذج Udop وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/udop-large
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
UdopTokenizer
فئة transformers.UdopTokenizer
< source >( vocab: str | list[tuple[str, float]] | None = Noneeos_token = '</s>'sep_token = '</s>'unk_token = '<unk>'pad_token = '<pad>'sep_token_box = [1000, 1000, 1000, 1000]pad_token_box = [0, 0, 0, 0]pad_token_label = -100only_label_first_subword = Trueextra_special_tokens = None**kwargs )
المعاملات
- eos_token (
str, اختياري, الافتراضي هو"</s>") — رمز نهاية التسلسل. عند بناء تسلسل باستخدام الرموز الخاصة، لا يُستخدم هذا الرمز لنهاية التسلسل، بل يُستخدم رمز الفاصل (sep_token) لهذا الغرض.عند بناء تسلسل باستخدام الرموز الخاصة، لا يُستخدم هذا الرمز لنهاية التسلسل. الرمز المستخدم هو
sep_token. - sep_token (
str، اختياري، القيمة الافتراضية"</s>") — رمز الفاصل، الذي يُستخدم عند بناء تسلسل من عدة تسلسلات، على سبيل المثال تسلسلان لتصنيف التسلسل أو نص وسؤال للإجابة على الأسئلة. كما يُستخدم كآخر رمز في تسلسل مبني باستخدام الرموز الخاصة. - unk_token (
str، اختياري، القيمة الافتراضية"<unk>") — رمز المجهول. لا يمكن تحويل الرمز غير الموجود في المفردات إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه. - pad_token (
str، اختياري، القيمة الافتراضية"<pad>") — الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة. - sep_token_box (
list[int]، اختياري، القيمة الافتراضية[1000, 1000, 1000, 1000]) — المربع المحيط (bounding box) المستخدم للرمز الخاص [SEP]. - pad_token_box (
list[int]، اختياري، القيمة الافتراضية[0, 0, 0, 0]) — الصندوق المحيطي (bounding box) المستخدم للرمز الخاص [PAD]. - pad_token_label (
int، اختياري، القيمة الافتراضية -100) — التسمية المستخدمة لرموز الحشو. القيمة الافتراضية هي -100، وهي قيمةignore_indexفي دالة CrossEntropyLoss الخاصة بـ PyTorch. - only_label_first_subword (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم وضع التسمية على الكلمة الفرعية الأولى فقط، في حال تم توفير تسميات الكلمات. - extra_special_tokens (
list[str]، اختياري، القيمة الافتراضية["<s>NOTUSED", "</s>NOTUSED"]) — رموز خاصة إضافية يستخدمها مُجزّئ النص.
أنشئ مُجزِّئ UDOP "سريع" (مدعوم بمكتبة tokenizers من HuggingFace). مُعدَّل من LayoutXLMTokenizer وT5Tokenizer. مبني على BPE.
يرث هذا المُجزِّئ من TokenizersBackend الذي يحتوي على معظم الطرق الرئيسية. ينبغي على المستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
build_inputs_with_special_tokens
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
المعاملات
- token_ids_0 (
list[int]) — قائمة بالمعرّفات التي ستُضاف إليها الرموز الخاصة. - token_ids_1 (
list[int]، اختياري) — قائمة اختيارية ثانية من المعرّفات لأزواج التسلسلات.
يعيد
list[int]
قائمة معرفات الإدخال مع الرموز الخاصة المناسبة.
ابنِ مدخلات النموذج من تسلسل أو زوج من التسلسلات لمهام تصنيف التسلسل عن طريق الربط وإضافة الرموز الخاصة. يتبع تسلسل XLM-RoBERTa التنسيق التالي:
- تسلسل واحد:
<s> X </s> - زوج من التسلسلات:
<s> A </s></s> B </s>
get_special_tokens_mask
< source >( token_ids_0: list[int]token_ids_1: list[int] | None = Nonealready_has_special_tokens: bool = False ) → A list of integers in the range [0, 1]
المعاملات
- token_ids_0 — قائمة بالمعرّفات (IDs) للتسلسل (الذي قد يكون مُنسّقًا بالفعل).
- token_ids_1 — غير مستخدم عندما يكون
already_has_special_tokens=True. يجب أن يكون None في هذه الحالة. - already_has_special_tokens — ما إذا كانت التسلسلة منسّقة مسبقًا باستخدام الرموز الخاصة.
يعيد
قائمة من الأعداد الصحيحة في المدى [0, 1]
1 لرمز خاص، 0 لرمز التسلسل.
استرجاع معرّفات التسلسلات من قائمة الرموز التي لم تُضف إليها أي رموز خاصة.
للمُرمِّزات السريعة، تستدعي مُجمِّعات البيانات هذه الدالة مع already_has_special_tokens=True لبناء قناع فوق تسلسل مُنسَّق مسبقًا. في تلك الحالة، نحسب القناع عن طريق التحقق من العضوية في all_special_ids.
create_token_type_ids_from_sequences
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
أنشئ قناعًا من التسلسلين المُمرَّرين لاستخدامه في مهمة تصنيف أزواج التسلسلات. لا يستخدم XLM-RoBERTa معرّفات أنواع الرموز، لذلك يُعاد قائمة من الأصفار.
احفظ ملفات مفردات المُجزّئ. بالنسبة إلى TokenizersBackend، يتم حفظ الملف tokenizer.json بواسطة الفئة الأساسية. تُعيد هذه الطريقة مجموعة فارغة (tuple) لأننا نستخدم tokenizer.json فقط.
UdopProcessor
فئة transformers.UdopProcessor
< source >( image_processortokenizer )
ينشئ UdopProcessor الذي يجمع معالج الصور ومجزّئ النص في معالج واحد.
يوفر UdopProcessor جميع وظائف LayoutLMv3ImageProcessor وUdopTokenizer. راجع ~LayoutLMv3ImageProcessor و~UdopTokenizer لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] = None**kwargs: *<class 'transformers.models.udop.processing_udop.UdopProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str], list[list[str]]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصاً أو قائمة من النصوص (نص مُقسَّم مسبقاً إلى رموز). إذا مرّرت مدخلاً مُقسَّماً مسبقاً إلى رموز، فعيّنis_split_into_words=Trueلتجنّب الغموض مع المدخلات المُجمَّعة في دفعات. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
UdopModel
فئة transformers.UdopModel
< source >( config: UdopConfig )
المعاملات
- config (UdopConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Udop الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonebbox: dict[str, typing.Any] | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonevisual_bbox: dict[str, typing.Any] | None = Nonedecoder_input_ids: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- bbox (
torch.LongTensorبشكل({0}, 4), اختياري) — صناديق الحدود (Bounding boxes) لرموز كل تسلسل إدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى.لاحظ أن
sequence_length = token_sequence_length + patch_sequence_length + 1حيث يمثل1رمز [CLS]. راجعpixel_valuesللحصول علىpatch_sequence_length. - pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام LayoutLMv3ImageProcessor. راجع LayoutLMv3ImageProcessor.call() للتفاصيل (UdopProcessor يستخدم LayoutLMv3ImageProcessor لمعالجة الصور). - visual_bbox (
torch.LongTensorمن الشكل(batch_size, patch_sequence_length, 4)، اختياري) — صناديق الحدود لكل رقعة في الصورة. إذا لم يتم تقديمها، يتم إنشاء صناديق الحدود داخل النموذج. - decoder_input_ids (
torch.LongTensorof shape(batch_size, target_sequence_length), اختياري) — فهارس رموز تسلسل مدخلات المُفكِّك في قاموس النموذج. يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات مدخلات المُفكِّك؟ يستخدم T5 الرمزpad_token_idكرمز بداية لتوليدdecoder_input_ids. إذا تم استخدامpast_key_values، فيجب إدخالdecoder_input_idsالأخيرة فقط بشكل اختياري (انظرpast_key_values). لمعرفة المزيد حول كيفية إعدادdecoder_input_idsللتدريب المسبق، اطّلع على T5 Training. - decoder_attention_mask (
torch.BoolTensorof shape(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو فيdecoder_input_ids. كما سيتم استخدام قناع سببي (Causal mask) افتراضيًا. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - encoder_outputs (
torch.Tensor، اختياري) — مجموعة مرتبة تتكون من (last_hidden_state، اختياري:hidden_states، اختياري:attentions)last_hidden_stateمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من حالات المخفية عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك. - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - decoder_inputs_embeds (
torch.Tensorمن الشكل(batch_size, target_sequence_length, hidden_size), اختياري) — اختياريًا، بدلاً من تمريرdecoder_input_idsيمكنك اختيار تمرير تمثيل مضمّن مباشرة. إذاpast_key_valuesمستخدم، فاختياريًا يكفي إدخال آخرdecoder_inputs_embedsفقط (انظرpast_key_values). هذا مفيد إذا كنت تريد مزيدًا من التحكم في كيفية تحويلdecoder_input_idsفهارس إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج.إذا لم يتم تعيين كلٍّ من
decoder_input_idsوdecoder_inputs_embeds، فإنdecoder_inputs_embedsيأخذ قيمةinputs_embeds. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values).
يعيد
Seq2SeqModelOutput أو tuple(torch.Tensor)
Seq2SeqModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (UdopConfig) والمدخلات.
تُعيد طريقة UdopModel الأمامية تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من فاحم النموذج.إذا تم استخدام
past_key_values، فإن الحالة المخفية الأخيرة فقط من التسلسلات ذات الشكل(batch_size, 1, hidden_size)هي التي تُخرج.past_key_values (
EncoderDecoderCache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع EncoderDecoderCache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden-states) للوحدة الترميزية (decoder) عند مخرج كل طبقة، بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
decoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
encoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoProcessor, AutoModel
>>> from datasets import load_dataset
>>> import torch

>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = AutoModel.from_pretrained("microsoft/udop-large")

>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> inputs = processor(image, words, boxes=boxes, return_tensors="pt")

>>> decoder_input_ids = torch.tensor([[model.config.decoder_start_token_id]])

>>> # forward pass
>>> outputs = model(**inputs, decoder_input_ids=decoder_input_ids)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1, 1024]
UdopForConditionalGeneration
فئة transformers.UdopForConditionalGeneration
< source >( config: UdopConfig )
المعاملات
- config (UdopConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
ترميز-فك ترميز UDOP Transformer مع رأس نمذجة لغوية في الأعلى، مما يتيح توليد النص بناءً على صور المستندات وموجّه اختياري.
تستند هذه الفئة إلى T5ForConditionalGeneration، وقد تم توسيعها للتعامل مع البيانات المتعلقة بالصور والتخطيط (ثنائي الأبعاد).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonebbox: dict[str, typing.Any] | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonevisual_bbox: dict[str, typing.Any] | None = Nonedecoder_input_ids: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqLMOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- bbox (
torch.LongTensorبشكل({0}, 4), اختياري) — صناديق الحدود (Bounding boxes) لرموز كل تسلسل إدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى.لاحظ أن
sequence_length = token_sequence_length + patch_sequence_length + 1حيث يمثل1رمز [CLS]. راجعpixel_valuesللحصول علىpatch_sequence_length. - pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام LayoutLMv3ImageProcessor. راجع LayoutLMv3ImageProcessor.call() للتفاصيل (UdopProcessor يستخدم LayoutLMv3ImageProcessor لمعالجة الصور). - visual_bbox (
torch.LongTensorمن الشكل(batch_size, patch_sequence_length, 4)، اختياري) — صناديق الحدود لكل رقعة في الصورة. إذا لم يتم تقديمها، يتم إنشاء صناديق الحدود داخل النموذج. - decoder_input_ids (
torch.LongTensorof shape(batch_size, target_sequence_length), اختياري) — فهارس رموز تسلسل مدخلات المُفكِّك في قاموس النموذج. يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات مدخلات المُفكِّك؟ يستخدم T5 الرمزpad_token_idكرمز بداية لتوليدdecoder_input_ids. إذا تم استخدامpast_key_values، فيجب إدخالdecoder_input_idsالأخيرة فقط بشكل اختياري (انظرpast_key_values). لمعرفة المزيد حول كيفية إعدادdecoder_input_idsللتدريب المسبق، اطّلع على T5 Training. - decoder_attention_mask (
torch.BoolTensorof shape(batch_size, target_sequence_length), اختياري) — السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو فيdecoder_input_ids. كما سيتم استخدام قناع سببي (Causal mask) افتراضيًا. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - encoder_outputs (
torch.Tensor، اختياري) — مجموعة مرتبة تتكون من (last_hidden_state، اختياري:hidden_states، اختياري:attentions)last_hidden_stateمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من حالات المخفية عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك. - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - decoder_inputs_embeds (
torch.Tensorمن الشكل(batch_size, target_sequence_length, hidden_size), اختياري) — اختياريًا، بدلاً من تمريرdecoder_input_idsيمكنك اختيار تمرير تمثيل مضمّن مباشرة. إذاpast_key_valuesمستخدم، فاختياريًا يكفي إدخال آخرdecoder_inputs_embedsفقط (انظرpast_key_values). هذا مفيد إذا كنت تريد مزيدًا من التحكم في كيفية تحويلdecoder_input_idsفهارس إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج.إذا لم يتم تعيين كلٍّ من
decoder_input_idsوdecoder_inputs_embeds، فإنdecoder_inputs_embedsيأخذ قيمةinputs_embeds. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة نمذجة اللغة. يجب أن تكون الفهارس ضمن[-100, 0, ..., config.vocab_size - 1]. يتم تجاهل (إخفاء) جميع التسميات المضبوطة على-100، ولا تُحسب الخسارة إلا للتسميات ضمن[0, ..., config.vocab_size].
يعيد
Seq2SeqLMOutput أو tuple(torch.Tensor)
Seq2SeqLMOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (UdopConfig) والمدخلات.
تتجاوز طريقة UdopForConditionalGeneration الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة.logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).past_key_values (
EncoderDecoderCache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع EncoderDecoderCache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
decoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
encoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoProcessor, UdopForConditionalGeneration
>>> from datasets import load_dataset

>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopForConditionalGeneration.from_pretrained("microsoft/udop-large")

>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> # one can use the various task prefixes (prompts) used during pre-training
>>> # e.g. the task prefix for DocVQA is "Question answering. "
>>> question = "Question answering. What is the date on the form?"
>>> encoding = processor(image, question, text_pair=words, boxes=boxes, return_tensors="pt")

>>> # autoregressive generation
>>> predicted_ids = model.generate(**encoding)
>>> print(processor.batch_decode(predicted_ids, skip_special_tokens=True)[0])
9/30/92
UdopEncoderModel
فئة transformers.UdopEncoderModel
< source >( config: UdopConfig )
المعاملات
- config (UdopConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Udop الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonebbox: dict[str, typing.Any] | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Nonevisual_bbox: dict[str, typing.Any] | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithAttentionMask or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. نظرًا لأن T5 هو نموذج يستخدم تضمينات المواقع النسبية، فيمكنك ملء المدخلات من الجانبين الأيمن والأيسر.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
لمعرفة المزيد حول كيفية تحضير
input_idsللتدريب المسبق، راجع تدريب T5. - bbox (
torch.LongTensorبشكل({0}, 4), اختياري) — صناديق الحدود (Bounding boxes) لرموز كل تسلسل إدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى.لاحظ أن
sequence_length = token_sequence_length + patch_sequence_length + 1حيث يمثل1رمز [CLS]. راجعpixel_valuesللحصول علىpatch_sequence_length. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام LayoutLMv3ImageProcessor. راجع LayoutLMv3ImageProcessor.call() للتفاصيل (UdopProcessor يستخدم LayoutLMv3ImageProcessor لمعالجة الصور). - visual_bbox (
torch.LongTensorمن الشكل(batch_size, patch_sequence_length, 4)، اختياري) — صناديق الحدود لكل رقعة في الصورة. إذا لم يتم تقديمها، يتم إنشاء صناديق الحدود داخل النموذج. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
يعيد
BaseModelOutputWithAttentionMask أو tuple(torch.Tensor)
BaseModelOutputWithAttentionMask أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (UdopConfig) والمدخلات.
تتجاوز طريقة UdopEncoderModel الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من النموذج. إذا تم استخدامpast_key_values، فسيتم إخراج حالة الإخفاء الأخيرة فقط للتسلسلات من الشكل(batch_size, 1, hidden_size).attention_mask (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — قناع الانتباه المستخدم في تمريرة النموذج الأمامية لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لمخرجات الطبقات المضمنة إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) ذات الشكل(batch_size, sequence_length, hidden_size). حالات مخفية لنموذج عند مخرجات كل طبقة بالإضافة إلى مخرجات التضمين الأولية الاختيارية.attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length). أوزان الانتباه بعد تطبيق softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueوconfig.add_cross_attention=Trueأو عندconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length). أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق softmax للانتباه، المُستخدمة لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
مثال:
>>> from transformers import AutoProcessor, UdopEncoderModel
>>> from huggingface_hub import hf_hub_download
>>> from datasets import load_dataset

>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopEncoderModel.from_pretrained("microsoft/udop-large")

>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> encoding = processor(image, words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state