
Transformers documentation
TVP
نُشر هذا النموذج في أوراق HF في 2023-03-09 وسُهم به في Hugging Face Transformers في 2023-11-22.
TVP
نظرة عامة
قُدِّم إطار التلميح النصي-البصري (TVP) في ورقة Text-Visual Prompting for Efficient 2D Temporal Video Grounding التي كتبها Yimeng Zhang وXin Chen وJinghan Jia وSijia Liu وKe Ding.
المستخلص من الورقة البحثية هو كالتالي:
في هذه الورقة، ندرس مشكلة تحديد الموقع الزمني للفيديو (TVG)، والتي تهدف إلى التنبؤ بنقاط بداية/نهاية اللحظات الموصوفة بجمل نصية داخل فيديو طويل غير مقصوص. ومن خلال الاستفادة من الميزات البصرية ثلاثية الأبعاد الدقيقة، حققت تقنيات TVG تقدماً ملحوظاً في السنوات الأخيرة. ومع ذلك، فإن التعقيد العالي للشبكات العصبية التلافيفية ثلاثية الأبعاد (CNNs) يجعل استخراج الميزات البصرية ثلاثية الأبعاد الكثيفة عملية تستغرق وقتاً طويلاً، مما يتطلب موارد ذاكرة وحوسبة مكثفة. سعياً وراء TVG فعّالة، نقترح إطاراً جديداً للتلميح النصي-البصري (TVP)، الذي يدمج أنماط اضطراب مُحسّنة (نسميها «تلميحات») في كل من المدخلات البصرية والميزات النصية لنموذج TVG. وعلى النقيض الحاد من شبكات CNN ثلاثية الأبعاد، نوضح أن TVP تتيح لنا تدريب مُرمّز الرؤية ومُرمّز اللغة بشكل مشترك بفعالية في نموذج TVG ثنائي الأبعاد، وتحسين أداء دمج الميزات بين الوسائط باستخدام ميزات بصرية ثنائية الأبعاد متناثرة منخفضة التعقيد فقط. علاوة على ذلك، نقترح خسارة TD IoU (TDIoU) لتعلم TVG بكفاءة. تُظهر التجارب على مجموعتي بيانات مرجعيتين، Charades-STA وActivityNet Captions، تجريبياً أن TVP المقترحة تعزز بشكل كبير أداء TVG ثنائي الأبعاد (على سبيل المثال، تحسّن بنسبة 9.79% على Charades-STA وتحسّن بنسبة 30.77% على ActivityNet Captions) وتحقق تسريعاً في الاستدلال بمقدار 5× مقارنةً بـ TVG الذي يستخدم الميزات البصرية ثلاثية الأبعاد.
تعالج هذه الدراسة تحديد الأحداث الزمنية في الفيديو (TVG)، وهو عملية تحديد أوقات بداية ونهاية أحداث محددة في فيديو طويل، كما يصفها جملة نصية. ويُقترح التلميح النصي-البصري (TVP) لتعزيز TVG. يتضمن TVP دمج أنماط مصممة خصيصاً، تُعرف باسم «التلميحات»، في كلا مكوّني الإدخال البصري (المبني على الصور) والنصي (المبني على الكلمات) لنموذج TVG. توفر هذه التلميحات سياقاً مكانياً-زمنياً إضافياً، مما يحسّن قدرة النموذج على تحديد توقيتات الأحداث بدقة في الفيديو. يعتمد النهج مدخلات بصرية ثنائية الأبعاد بدلاً من ثلاثية الأبعاد. على الرغم من أن المدخلات ثلاثية الأبعاد توفر تفاصيل مكانية-زمنية أكثر، إلا أنها تستغرق وقتاً أطول للمعالجة. يهدف استخدام المدخلات ثنائية الأبعاد مع طريقة التلميح إلى توفير مستويات مماثلة من السياق والدقة بكفاءة أكبر.
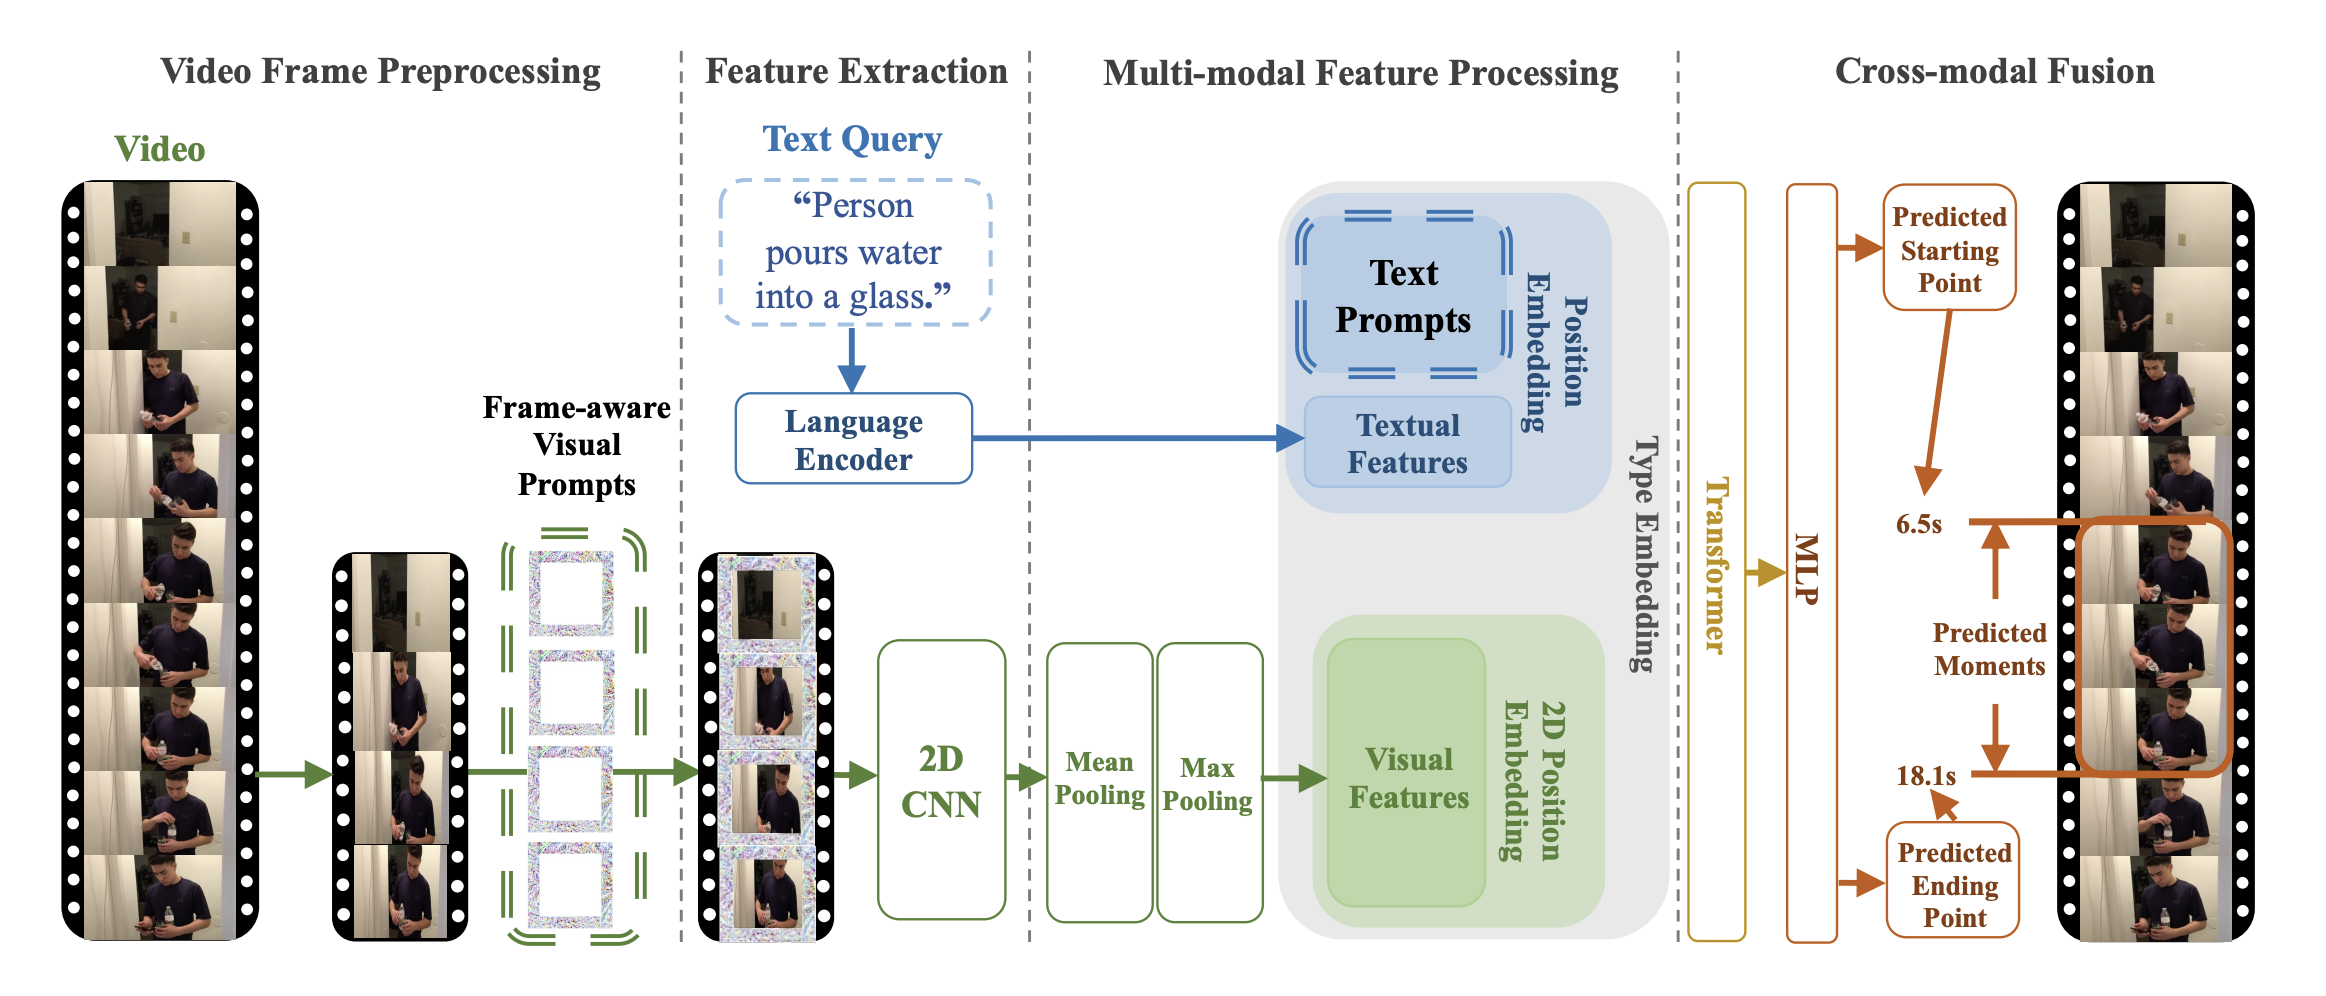 TVP architecture. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل Jiqing Feng. يمكن العثور على الكود الأصلي هنا.
نصائح وأمثلة للاستخدام
الموجّهات هي أنماط اضطراب مُحسَّنة، تُضاف إلى إطارات الفيديو المدخلة أو ميزات النص. يشير المصطلح "المجموعة الشاملة" إلى استخدام نفس مجموعة الموجّهات تمامًا لأي مدخل، مما يعني أن هذه الموجّهات تُضاف بشكل متسق إلى جميع إطارات الفيديو وميزات النص، بغض النظر عن محتوى المدخل.
يتألف TVP من مُشفِّر بصري ومُشفِّر بيني. وهو يتضمن مجموعةً عالمية من الإشارات البصرية والنصية، تُدمج في إطارات الفيديو المُستخرجة عشوائياً وفي الميزات النصية على التوالي. وبشكل خاص، تُطبَّق مجموعة من الإشارات البصرية المختلفة على الإطارات المُستخرجة بشكل منتظم من فيديو واحد غير مقصوص، وذلك بالترتيب.
يهدف هذا النموذج إلى دمج موجهات قابلة للتدريب في كل من المدخلات البصرية والميزات النصية لمشكلات تحديد الموقع الزمني في الفيديو (TVG). من حيث المبدأ، يمكن تطبيق أي مشفر بصري أو بيني متعدد الوسائط في البنية المقترحة.
يجمع TvpProcessor بين BertTokenizer وTvpImageProcessor في كائن واحد، بحيث يقوم بتشفير النص وتجهيز الصور على التوالي.
يُظهر المثال التالي كيفية تشغيل تحديد الموقع الزمني للفيديو باستخدام TvpProcessor وTvpForVideoGrounding.
import av
import cv2
import numpy as np
from huggingface_hub import hf_hub_download

from transformers import AutoProcessor, TvpForVideoGrounding


def pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
    '''
    Convert the video from its original fps to the target_fps and decode the video with PyAV decoder.
    Args:
        container (container): pyav container.
        sampling_rate (int): frame sampling rate (interval between two sampled frames).
        num_frames (int): number of frames to sample.
        clip_idx (int): if clip_idx is -1, perform random temporal sampling.
            If clip_idx is larger than -1, uniformly split the video to num_clips
            clips, and select the clip_idx-th video clip.
        num_clips (int): overall number of clips to uniformly sample from the given video.
        target_fps (int): the input video may have different fps, convert it to
            the target video fps before frame sampling.
    Returns:
        frames (tensor): decoded frames from the video. Return None if the no
            video stream was found.
        fps (float): the number of frames per second of the video.
    '''
    video = container.streams.video[0]
    fps = float(video.average_rate)
    clip_size = sampling_rate * num_frames / target_fps * fps
    delta = max(num_frames - clip_size, 0)
    start_idx = delta * clip_idx / num_clips
    end_idx = start_idx + clip_size - 1
    timebase = video.duration / num_frames
    video_start_pts = int(start_idx * timebase)
    video_end_pts = int(end_idx * timebase)
    seek_offset = max(video_start_pts - 1024, 0)
    container.seek(seek_offset, any_frame=False, backward=True, stream=video)
    frames = {}
    for frame in container.decode(video=0):
        if frame.pts < video_start_pts:
            continue
        frames[frame.pts] = frame
        if frame.pts > video_end_pts:
            break
    frames = [frames[pts] for pts in sorted(frames)]
    return frames, fps


def decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
    '''
    Decode the video and perform temporal sampling.
    Args:
        container (container): pyav container.
        sampling_rate (int): frame sampling rate (interval between two sampled frames).
        num_frames (int): number of frames to sample.
        clip_idx (int): if clip_idx is -1, perform random temporal sampling.
            If clip_idx is larger than -1, uniformly split the video to num_clips
            clips, and select the clip_idx-th video clip.
        num_clips (int): overall number of clips to uniformly sample from the given video.
        target_fps (int): the input video may have different fps, convert it to
            the target video fps before frame sampling.
    Returns:
        frames (tensor): decoded frames from the video.
    '''
    assert clip_idx >= -2, f"Not a valid clip_idx {clip_idx}"
    frames, fps = pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps)
    clip_size = sampling_rate * num_frames / target_fps * fps
    index = np.linspace(0, clip_size - 1, num_frames)
    index = np.clip(index, 0, len(frames) - 1).astype(np.int64)
    frames = np.array([frames[idx].to_rgb().to_ndarray() for idx in index])
    frames = frames.transpose(0, 3, 1, 2)
    return frames


file = hf_hub_download(repo_id="Intel/tvp_demo", filename="AK2KG.mp4", repo_type="dataset")
model = TvpForVideoGrounding.from_pretrained("Intel/tvp-base", device_map="auto")

decoder_kwargs = dict(
    container=av.open(file, metadata_errors="ignore"),
    sampling_rate=1,
    num_frames=model.config.num_frames,
    clip_idx=0,
    num_clips=1,
    target_fps=3,
)
raw_sampled_frms = decode(**decoder_kwargs)

text = "a person is sitting on a bed."
processor = AutoProcessor.from_pretrained("Intel/tvp-base")
model_inputs = processor(
    text=[text], videos=list(raw_sampled_frms), return_tensors="pt", max_text_length=100#, size=size
)

model_inputs["pixel_values"] = model_inputs["pixel_values"].to(model.dtype)
output = model(**model_inputs)

def get_video_duration(filename):
    cap = cv2.VideoCapture(filename)
    if cap.isOpened():
        rate = cap.get(5)
        frame_num = cap.get(7)
        duration = frame_num/rate
        return duration
    return -1

duration = get_video_duration(file)
start, end = processor.post_process_video_grounding(output.logits, duration)

print(f"The time slot of the video corresponding to the text \"{text}\" is from {start}s to {end}s")
نصائح:
- تستخدم هذه النسخة من TVP BertTokenizer لتوليد تمثيلات النص، ونموذج Resnet-50 لحساب التمثيلات البصرية.
- تم إصدار نقاط التفتيش للنموذج tvp-base المُدرَّب مسبقًا.
- يرجى الرجوع إلى الجدول 2 لأداء TVP في مهمة تحديد الموقع الزمني للفيديو (Temporal Video Grounding).
TvpConfig
فئة transformers.TvpConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonedistance_loss_weight: float = 1.0duration_loss_weight: float = 0.1visual_prompter_type: str = 'framepad'visual_prompter_apply: str = 'replace'visual_prompt_size: int = 96max_img_size: int = 448num_frames: int = 48vocab_size: int = 30522type_vocab_size: int = 2hidden_size: int = 768intermediate_size: int = 3072num_hidden_layers: int = 12num_attention_heads: int = 12max_position_embeddings: int = 512max_grid_col_position_embeddings: int = 100max_grid_row_position_embeddings: int = 100hidden_dropout_prob: float | int = 0.1hidden_act: str = 'gelu'layer_norm_eps: float = 1e-12initializer_range: float = 0.02attention_probs_dropout_prob: float | int = 0.1pad_token_id: int | None = None )
المعاملات
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - distance_loss_weight (
float، اختياري، القيمة الافتراضية 1.0) — وزن خسارة المسافة. - duration_loss_weight (
float، اختياري، القيمة الافتراضية 0.1) — وزن خسارة المدة. - visual_prompter_type (
str، اختياري، القيمة الافتراضية"framepad") — نوع الموجه البصري. نوع الحشو. يعني Framepad إضافة حشو لكل إطار. يجب أن يكون أحد “framepad” أو “framedownpad” - visual_prompter_apply (
str, optional, defaults to"replace") — The way of applying visual prompt. Replace means use the value of prompt to change the original value in visual inputs. Should be one of “replace”, or “add”, or “remove”. - visual_prompt_size (
int، اختياري، القيمة الافتراضية 96) — حجم الموجه البصري. - max_img_size (
int، اختياري، القيمة الافتراضية 448) — الحد الأقصى لحجم الإطار. - num_frames (
int، اختياري، القيمة الافتراضية 48) — عدد الإطارات المستخرجة من الفيديو. - vocab_size (
int، اختياري، القيمة الافتراضية30522) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - type_vocab_size (
int، اختياري، القيمة الافتراضية2) — حجم مفرداتtoken_type_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - max_position_embeddings (
int، اختياري، القيمة الافتراضية 512) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج. يُنصح عادةً بإعداد هذه القيمة إلى رقم كبير احتياطاً (مثل 512 أو 1024 أو 2048). - max_grid_col_position_embeddings (
int، اختياري، القيمة الافتراضية 100) — أقصى عدد من البقع الأفقية من إطار الفيديو. - max_grid_row_position_embeddings (
int، اختياري، القيمة الافتراضية 100) — أقصى عدد من البقع العمودية في إطار الفيديو. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - pad_token_id (
int, اختياري) — معرّف الرمز المستخدم للتعبئة في المفردات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج TvpModel. تُستخدم لاستحداث نموذج Tvp وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ Intel/tvp-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
TvpImageProcessor
فئة transformers.TvpImageProcessor
< source >( **kwargs: *<class 'transformers.models.tvp.image_processing_tvp.TvpImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'longest_edge' -- 448}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 448, 'width': 448}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ملء الصورة. يتم الملء إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الملء الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 448, 'width': 448}): الحجم بصيغة{"height": int, "width" int}الذي سيتم توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_flip_channel_order (
bool، kwargs، اختياري، القيمة الافتراضية هيself.do_flip_channel_order) — ما إذا كان يجب عكس ترتيب قنوات الصورة من RGB إلى BGR. - constant_values (
floatأو kwargs أوList[float]، اختياري، القيمة الافتراضية هيself.constant_values) — القيمة المستخدمة لملء منطقة الحشو عندما تكونpad_modeهي'constant'. - pad_mode (
str، kwargs، اختياري، القيمة الافتراضيةself.pad_mode) — وضع الحشو المستخدم —'constant'أو'edge'أو'reflect'أو'symmetric'.
ينشئ معالج صور TvpImageProcessor.
preprocess
< source >( videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]]**kwargs: *<class 'transformers.models.tvp.image_processing_tvp.TvpImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- videos (
ImageInputأوlist[ImageInput]أوlist[list[ImageInput]]) — الإطارات التي يجب معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_flip_channel_order (
bool، kwargs، اختياري، القيمة الافتراضية هيself.do_flip_channel_order) — ما إذا كان يجب عكس ترتيب قنوات الصورة من RGB إلى BGR. - constant_values (
floatأو kwargs أوList[float]، اختياري، القيمة الافتراضية هيself.constant_values) — القيمة المستخدمة لملء منطقة الحشو عندما تكونpad_modeهي'constant'. - pad_mode (
str، kwargs، اختياري، القيمة الافتراضيةself.pad_mode) — وضع الحشو المستخدم —'constant'أو'edge'أو'reflect'أو'symmetric'.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
TvpImageProcessorPil
فئة transformers.TvpImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.tvp.image_processing_pil_tvp.TvpImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'longest_edge' -- 448}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 448, 'width': 448}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ملء الصورة. يتم الملء إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الملء الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 448, 'width': 448}): الحجم بصيغة{"height": int, "width" int}الذي سيتم توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_flip_channel_order (
bool، kwargs، اختياري، القيمة الافتراضية هيself.do_flip_channel_order) — ما إذا كان يجب عكس ترتيب قنوات الصورة من RGB إلى BGR. - constant_values (
floatأو kwargs أوList[float]، اختياري، القيمة الافتراضية هيself.constant_values) — القيمة المستخدمة لملء منطقة الحشو عندما تكونpad_modeهي'constant'. - pad_mode (
str، kwargs، اختياري، القيمة الافتراضيةself.pad_mode) — وضع الحشو المستخدم —'constant'أو'edge'أو'reflect'أو'symmetric'.
ينشئ معالج صور TvpImageProcessor.
preprocess
< source >( videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]]**kwargs: *<class 'transformers.models.tvp.image_processing_pil_tvp.TvpImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- videos (
ImageInputأوlist[ImageInput]أوlist[list[ImageInput]]) — الإطارات التي يجب معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_flip_channel_order (
bool، kwargs، اختياري، القيمة الافتراضية هيself.do_flip_channel_order) — ما إذا كان يجب عكس ترتيب قنوات الصورة من RGB إلى BGR. - constant_values (
floatأو kwargs أوList[float]، اختياري، القيمة الافتراضية هيself.constant_values) — القيمة المستخدمة لملء منطقة الحشو عندما تكونpad_modeهي'constant'. - pad_mode (
str، kwargs، اختياري، القيمة الافتراضيةself.pad_mode) — وضع الحشو المستخدم —'constant'أو'edge'أو'reflect'أو'symmetric'.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
TvpProcessor
فئة transformers.TvpProcessor
< source >( image_processor = Nonetokenizer = None**kwargs )
ينشئ معالج TvpProcessor يجمع معالج الصور ومجزّئ الرموز في معالج واحد.
يوفر TvpProcessor جميع وظائف TvpImageProcessor وBertTokenizer. راجع ~TvpImageProcessor و~BertTokenizer لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = Nonevideos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = Noneaudio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.processing_utils.ProcessingKwargs'> )
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str], list[list[str]]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصاً أو قائمة من النصوص (نص مُقسَّم مسبقاً إلى رموز). إذا مرّرت مدخلاً مُقسَّماً مسبقاً إلى رموز، فعيّنis_split_into_words=Trueلتجنّب الغموض مع المدخلات المُجمَّعة في دفعات. - videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]، اختياري) — فيديو يُراد معالجته مسبقًا. يتوقع فيديو واحدًا أو دفعة من الفيديوهات بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر فيديوهات بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - audio (
Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]], اختياري) — الصوت أو مجموعة الأصوات التي سيتم تجهيزها. يمكن أن يكون كل صوت مصفوفة NumPy أو متجه PyTorch. في حالة استخدام مصفوفة NumPy أو متجه PyTorch، يجب أن يكون شكل كل صوت (C, T)، حيث C هو عدد القنوات، وT هو طول العينة للصوت. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
TvpModel
فئة transformers.TvpModel
< source >( config: TvpConfig )
المعاملات
- config (TvpConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Tvp العاري، وهو نموذج تحويلي (Transformer) يُخرج كائن BaseModelOutputWithPooling دون أي رأس (head) محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = Noneinterpolate_pos_encoding: bool = False**kwargs ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام TvpImageProcessor. راجع TvpImageProcessor.call() للتفاصيل (TvpProcessor يستخدم TvpImageProcessor لمعالجة الصور). - attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (TvpConfig) والمدخلات.
تُعيد طريقة TvpModel الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpModel

>>> model = TvpModel.from_pretrained("Jiqing/tiny-random-tvp")

>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")

>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
TvpForVideoGrounding
فئة transformers.TvpForVideoGrounding
< source >( config: TvpConfig )
المعاملات
- config (TvpConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Tvp مع رأس لفهم الفيديو في الأعلى يحسب خسارة التداخل (IoU) والمسافة والمدة.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonelabels: tuple[torch.Tensor] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = Noneinterpolate_pos_encoding: bool = False**kwargs ) → TvpVideoGroundingOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام TvpImageProcessor. راجع TvpImageProcessor.call() للتفاصيل (TvpProcessor يستخدم TvpImageProcessor لمعالجة الصور). - attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- labels (
torch.Tensorمن الشكل(batch_size, 3)، اختياري) — تحتوي التسميات على مدة الفيديو ووقت بدايته ووقت نهايته، المقابلة للنص. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
TvpVideoGroundingOutput أو tuple(torch.Tensor)
TvpVideoGroundingOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتمادًا على الإعدادات (TvpConfig) والمدخلات.
تتجاوز طريقة TvpForVideoGrounding الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عندما يكونreturn_lossهوTrue) — خسارة IoU للمسافة الزمنية لتأريض الفيديو.logits (
torch.Tensorمن الشكل(batch_size, 2)) — يحتوي على start_time/duration و end_time/duration. وهو يمثل الشريحة الزمنية للفيديوهات المقابلة لنصوص الإدخال.hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).
أمثلة:
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpForVideoGrounding

>>> model = TvpForVideoGrounding.from_pretrained("Jiqing/tiny-random-tvp")

>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")

>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)