
Transformers documentation
TAPAS
نُشر هذا النموذج في أوراق HF في 2020-04-05، وأُضيف إلى Hugging Face Transformers في 2020-12-15.
TAPAS
نظرة عامة
قُدِّم نموذج TAPAS في TAPAS: Weakly Supervised Table Parsing via Pre-training بواسطة Jonathan Herzig وPaweł Krzysztof Nowak وThomas Müller وFrancesco Piccinno وJulian Martin Eisenschlos. وهو نموذج مبني على BERT صُمِّم (وتدرب مسبقاً) خصيصاً للإجابة عن الأسئلة المتعلقة بالبيانات الجدولية. مقارنةً بـ BERT، يستخدم TAPAS تضمينات الموضع النسبي ويحتوي على 7 أنواع من الرموز (tokens) التي ترمّز البنية الجدولية. وقد خضع TAPAS للتدريب المسبق على هدف نمذجة اللغة المقنّعة (MLM) على مجموعة بيانات ضخمة تضم ملايين الجداول من ويكيبيديا الإنجليزية والنصوص المقابلة لها.
في مهام الإجابة عن الأسئلة، يحتوي TAPAS على رأسين في الأعلى: رأس لاختيار الخلايا ورأس للتجميع، لأداء عمليات التجميع (اختياريًا) (مثل العد أو الجمع) بين الخلايا المختارة. تم ضبط TAPAS على عدة مجموعات بيانات:
- SQA (الإجابة المتسلسلة على الأسئلة من مايكروسوفت)
- WTQ (أسئلة الجداول من ويكيبيديا من جامعة ستانفورد)
- WikiSQL (من تطوير Salesforce).
يحقّق أداءً متقدماً على كلٍّ من SQA وWTQ، مع أداءٍ مماثل لأفضل ما هو متاح على WikiSQL، وذلك بهيكلية أبسط بكثير.
المستخلص من الورقة البحثية هو كالتالي:
يُعدّ الإجابة على الأسئلة باللغة الطبيعية على الجداول مهمةً عادةً لتحليل دلالي. ولتخفيف تكلفة جمع الأشكال المنطقية الكاملة، يركّز نهج شائع على الإشراف الضعيف الذي يتكوّن من الدلالات بدلاً من الأشكال المنطقية. ومع ذلك، فإن تدريب محللات دلالية من الإشراف الضعيف يثير صعوبات، بالإضافة إلى أن الأشكال المنطقية المولّدة تُستخدم فقط كخطوة وسيطة قبل استرجاع الدلالة. في هذه الورقة، نقدّم TAPAS، وهو نهج للإجابة على الأسئلة على الجداول دون توليد أشكال منطقية. يتدرّب TAPAS من الإشراف الضعيف، ويتنبأ بالدلالة من خلال اختيار خلايا الجدول وتطبيق عامل تجميع مناسب على هذا الاختيار اختيارياً. يوسّع TAPAS بنية BERT لتشفير الجداول كمدخلات، ويُهيّأ من تدريب مسبق مشترك فعّال لمقاطع النص والجداول المستخرجة من ويكيبيديا، ويُدرَّب من البداية إلى النهاية. أجرينا تجارب على ثلاثة مجموعات بيانات مختلفة لتحليل دلالي، ووجدنا أن TAPAS يتفوّق على نماذج التحليل الدلالي أو يضاهيها من خلال تحسين دقة الحالة الفنية على SQA من 55.1 إلى 67.2، وأداءً مماثلاً للحالة الفنية على WIKISQL وWIKITQ، لكن ببنية نموذج أبسط. كما وجدنا أن التعلّم الانتقالي، وهو أمر بسيط في إعدادنا، من WIKISQL إلى WIKITQ، يُنتج دقة 48.7، أي أعلى من الحالة الفنية بـ 4.2 نقطة.
بالإضافة إلى ذلك، قام المؤلفون بتدريب TAPAS مسبقاً بشكل إضافي للتعرف على استلزام الجدول، وذلك من خلال إنشاء مجموعة بيانات متوازنة تتكون من ملايين أمثلة التدريب المُنشأة آلياً، والتي يتم تعلمها في خطوة وسيطة قبل الضبط الدقيق. يسمي مؤلفو TAPAS هذا التدريب المسبق الإضافي بالتدريب المسبق الوسيط (بما أن TAPAS يُدرَّب مسبقاً أولاً على MLM، ثم على مجموعة بيانات أخرى). وقد وجدوا أن التدريب المسبق الوسيط يحسّن الأداء بشكل أكبر على SQA، محققاً حداً فنياً جديداً، وكذلك حداً فنياً على TabFact، وهي مجموعة بيانات واسعة النطاق تضم 16 ألف جدول من ويكيبيديا لاستلزام الجدول (مهمة تصنيف ثنائية). لمزيد من التفاصيل، راجعوا ورقتهم اللاحقة: Understanding tables with intermediate pre-training بقلم Julian Martin Eisenschlos وSyrine Krichene وThomas Müller.
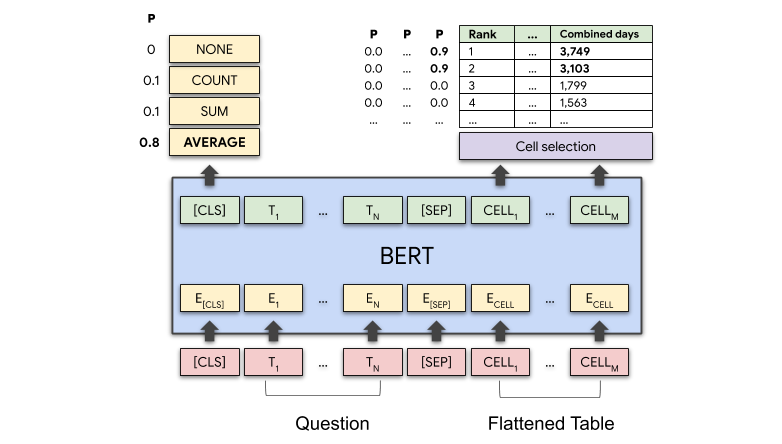 TAPAS architecture. Taken from the original blog post.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- TAPAS هو نموذج يستخدم تضمينات الموضع النسبي افتراضيًا (إعادة تعيين تضمينات الموضع عند كل خلية في الجدول). لاحظ أن هذا أمر أُضيف بعد نشر ورقة TAPAS الأصلية. وفقًا للمؤلفين، يؤدي هذا عادةً إلى أداء أفضل قليلاً، ويتيح لك ترميز تسلسلات أطول دون نفاد التضمينات. يتجلى ذلك في معامل
reset_position_index_per_cellالخاص بـ TapasConfig، والذي يُضبط علىTrueافتراضيًا. جميع النسخ الافتراضية من النماذج المتاحة على hub تستخدم تضمينات الموضع النسبي. يمكنك لا يزال استخدام تلك التي تعتمد على تضمينات الموضع المطلقة عن طريق تمرير معامل إضافيrevision="no_reset"عند استدعاء طريقةfrom_pretrained(). لاحظ أنه يُنصح عادةً بملء المدخلات على اليمين بدلاً من اليسار. - يعتمد TAPAS على BERT، لذا فإن
TAPAS-baseعلى سبيل المثال يقابل بنيةBERT-base. وبالطبع، سيحققTAPAS-largeأفضل أداء (النتائج المُبلَّغ عنها في الورقة هي منTAPAS-large). تُعرض نتائج النماذج ذات الأحجام المختلفة في مستودع GitHub الأصلي. - تحتوي TAPAS على نقاط تحقق (checkpoints) مُعدّلة على SQA، وهي قادرة على الإجابة عن الأسئلة المتعلقة بجدول في سياق محادثة. وهذا يعني أنه يمكنك طرح أسئلة متابعة مثل "ما هو عمره؟" مرتبطة بالسؤال السابق. لاحظ أن المرور الأمامي (forward pass) في TAPAS يختلف قليلاً في حالة وجود سياق محادثة: في هذه الحالة، يجب عليك إدخال كل زوج من الجدول والسؤال إلى النموذج واحدًا تلو الآخر، بحيث يمكن استبدال معرفات أنواع الرموز (token type ids) الخاصة بـ
prev_labelsبالتوقعاتlabelsالتي يولّدها النموذج للسؤال السابق. راجع قسم "الاستخدام" لمزيد من المعلومات. - يُشبه TAPAS نموذج BERT، ولذلك يعتمد على هدف نمذجة اللغة المقنّعة (MLM). ومن ثم، فهو فعّال في التنبؤ بالرموز المقنّعة وفي فهم اللغة الطبيعية (NLU) بشكل عام، لكنه ليس الأمثل لتوليد النصوص. النماذج المدرَّبة باستخدام هدف نمذجة اللغة السببية (CLM) أفضل في هذا الصدد. يُشار إلى أنه يمكن استخدام TAPAS كمُشفِّر (encoder) في إطار EncoderDecoderModel، لدمجه مع مُفكِّك نصوص ذاتي التراجع (autoregressive) مثل GPT-2.
الاستخدام: الضبط الدقيق
هنا نوضح كيفية ضبط TapasForQuestionAnswering على مجموعة البيانات الخاصة بك.
الخطوة 1: اختر إحدى الطرق الثلاث لاستخدام TAPAS - أو جرّب
في الأساس، هناك ثلاث طرق مختلفة يمكن من خلالها ضبط TapasForQuestionAnswering على نحو دقيق، تتوافق مع مجموعات البيانات المختلفة التي تم ضبط Tapas عليها:
- SQA: إذا كنت مهتمًا بطرح أسئلة متابعة مرتبطة بجدول، في سياق محادثة تفاعلية. على سبيل المثال، إذا سألت أولًا «ما اسم الممثل الأول؟»، يمكنك بعد ذلك طرح سؤال متابعة مثل «كم عمره؟». هنا، لا تتضمن الأسئلة أي عمليات تجميع (جميع الأسئلة هي أسئلة اختيار خلايا).
- WTQ: إذا لم تكن مهتمًا بطرح الأسئلة في سياق محادثة، بل بطرح أسئلة مرتبطة بجدول، وقد تتضمن عمليات تجميع، مثل عدّ عدد الصفوف، أو جمع قيم الخلايا، أو حساب متوسط قيم الخلايا. يمكنك على سبيل المثال أن تسأل: «ما هو إجمالي عدد الأهداف التي سجلها كريستيانو رونالدو خلال مسيرته؟». يُطلق على هذا الحالة أيضًا اسم الإشراف الضعيف، حيث يجب على النموذج نفسه تعليل عامل التجميع المناسب (SUM/COUNT/AVERAGE/NONE) اعتمادًا فقط على إجابة السؤال كإشراف.
- مُدارَسٌ بإشراف WikiSQL: يستند هذا المجموعة البيانات إلى WikiSQL، حيث يُمنح النموذج مُشغّل التجميع الصحيح أثناء التدريب. ويُطلق على هذا أيضاً الإشراف القوي. هنا، يكون تعلّم مُشغّل التجميع المناسب أسهل بكثير.
لخلاصة القول:
| المهمة | مجموعة بيانات مثال | الوصف |
|---|---|---|
| حواري | SQA | أسئلة اختيار الخلية فقط، محادثة |
| الإشراف الضعيف للتجميع | WTQ | قد تتضمن الأسئلة عمليات تجميع، ويتعيّن على النموذج تعلّم ذلك اعتماداً على الإجابة فقط كإشراف |
| إشراف قوي للتجميع | مُدرَّب بإشراف على WikiSQL | قد تتضمن الأسئلة عمليات تجميع، ويجب على النموذج أن يتعلم ذلك بناءً على مُشغِّل التجميع المرجعي. |
يمكن تهيئة نموذج بقاعدة مُدرَّبة مسبقًا ورؤوس تصنيف مُهيَّأة عشوائيًا من المستودع بالطريقة الموضحة أدناه.
from transformers import TapasConfig, TapasForQuestionAnswering


# for example, the base sized model with default SQA configuration
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", device_map="auto")

# or, the base sized model with WTQ configuration
config = TapasConfig.from_pretrained("google/tapas-base-finetuned-wtq")
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")

# or, the base sized model with WikiSQL configuration
config = TapasConfig("google-base-finetuned-wikisql-supervised")
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")
بالطبع، ليس من الضروري بالضرورة اتباع أحد هذه الأساليب الثلاثة التي تم بها ضبط نموذج TAPAS. يمكنك أيضًا إجراء تجارب عن طريق تحديد أي من المعلمات الفائقة التي تريدها عند تهيئة TapasConfig، ثم إنشاء TapasForQuestionAnswering بناءً على ذلك الإعداد. على سبيل المثال، إذا كان لديك مجموعة بيانات تحتوي على أسئلة محادثة وأسئلة قد تتضمن عمليات تجميع، فيمكنك القيام بذلك بهذه الطريقة. إليك مثال:
from transformers import TapasConfig, TapasForQuestionAnswering


# you can initialize the classification heads any way you want (see docs of TapasConfig)
config = TapasConfig(num_aggregation_labels=3, average_logits_per_cell=True)
# initializing the pre-trained base sized model with our custom classification heads
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")
يمكنك أيضاً البدء من نقطة تحقق (checkpoint) سبق ضبطها. تجدر الإشارة إلى أن نقطة التحقق المُضبوطة مسبقاً على WTQ تعاني من بعض المشكلات بسبب خسارة L2 التي تكون هشة إلى حد ما. راجع هنا لمزيد من المعلومات.
لقائمة بجميع نقاط التفتيش المسبقة التدريب والمُحسّنة لنموذج TAPAS المتاحة على مركز HuggingFace، راجع هنا.
الخطوة 2: جهّز بياناتك في صيغة SQA
ثانياً، بغض النظر عما اخترته أعلاه، يجب أن تستعدّ مجموعة بياناتك في صيغة SQA. هذه الصيغة هي ملف TSV/CSV يحتوي على الأعمدة التالية:
id: اختياري، معرّف زوج الجدول والسؤال، لأغراض التتبع.annotator: اختياري، معرّف الشخص الذي قام بترميز زوج الجدول والسؤال، لأغراض التوثيق.position: عدد صحيح يحدد ما إذا كانت السؤال الأول أو الثاني أو الثالث، وذلك فيما يتعلق بالجداول. لا يُطلب هذا العمود إلّا في حالة الإعداد المحادثي (SQA). لا تحتاج إلى هذا العمود إذا كنتَ تتجه نحو الإشراف على WTQ/WikiSQL.question: stringtable_file: نص، اسم ملف csv يحتوي على البيانات الجدوليةanswer_coordinates: قائمة من مجموعة واحدة أو أكثر (كل مجموعة هي إحداثي خلية، أي زوج من الصف والعمود الذي يُشكّل جزءاً من الإجابة)answer_text: قائمة من نص واحد أو أكثر (كل نص يمثل قيمة خلية تشكل جزءاً من الإجابة)aggregation_label: فهرس مُشغِّل التجميع. مطلوب فقط في حالة الإشراف القوي على التجميع (حالة الإشراف على WikiSQL)float_answer: الإجابة العشرية على السؤال، إن وُجدت (np.nan إذا لم توجد). مطلوبة فقط في حالة الإشراف الضعيف للتجميع (مثل WTQ وWikiSQL)
يجب أن تكون الجداول نفسها موجودة في مجلد، بحيث يكون كل جدول ملف csv منفصلاً. يُشار إلى أن مؤلّفي خوارزمية TAPAS استخدموا سكربتات تحويل تتضمن بعض المنطق الآلي لتحويل مجموعات البيانات الأخرى (WTQ، WikiSQL) إلى صيغة SQA. يوضّح المؤلّف ذلك هنا. ويمكن العثور على نسخة من هذا السكربت تعمل مع تطبيق HuggingFace هنا. ومن المثير للاهتمام أن سكربتات التحويل هذه ليست مثالية (حيث تُملأ حقول answer_coordinates وfloat_answer بناءً على answer_text)، مما يعني أنه يمكن في الواقع تحسين نتائج WTQ وWikiSQL.
الخطوة 3: تحويل بياناتك إلى متجهات باستخدام TapasTokenizer
ثالثًا، نظرًا إلى أنك قمت بتجهيز بياناتك في هذا التنسيق TSV/CSV (والملفات CSV المقابلة التي تحتوي على البيانات الجدولية)، يمكنك بعد ذلك استخدام TapasTokenizer لتحويل أزواج الجدول-السؤال إلى input_ids وattention_mask وtoken_type_ids وما إلى ذلك. مرة أخرى، بناءً على أي من الحالات الثلاث اخترتها أعلاه، يتطلب TapasForQuestionAnswering مدخلات مختلفة لتدريبه الدقيق:
| المهمة | المداخل المطلوبة |
|---|---|
| حواري | input_ids, attention_mask, token_type_ids, labels |
| الإشراف الضعيف للتجميع | input_ids, attention_mask, token_type_ids, labels, numeric_values, numeric_values_scale, float_answer |
| إشراف قوي للتجميع | input ids, attention mask, token type ids, labels, aggregation_labels |
ينشئ TapasTokenizer الحقول labels وnumeric_values وnumeric_values_scale بناءً على العمودين answer_coordinates وanswer_text في ملف TSV. أما float_answer وaggregation_labels فتوجد مسبقاً في ملف TSV الخاص بالخطوة 2. إليك مثالاً:
from transformers import TapasTokenizer
import pandas as pd

model_name = "google/tapas-base"
tokenizer = TapasTokenizer.from_pretrained(model_name)

data = {"Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"], "Number of movies": ["87", "53", "69"]}
queries = [
    "What is the name of the first actor?",
    "How many movies has George Clooney played in?",
    "What is the total number of movies?",
]
answer_coordinates = [[(0, 0)], [(2, 1)], [(0, 1), (1, 1), (2, 1)]]
answer_text = [["Brad Pitt"], ["69"], ["209"]]
table = pd.DataFrame.from_dict(data)
inputs = tokenizer(
    table=table,
    queries=queries,
    answer_coordinates=answer_coordinates,
    answer_text=answer_text,
    padding="max_length",
    return_tensors="pt",
)
inputs
{'input_ids': tensor([[ ]]), 'attention_mask': tensor([[...]]), 'token_type_ids': tensor([[[...]]]),
'numeric_values': tensor([[ ]]), 'numeric_values_scale: tensor([[ ]]), labels: tensor([[ ]])}
لاحظ أن TapasTokenizer يتوقع أن تكون بيانات الجدول نصية فقط. يمكنك استخدام .astype(str) على إطار البيانات (dataframe) لتحويله إلى بيانات نصية فقط.
بالطبع، هذا يوضح فقط كيفية ترميز مثال تدريب واحد. يُنصح بإنشاء محمّل بيانات (dataloader) للتكرار على الدفعات (batches):
import pandas as pd
import torch


tsv_path = "your_path_to_the_tsv_file"
table_csv_path = "your_path_to_a_directory_containing_all_csv_files"


class TableDataset(torch.utils.data.Dataset):
    def __init__(self, data, tokenizer):
        self.data = data
        self.tokenizer = tokenizer

    def __getitem__(self, idx):
        item = data.iloc[idx]
        table = pd.read_csv(table_csv_path + item.table_file).astype(
            str
        )  # be sure to make your table data text only
        encoding = self.tokenizer(
            table=table,
            queries=item.question,
            answer_coordinates=item.answer_coordinates,
            answer_text=item.answer_text,
            truncation=True,
            padding="max_length",
            return_tensors="pt",
        )
        # remove the batch dimension which the tokenizer adds by default
        encoding = {key: val.squeeze(0) for key, val in encoding.items()}
        # add the float_answer which is also required (weak supervision for aggregation case)
        encoding["float_answer"] = torch.tensor(item.float_answer)
        return encoding

    def __len__(self):
        return len(self.data)


data = pd.read_csv(tsv_path, sep="\t")
train_dataset = TableDataset(data, tokenizer)
train_dataloader = torch.utils.data.DataLoader(train_dataset, batch_size=32)
لاحظ أنه هنا، نقوم بتشفير كل زوج من الجدول والسؤال بشكل مستقل. وهذا مقبول طالما أن مجموعة البيانات الخاصة بك غير محادثة. في حال كانت مجموعة بياناتك تتضمن أسئلة محادثة (كما هو الحال في SQA)، فيجب عليك أولاً تجميع queries وanswer_coordinates وanswer_text لكل جدول (بترتيب مؤشر position) وتشفير كل جدول مع أسئلته دفعة واحدة. سيضمن ذلك ضبط أنواع الرموز prev_labels بشكل صحيح (انظر توثيق TapasTokenizer). راجع هذا الدفتر لمزيد من المعلومات.
**الخطوة 4: تدريب (ضبط) النموذج
يمكنك بعد ذلك ضبط TapasForQuestionAnswering على النحو التالي (موضح هنا لحالة الإشراف الضعيف لحالة التجميع):
from transformers import AdamW, TapasConfig, TapasForQuestionAnswering


# this is the default WTQ configuration
config = TapasConfig(
    num_aggregation_labels=4,
    use_answer_as_supervision=True,
    answer_loss_cutoff=0.664694,
    cell_selection_preference=0.207951,
    huber_loss_delta=0.121194,
    init_cell_selection_weights_to_zero=True,
    select_one_column=True,
    allow_empty_column_selection=False,
    temperature=0.0352513,
)
model = TapasForQuestionAnswering.from_pretrained("google/tapas-base", config=config, device_map="auto")

optimizer = AdamW(model.parameters(), lr=5e-5)

model.train()
for epoch in range(2):  # loop over the dataset multiple times
    for batch in train_dataloader:
        # get the inputs;
        input_ids = batch["input_ids"]
        attention_mask = batch["attention_mask"]
        token_type_ids = batch["token_type_ids"]
        labels = batch["labels"]
        numeric_values = batch["numeric_values"]
        numeric_values_scale = batch["numeric_values_scale"]
        float_answer = batch["float_answer"]

        # zero the parameter gradients
        optimizer.zero_grad()

        # forward + backward + optimize
        outputs = model(
            input_ids=input_ids,
            attention_mask=attention_mask,
            token_type_ids=token_type_ids,
            labels=labels,
            numeric_values=numeric_values,
            numeric_values_scale=numeric_values_scale,
            float_answer=float_answer,
        )
        loss = outputs.loss
        loss.backward()
        optimizer.step()
الاستخدام: الاستدلال
هنا نوضح كيفية استخدام TapasForQuestionAnswering للاستدلال (أي إجراء تنبؤات على بيانات جديدة). للاستدلال، يجب تقديم input_ids وattention_mask وtoken_type_ids (والتي يمكنك الحصول عليها باستخدام TapasTokenizer) إلى النموذج للحصول على القيم اللوجستية. بعد ذلك، يمكنك استخدام الطريقة المريحة ~models.tapas.tokenization_tapas.convert_logits_to_predictions لتحويل هذه القيم إلى إحداثيات متوقعة وفهارس تجميع اختيارية.
ومع ذلك، لاحظ أن الاستدلال مختلف اعتمادًا على ما إذا كانت البيئة محادثة أم لا. في بيئة غير محادثة، يمكن إجراء الاستدلال بالتوازي على جميع أزواج الجدول والسؤال في الدفعة. إليك مثال على ذلك:
from transformers import TapasTokenizer, TapasForQuestionAnswering
import pandas as pd

model_name = "google/tapas-base-finetuned-wtq"
model = TapasForQuestionAnswering.from_pretrained(model_name, device_map="auto")
tokenizer = TapasTokenizer.from_pretrained(model_name)

data = {"Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"], "Number of movies": ["87", "53", "69"]}
queries = [
    "What is the name of the first actor?",
    "How many movies has George Clooney played in?",
    "What is the total number of movies?",
]
table = pd.DataFrame.from_dict(data)
inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt").to(model.device)
outputs = model(**inputs)
predicted_answer_coordinates, predicted_aggregation_indices = tokenizer.convert_logits_to_predictions(
    inputs, outputs.logits.detach(), outputs.logits_aggregation.detach()
)

# let's print out the results:
id2aggregation = {0: "NONE", 1: "SUM", 2: "AVERAGE", 3: "COUNT"}
aggregation_predictions_string = [id2aggregation[x] for x in predicted_aggregation_indices]

answers = []
for coordinates in predicted_answer_coordinates:
    if len(coordinates) == 1:
        # only a single cell:
        answers.append(table.iat[coordinates[0]])
    else:
        # multiple cells
        cell_values = []
        for coordinate in coordinates:
            cell_values.append(table.iat[coordinate])
        answers.append(", ".join(cell_values))

display(table)
print("")
for query, answer, predicted_agg in zip(queries, answers, aggregation_predictions_string):
    print(query)
    if predicted_agg == "NONE":
        print("Predicted answer: " + answer)
    else:
        print("Predicted answer: " + predicted_agg + " > " + answer)
What is the name of the first actor?
Predicted answer: Brad Pitt
How many movies has George Clooney played in?
Predicted answer: COUNT > 69
What is the total number of movies?
Predicted answer: SUM > 87, 53, 69
في حالة الإعداد التفاعلي، يجب تقديم كل زوج من الجدول والسؤال إلى النموذج بشكل متسلسل، بحيث يمكن استبدال أنواع الرموز prev_labels بالرموز labels المتوقعة من زوج الجدول والسؤال السابق. مرة أخرى، يمكن العثور على مزيد من المعلومات في هذا الدفتر.
الموارد
المخرجات الخاصة بـ TAPAS
فئة transformers.models.tapas.modeling_tapas.TableQuestionAnsweringOutput
< source >( loss: typing.Optional[torch.Tensor] = Nonelogits: typing.Optional[torch.Tensor] = Nonelogits_aggregation: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = None )
المعاملات
- loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels(وإمكانًاanswer،aggregation_labels،numeric_valuesوnumeric_values_scale)) — الخسارة الإجمالية كمجموع خسارة احتمال السجل لاختيار الخلايا الهرمية و(اختياريًا) خسارة الانحدار شبه المُشرف و(اختياريًا) الخسارة المُشرفة للتجميعات. - logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — درجات التنبؤ لرأس اختيار الخلايا، لكل رمز. - logits_aggregation (
torch.Tensor، اختياري، من الشكل(batch_size, num_aggregation_labels)) — درجات التنبؤ لرأس التجميع، لكل مشغّل تجميع. - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
نوع المخرجات لـ TapasForQuestionAnswering.
TapasConfig
فئة transformers.TapasConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 1024type_vocab_sizes: list[int] | tuple[int, ...] = (3, 256, 256, 2, 256, 256, 10)initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0bos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepositive_label_weight: float = 10.0num_aggregation_labels: int = 0aggregation_loss_weight: float = 1.0use_answer_as_supervision: bool | None = Noneanswer_loss_importance: float = 1.0use_normalized_answer_loss: bool = Falsehuber_loss_delta: float | None = Nonetemperature: float = 1.0aggregation_temperature: float = 1.0use_gumbel_for_cells: bool = Falseuse_gumbel_for_aggregation: bool = Falseaverage_approximation_function: str = 'ratio'cell_selection_preference: float | None = Noneanswer_loss_cutoff: float | int | None = Nonemax_num_rows: int = 64max_num_columns: int = 32average_logits_per_cell: bool = Falseselect_one_column: bool = Trueallow_empty_column_selection: bool = Falseinit_cell_selection_weights_to_zero: bool = Falsereset_position_index_per_cell: bool = Truedisable_per_token_loss: bool = Falseaggregation_labels: dict | None = Noneno_aggregation_label_index: int | None = Noneis_decoder: bool = Falseadd_cross_attention: bool = Falsetie_word_embeddings: bool = True )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية30522) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - max_position_embeddings (
int، اختياري، القيمة الافتراضية1024) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج على الإطلاق. - type_vocab_sizes (
list[int]، اختياري، القيمة الافتراضية[3, 256, 256, 2, 256, 256, 10]) — حجم المعجم الخاص بـtoken_type_idsالمُمرَّر عند استدعاء TapasModel. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - pad_token_id (
int، اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int, اختياري) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]], اختياري) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - positive_label_weight (
float، اختياري، القيمة الافتراضية 10.0) — الوزن المخصص للتسميات الإيجابية. - num_aggregation_labels (
int، اختياري، القيمة الافتراضية 0) — عدد مشغّلات التجميع التي يجب التنبؤ بها. - aggregation_loss_weight (
float، اختياري، القيمة الافتراضية 1.0) — وزن الأهمية لخسارة التجميع. - use_answer_as_supervision (
bool, اختياري) — ما إذا كان سيتم استخدام الإجابة كإشراف وحيد لأمثلة التجميع. - answer_loss_importance (
float، اختياري، القيمة الافتراضية 1.0) — وزن الأهمية لخسارة الانحدار. - use_normalized_answer_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب تطبيع خسارة الإجابة (answer loss) باستخدام القيمة العظمى للقيمة المتوقعة والقيمة المتوقعة. - huber_loss_delta (
float, اختياري) — معامل دلتا المستخدم لحساب خسارة الانحدار. - temperature (
float، اختياري، القيمة الافتراضية 1.0) — القيمة المستخدمة للتحكم (أو تغيير) في انحراف احتمالات logits للخلايا. - aggregation_temperature (
float، اختياري، القيمة الافتراضية 1.0) — يُقيّم logits التجميع للتحكم في انحراف الاحتمالات. - use_gumbel_for_cells (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تطبيق Gumbel-Softmax على اختيار الخلايا. - use_gumbel_for_aggregation (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تطبيق Gumbel-Softmax على اختيار التجميع. - average_approximation_function (
string، اختياري، القيمة الافتراضية"ratio") — الطريقة المستخدمة لحساب المتوسط المتوقع للخلايا في حالة الإشراف الضعيف. أحد القيم:"ratio"،"first_order"أو"second_order". - cell_selection_preference (
float، اختياري) — تفضيل اختيار الخلايا في الحالات الغامضة. ينطبق فقط في حالة الإشراف الضعيف للتجميع (WTQ، WikiSQL). إذا كانت الكتلة الإجمالية لاحتمالات التجميع (باستثناء عامل “NONE”) أعلى من هذا المعامل فائق، يتم التنبؤ بالتجميع لمثال معين. - answer_loss_cutoff (
float، اختياري) — تجاهل الأمثلة التي يكون فيها خسارة الإجابة أكبر من حدّ القطع. - max_num_rows (
int، اختياري، القيمة الافتراضية 64) — الحد الأقصى لعدد الصفوف. - max_num_columns (
int، اختياري، القيمة الافتراضية 32) — الحد الأقصى لعدد الأعمدة. - average_logits_per_cell (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم حساب متوسط القيم اللوجستية (logits) لكل خلية. - select_one_column (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تقييد النموذج لاختيار الخلايا من عمود واحد فقط. - allow_empty_column_selection (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يُسمح بعدم اختيار أي عمود. - init_cell_selection_weights_to_zero (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تهيئة أوزان اختيار الخلايا إلى 0 بحيث تكون الاحتمالات الأولية 50%. - reset_position_index_per_cell (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تعيين فهارس المواقع عند كل خلية (أي استخدام تضمينات المواقع النسبية). - disable_per_token_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تعطيل أي إشراف (قوي أو ضعيف) على الخلايا. - aggregation_labels (
dict[int, label]، اختياري) — تسميات التجميع المستخدمة لتجميع النتائج. على سبيل المثال، تحتوي نماذج WTQ على تسميات تجميع كالتالي:{0: "NONE", 1: "SUM", 2: "AVERAGE", 3: "COUNT"} - no_aggregation_label_index (
int, اختياري) — إذا كانت تسميات التجميع معرّفة وكان أحد هذه التسميات يمثل "لا يوجد تجميع"، فيجب تعيينه إلى فهرس هذه التسمية. على سبيل المثال، تحتوي نماذج WTQ على تسمية التجميع "NONE" عند الفهرس 0، لذا يجب تعيين القيمة إلى 0 لهذه النماذج. - is_decoder (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان النموذج يُستخدم كمفكّك (decoder) أم لا. إذا كانت القيمةFalse، يُستخدم النموذج كمُرمِّز (encoder). - add_cross_attention (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة طبقات الانتباه المتقاطع إلى النموذج. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج TapasModel. تُستخدم لاستحداث نموذج Tapas وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيُنتج إعدادات مشابهة لتلك الخاصة بـ google/tapas-base-finetuned-sqa
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import TapasModel, TapasConfig

>>> # Initializing a default (SQA) Tapas configuration
>>> configuration = TapasConfig()
>>> # Initializing a model from the configuration
>>> model = TapasModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
TapasTokenizer
فئة transformers.TapasTokenizer
< source >( vocab_filedo_lower_case = Truedo_basic_tokenize = Truenever_split = Noneunk_token = '[UNK]'sep_token = '[SEP]'pad_token = '[PAD]'cls_token = '[CLS]'mask_token = '[MASK]'empty_token = '[EMPTY]'tokenize_chinese_chars = Truestrip_accents = Nonecell_trim_length: int = -1max_column_id: int | None = Nonemax_row_id: int | None = Nonestrip_column_names: bool = Falseupdate_answer_coordinates: bool = Falsemin_question_length = Nonemax_question_length = Nonemodel_max_length: int = 512additional_special_tokens: list[str] | None = Noneclean_up_tokenization_spaces = True**kwargs )
المعاملات
- vocab_file (
str) — ملف يحتوي على المفردات. - do_lower_case (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تحويل المدخلات إلى أحرف صغيرة عند تقسيم النص إلى رموز. - do_basic_tokenize (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تنفيذ الترميز الأساسي قبل WordPiece أم لا. - never_split (
Iterable، اختياري) — مجموعة من الرموز التي لن يتم تقسيمها أبداً أثناء عملية الترميز. لا يكون له أي تأثير إلا عندما يكونdo_basic_tokenize=True - unk_token (
str، اختياري، القيمة الافتراضية"[UNK]") — رمز المجهول. أي رمز غير موجود في المفردات لا يمكن تحويله إلى معرّف، فيتم تعيينه ليكون هذا الرمز بدلاً من ذلك. - sep_token (
str، اختياري، القيمة الافتراضية"[SEP]") — رمز الفاصل، الذي يُستخدم عند بناء تسلسل من عدة تسلسلات، على سبيل المثال تسلسلان لتصنيف التسلسل، أو نص وسؤال للإجابة على الأسئلة. كما يُستخدم كآخر رمز في تسلسل مبني باستخدام الرموز الخاصة. - pad_token (
str، اختياري، القيمة الافتراضية"[PAD]") — الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة. - cls_token (
str، اختياري، القيمة الافتراضية"[CLS]") — رمز المُصنِّف الذي يُستخدم عند إجراء تصنيف التسلسل (تصنيف التسلسل بأكمله بدلاً من التصنيف لكل رمز على حدة). وهو الرمز الأول في التسلسل عند بناؤه باستخدام الرموز الخاصة. - mask_token (
str، اختياري، القيمة الافتراضية"[MASK]") — الرمز المستخدم لإخفاء القيم. هذا هو الرمز المستخدم عند تدريب هذا النموذج باستخدام نمذجة اللغة المقنّعة. وهو الرمز الذي سيحاول النموذج التنبؤ به. - empty_token (
str، اختياري، القيمة الافتراضية"[EMPTY]") — الرمز المستخدم لقيم الخلايا الفارغة في الجدول. وتشمل قيم الخلايا الفارغة "" و"n/a" و"nan" و"؟". - tokenize_chinese_chars (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تقسيم الأحرف الصينية إلى رموز. يُرجى على الأرجح تعطيل هذا الخيار للغة اليابانية (انظر هذا المشكلة). - strip_accents (
bool، اختياري) — ما إذا كان يجب إزالة جميع الحركات أم لا. إذا لم يُحدد هذا الخيار، فسيتم تحديده بناءً على قيمةlowercase(كما في BERT الأصلي). - cell_trim_length (
int، اختياري، القيمة الافتراضية -1) — إذا كانت القيمة > 0: يتم تقليم الخلايا بحيث تكون الطول <= هذه القيمة. كما يُعطَّل تقليم الخلايا الإضافي، لذا يجب استخدامه مع ضبطtruncationعلىTrue. - max_column_id (
int, اختياري) — أقصى معرّف للعمود الذي يجب استخراجه. - max_row_id (
int، اختياري) — أقصى معرّف للصف الذي يجب استخراجه. - strip_column_names (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة نصوص فارغة بدلاً من أسماء الأعمدة. - update_answer_coordinates (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إعادة حساب إحداثيات الإجابة من نص الإجابة. - min_question_length (
int، اختياري) — الحد الأدنى لطول كل سؤال بوحدة الرموز (سيتم تخطيه في حال عدم استيفاء هذا الشرط). - max_question_length (
int، اختياري) — الحد الأقصى لطول كل سؤال بوحدة الرموز (سيتم تخطيه في حال تجاوز هذا الحد). - clean_up_tokenization_spaces (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تنظيف المسافات بعد فك الترميز، ويتضمن التنظيف إزالة أي عناصر غير مرغوب فيها مثل المسافات الزائدة.
إنشاء مُرمِّز TAPAS. مبني على WordPiece. يُمهّد جدولاً وجملة واحدة أو أكثر ذات صلة به ليتم استخدامها من قبل نماذج TAPAS.
يرث هذا المُجزِّئ من PreTrainedTokenizer الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق. ينشئ TapasTokenizer عدة معرّفات لنوع الرموز لتشفير البنية الجدولية. وللتحديد الدقيق، يضيف 7 معرّفات لنوع الرموز، بالترتيب التالي: segment_ids، column_ids، row_ids، prev_labels، column_ranks، inv_column_ranks وnumeric_relations:
- segment_ids: تُحدد ما إذا كان الرمز (token) ينتمي إلى السؤال (0) أو إلى الجدول (1). القيمة 0 للرموز الخاصة و للملء (padding).
- column_ids: تُحدد إلى أي عمود في الجدول ينتمي الرمز (تبدأ من 1). تكون قيمتها 0 لجميع رموز السؤال، والرموز الخاصة، والتعبئة.
- row_ids: تُشير إلى الصف الذي ينتمي إليه الرمز في الجدول (بدءًا من 1). تكون قيمتها 0 لجميع رموز السؤال، والرموز الخاصة، والتعبئة. كما تكون 0 لرموز رؤوس الأعمدة.
- prev_labels: تُشير إلى ما إذا كان الرمز (token) جزءًا من إجابة السؤال السابق (1) أم لا (0). مفيدة في الإعدادات الحوارية (مثل SQA).
- column_ranks: يُظهر ترتيب رمز الجدول بالنسبة إلى العمود، إن كان ذلك ممكنًا. على سبيل المثال، إذا كان لديك عمود بعنوان "عدد الأفلام" بقيم 87 و53 و69، فإن رتب الأعمدة لهذه الرموز هي 3 و1 و2 على التوالي. القيمة 0 لجميع رموز السؤال والرموز الخاصة والتعبئة.
- inv_column_ranks: تُظهر الترتيب العكسي لرمز جدول بالنسبة إلى عمود، إن كان ذلك ممكنًا. على سبيل المثال، إذا كان لديك عمود "عدد الأفلام" بقيم 87 و53 و69، فإن الترتيبات العكسية للعمود لهذه الرموز هي 1 و3 و2 على التوالي. القيمة 0 لجميع رموز الأسئلة والرموز الخاصة والتعبئة.
- numeric_relations: تُظهر العلاقات العددية بين السؤال ورموز الجدول. القيمة 0 لجميع رموز السؤال والرموز الخاصة ورموز الحشو.
يُنفّذ TapasTokenizer عملية الترميز من البداية إلى النهاية على جدول وجُمل مرتبطة به: تقسيم علامات الترقيم و.
__call__
< source >( table: typing.Union[ForwardRef('pd.DataFrame'), str, list[str], NoneType]queries: str | list[str] | list[int] | list[list[str]] | list[list[int]] | None = Noneanswer_coordinates: list[tuple] | list[list[tuple]] | None = Noneanswer_text: list[str] | list[list[str]] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | transformers.utils.generic.PaddingStrategy = Falsetruncation: bool | str | transformers.models.tapas.tokenization_tapas.TapasTruncationStrategy = Falsemax_length: int | None = Nonepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = True**kwargs )
المعاملات
- table (
pd.DataFrameأوstrأوlist[str]) — جدول يحتوي على بيانات جدولية. لاحظ أن جميع قيم الخلايا يجب أن تكون نصية. استخدم .astype(str) على إطار بيانات Pandas لتحويله إلى نص. عند تمرير نص أو قائمة من النصوص، سيتم تفسيرها كاستعلامات مع جدول فارغ (لدعم اختبارات المرمّز العام). - queries (
strأوlist[str]) — سؤال أو مجموعة من الأسئلة المتعلقة بجدول يُراد ترميزه. لاحظ أنه في حالة وجود مجموعة، يجب أن تشير جميع الأسئلة إلى نفس الجدول. - answer_coordinates (
list[Tuple]أوlist[list[Tuple]]، اختياري) — إحداثيات الإجابة لكل زوج من (الجدول، السؤال) في الدفعة. في حال تم تقديم زوج واحد فقط من (الجدول، السؤال)، يجب أن تكون answer_coordinates قائمة واحدة تحتوي على زوج واحد أو أكثر من tuples. يجب أن يكون كل tuple زوجًا من (row_index, column_index). الصف الأول للبيانات (وليس صف ترويسة الأعمدة) له فهرس 0. العمود الأول له فهرس 0. في حال تم تقديم دفعة من أزواج (الجدول، السؤال)، يجب أن تكون answer_coordinates قائمة من قوائم من tuples (حيث تتوافق كل قائمة مع زوج واحد من (الجدول، السؤال)). - answer_text (
list[str]أوlist[list[str]]، اختياري) — نص الإجابة لكل زوج من الجدول والسؤال في الدفعة. في حال تم تقديم زوج واحد فقط من الجدول والسؤال، يجب أن يكون answer_text قائمة واحدة تحتوي على نص واحد أو أكثر. يجب أن يكون كل نص هو نص الإجابة المقابل لإحداثيات الإجابة. في حال تم تقديم دفعة من أزواج الجدول والسؤال، يجب أن تكون answer_coordinates قائمة من قوائم النصوص (حيث تتوافق كل قائمة مع زوج واحد من الجدول والسؤال). - add_special_tokens (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم ترميز التسلسلات باستخدام الرموز الخاصة الخاصة بنموذجها أم لا. - padding (
bool,strأو PaddingStrategy, اختياري, الافتراضي هوFalse) — يُفعّل التحكم في الحشو. يقبل القيم التالية:Trueأو'longest': يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).'max_length': يتم ملء النص حتى الطول الأقصى المحدد عبر الحجةmax_lengthأو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.Falseأو'do_not_pad'(الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
- truncation (
bool,strأوTapasTruncationStrategy, اختياري, الافتراضي هوFalse) — يُفعّل التحكم في القص. يقبل القيم التالية:Trueأو'drop_rows_to_fit': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. يتم هذا القص صفًا بصف، مع إزالة الصفوف من الجدول.Falseأو'do_not_truncate'(الافتراضي): لا يوجد اقتطاع (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال في النموذج).
- max_length (
int, اختياري) — يتحكم في الحد الأقصى للطول الذي ستستخدمه إحدى معاملات القص/الحشو.إذا تُرك غير مُعيَّن أو عُدِّل إلى
None، فسيتم استخدام الطول الأقصى المُعرَّف مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب طولًا أقصى. وإذا لم يكن للنموذج طول إدخال أقصى محدد (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى طول أقصى. - is_split_into_words (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان المدخل مُجزَّأً مسبقاً (على سبيل المثال، مقسَّماً إلى كلمات). إذا تم ضبطه علىTrue، يفترض المُجزِّئ أن المدخل مقسَّم بالفعل إلى كلمات (على سبيل المثال، عن طريق تقسيمه على المسافات) وسيُجزِّئها. هذا مفيد لتصنيف الكيانات الاسمية أو تصنيف الرموز. - pad_to_multiple_of (
int، اختياري) — إذا تم ضبطه، سيتم توسيط التسلسل إلى مضاعف للقيمة المُقدَّمة. وهذا مفيد بشكل خاص لتفعيل استخدام نوى Tensor على أجهزة NVIDIA التي تتمتع بقابلية معالجة>= 7.5(Volta). - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات بدلاً من قائمة من الأعداد الصحيحة في Python. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن نوع Numpy.
الطريقة الرئيسية لتجزئة (tokenization) وتجهيز تسلسل واحد أو عدة تسلسلات مرتبطة بجدول للنموذج.
convert_logits_to_predictions
< source >( datalogitslogits_agg = Nonecell_classification_threshold = 0.5 ) → tuple comprising various elements depending on the inputs
المعاملات
- data (
dict) — قاموس يربط الميزات بقيمها الفعلية. يجب إنشاؤه باستخدام TapasTokenizer. - logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — مصفوفة تحتوي على قيم logits على مستوى الرموز. - logits_agg (
torch.Tensorمن الشكل(batch_size, num_aggregation_labels)، اختياري) — مصفوفة تحتوي على قيم التجميع (aggregation logits). - cell_classification_threshold (
float, اختياري، القيمة الافتراضية 0.5) — العتبة المستخدمة لاختيار الخلايا. سيتم اختيار جميع خلايا الجدول التي تكون احتمالاتها أكبر من هذه العتبة.
يعيد
tuple تتألف من عناصر مختلفة اعتماداً على المدخلات
- predicted_answer_coordinates (
list[list[[tuple]]of lengthbatch_size): إحداثيات الإجابة المتوقعة على شكل قائمة من قوائم من_tuples. يحتوي كل عنصر في القائمة على إحداثيات الإجابة المتوقعة لمثال واحد في الدفعة، على شكل قائمة من_tuples. كل tuple هو خلية، أي (مؤشر الصف، مؤشر العمود). - predicted_aggregation_indices (
list[int]بطولbatch_size، اختياري، يُعاد عند توفيرlogits_aggregation): فهارس مشغّل التجميع المتوقعة لرأس التجميع.
يحوّل القيم الخام (logits) الخاصة بـ TapasForQuestionAnswering إلى إحداثيات الإجابة المتوقعة الفعلية، بالإضافة إلى فهارس التجميع الاختيارية.
يمكن العثور على التنفيذ الأصلي، الذي تستند إليه هذه الدالة، هنا.
TapasModel
فئة transformers.TapasModel
< source >( config: TapasConfigadd_pooling_layer = True )
المعاملات
- config (TapasConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
- add_pooling_layer (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة طبقة تجميع
نموذج Tapas الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length, 7), اختياري) — مؤشرات رموز ترمّز البنية الجدولية. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع هذا الفصل لمزيد من المعلومات. - position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في ترميزات المواضع. إذا كانreset_position_index_per_cellفي TapasConfig مضبطًا علىTrue, فسيتم استخدام ترميزات المواضع النسبية. يتم اختيارها من النطاق[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - encoder_hidden_states (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر. تُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. - encoder_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (TapasConfig) والمدخلات.
تتجاوز طريقة TapasModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, TapasModel
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base")
>>> model = TapasModel.from_pretrained("google/tapas-base")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)
>>> queries = ["How many movies has George Clooney played in?", "How old is Brad Pitt?"]

>>> inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt")
>>> outputs = model(**inputs)

>>> last_hidden_states = outputs.last_hidden_state
TapasForMaskedLM
class transformers.TapasForMaskedLM
< source >( config: TapasConfig )
المعاملات
- config (TapasConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Tapas مع رأس language modeling في الأعلى.”
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskedLMOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length, 7), اختياري) — مؤشرات رموز ترمّز البنية الجدولية. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع هذا الفصل لمزيد من المعلومات. - position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. إذا كانreset_position_index_per_cellفي TapasConfig مضبطًا علىTrue, فسيتم استخدام تضمينات المواضع النسبية. يتم اختيارها من النطاق[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - encoder_hidden_states (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر. تُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. - encoder_attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[-100, 0, ..., config.vocab_size](انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MaskedLMOutput أو tuple(torch.Tensor)
MaskedLMOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (TapasConfig) والمدخلات.
تتجاوز طريقة TapasForMaskedLM الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة المقنّعة (MLM).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, TapasForMaskedLM
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base")
>>> model = TapasForMaskedLM.from_pretrained("google/tapas-base")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)

>>> inputs = tokenizer(
...     table=table, queries="How many [MASK] has George [MASK] played in?", return_tensors="pt"
... )
>>> labels = tokenizer(
...     table=table, queries="How many movies has George Clooney played in?", return_tensors="pt"
... )["input_ids"]

>>> outputs = model(**inputs, labels=labels)
>>> logits = outputs.logits
TapasForSequenceClassification
فئة transformers.TapasForSequenceClassification
< source >( config: TapasConfig )
المعاملات
- config (TapasConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Tapas مع رأس تصنيف تسلسل في الأعلى (طبقة خطية فوق المخرجات المجمّعة)، على سبيل المثال لمهام الاستلزام على الجداول، مثل TabFact (Chen et al., 2020).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → SequenceClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length, 7), اختياري) — مؤشرات رموز ترمّز البنية الجدولية. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع هذا الفصل لمزيد من المعلومات. - position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في ترميزات المواضع. إذا كانreset_position_index_per_cellفي TapasConfig مضبطًا علىTrue, فسيتم استخدام ترميزات المواضع النسبية. يتم اختيارها من النطاق[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/الانحدار التسلسلي. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). ملاحظة: يُطلق عليها اسم “classification_class_index” في التنفيذ الأصلي. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
SequenceClassifierOutput أو tuple(torch.Tensor)
SequenceClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (TapasConfig) والمدخلات.
تُعيد طريقة TapasForSequenceClassification الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, TapasForSequenceClassification
>>> import torch
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base-finetuned-tabfact")
>>> model = TapasForSequenceClassification.from_pretrained("google/tapas-base-finetuned-tabfact")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)
>>> queries = [
...     "There is only one actor who is 45 years old",
...     "There are 3 actors which played in more than 60 movies",
... ]

>>> inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt")
>>> labels = torch.tensor([1, 0])  # 1 means entailed, 0 means refuted

>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> logits = outputs.logits
TapasForQuestionAnswering
فئة transformers.TapasForQuestionAnswering
< source >( config: TapasConfig )
المعاملات
- config (TapasConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Tapas مع رأس لاختيار الخلايا ورأس اختياري للتجميع في الأعلى، مخصص لمهام الإجابة عن الأسئلة على الجداول (طبقات خطية فوق مخرجات الحالات المخفية لحساب logits وlogits_aggregation الاختياري)، مثل مهام SQA وWTQ أو المهام المُشرفة عليها بواسطة WikiSQL.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonetable_mask: typing.Optional[torch.LongTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneaggregation_labels: typing.Optional[torch.LongTensor] = Nonefloat_answer: typing.Optional[torch.Tensor] = Nonenumeric_values: typing.Optional[torch.Tensor] = Nonenumeric_values_scale: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TableQuestionAnsweringOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length, 7), اختياري) — مؤشرات رموز ترمّز البنية الجدولية. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع هذا الفصل لمزيد من المعلومات. - position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في ترميزات المواضع. إذا كانreset_position_index_per_cellفي TapasConfig مضبطًا علىTrue, فسيتم استخدام ترميزات المواضع النسبية. يتم اختيارها من النطاق[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - table_mask (
torch.LongTensorمن الشكل(batch_size, seq_length)، اختياري) — قناع للجدول. يُظهر أي الرموز تنتمي إلى الجدول (1). رموز الأسئلة، رؤوس الجدول، والتعبئة هي 0. - labels (
torch.LongTensorبشكل(batch_size, seq_length), اختياري) — تسميات لكل رمز لحساب خسارة اختيار الخلايا الهرمي. يرمّز هذا المواضع التي تظهر فيها الإجابة في الجدول. يمكن الحصول عليها باستخدام AutoTokenizer.- 1 للرموز التي تُشكّل جزءاً من الإجابة،
- 0 للرموز التي ليست جزءًا من الإجابة.
- aggregation_labels (
torch.LongTensorمن الشكل(batch_size, )، اختياري) — مؤشر دالة التجميع لكل مثال في الدفعة لحساب خسارة التجميع. يجب أن تكون الفهارس ضمن[0, ..., config.num_aggregation_labels - 1]. مطلوب فقط في حالة الإشراف القوي على التجميع (WikiSQL-supervised). - float_answer (
torch.Tensorof shape(batch_size, ), اختياري) — إجابة رقمية لكل مثال في الدفعة. اضبطها على float(‘nan’) لأسئلة اختيار الخلايا. مطلوبة فقط في حالة الإشراف الضعيف (WTQ) لحساب قناع التجميع وخسارة الانحدار. - numeric_values (
torch.Tensorمن الشكل(batch_size, seq_length)، اختياري) — القيم الرقمية لكل رمز، وقيمة NaN للرموز التي ليست قيمًا رقمية. يمكن الحصول عليها باستخدام AutoTokenizer. لا يُطلب هذا المعامل إلا في حالة الإشراف الضعيف للتجميع (WTQ) لحساب فقد الانحدار. - numeric_values_scale (
torch.Tensorمن الشكل(batch_size, seq_length)، اختياري) — مقياس القيم الرقمية لكل رمز. يمكن الحصول عليه باستخدام AutoTokenizer. مطلوب فقط في حالة الإشراف الضعيف للتجميع (WTQ) لحساب خسارة الانحدار. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
TableQuestionAnsweringOutput أو tuple(torch.Tensor)
TableQuestionAnsweringOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (TapasConfig) والمدخلات.
تتجاوز طريقة TapasForQuestionAnswering الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري، يُعاد عند توفيرlabels(وإمكانًاanswer،aggregation_labels،numeric_valuesوnumeric_values_scale)) — إجمالي الخسارة كمجموع خسارة احتمال تسجيل اختيار الخلايا الهرمي، وخسارة الانحدار شبه المُشرف (اختياريًا)، وخسارة الإشراف (اختياريًا) للتجميعات.logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — درجات التنبؤ لرأس اختيار الخلايا، لكل رمز.logits_aggregation (
torch.Tensor، اختياري، من الشكل(batch_size, num_aggregation_labels)) — درجات التنبؤ لرأس التجميع، لكل مشغّل تجميع.hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, TapasForQuestionAnswering
>>> import pandas as pd

>>> tokenizer = AutoTokenizer.from_pretrained("google/tapas-base-finetuned-wtq")
>>> model = TapasForQuestionAnswering.from_pretrained("google/tapas-base-finetuned-wtq")

>>> data = {
...     "Actors": ["Brad Pitt", "Leonardo Di Caprio", "George Clooney"],
...     "Age": ["56", "45", "59"],
...     "Number of movies": ["87", "53", "69"],
... }
>>> table = pd.DataFrame.from_dict(data)
>>> queries = ["How many movies has George Clooney played in?", "How old is Brad Pitt?"]

>>> inputs = tokenizer(table=table, queries=queries, padding="max_length", return_tensors="pt")
>>> outputs = model(**inputs)

>>> logits = outputs.logits
>>> logits_aggregation = outputs.logits_aggregation