
Transformers documentation
LiLT
نُشر هذا النموذج في أوراق HF في 28 فبراير 2022، وأُضيف إلى مكتبة Hugging Face Transformers في 12 أكتوبر 2022.
LiLT
نظرة عامة
قُدِّم نموذج LiLT في LiLT: A Simple yet Effective Language-Independent Layout Transformer for Structured Document Understanding بواسطة Jiapeng Wang وLianwen Jin وKai Ding. يتيح LiLT دمج أي مُشفِّر نصوص RoBERTa مُدرَّب مسبقًا مع Layout Transformer خفيف الوزن، لتمكين فهم المستندات على غرار LayoutLM للعديد من اللغات.
المستخلص من الورقة البحثية هو كالتالي:
جذب فهم المستندات المهيكلة اهتمامًا كبيرًا وحقق تقدمًا ملحوظًا مؤخرًا، نظرًا لدوره الحاسم في معالجة المستندات الذكية. ومع ذلك، لا تستطيع معظم النماذج ذات الصلة الموجودة التعامل إلا مع بيانات المستندات باللغة (أو اللغات) المحددة (عادةً الإنجليزية) المضمنة في مجموعة التدريب المسبق، وهو ما يُعد محدودًا للغاية. لمعالجة هذه المشكلة، نقترح نموذج تحويل تخطيط مستقل عن اللغة (LiLT) بسيطًا وفعالًا لفهم المستندات المهيكلة. يمكن تدريب LiLT مسبقًا على مستندات مهيكلة بلغة واحدة، ثم ضبطه بدقة مباشرة على لغات أخرى باستخدام النماذج النصية المسبقة التدريب أحادية اللغة/متعددة اللغة الجاهزة. أظهرت النتائج التجريبية على ثماني لغات أن LiLT يمكنه تحقيق أداء تنافسي أو حتى متفوق على معايير الاختبار الهابطة الشائعة الاستخدام والمتنوعة، مما يتيح الاستفادة من التدريب المسبق على هيكل تخطيط المستندات بشكل مستقل عن اللغة.
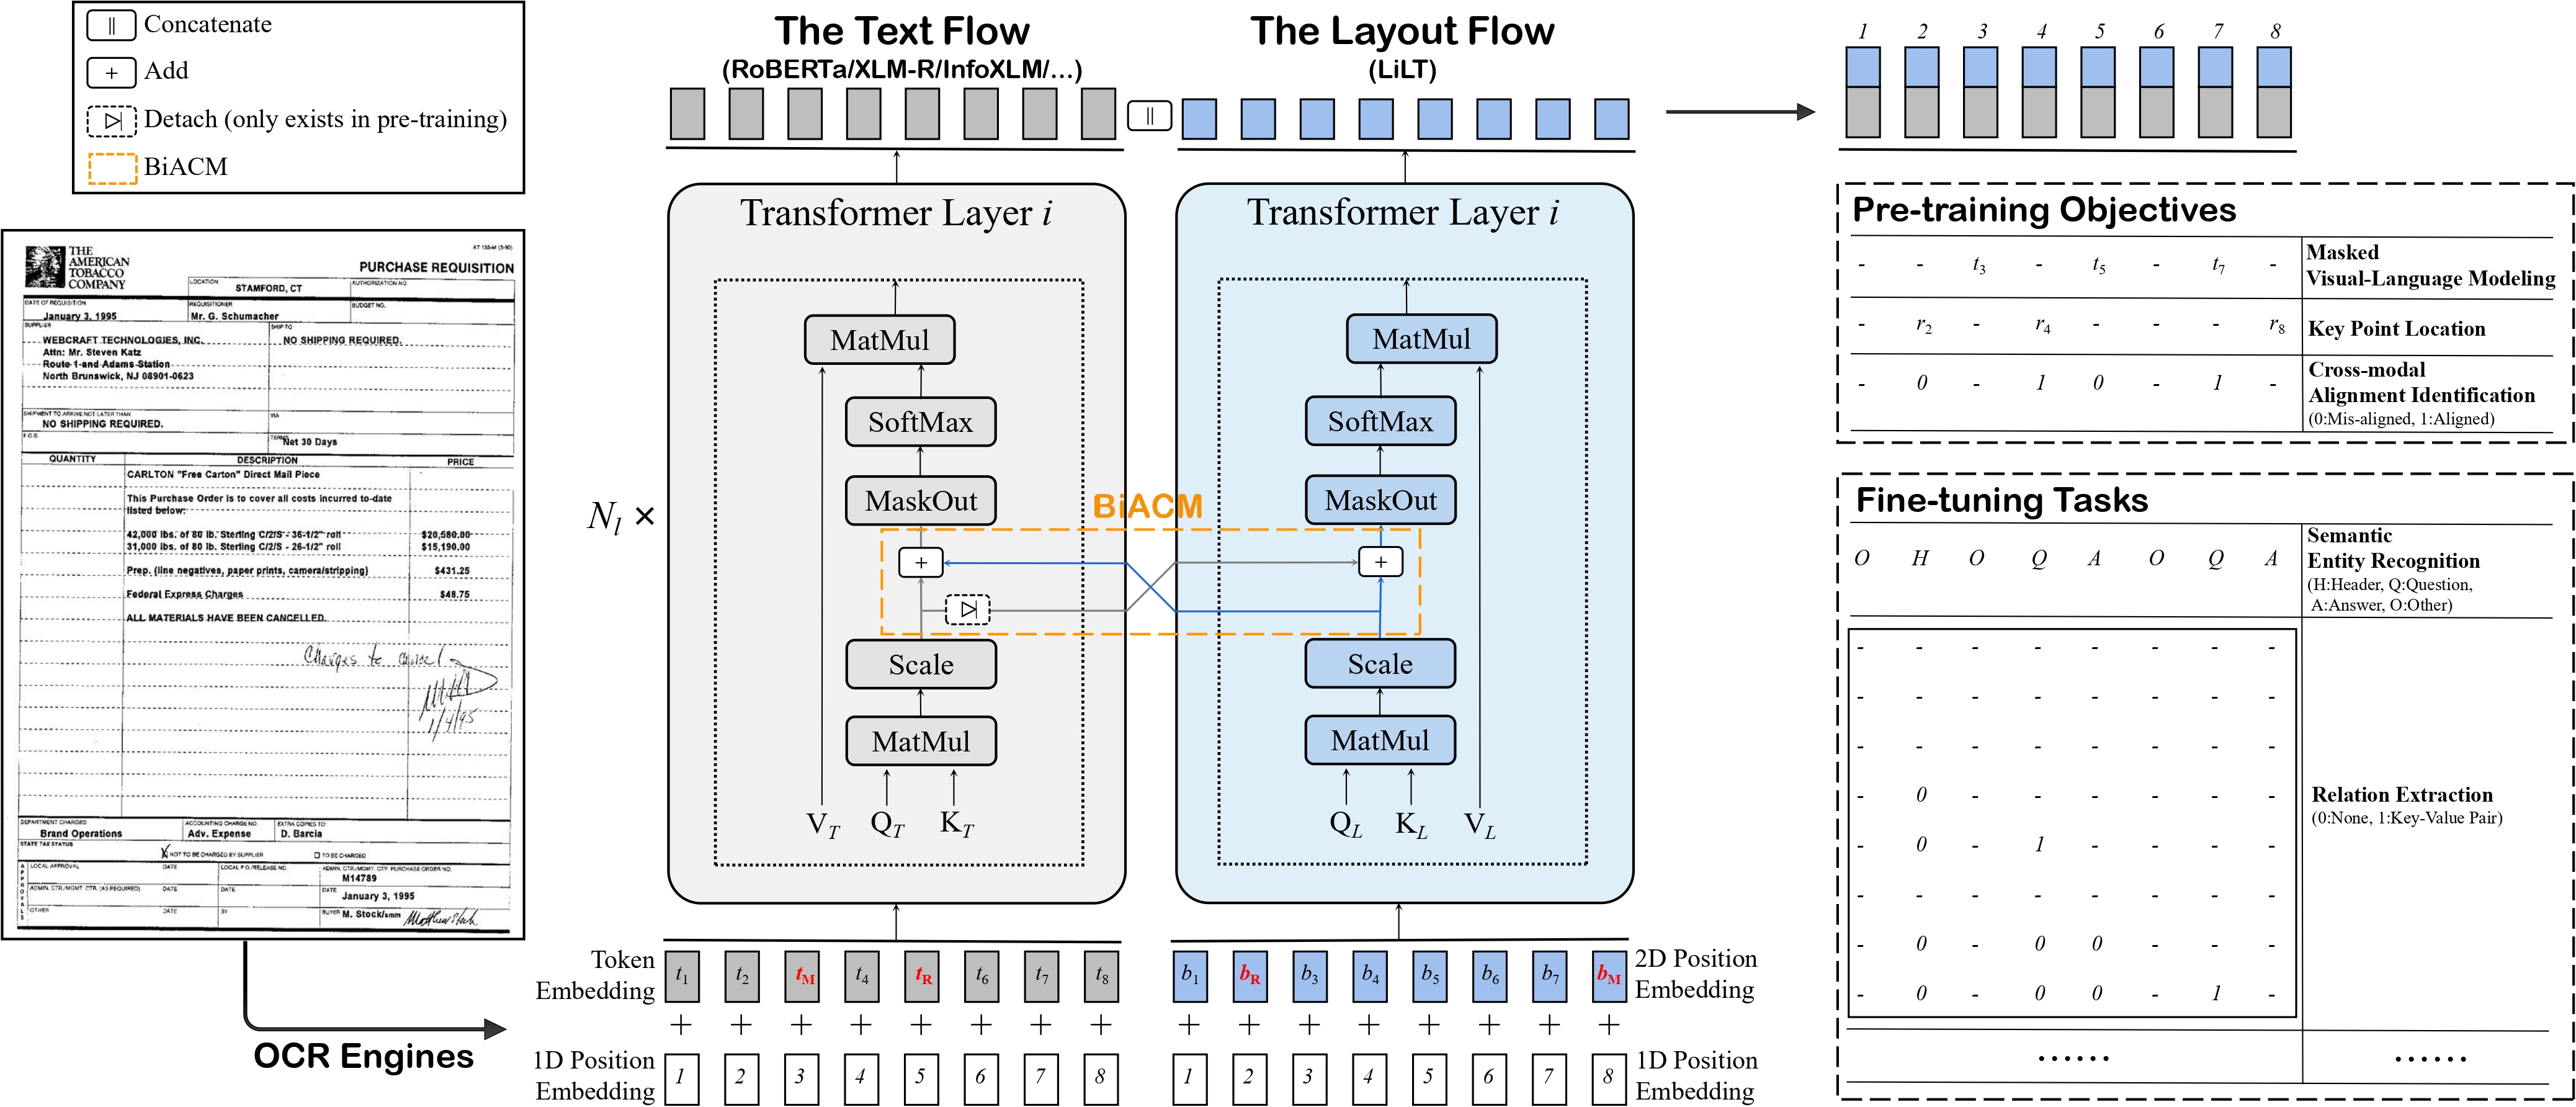 LiLT architecture. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- لدمج Language-Independent Layout Transformer مع نقطة تحقق RoBERTa جديدة من المستودع، راجع هذا الدليل.
سيؤدي تشغيل السكربت إلى حفظ ملفي
config.jsonوpytorch_model.binمحليًا. بعد القيام بذلك، يمكن تنفيذ ما يلي (بافتراض أنك مسجّل الدخول بحساب HuggingFace الخاص بك):
from transformers import LiltModel


model = LiltModel.from_pretrained("path_to_your_files", device_map="auto")
model.push_to_hub("name_of_repo_on_the_hub")- عند إعداد البيانات للنموذج، تأكد من استخدام مفردات الرموز (token vocabulary) التي تتوافق مع نقطة الفحص (checkpoint) الخاصة بـ RoBERTa التي قمت بدمجها مع Layout Transformer.
- بما أن lilt-roberta-en-base يستخدم نفس مفردات LayoutLMv3، يمكن استخدام LayoutLMv3TokenizerFast لتحضير البيانات للنموذج. والأمر نفسه ينطبق على lilt-roberta-en-base: يمكن استخدام LayoutXLMTokenizerFast لذلك النموذج.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء مع LiLT.
- يمكن العثور على كراسات العرض الخاصة بـ LiLT هنا.
موارد التوثيق
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
LiltConfig
فئة transformers.LiltConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 512type_vocab_size: int = 2initializer_range: float = 0.02layer_norm_eps: float = 1e-12pad_token_id: int | None = 0bos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Noneclassifier_dropout: float | int | None = Nonechannel_shrink_ratio: int = 4max_2d_position_embeddings: int = 1024 )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية30522) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - max_position_embeddings (
int، اختياري، القيمة الافتراضية512) — أقصى طول تسلسل قد يُستخدم مع هذا النموذج. - type_vocab_size (
int، اختياري، القيمة الافتراضية2) — حجم مفرداتtoken_type_ids. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - pad_token_id (
int، اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int, اختياري) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]], اختياري) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - classifier_dropout (
Union[float, int]، اختياري) — نسبة dropout الخاصة بتصنيفي. - channel_shrink_ratio (
int, اختياري، القيمة الافتراضية 4) — نسبة الانكماش مقارنةً بـhidden_sizeلبُعد القناة في تضمينات التخطيط. - max_2d_position_embeddings (
int، اختياري، القيمة الافتراضية 1024) — القيمة القصوى التي قد يُستخدم بها تضمين الموضع ثنائي الأبعاد. يُنصح عادةً بإعداد هذه القيمة إلى رقم كبير احتياطاً (مثلاً، 1024).
هذه فئة الإعدادات المخزنة لإعدادات نموذج LiltModel. تُستخدم لاستحداث نموذج Lilt وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ SCUT-DLVCLab/lilt-roberta-en-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import LiltConfig, LiltModel

>>> # Initializing a LiLT SCUT-DLVCLab/lilt-roberta-en-base style configuration
>>> configuration = LiltConfig()
>>> # Randomly initializing a model from the SCUT-DLVCLab/lilt-roberta-en-base style configuration
>>> model = LiltModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
LiltModel
فئة transformers.LiltModel
< source >( config: LiltConfigadd_pooling_layer = True )
المعاملات
- config (LiltConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
- add_pooling_layer (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة طبقة تجميع
نموذج Lilt الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonebbox: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- bbox (
torch.LongTensorمن الشكل(batch_size, sequence_length, 4)، اختياري) — صناديق الحدود (Bounding boxes) لكل رموز تسلسل الإدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بالصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. راجع نظرة عامة حول المعايرة. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (LiltConfig) والمدخلات.
تُعيد طريقة LiltModel الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, AutoModel
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModel.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
LiltForSequenceClassification
فئة transformers.LiltForSequenceClassification
< source >( config: LiltConfig )
المعاملات
- config (LiltConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج LiLT مُحوِّل (Transformer) مع رأس تصنيف/انحدار تسلسلي في الأعلى (طبقة خطية فوق المخرجات المجمّعة)، على سبيل المثال لمهام GLUE.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonebbox: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → SequenceClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- bbox (
torch.LongTensorمن الشكل(batch_size, sequence_length, 4)، اختياري) — صناديق الحدود (Bounding boxes) لكل رموز تسلسل الإدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بالصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. راجع نظرة عامة حول المعايرة. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/الانحدار التسلسلي. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
SequenceClassifierOutput أو tuple(torch.Tensor)
SequenceClassifierOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (LiltConfig) والمدخلات.
تتجاوز طريقة LiltForSequenceClassification الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, AutoModelForSequenceClassification
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> predicted_class_idx = outputs.logits.argmax(-1).item()
>>> predicted_class = model.config.id2label[predicted_class_idx]
LiltForTokenClassification
فئة transformers.LiltForTokenClassification
< source >( config: LiltConfig )
المعاملات
- config (LiltConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
تحويلة Lilt مع رأس تصنيف الرموز في الأعلى (طبقة خطية فوق مخرجات الحالات المخفية) على سبيل المثال لمهام التعرف على الكيانات المسمّاة (NER).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonebbox: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TokenClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- bbox (
torch.LongTensorمن الشكل(batch_size, sequence_length, 4)، اختياري) — صناديق الحدود (Bounding boxes) لكل رموز تسلسل الإدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بالصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. راجع نظرة عامة حول المعايرة. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة تصنيف الرموز. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
TokenClassifierOutput أو tuple(torch.Tensor)
TokenClassifierOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (LiltConfig) والمدخلات.
تُعيد طريقة LiltForTokenClassification الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة التصنيف.logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.num_labels)) — درجات التصنيف (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, AutoModelForTokenClassification
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModelForTokenClassification.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)
>>> predicted_class_indices = outputs.logits.argmax(-1)
LiltForQuestionAnswering
فئة transformers.LiltForQuestionAnswering
< source >( config: LiltConfig )
المعاملات
- config (LiltConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
محوّل Lilt مع رأس تصنيف مقاطع في الأعلى لمهام الإجابة الاستخراجية على الأسئلة مثل
SQuAD (طبقة خطية فوق مخرجات الحالات المخفية لحساب span start logits وspan end logits).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonebbox: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonestart_positions: typing.Optional[torch.LongTensor] = Noneend_positions: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → QuestionAnsweringModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- bbox (
torch.LongTensorمن الشكل(batch_size, sequence_length, 4)، اختياري) — صناديق الحدود (Bounding boxes) لكل رموز تسلسل الإدخال. يتم اختيارها ضمن النطاق[0, config.max_2d_position_embeddings-1]. يجب أن يكون كل صندوق حدود نسخة مُعايرة بالصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. راجع نظرة عامة حول المعايرة. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - start_positions (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لموضع (فهرس) بداية المقطع المُسمّى لحساب خسارة تصنيف الرموز. تُثبَّت المواضع على طول التسلسل (sequence_length). لا تُؤخذ المواضع خارج التسلسل في الاعتبار عند حساب الخسارة. - end_positions (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — تسميات لموضع (فهرس) نهاية المقطع المُسمّى لحساب خسارة تصنيف الرموز. تُثبَّت المواضع على طول التسلسل (sequence_length). لا تُؤخذ المواضع خارج التسلسل في الاعتبار عند حساب الخسارة. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
QuestionAnsweringModelOutput أو tuple(torch.Tensor)
QuestionAnsweringModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (LiltConfig) والمدخلات.
تُعيد طريقة LiltForQuestionAnswering الأمامية تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — إجمالي خسارة استخراج المقاطع هو مجموع دالة Cross-Entropy لموقعي البداية والنهاية.start_logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — درجات بداية النطاق (قبل SoftMax).end_logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — درجات نهاية المدى (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoTokenizer, AutoModelForQuestionAnswering
>>> from datasets import load_dataset

>>> tokenizer = AutoTokenizer.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")
>>> model = AutoModelForQuestionAnswering.from_pretrained("SCUT-DLVCLab/lilt-roberta-en-base")

>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]

>>> encoding = tokenizer(words, boxes=boxes, return_tensors="pt")

>>> outputs = model(**encoding)

>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()

>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> predicted_answer = tokenizer.decode(predict_answer_tokens)