
Transformers documentation
MGP-STR
نُشر هذا النموذج في أوراق HF في 2022-09-08 وسُهم به في Hugging Face Transformers في 2023-03-13.
MGP-STR
نظرة عامة
قُدِّم نموذج MGP-STR في Multi-Granularity Prediction for Scene Text Recognition من قِبل Peng Wang وCheng Da وCong Yao. يُعدّ MGP-STR نموذجًا لمعالجة النصوص في المشاهد (STR) بسيطًا من حيث المفهوم بسيط لكنه قوي، وهو مبني على Vision Transformer (ViT). ولدمج المعرفة اللغوية، تم اقتراح استراتيجية التنبؤ متعدد الحُجُم (MGP) لحقن المعلومات من النمط اللغوي في النموذج بطريقة ضمنية.
المستخلص من الورقة البحثية هو كالتالي:
يُعدّ التعرف على النص في المشاهد (STR) موضوع بحث نشط في مجال الرؤية الحاسوبية منذ سنوات. لمعالجة هذه المشكلة الصعبة، تم اقتراح العديد من الأساليب المبتكرة تباعاً، وأصبح دمج المعرفة اللغوية في نماذج STR اتجاهاً بارزاً مؤخراً. في هذا العمل، نستلهم أولاً من التقدم الأخير في محوّل الرؤية (ViT) لبناء نموذج رؤية STR بسيط من حيث المفهوم وقوي، وهو مبني على ViT ويتفوق على أحدث النماذج السابقة في التعرف على النص في المشاهد، بما في ذلك النماذج البصرية المحضة والأساليب المعززة باللغة. لدمج المعرفة اللغوية، نقترح أيضاً استراتيجية التنبؤ متعددة الحُجْم (Multi-Granularity Prediction) لحقن المعلومات من النمط اللغوي في النموذج بطريقة ضمنية، أي أن تمثيلات تحت الكلمة (BPE وWordPiece) المستخدمة على نطاق واسع في معالجة اللغة الطبيعية (NLP) تُقدَّم إلى فضاء الإخراج، بالإضافة إلى تمثيل مستوى الحرف التقليدي، دون اعتماد نموذج لغوي (LM) مستقل. الخوارزمية الناتجة (المعروفة باسم MGP-STR) قادرة على دفع غلاف أداء STR إلى مستوى أعلى. تحديداً، إنها تحقق دقة تعرّف متوسطة تبلغ 93.35% على المعايير القياسية.
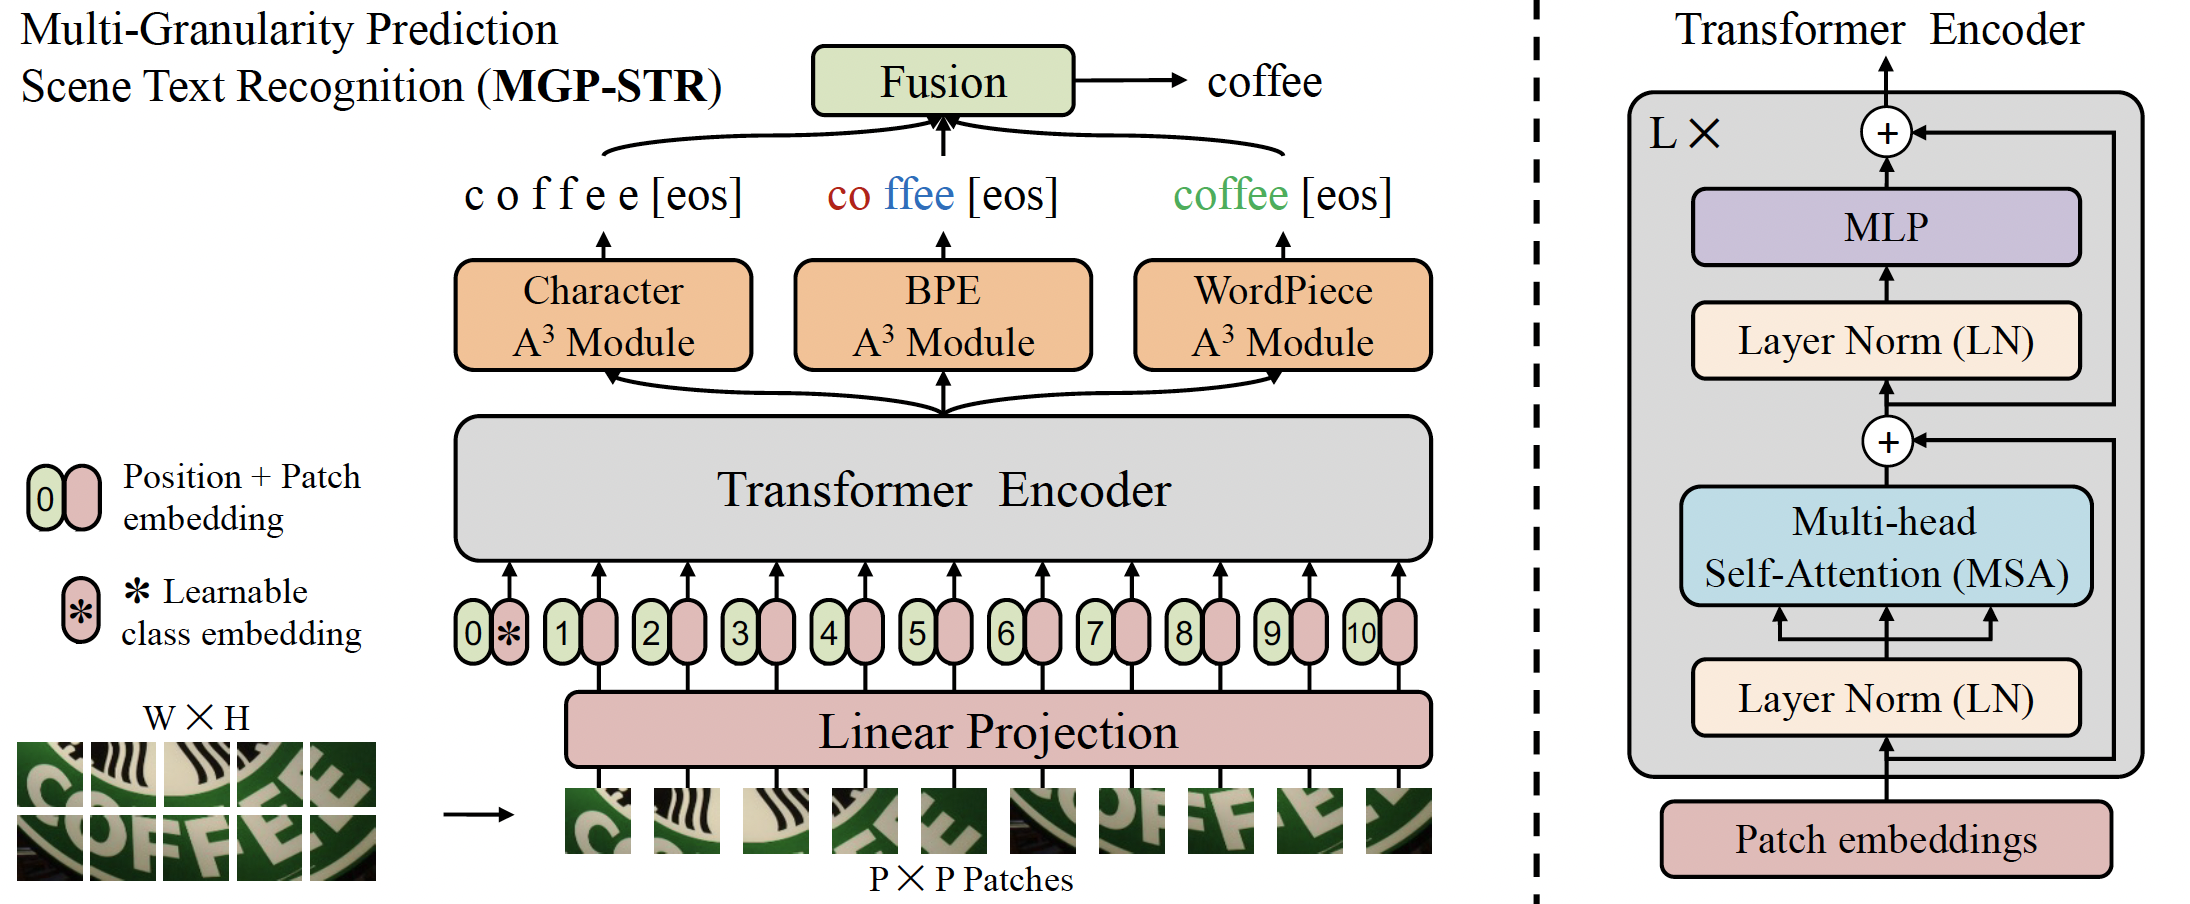 MGP-STR architecture. Taken from the original paper.
يُدرَّب نموذج MGP-STR على مجموعتين اصطناعيتين من البيانات هما MJSynth (MJ) وSynthText (ST) دون إجراء أي ضبط دقيق على مجموعات بيانات أخرى. ويحقق هذا النموذج نتائج متقدمة على ستة معايير قياسية لاختبار النصوص في المشاهد اللاتينية، وتشمل ثلاثة مجموعات بيانات للنص المنتظم (IC13، SVT، IIIT) وثلاثة مجموعات للنص غير المنتظم (IC15، SVTP، CUTE). تمت مساهمة هذا النموذج من قِبل yuekun. يمكن العثور على الكود الأصلي هنا.
مثال على الاستدلال
يقبل MgpstrModel الصور كمدخلات ويولّد ثلاثة أنواع من التنبؤات، التي تمثل معلومات نصية بدرجات تفصيل مختلفة. تُدمج أنواع التنبؤات الثلاثة معًا لإعطاء نتيجة التنبؤ النهائية.
تتولى فئة ViTImageProcessor مسؤولية المعالجة المسبقة لصورة الإدخال، بينما يقوم MgpstrTokenizer بفك ترميز رموز الأحرف المولّدة إلى النص المستهدف. تجمع فئة MgpstrProcessor بين ViTImageProcessor وMgpstrTokenizer في كائن واحد، وذلك لاستخراج ميزات الإدخال وفك ترميز معرّفات الرموز المتوقعة.
- التعرف الضوئي على الحروف (OCR) خطوة بخطوة
import requests
from PIL import Image

from transformers import MgpstrForSceneTextRecognition, MgpstrProcessor


processor = MgpstrProcessor.from_pretrained('alibaba-damo/mgp-str-base')
model = MgpstrForSceneTextRecognition.from_pretrained('alibaba-damo/mgp-str-base', device_map="auto")

# load a synthetic scene-text image
url = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/mgp_str_ticket.png"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")

pixel_values = processor(images=image, return_tensors="pt").to(model.device).pixel_values
outputs = model(pixel_values)

generated_text = processor.batch_decode(outputs.logits)['generated_text']
MgpstrConfig
فئة transformers.MgpstrConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneimage_size: list[int] | tuple[int, ...] = (32, 128)patch_size: int | list[int] | tuple[int, int] = 4num_channels: int = 3max_token_length: int = 27num_character_labels: int = 38num_bpe_labels: int = 50257num_wordpiece_labels: int = 30522hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12mlp_ratio: float | int = 4.0qkv_bias: bool = Truedistilled: bool = Falselayer_norm_eps: float = 1e-05drop_rate: float | int = 0.0attn_drop_rate: float | int = 0.0drop_path_rate: float | int = 0.0output_a3_attentions: bool = Falseinitializer_range: float = 0.02 )
المعاملات
- image_size (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(32, 128)) — حجم (دقة) كل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية4) — حجم (دقة) كل رقعة. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - max_token_length (
int، اختياري، القيمة الافتراضية 27) — الحد الأقصى لعدد الرموز المخرجة. - num_character_labels (
int، اختياري، القيمة الافتراضية 38) — عدد الفئات لرأس الشخصية. - num_bpe_labels (
int، اختياري، القيمة الافتراضية 50257) — عدد الفئات لرأس bpe. - num_wordpiece_labels (
int، اختياري، القيمة الافتراضية 30522) — عدد الفئات لرأس wordpiece. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - mlp_ratio (
Union[float, int]، اختياري، القيمة الافتراضية4.0) — نسبة بُعد مخفي MLP إلى بُعد التضمين. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم. - distilled (
bool، اختياري، القيمة الافتراضيةFalse) — يتضمن النموذج رمز تقطير ورأسًا كما في نماذج DeiT. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - drop_rate (
float، اختياري، القيمة الافتراضية 0.0) — احتمالية الإسقاط (Dropout) لجميع الطبقات المتصلة بالكامل في التضمينات والمُشفِّر. - attn_drop_rate (
float, اختياري، القيمة الافتراضية 0.0) — نسبة الإسقاط (Dropout) لاحتمالات الانتباه. - drop_path_rate (
Union[float, int], اختياري، القيمة الافتراضية0.0) — معدل إسقاط المسار (Drop path) لدمج البقع (patch fusion). - output_a3_attentions (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب على النموذج إرجاع انتباه وحدات A^3 أم لا. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Mgp StrModel. تُستخدم لاستحداث نموذج Mgp Str وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ alibaba-damo/mgp-str-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import MgpstrConfig, MgpstrForSceneTextRecognition

>>> # Initializing a Mgpstr mgp-str-base style configuration
>>> configuration = MgpstrConfig()

>>> # Initializing a model (with random weights) from the mgp-str-base style configuration
>>> model = MgpstrForSceneTextRecognition(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MgpstrTokenizer
فئة transformers.MgpstrTokenizer
< source >( vocab_fileunk_token = '[GO]'bos_token = '[GO]'eos_token = '[s]'pad_token = '[GO]'**kwargs )
المعاملات
- vocab_file (
str) — مسار ملف المفردات. - unk_token (
str، اختياري، القيمة الافتراضية"[GO]") — رمز المجهول. أي رمز غير موجود في المفردات لا يمكن تحويله إلى معرّف، فيتم تعيينه ليكون هذا الرمز بدلاً من ذلك. - bos_token (
str، اختياري، القيمة الافتراضية"[GO]") — رمز بداية التسلسل. - eos_token (
str، اختياري، القيمة الافتراضية"[s]") — رمز نهاية التسلسل. - pad_token (
strأوtokenizers.AddedToken، اختياري، القيمة الافتراضية"[GO]") — رمز خاص يُستخدم لجعل مصفوفات الرموز متساوية الحجم لأغراض الدفع (batching). ثم يتم تجاهله من قبل آليات الانتباه أو حساب الخسارة.
أنشئ مُجزِّئ أحرف MGP-STR.
يرث هذا المُجزِّئ من PreTrainedTokenizer الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
MgpstrProcessor
فئة transformers.MgpstrProcessor
< source >( image_processor = Nonetokenizer = None**kwargs )
ينشئ معالج MgpstrProcessor يجمع معالج الصور ومجزّئ الرموز في معالج واحد.
يوفر MgpstrProcessor جميع وظائف ViTImageProcessor وMgpstrTokenizer. راجع ~ViTImageProcessor و~MgpstrTokenizer لمزيد من المعلومات.
__call__
< source >( text = Noneimages = None**kwargs )
المعاملات
- text (`
) -- The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, setis_split_into_words=True` to avoid ambiguity with batched inputs. - images (`
) -- Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, setdo_rescale=False`. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
batch_decode
< source >( sequences ) → dict[str, any]
المعاملات
يعيد
dict[str, any]
قائمة بجميع مخرجات النتائج المُفكَّكة.
generated_text (list[str]): النتائج النهائية بعد دمج char وbpe وwp.
scores (list[float]): الدرجات النهائية بعد دمج char وbpe وwp.
char_preds (list[str]): قائمة الجُمل المُفكَّكة على مستوى الحروف.
bpe_preds (list[str]): قائمة الجُمل المُفكَّكة على مستوى bpe.
wp_preds (list[str]): قائمة الجُمل المُفكَّكة على مستوى wp.
تحويل قائمة من قوائم معرّفات الرموز إلى قائمة من النصوص عن طريق استدعاء decode.
تُمرّر هذه الطريقة جميع معاملاتها إلى batch_decode() الخاصة بـ PreTrainedTokenizer. يُرجى الرجوع إلى سلسلة التوثيق (docstring) لهذه الطريقة لمزيد من المعلومات.
MgpstrModel
فئة transformers.MgpstrModel
< source >( config: MgpstrConfig )
المعاملات
- config (MgpstrConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Mgp Str الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensoroutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ViTImageProcessor. راجع ViTImageProcessor.call() للتفاصيل (MgpstrProcessor يستخدم ViTImageProcessor لمعالجة الصور). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
BaseModelOutput أو tuple(torch.Tensor)
BaseModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (MgpstrConfig) والمدخلات.
تتجاوز طريقة MgpstrModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
MgpstrForSceneTextRecognition
فئة transformers.MgpstrForSceneTextRecognition
< source >( config: MgpstrConfig )
المعاملات
- config (MgpstrConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج MGP-STR وهو نموذج تحويلي (Transformer) مزود بثلاثة رؤوس تصنيف في الأعلى (ثلاثة وحدات A^3 وثلاثة طبقات خطية فوق مخرج مُشفِّر التحوّل) لتعرف النص في المشهد (STR).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensoroutput_attentions: bool | None = Noneoutput_a3_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MgpstrModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ViTImageProcessor. راجع ViTImageProcessor.call() للتفاصيل (MgpstrProcessor يستخدم ViTImageProcessor لمعالجة الصور). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_a3_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لوحدات a3 أم لا. راجعa3_attentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MgpstrModelOutput أو tuple(torch.Tensor)
MgpstrModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (MgpstrConfig) والمدخلات.
تتجاوز طريقة MgpstrForSceneTextRecognition الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
logits (
tuple(torch.Tensor)من الشكل(batch_size, config.num_character_labels)) — مجموعة منtorch.Tensor(واحدة لإخراج الحرف من الشكل(batch_size, config.max_token_length, config.num_character_labels)، + واحدة لإخراج bpe من الشكل(batch_size, config.max_token_length, config.num_bpe_labels)، + واحدة لإخراج wordpiece من الشكل(batch_size, config.max_token_length, config.num_wordpiece_labels)) .درجات التصنيف (قبل SoftMax) لكل من الأحرف وbpe وwordpiece.
hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
a3_attentions (
tuple(torch.Tensor), optional, returned whenoutput_a3_attentions=Trueis passed or whenconfig.output_a3_attentions=True) — Tuple oftorch.Tensor(one for the attention of character, + one for the attention of bpe, + one for the attention of wordpiece) of shape(batch_size, config.max_token_length, sequence_length)`.أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import (
...     MgpstrProcessor,
...     MgpstrForSceneTextRecognition,
... )
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image

>>> # load a synthetic scene-text image
>>> url = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/mgp_str_ticket.png"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")

>>> processor = MgpstrProcessor.from_pretrained("alibaba-damo/mgp-str-base")
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values

>>> model = MgpstrForSceneTextRecognition.from_pretrained("alibaba-damo/mgp-str-base")

>>> # inference
>>> outputs = model(pixel_values)
>>> out_strs = processor.batch_decode(outputs.logits)
>>> out_strs["generated_text"]
'["ticket"]'