
Transformers documentation
Grounding DINO
نُشر هذا النموذج في أوراق HF في 2023-03-09 وسُهم به في Hugging Face Transformers في 2024-04-11.
Grounding DINO
نظرة عامة
قُدِّم نموذج Grounding DINO في Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection بواسطة Shilong Liu وZhaoyang Zeng وTianhe Ren وFeng Li وHao Zhang وJie Yang وChunyuan Li وJianwei Yang وHang Su وJun Zhu وLei Zhang. يوسّع Grounding DINO نموذج كشف الكائنات المغلق المجموعة من خلال إضافة مشفّر نصي، مما يتيح كشف الكائنات المفتوحة المجموعة. يحقق النموذج نتائج ملحوظة، مثل 52.5 AP على COCO بدون تدريب مسبق.
المستخلص من الورقة البحثية هو كالتالي:
في هذه الورقة، نعرض كاشفًا للأجسام من نوع المجموعة المفتوحة، يُدعى Grounding DINO، وذلك من خلال دمج كاشف DINO القائم على Transformers مع التدريب المسبق المرتبط بالسياق، مما يتيح الكشف عن أي أجسام باستخدام مدخلات بشرية مثل أسماء الفئات أو عبارات الإشارة. الحل الجوهري للكشف عن الأجسام من نوع المجموعة المفتوحة يتمثل في إدخال اللغة إلى كاشف من نوع المجموعة المغلقة من أجل تعميم المفاهيم المفتوحة. ولدمج نمطي اللغة والرؤية بفعالية، نقسم كاشف المجموعة المغلقة مفهومياً إلى ثلاث مراحل، ونقترح حلاً للدمج الضيق يتضمن معزّز ميزات، واختيار استعلامات موجّهة باللغة، ومفكك بين النماذج للدمج بين النماذج. في حين ركّزت الأعمال السابقة بشكل رئيسي على تقييم الكشف عن الأجسام من نوع المجموعة المفتوحة على فئات جديدة، نقترح أيضاً إجراء تقييمات على فهم عبارات الإشارة للأجسام المحددة بسمات. يتفوق Grounding DINO بشكل ملحوظ في جميع الإعدادات الثلاث، بما في ذلك معايير COCO وLVIS وODinW وRefCOCO/+/g. يحقق Grounding DINO دقة AP تبلغ 52.5 على معيار COCO للنقل بدون تدريب مسبق، أي دون استخدام أي بيانات تدريب من COCO. كما يسجّل رقماً قياسياً جديداً على معيار ODinW بدون تدريب مسبق بمتوسط AP يبلغ 26.1.
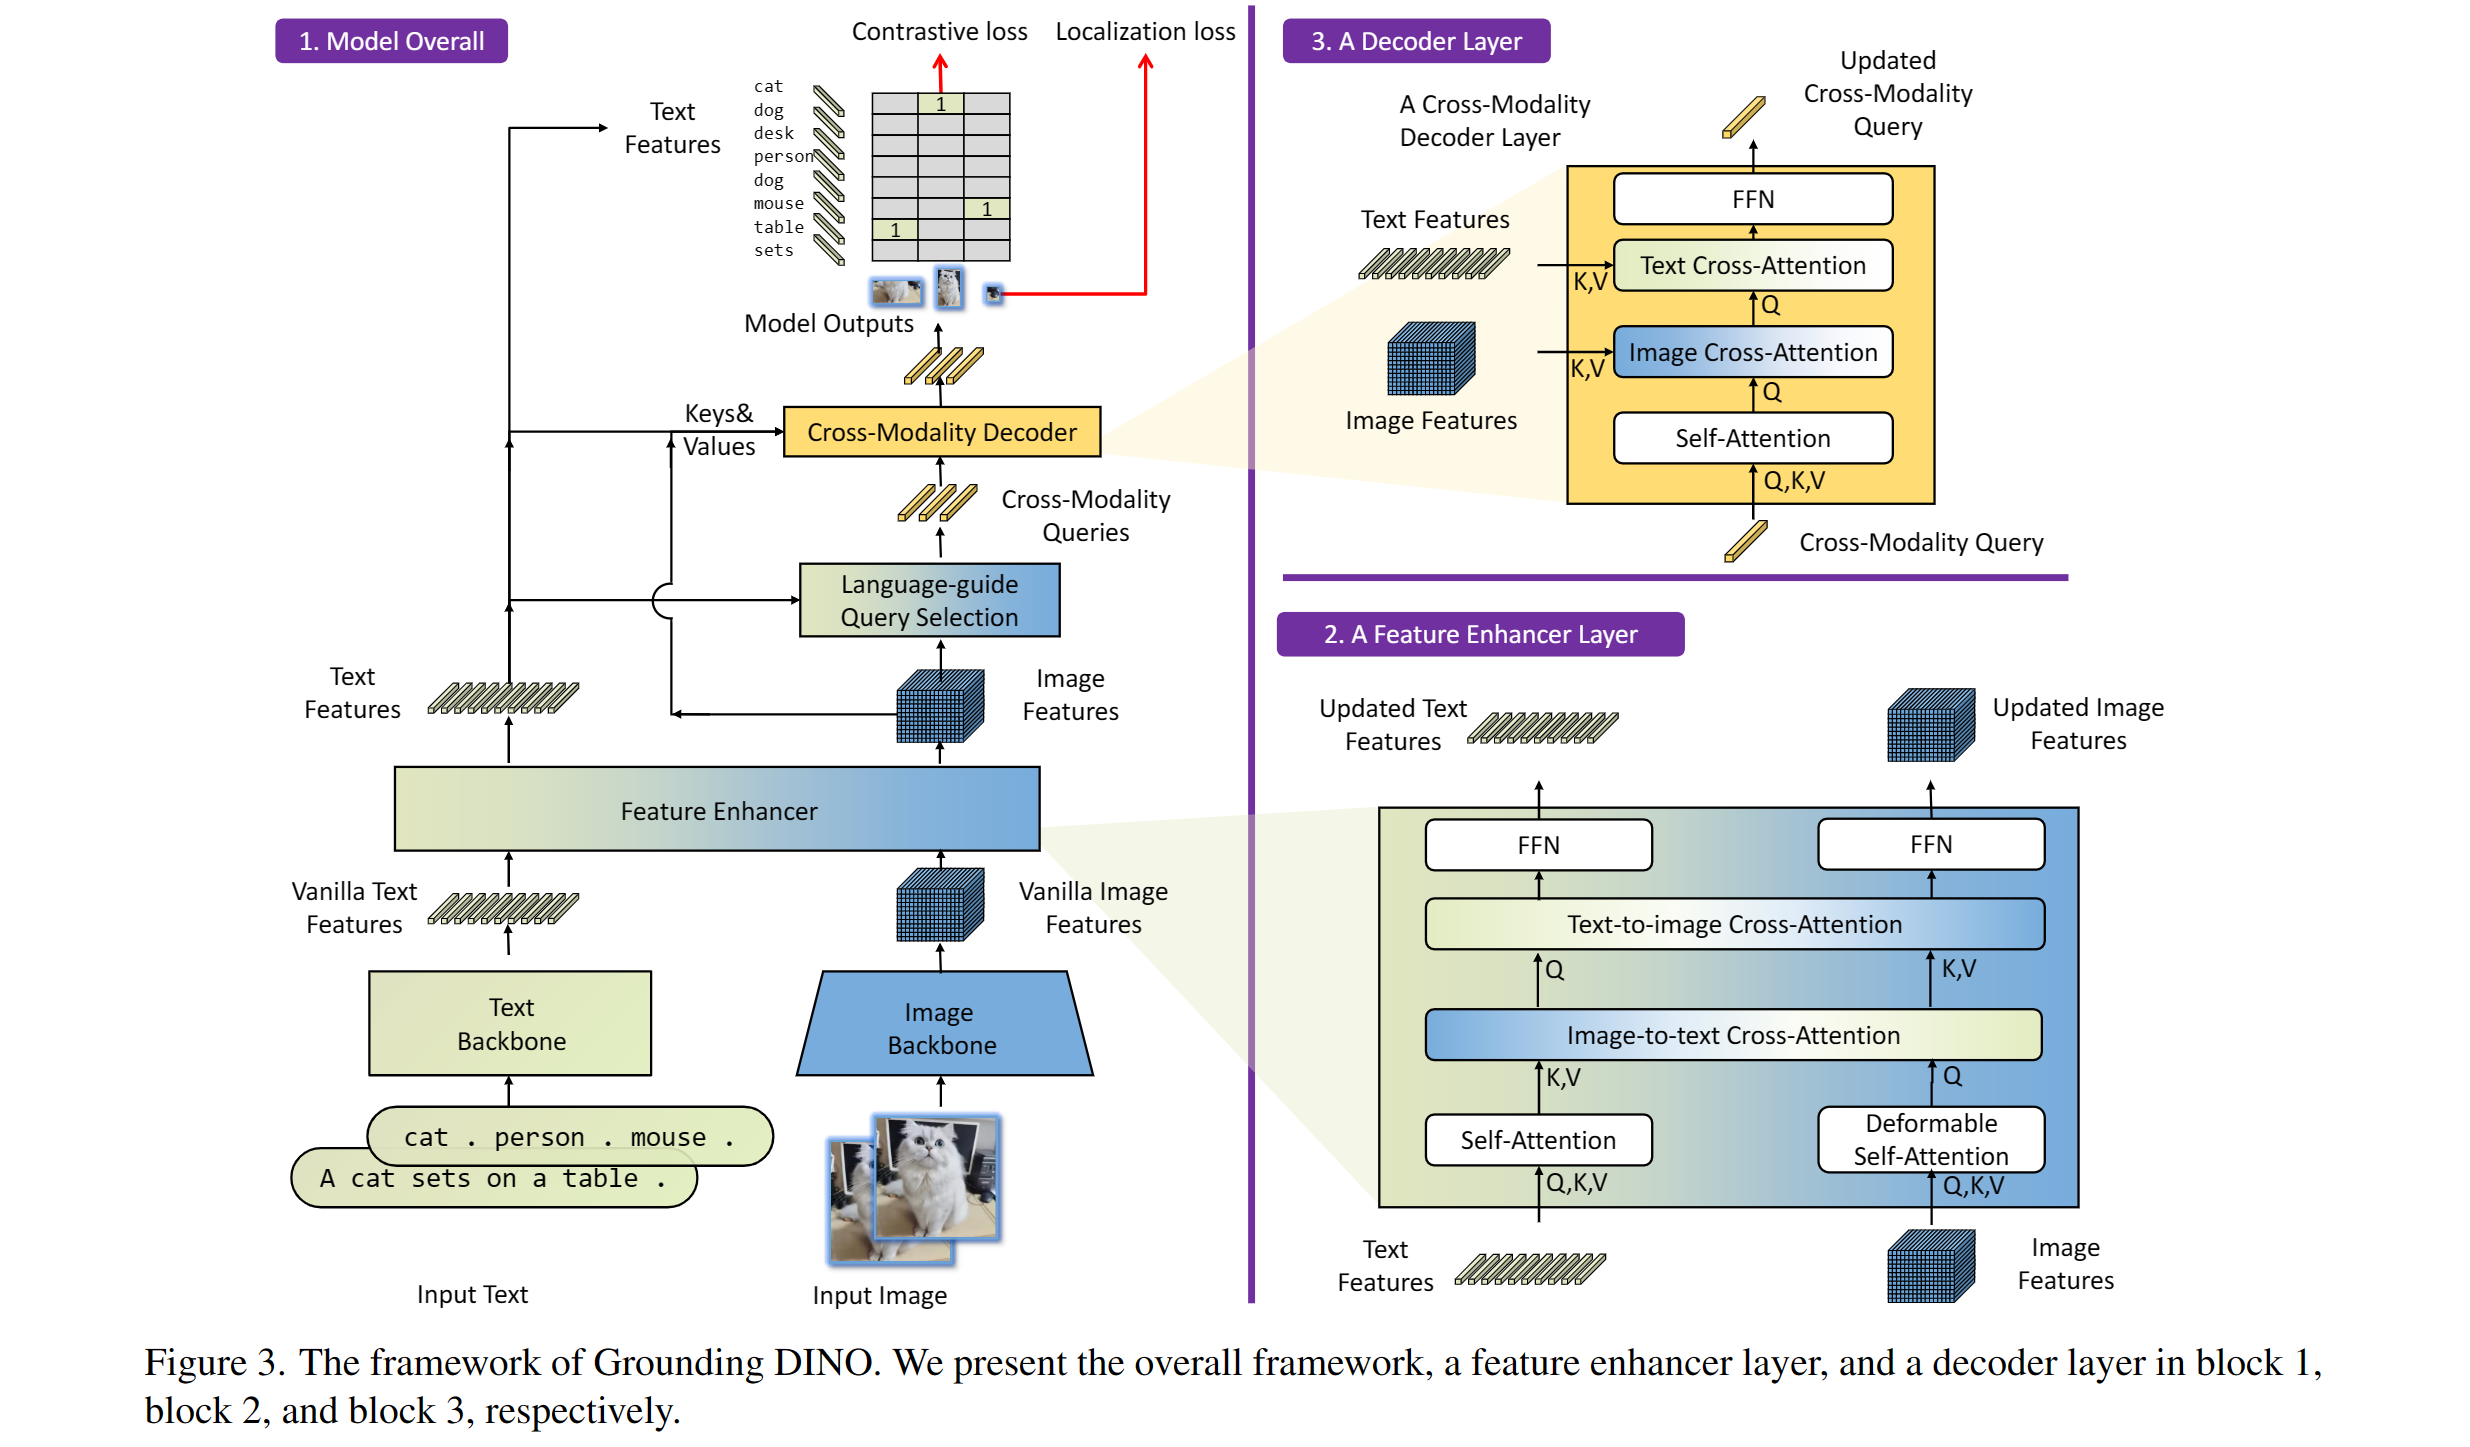 Grounding DINO overview. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل EduardoPacheco وnielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- يمكن استخدام GroundingDinoProcessor لتحضير أزواج النص والصورة للنموذج.
- لفصل الفئات في النص، استخدم نقطة، على سبيل المثال: “a cat. a dog.”
- عند استخدام فئات متعددة (مثل
"a cat. a dog.")، استخدمpost_process_grounded_object_detectionمن GroundingDinoProcessor لمعالجة المخرجات بعد التنفيذ. حيث إن التسميات التي تُعاد منpost_process_object_detectionتمثل الفهارس من بُعد النموذج حيث تكون الاحتمالية > العتبة.
إليك كيفية استخدام النموذج للكشف عن الأشياء بدون تدريب مسبق:
import requests

import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection

model_id = "IDEA-Research/grounding-dino-tiny"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")

image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]

inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

results = processor.post_process_grounded_object_detection(
    outputs,
    inputs.input_ids,
    threshold=0.4,
    text_threshold=0.3,
    target_sizes=[image.size[::-1]]
)

# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
    box = [round(x, 2) for x in box.tolist()]
    print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
سام الموثّق
يمكن الجمع بين Grounding DINO ونموذج Segment Anything لتوليد الأقنعة بناءً على النص، كما هو موضح في Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks. يمكنك الرجوع إلى دفتر العرض التوضيحي 🌍 هذا للتفاصيل.
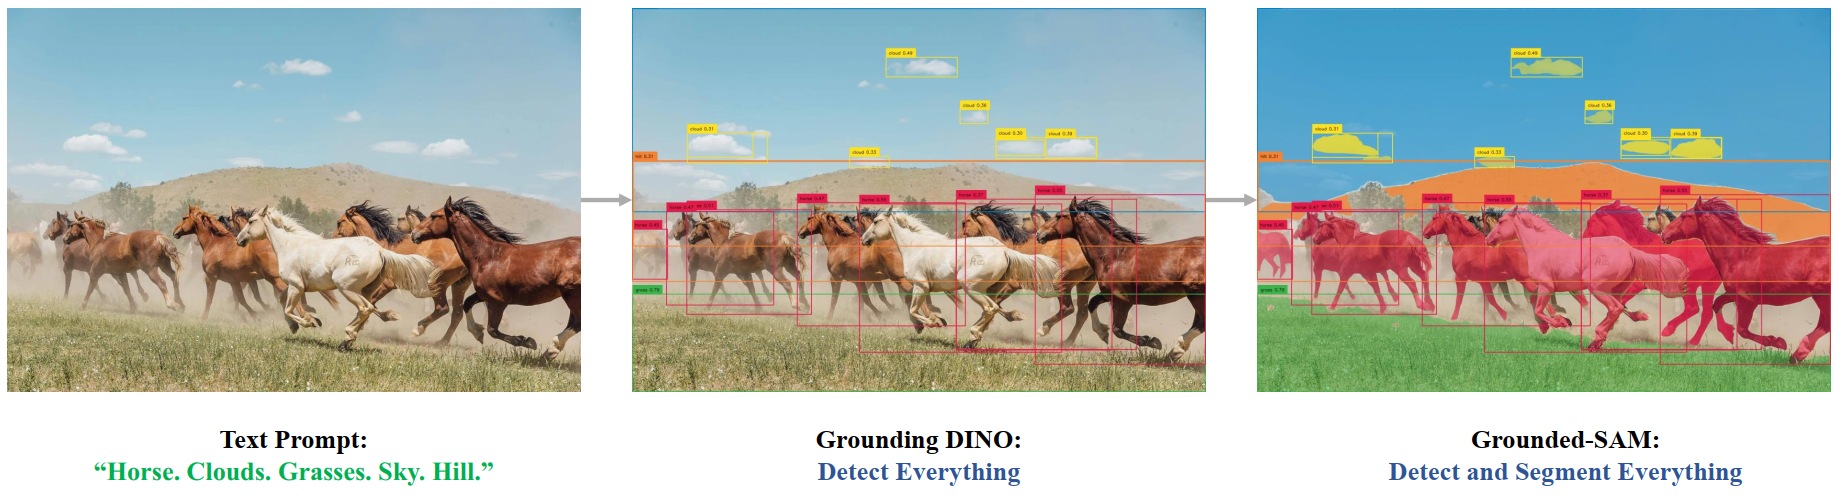 Grounded SAM overview. Taken from the original repository.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد من المجتمع (مُشار إليها بـ 🌎) لمساعدتك على البدء مع Grounding DINO. إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب (Pull Request) وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
- يمكن العثور على دفاتر ملاحظات توضيحية تتعلق بالاستدلال باستخدام Grounding DINO وكذلك دمجه مع SAM هنا. 🌎
GroundingDinoImageProcessor
فئة transformers.GroundingDinoImageProcessor
< source >( **kwargs: *<class 'transformers.models.grounding_dino.image_processing_grounding_dino.GroundingDinoImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 800, 'longest_edge': 1333}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ملء الصورة. يتم الملء إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الملء الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - format (
str، kwargs، اختياري، القيمة الافتراضيةAnnotationFormat.COCO_DETECTION) — تنسيق البيانات للتعليقات التوضيحية. أحد الخيارين: “coco_detection” أو “coco_panoptic”. - do_convert_annotations (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — يتحكم في ما إذا كان سيتم تحويل التسميات إلى الصيغة التي يتوقعها نموذج GROUNDING_DINO. يقوم بتحويل صناديق الحدود إلى الصيغة(center_x, center_y, width, height)وفي المدى[0, 1]. يمكن تجاوز ذلك عبر معاملdo_convert_annotationsفي طريقةpreprocess.
ينشئ معالج صور GroundingDinoImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = Nonereturn_segmentation_masks: bool | None = Nonemasks_path: str | pathlib.Path | None = None**kwargs: *<class 'transformers.models.grounding_dino.image_processing_grounding_dino.GroundingDinoImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - annotations (
AnnotationTypeأوlist[AnnotationType]، اختياري) — التعليقات التي سيتم تحويلها وفقاً للتوسيط المطبّق على الصور. - return_segmentation_masks (
bool، اختياري، القيمة الافتراضيةself.return_segmentation_masks) — ما إذا كان يجب إرجاع أقنعة التقطيع. - masks_path (
strأوpathlib.Path، اختياري) — المسار إلى المجلد الذي يحتوي على أقنعة التقسيم. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - format (
str، kwargs، اختياري، القيمة الافتراضيةAnnotationFormat.COCO_DETECTION) — تنسيق البيانات للتعليقات التوضيحية. أحد الخيارين: “coco_detection” أو “coco_panoptic”. - do_convert_annotations (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — يتحكم في ما إذا كان سيتم تحويل التسميات إلى الصيغة التي يتوقعها نموذج GROUNDING_DINO. يقوم بتحويل صناديق الحدود إلى الصيغة(center_x, center_y, width, height)وفي المدى[0, 1]. يمكن تجاوز ذلك عبر معاملdo_convert_annotationsفي طريقةpreprocess.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
GroundingDinoImageProcessorPil
فئة transformers.GroundingDinoImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.grounding_dino.image_processing_pil_grounding_dino.GroundingDinoImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 800, 'longest_edge': 1333}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ملء الصورة. يتم الملء إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الملء الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - format (
str، kwargs، اختياري، القيمة الافتراضيةAnnotationFormat.COCO_DETECTION) — تنسيق البيانات للتعليقات التوضيحية. أحد الخيارين: “coco_detection” أو “coco_panoptic”. - do_convert_annotations (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — يتحكم في ما إذا كان سيتم تحويل التسميات إلى الصيغة التي يتوقعها نموذج GROUNDING_DINO. يقوم بتحويل صناديق الحدود إلى الصيغة(center_x, center_y, width, height)وفي المدى[0, 1]. يمكن تجاوز ذلك عبر معاملdo_convert_annotationsفي طريقةpreprocess.
ينشئ معالج صور GroundingDinoImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = Nonereturn_segmentation_masks: bool | None = Nonemasks_path: str | pathlib.Path | None = None**kwargs: *<class 'transformers.models.grounding_dino.image_processing_pil_grounding_dino.GroundingDinoImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - annotations (
AnnotationTypeأوlist[AnnotationType]، اختياري) — التعليقات التي سيتم تحويلها وفقاً للتوسيط المطبّق على الصور. - return_segmentation_masks (
bool، اختياري، القيمة الافتراضيةself.return_segmentation_masks) — ما إذا كان يجب إرجاع أقنعة التقطيع. - masks_path (
strأوpathlib.Path، اختياري) — المسار إلى المجلد الذي يحتوي على أقنعة التقسيم. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - format (
str، kwargs، اختياري، القيمة الافتراضيةAnnotationFormat.COCO_DETECTION) — تنسيق البيانات للتعليقات التوضيحية. أحد الخيارين: “coco_detection” أو “coco_panoptic”. - do_convert_annotations (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — يتحكم في ما إذا كان سيتم تحويل التسميات إلى الصيغة التي يتوقعها نموذج GROUNDING_DINO. يقوم بتحويل صناديق الحدود إلى الصيغة(center_x, center_y, width, height)وفي المدى[0, 1]. يمكن تجاوز ذلك عبر معاملdo_convert_annotationsفي طريقةpreprocess.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_object_detection
< source >( outputs: GroundingDinoObjectDetectionOutputthreshold: float = 0.1target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None ) → list[Dict]
المعاملات
- outputs (
GroundingDinoObjectDetectionOutput) — المخرجات الخام للنموذج. - threshold (
float، اختياري، القيمة الافتراضية 0.1) — حدّ الدرجة الذي يُحتفظ به للتنبؤات الخاصة بكشف الكائنات. - target_sizes (
torch.Tensorأوlist[tuple[int, int]]، اختياري) — مصفوفة (Tensor) بأبعاد(batch_size, 2)أو قائمة من الأزواج (tuple[int, int]) تحتوي على الحجم المستهدف(height, width)لكل صورة في الدفعة. إذا لم يتم ضبطه، فلن يتم تغيير حجم التنبؤات.
يعيد
list[Dict]
قائمة من القواميس، حيث يحتوي كل قاموس على المفاتيح التالية:
- “scores”: درجات الثقة لكل صندوق متوقع على الصورة.
- “labels”: فهارس الفئات التي يتنبأ بها النموذج في الصورة.
- “boxes”: صناديق الحدود للصور بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
يحوّل المخرجات الخام لـ GroundingDinoForObjectDetection إلى صناديق تحديد نهائية بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
GroundingDinoProcessor
فئة transformers.GroundingDinoProcessor
< source >( image_processortokenizer )
ينشئ GroundingDinoProcessor الذي يجمع معالج الصور ومعالج الرموز في معالج واحد.
يوفر GroundingDinoProcessor جميع وظائف GroundingDinoImageProcessor وBertTokenizer. راجع ~GroundingDinoImageProcessor و~BertTokenizer لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = Nonevideos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = Noneaudio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.processing_utils.ProcessingKwargs'> )
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str], list[list[str]]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصاً أو قائمة من النصوص (نص مُقسَّم مسبقاً إلى رموز). إذا مرّرت مدخلاً مُقسَّماً مسبقاً إلى رموز، فعيّنis_split_into_words=Trueلتجنّب الغموض مع المدخلات المُجمَّعة في دفعات. - videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]، اختياري) — فيديو يُراد معالجته مسبقًا. يتوقع فيديو واحدًا أو دفعة من الفيديوهات بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر فيديوهات بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - audio (
Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]], اختياري) — الصوت أو مجموعة الأصوات التي سيتم تجهيزها. يمكن أن يكون كل صوت مصفوفة NumPy أو متجه PyTorch. في حالة استخدام مصفوفة NumPy أو متجه PyTorch، يجب أن يكون شكل كل صوت (C, T)، حيث C هو عدد القنوات، وT هو طول العينة للصوت. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
post_process_grounded_object_detection
< source >( outputs: GroundingDinoObjectDetectionOutputinput_ids: transformers.utils.generic.TensorType | None = Nonethreshold: float = 0.25text_threshold: float = 0.25target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = Nonetext_labels: list[list[str]] | None = None ) → list[Dict]
المعاملات
- outputs (
GroundingDinoObjectDetectionOutput) — المخرجات الخام للنموذج. - input_ids (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — معرّفات الرموز (token ids) للنص المُدخل. إذا لم تُقدَّم، فسيتم أخذها من مخرجات النموذج. - threshold (
float، اختياري، القيمة الافتراضية 0.25) — الحد الأدنى للاحتفاظ بتنبؤات كشف الكائنات بناءً على درجة الثقة. - text_threshold (
float، اختياري، القيمة الافتراضية 0.25) — حدّ الدرجة للاحتفاظ بتنبؤات كشف النص. - target_sizes (
torch.Tensorأوlist[tuple[int, int]]، اختياري) — مصفوفة (Tensor) بأبعاد(batch_size, 2)أو قائمة من الأزواج (tuple[int, int]) تحتوي على الحجم المستهدف(height, width)لكل صورة في الدفعة. إذا لم يتم ضبطه، فلن يتم تغيير حجم التنبؤات. - text_labels (
list[list[str]]، اختياري) — قائمة بتسميات مرشحة للكشف عنها في كل صورة. في الوقت الحالي، لا يُستخدم، لكنه مطلوب في التوقيع الخاص بخط أنابيب كشف الأشياء بدون تدريب. تُستخرج التسميات النصية بدلاً من ذلك من متجهinput_idsالمُقدَّم فيoutputs.
يعيد
list[Dict]
قائمة من القواميس، حيث يحتوي كل قاموس على
- scores: متجه من درجات الثقة للكائنات المكتشفة
- boxes: متجه (tensor) لصفوف الإحداثيات المحيطة بالصناديق (bounding boxes) بصيغة [x0, y0, x1, y1]
- labels: قائمة بتسميات نصية لكل كائن تم اكتشافه (ستُستبدل بمعرّفات عددية في الإصدار 4.51.0)
- text_labels: قائمة بتسميات النصوص للكائنات المكتشفة
يحوّل المخرجات الخام لـ GroundingDinoForObjectDetection إلى صناديق تحديد نهائية بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y) ويحصل على التسمية النصية المرتبطة بها.
GroundingDinoConfig
فئة transformers.GroundingDinoConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_queries: int = 900encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'num_feature_levels: int = 4encoder_n_points: int = 4decoder_n_points: int = 4two_stage: bool = Trueclass_cost: float = 1.0bbox_cost: float = 5.0giou_cost: float = 2.0bbox_loss_coefficient: float = 5.0giou_loss_coefficient: float = 2.0focal_alpha: float = 0.25disable_custom_kernels: bool = Falsemax_text_len: int = 256text_enhancer_dropout: float | int = 0.0fusion_droppath: float | int = 0.1fusion_dropout: float | int = 0.0embedding_init_target: bool = Truequery_dim: int = 4decoder_bbox_embed_share: bool = Truetwo_stage_bbox_embed_share: bool = Falsepositional_embedding_temperature: int = 20init_std: float = 0.02layer_norm_eps: float = 1e-05tie_word_embeddings: bool = True )
المعاملات
- is_encoder_decoder (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]، اختياري) — كائن الإعدادات أو قاموس العمود الفقري النصي. - num_queries (
int، اختياري، القيمة الافتراضية 900) — عدد استعلامات الكائنات، أي فتحات الكشف. هذا هو الحد الأقصى لعدد الكائنات التي يمكن لنموذج GroundingDinoModel اكتشافها في صورة واحدة. - encoder_layers (
int, اختياري، القيمة الافتراضية6) — عدد الطبقات المخفية في مُشفِّر Transformer. سيستخدم القيمة نفسها لـnum_layersإذا لم يتم ضبطه. - encoder_ffn_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد طبقة "الوسط" (التي تُسمّى غالبًا بطبقة التغذية الأمامية) في المُشفِّر. - encoder_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُشفِّر Transformer. - decoder_layers (
int, اختياري، القيمة الافتراضية6) — عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمةnum_layersإذا لم يتم تعيينه. - decoder_ffn_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد طبقة "الوسط" (التي تُسمّى غالباً بطبقة التغذية الأمامية) في المُفكِّك. - decoder_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - activation_function (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - d_model (
int، اختياري، القيمة الافتراضية256) — حجم طبقات المُشفِّر وطبقة المُجمِّع. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — النسبة لجميع طبقات dropout. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - activation_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة dropout للتفعيلات داخل الطبقة المتصلة بالكامل. - auxiliary_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام خسائر فك الترميز المساعدة (الخسائر في كل طبقة من طبقات فك الترميز). - position_embedding_type (
str، اختياري، القيمة الافتراضية"sine") — نوع تضمينات الموضع المستخدمة فوق ميزات الصورة. إما"sine"أو"learned". - num_feature_levels (
int، اختياري، القيمة الافتراضية 4) — عدد مستويات الميزات المدخلة. - encoder_n_points (
int، اختياري، القيمة الافتراضية 4) — عدد المفاتيح المُستخرجة في كل مستوى من مستويات الميزات لكل رأس انتباه في المُشفِّر. - decoder_n_points (
int، اختياري، القيمة الافتراضية 4) — عدد المفاتيح المُعَيَّنَة في كل مستوى من مستويات الميزات لكل رأس انتباه في المُفَكِّك. - two_stage (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيق نموذج DETR قابل للتشوه على مرحلتين، حيث يتم توليد اقتراحات المناطق أيضًا بواسطة نسخة من Grounding DINO، ثم تُغذّى هذه الاقتراحات إلى المُفكِّك (decoder) لتحسين صناديق الحدود بشكل تكراري. - class_cost (
float، اختياري، القيمة الافتراضية1.0) — الوزن النسبي لخطأ التصنيف في تكلفة المطابقة الهنغارية. - bbox_cost (
float، اختياري، القيمة الافتراضية5.0) — الوزن النسبي لخطأ صندوق الحدود L1 في تكلفة المطابقة الهنغارية. - giou_cost (
float، اختياري، القيمة الافتراضية2.0) — الوزن النسبي لخسارة IoU المعممة في تكلفة المطابقة الهنغارية. - bbox_loss_coefficient (
float, اختياري، القيمة الافتراضية5.0) — الوزن النسبي لخسارة صندوق الحدود L1 في خسارة التقطيع البانورامي. - giou_loss_coefficient (
float, اختياري، القيمة الافتراضية2.0) — الوزن النسبي لخسارة IoU المعممة في خسارة التقطيع البانورامي. - focal_alpha (
float، اختياري، القيمة الافتراضية0.25) — معامل ألفا في دالة الخسارة البؤرية. - disable_custom_kernels (
bool، اختياري، القيمة الافتراضيةFalse) — تعطيل استخدام نواة CUDA وCPU المخصصة. هذا الخيار ضروري للتصدير إلى ONNX، حيث لا تدعم عملية التصدير إلى ONNX في PyTorch النوى المخصصة. - max_text_len (
int، اختياري، القيمة الافتراضية 256) — الحد الأقصى لطول مدخلات النص. - text_enhancer_dropout (
float, اختياري، القيمة الافتراضية 0.0) — نسبة dropout لمُحسِّن النص. - fusion_droppath (
float, اختياري، القيمة الافتراضية 0.1) — نسبة droppath الخاصة بوحدة الدمج. - fusion_dropout (
float, اختياري، القيمة الافتراضية 0.0) — نسبة dropout لوحدة الدمج. - embedding_init_target (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تهيئة الهدف بأوزان Embedding. - query_dim (
int، اختياري، القيمة الافتراضية 4) — بعد متجه الاستعلام. - decoder_bbox_embed_share (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم مشاركة رأس انحدار bbox لجميع طبقات المُفكِّك. - two_stage_bbox_embed_share (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم مشاركة تضمين bbox بين مولّد bbox ذي المرحلتين وتوليد اقتراحات المنطقة. - positional_embedding_temperature (
float، اختياري، القيمة الافتراضية 20) — درجة الحرارة الخاصة بتضمين الموضع الجيبية (Sine Positional Embedding) التي تُستخدم مع العمود الفقري البصري (vision backbone). - init_std (
float، اختياري، القيمة الافتراضية0.02) — انحراف معياري لمُهيّئ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Grounding Dino. تُستخدم لاستحداث نموذج Grounding Dino وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ IDEA-Research/grounding-dino-tiny
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import GroundingDinoConfig, GroundingDinoModel

>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()

>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
GroundingDinoModel
فئة transformers.GroundingDinoModel
< source >( config: GroundingDinoConfig )
المعاملات
- config (GroundingDinoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Grounding DINO الأساسي (المكوّن من هيكل أساسي وحوّال مُشفِّر-مُفكِّك) الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorinput_ids: Tensortoken_type_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneencoder_outputs = Noneoutput_attentions = Noneoutput_hidden_states = Nonereturn_dict = None**kwargs ) → GroundingDinoModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام GroundingDinoImageProcessor. راجع GroundingDinoImageProcessor.call() للتفاصيل (GroundingDinoProcessor يستخدم GroundingDinoImageProcessor لمعالجة الصور). - input_ids (
torch.LongTensorبشكل(batch_size, text_sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا إذا قمت بتزويده.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع BertTokenizer.call() للحصول على التفاصيل.
- token_type_ids (
torch.LongTensorبشكل(batch_size, text_sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]: 0 تتوافق مع رمزsentence A، و1 تتوافق مع رمزsentence Bرمز - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- pixel_mask (
torch.Tensorبشكل(batch_size, height, width), اختياري) — قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة من[0, 1]:- 1 للبيكسلات الحقيقية (أي غير المقنّعة)،
- 0 للبيكسلات التي تمثل حشواً (أي مقنّعة).
- encoder_outputs (`
) -- Tuple consists of (last_hidden_state, *optional*:hidden_states, *optional*:attentions)last_hidden_stateof shape(batch_size, sequence_length, hidden_size)`, optional) هي سلسلة من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من المُشفِّر. تُستخدم في الانتباه المتقاطع (cross-attention) داخل المُفكِّك. - output_attentions (`
) -- Whether or not to return the attentions tensors of all attention layers. Seeattentions` under returned tensors for more detail. - output_hidden_states (`
) -- Whether or not to return the hidden states of all layers. Seehidden_states` under returned tensors for more detail. - return_dict (") — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
GroundingDinoModelOutput أو tuple(torch.Tensor)
GroundingDinoModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (GroundingDinoConfig) والمدخلات.
تتجاوز طريقة GroundingDinoModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_queries, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من فاحص النموذج.init_reference_points (
torch.Tensorمن الشكل(batch_size, num_queries, 4)) — نقاط المرجع الأولية المُرسلة عبر مُفكِّك Transformer.intermediate_hidden_states (
torch.Tensorمن الشكل(batch_size, config.decoder_layers, num_queries, hidden_size)) — حالات مخفية وسيطة مكدسة (مخرجات كل طبقة من فاحم الشيفر).intermediate_reference_points (
torch.Tensorمن الشكل(batch_size, config.decoder_layers, num_queries, 4)) — نقاط مرجعية وسيطة مكدسة (نقاط مرجعية لكل طبقة من طبقات المُفكِّك).decoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
decoder_attentions (
tuple[tuple[torch.Tensor]]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
encoder_last_hidden_state_vision (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من المُشفِّر في النموذج.encoder_last_hidden_state_text (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات الخفاء عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_vision_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج تضمينات الرؤية + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size). حالات مخفية لمشفّر الرؤية عند إخراج كل طبقة بالإضافة إلى مخرجات التضمين الأولية.encoder_text_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات النصية + واحدة لإخراج كل طبقة) بشكل(batch_size, sequence_length, hidden_size). حالات المخفية لمشفّر النص عند إخراج كل طبقة بالإضافة إلى مخرجات التضمين الأولية.encoder_attentions (
tuple(tuple(torch.Tensor))، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة من المجموعات منtorch.Tensor(واحدة لكل طبقة من طبقات الانتباه) بأبعاد(batch_size, num_heads, sequence_length, sequence_length). أوزان الانتباه بعد دالة softmax للانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه النص-البصري، والبصري-النصي، ومُعزِّز النص (الانتباه الذاتي)، ورؤوس الانتباه المتشوه متعدد المقاييس. softmax للانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه ثنائي الاتجاه.enc_outputs_class (
torch.Tensorمن الشكل(batch_size, sequence_length, config.num_labels)، اختياري، يُعاد عندconfig.two_stage=True) — درجات الصناديق المحيطة المتوقعة حيث يتم اختيار أعلىconfig.num_queriesصناديق محيطة من حيث الدرجات كإقتراحات مناطق في المرحلة الأولى. مخرجات التصنيف الثنائي للصناديق المحيطة (أي المقدمة والخلفية).enc_outputs_coord_logits (
torch.Tensorمن الشكل(batch_size, sequence_length, 4)، اختياري، يُعاد عندconfig.two_stage=True) — قيم اللوجيتات الخاصة بإحداثيات صناديق الحدود المتوقعة في المرحلة الأولى.encoder_logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.num_labels)، اختياري، يُعاد عندconfig.two_stage=True) — قيم اللوجيتات (Logits) لصناديق الحدود (Bounding boxes) الأعلى تقييماً وعددهاconfig.num_queriesفي المرحلة الأولى.encoder_pred_boxes (
torch.Tensorمن الشكل(batch_size, sequence_length, 4)، اختياري، يُعاد عندconfig.two_stage=True) — إحداثيات صناديق الحدود الأعلى تقييماً وعددهاconfig.num_queriesفي المرحلة الأولى.
أمثلة:
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> text = "a cat."

>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")

>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)

>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
GroundingDinoForObjectDetection
فئة transformers.GroundingDinoForObjectDetection
< source >( config: GroundingDinoConfig )
المعاملات
- config (GroundingDinoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Grounding DINO (المكوّن من هيكل أساسي ومحوّل مُشفِّر-مفكِّك) مع رؤوس كشف كائنات في الأعلى، لمهام مثل كشف COCO.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorinput_ids: LongTensortoken_type_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonepixel_mask: typing.Optional[torch.BoolTensor] = Noneencoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = Nonelabels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None**kwargs )
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام GroundingDinoImageProcessor. راجع GroundingDinoImageProcessor.call() للتفاصيل (GroundingDinoProcessor يستخدم GroundingDinoImageProcessor لمعالجة الصور). - input_ids (
torch.LongTensorبشكل(batch_size, text_sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا إذا قمت بتزويده.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع BertTokenizer.call() للحصول على التفاصيل.
- token_type_ids (
torch.LongTensorبشكل(batch_size, text_sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]: 0 تتوافق مع رمزsentence A، و1 تتوافق مع رمزsentence Bرمز - attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- pixel_mask (
torch.BoolTensorبشكل(batch_size, height, width), اختياري) — قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة من [0, 1]: 1 للبكسلات الحقيقية (أي غير المقنعة)، و0 للبكسلات المعبأة (أي المقنعة). ما هي أقنعة الانتباه؟[0, 1]:- 1 للبيكسلات الحقيقية (أي غير المقنّعة)،
- 0 للبيكسلات التي تمثل حشواً (أي مقنّعة).
- encoder_outputs (
Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple], اختياري) — يتألف الـ Tuple من (last_hidden_state, اختياري:hidden_states, اختياري:attentions)last_hidden_stateذو الشكل(batch_size, sequence_length, hidden_size), اختياري) هو تسلسل من حالات المخفية (hidden-states) عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) داخل المُفكِّك. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - labels (
list[Dict]بطول(batch_size,)، اختياري) — التسميات لحساب خسارة المطابقة الثنائية. قائمة من القواميس، يحتوي كل قاموس على الأقل على المفتاحين التاليين: ‘class_labels’ و ‘boxes’ (تسميات الفئات وصناديق الحدود لصورة في الدفعة على التوالي). يجب أن تكون تسميات الفئات نفسهاtorch.LongTensorبطول(number of bounding boxes in the image,)وأن تكون الصناديقtorch.Tensorبشكل(number of bounding boxes in the image, 4).
تُعيد طريقة GroundingDinoForObjectDetection الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
أمثلة:
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection

>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"

>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]

>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> results = processor.post_process_grounded_object_detection(
...     outputs,
...     threshold=0.4,
...     text_threshold=0.3,
...     target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
...     box = [round(x, 2) for x in box.tolist()]
...     print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]