
Transformers documentation
KOSMOS-2
نُشر هذا النموذج في أوراق HF في 26 يونيو 2023، وأُضيف إلى مكتبة Hugging Face Transformers في 30 أكتوبر 2023.
KOSMOS-2
نظرة عامة
قُدِّم نموذج KOSMOS-2 في Kosmos-2: Grounding Multimodal Large Language Models to the World من قِبل Zhiliang Peng وWenhui Wang وLi Dong وYaru Hao وShaohan Huang وShuming Ma وFuru Wei.
نموذج KOSMOS-2 هو نموذج لغة سببي مبني على بنية Transformer، وقد تم تدريبه باستخدام مهمة التنبؤ بالكلمة التالية على مجموعة بيانات واسعة النطاق من الويب تتكون من أزواج صور-نصوص مرتبطة GRIT. يتم تحويل الإحداثيات المكانية للمربعات المحيطة في مجموعة البيانات إلى تسلسل من رموز الموقع، والتي تُضاف إلى مقاطع النص الكيانية المقابلة لها (على سبيل المثال، a snowman يتبعه <patch_index_0044><patch_index_0863>). يشبه تنسيق البيانات "روابط فرعية" تربط مناطق الكائنات في الصورة بمقطع النص الخاص بها في الوصف المقابل.
المستخلص من الورقة البحثية هو كالتالي:
نقدّم Kosmos-2، وهو نموذج لغوي كبير متعدد الوسائط (MLLM)، يتيح قدرات جديدة في إدراك أوصاف الكائنات (مثل صناديق الحدود) وربط النص بالعالم البصري. على وجه التحديد، نمثّل عبارات الإشارة كرابط في Markdown، أي “[نطاق النص](صناديق الحدود)”, حيث تكون أوصاف الكائنات تسلسلات من رموز الموقع. إلى جانب مجموعات البيانات متعددة الوسائط، نبني بيانات واسعة النطاق من أزواج الصور والنصوص المرتبطة (تُسمى GrIT) لتدريب النموذج. بالإضافة إلى القدرات الحالية لنماذج MLLM (مثل إدراك الوسائط العامة، واتباع التعليمات، وأداء التعلم في السياق)، يدمج Kosmos-2 قدرة الربط في التطبيقات الفرعية. نقيّم Kosmos-2 على مجموعة واسعة من المهام، بما في ذلك (i) الربط متعدد الوسائط، مثل فهم عبارات الإشارة، والربط العباراتي، (ii) الإشارة متعددة الوسائط، مثل توليد عبارات الإشارة، (iii) مهام الإدراك واللغة، و(iv) فهم اللغة وتوليدها. تهيّئ هذه الدراسة الأساس لتطوير الذكاء الاصطناعي المتجسد، وتسلّط الضوء على التقارب الكبير بين اللغة والإدراك متعدد الوسائط والإجراء ونمذجة العالم، وهو خطوة أساسية نحو الذكاء الاصطناعي العام. الكود والنماذج المُسبقة التدريب متاحة على https://aka.ms/kosmos-2.
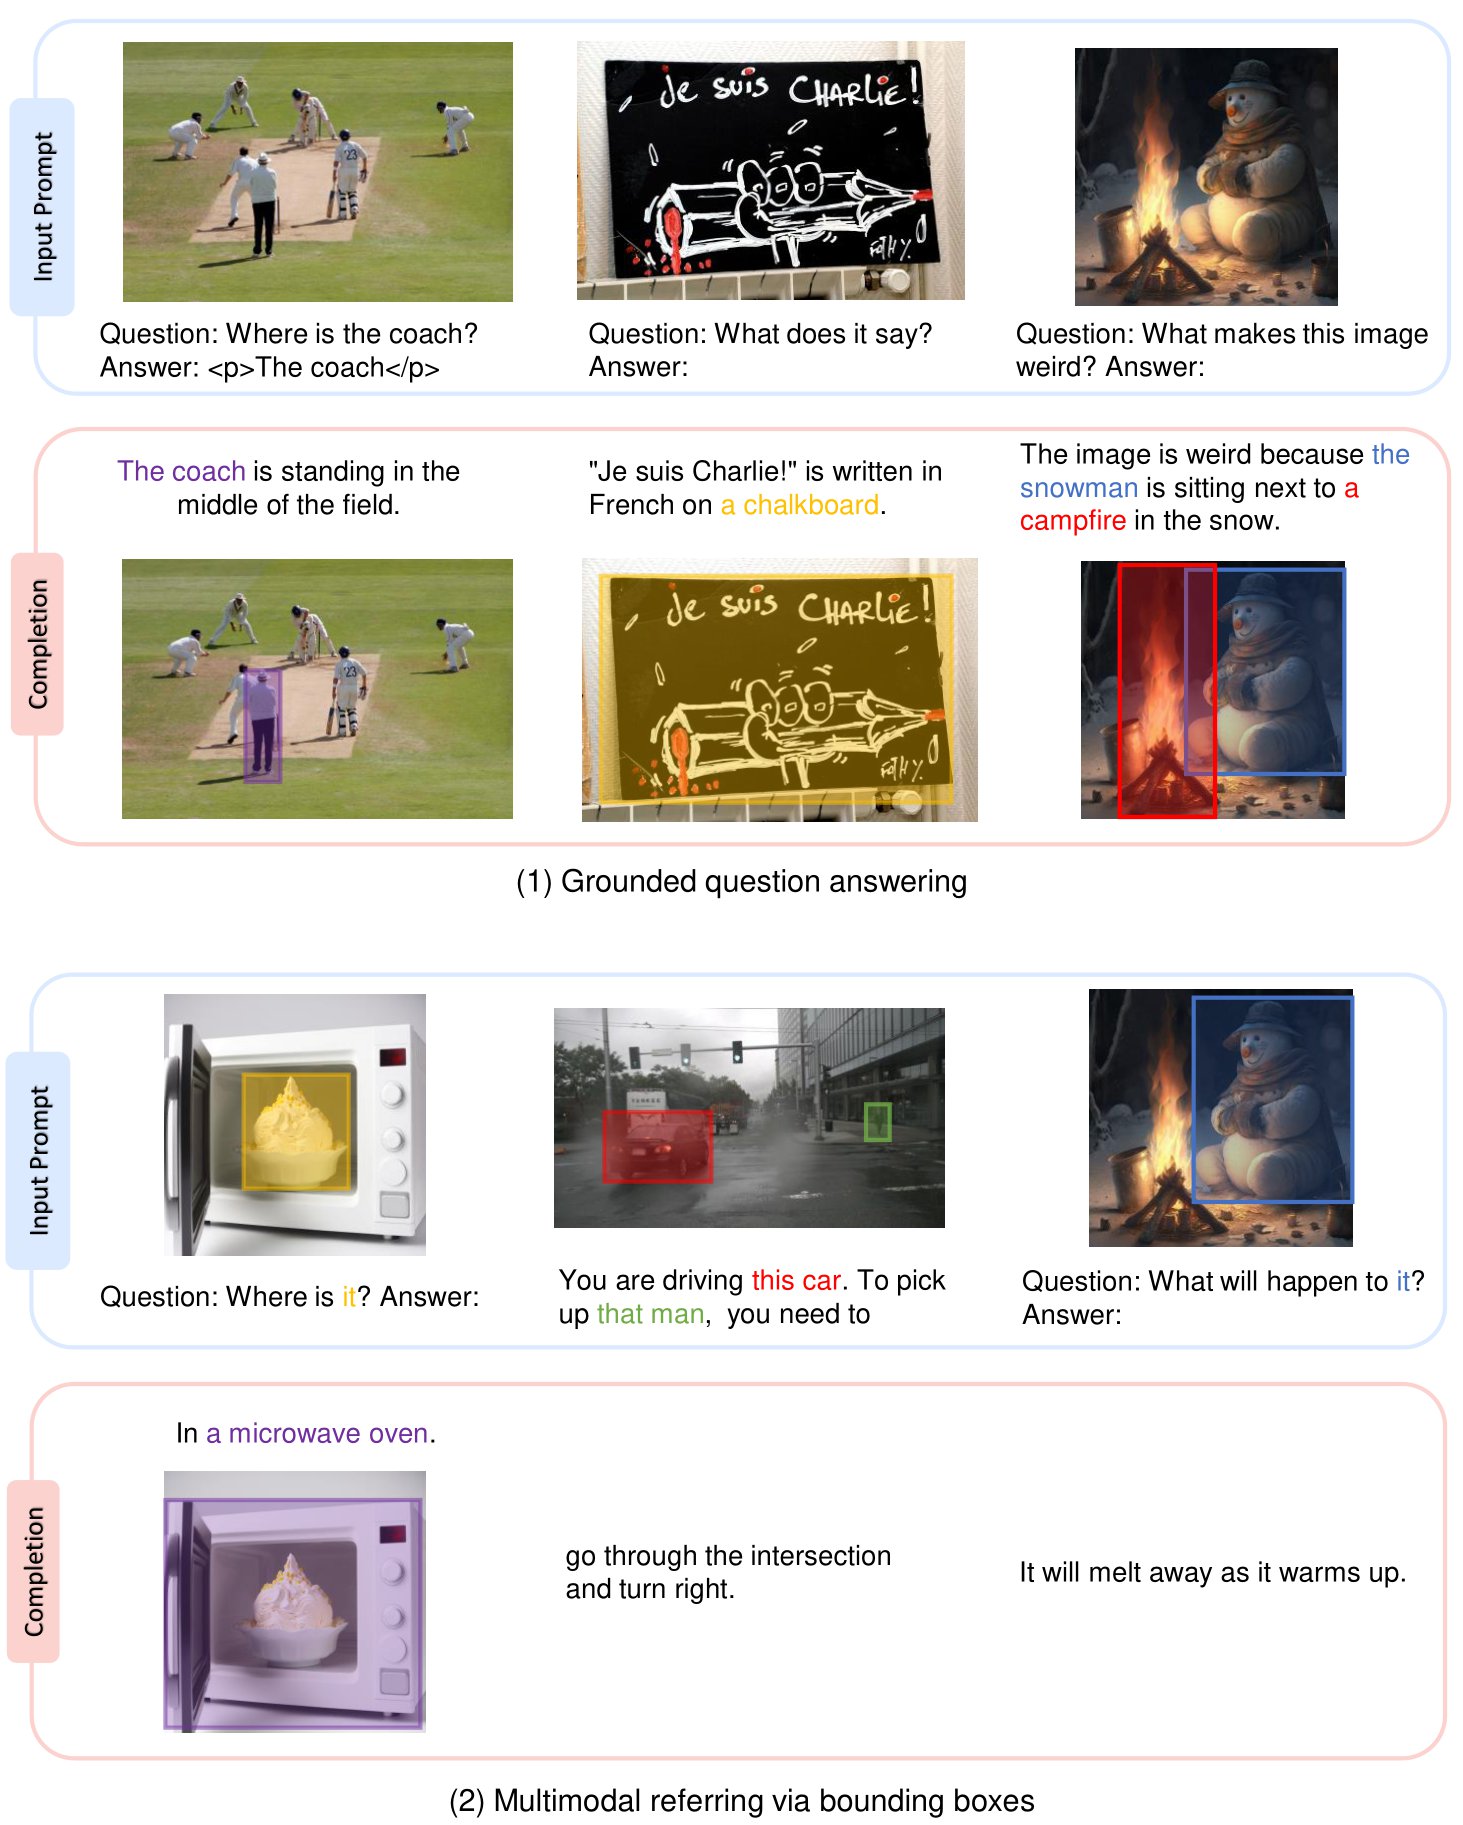 Overview of tasks that KOSMOS-2 can handle. Taken from the original paper.
مثال
import requests
from PIL import Image

from transformers import AutoProcessor, Kosmos2ForConditionalGeneration


model = Kosmos2ForConditionalGeneration.from_pretrained("microsoft/kosmos-2-patch14-224", device_map="auto")
processor = AutoProcessor.from_pretrained("microsoft/kosmos-2-patch14-224")

url = "https://huggingface.co/microsoft/kosmos-2-patch14-224/resolve/main/snowman.jpg"
image = Image.open(requests.get(url, stream=True).raw)

prompt = "<grounding> An image of"

inputs = processor(text=prompt, images=image, return_tensors="pt").to(model.device)

generated_ids = model.generate(
    pixel_values=inputs["pixel_values"],
    input_ids=inputs["input_ids"],
    attention_mask=inputs["attention_mask"],
    image_embeds=None,
    image_embeds_position_mask=inputs["image_embeds_position_mask"],
    use_cache=True,
    max_new_tokens=64,
)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
processed_text = processor.post_process_generation(generated_text, cleanup_and_extract=False)
processed_text
'<grounding> An image of<phrase> a snowman</phrase><object><patch_index_0044><patch_index_0863></object> warming himself by<phrase> a fire</phrase><object><patch_index_0005><patch_index_0911></object>.'

caption, entities = processor.post_process_generation(generated_text)
caption
'An image of a snowman warming himself by a fire.'

entities
[('a snowman', (12, 21), [(0.390625, 0.046875, 0.984375, 0.828125)]), ('a fire', (41, 47), [(0.171875, 0.015625, 0.484375, 0.890625)])]
تمت مساهمة هذا النموذج من قِبل Yih-Dar SHIEH. يمكن العثور على الكود الأصلي هنا.
Kosmos2Config
فئة transformers.Kosmos2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonelatent_query_num: int = 64tie_word_embeddings: bool = True )
المعاملات
- text_config (
Union[dict, ~configuration_utils.PreTrainedConfig]، اختياري) — كائن الإعدادات أو قاموس العمود الفقري النصي. - vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — كائن الإعدادات أو قاموس العمود الفقري البصري. - latent_query_num (
int، اختياري، القيمة الافتراضية 64) — عدد رموز الاستعلام الكامنة التي تمثل ميزات الصورة المستخدمة في مكوّن فك ترميز النص. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Kosmos2Model. تُستخدم لاستحداث نموذج Kosmos2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/kosmos-2-patch14-224
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import Kosmos2Config, Kosmos2Model

>>> # Initializing a Kosmos-2 kosmos-2-patch14-224 style configuration
>>> configuration = Kosmos2Config()

>>> # Initializing a model (with random weights) from the kosmos-2-patch14-224 style configuration
>>> model = Kosmos2Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Kosmos2TextConfig
فئة transformers.Kosmos2TextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 65037max_position_embeddings: int = 2048embed_dim: int = 2048layers: int = 24ffn_dim: int = 8192attention_heads: int = 32activation_function: str = 'gelu'dropout: float | int = 0.1attention_dropout: float | int = 0.1activation_dropout: float | int = 0.0layerdrop: float | int = 0.0layer_norm_eps: float = 1e-05init_std: float = 0.02scale_embedding: bool = Trueuse_cache: bool = Truetie_word_embeddings: bool = Truepad_token_id: int | None = 1bos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2add_cross_attention: bool = False )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية65037) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - max_position_embeddings (
int، اختياري، القيمة الافتراضية2048) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج. - embed_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد التضمينات والحالات المخفية. - layers (
int، اختياري، القيمة الافتراضية24) — عدد الطبقات المخفية في مُفكِّك Transformer. - ffn_dim (
int، اختياري، القيمة الافتراضية8192) — بعد تمثيلات MLP. - attention_heads (
int، اختياري، القيمة الافتراضية32) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - activation_function (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — النسبة لجميع طبقات dropout. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - activation_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة dropout للتفعيلات داخل الطبقة المتصلة بالكامل. - layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية LayerDrop. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - init_std (
float، اختياري، القيمة الافتراضية0.02) — انحراف معياري لمُهيّئ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - scale_embedding (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم توسيع التضمينات (embeddings) من خلال القسمة على sqrt(d_model). - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج. - pad_token_id (
int، اختياري، القيمة الافتراضية1) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int, اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]]، اختياري، القيمة الافتراضية2) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - add_cross_attention (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة طبقات الانتباه المتقاطع إلى النموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Kosmos2Model. تُستخدم لاستحداث نموذج Kosmos2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/kosmos-2-patch14-224
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
Kosmos2VisionConfig
فئة transformers.Kosmos2VisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1024intermediate_size: int = 4096num_hidden_layers: int = 24num_attention_heads: int = 16num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 14hidden_act: str = 'quick_gelu'layer_norm_eps: float = 1e-05attention_dropout: float | int = 0.0initializer_range: float = 0.02initializer_factor: float = 1.0 )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية1024) — أبعاد التمثيلات المخفية. - intermediate_size (
int، اختياري، القيمة الافتراضية4096) — أبعاد تمثيلات MLP. - num_hidden_layers (
int، اختياري، القيمة الافتراضية24) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية14) — حجم (دقة) كل رقعة. - hidden_act (
str، اختياري، القيمة الافتراضيةquick_gelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - initializer_factor (
float، اختياري، القيمة الافتراضية1.0) — عامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
هذه فئة الإعدادات المخزنة لإعدادات نموذج Kosmos2Model. تُستخدم لاستحداث نموذج Kosmos2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/kosmos-2-patch14-224
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
Kosmos2Processor
فئة transformers.Kosmos2Processor
< source >( image_processortokenizernum_patch_index_tokens = 1024*kwargs )
ينشئ Kosmos2Processor الذي يجمع معالج الصور ومعالج الرموز في معالج واحد.
يوفر Kosmos2Processor جميع وظائف image_processor_class وtokenizer_class. راجع ~image_processor_class و~tokenizer_class لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] = None**kwargs: *<class 'transformers.models.kosmos2.processing_kosmos2.Kosmos2ProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - text (
Union[str, list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى رموز). إذا مررت مدخلًا مُقسَّمًا مسبقًا إلى رموز، فاضبطis_split_into_words=Trueلتجنب الغموض مع المدخلات الدفعية. - add_eos_token (
bool، kwargs، القيمة الافتراضيةFalse) — ما إذا كان يجب تضمين معرّف رمزEOSفي الترميز عندadd_special_tokens=True. - bboxes (
Union[list[tuple[int]], *kwargs*, list[tuple[float]], list[list[tuple[int]]], list[list[tuple[float]]]]، اختياري) — صناديق الحدود المرتبطة بـtexts. - num_image_tokens (
int، kwargs، اختياري، القيمة الافتراضية 64) — عدد المواضع (المتتالية) المستخدمة لوضع العلامات على الأماكن المخصصة لتخزين معلومات الصورة. يجب أن تكون هذه القيمة مطابقة لقيمةlatent_query_numفي نسخةKosmos2Configالتي تستخدمها. - first_image_token_id (
int، kwargs، اختياري) — معرّف الرمز الذي سيُستخدم في الموقع الأول من التسلسل الفرعي المخصص لتخزين معلومات الصورة. إذا لم يُضبط، فسيُستخدمself.tokenizer.unk_token_id + 1افتراضيًا. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
Kosmos2Model
فئة transformers.Kosmos2Model
< source >( config: Kosmos2Config )
المعاملات
- config (Kosmos2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج KOSMOS-2 لتوليد ميزات النص والصورة. يتكون النموذج من مشفر بصري ونموذج لغوي.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_ids: typing.Optional[torch.Tensor] = Noneimage_embeds_position_mask: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneimage_embeds: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Kosmos2ModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدامimage_processor_class. راجعimage_processor_class.__call__للتفاصيل (processor_classيستخدمimage_processor_classلمعالجة الصور). - input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- image_embeds_position_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع يُحدد الموقع داخل التسلسل الذي يجب إدراج ميزات الصورة فيه. القيم المختارة للقناع من[0, 1]:- 1 في الأماكن التي يجب وضع ميزات الصورة فيها،
- 0 للمواقع التي لا تخص ميزات الصورة (أي لرموز النص).
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - image_embeds (
torch.Tensorمن الشكل(batch_size, latent_query_num, hidden_size)، اختياري) — تسلسل من حالات الإخفاء (hidden-states) عند مخرجKosmos2ImageToTextProjection. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
Kosmos2ModelOutput أو tuple(torch.Tensor)
Kosmos2ModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Kosmos2Config) والمدخلات.
تتجاوز طريقة Kosmos2Model الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.past_key_values (
~cache_utils.Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عندconfig.use_cache=True) — إنه كائن من Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
image_embeds (
torch.Tensorمن الشكل(batch_size, latent_query_num, hidden_size)، اختياري) — تسلسل من حالات الإخفاء (hidden-states) عند مخرجKosmos2ImageToTextProjection.projection_attentions (
tuple(torch.Tensor)، اختياري) — مجموعة منtorch.Tensor(واحدة لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه التي يمنحها
Kosmos2ImageToTextProjection، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.vision_model_output (
BaseModelOutputWithPooling، اختياري) — مخرجاتKosmos2VisionModel.
أمثلة:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Kosmos2Model

>>> model = Kosmos2Model.from_pretrained("microsoft/kosmos-2-patch14-224")
>>> processor = AutoProcessor.from_pretrained("microsoft/kosmos-2-patch14-224")

>>> url = "https://huggingface.co/microsoft/kosmos-2-patch14-224/resolve/main/snowman.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> text = (
...     "<grounding> An image of<phrase> a snowman</phrase><object><patch_index_0044><patch_index_0863>"
...     "</object> warming himself by<phrase> a fire</phrase><object><patch_index_0005><patch_index_0911>"
...     "</object>"
... )

>>> inputs = processor(text=text, images=image, return_tensors="pt", add_eos_token=True)

>>> last_hidden_state = model(
...     pixel_values=inputs["pixel_values"],
...     input_ids=inputs["input_ids"],
...     attention_mask=inputs["attention_mask"],
...     image_embeds_position_mask=inputs["image_embeds_position_mask"],
... ).last_hidden_state
>>> list(last_hidden_state.shape)
[1, 91, 2048]
get_image_features
< source >( pixel_values: Tensorinterpolate_pos_encoding: bool | None = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithProjectionAttentions or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسلات باستخدامimage_processor_class. راجعimage_processor_class.__call__للتفاصيل (processor_classيستخدمimage_processor_classلمعالجة الصور). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
BaseModelOutputWithProjectionAttentions أو tuple(torch.Tensor)
BaseModelOutputWithProjectionAttentions أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (Kosmos2Config) والمدخلات.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
projection_attentions (
tuple(torch.Tensor)) — مجموعة منtorch.Tensor(واحدة لكل طبقة) ذات الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه التي يمنحها
Kosmos2ImageToTextProjection، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
Kosmos2ForConditionalGeneration
فئة transformers.Kosmos2ForConditionalGeneration
< source >( config: Kosmos2Config )
المعاملات
- config (Kosmos2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج KOSMOS-2 لتوليد النص وصناديق الحدود بناءً على صورة. يتكون النموذج من مشفر بصري ونموذج لغوي.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_ids: typing.Optional[torch.Tensor] = Noneimage_embeds_position_mask: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneimage_embeds: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Kosmos2ForConditionalGenerationModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدامimage_processor_class. راجعimage_processor_class.__call__للتفاصيل (processor_classيستخدمimage_processor_classلمعالجة الصور). - input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- image_embeds_position_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع يُحدد الموقع داخل التسلسل الذي يجب إدراج ميزات الصورة فيه. القيم المختارة للقناع من[0, 1]:- 1 في الأماكن التي يجب وضع ميزات الصورة فيها،
- 0 للمواقع التي لا تخص ميزات الصورة (أي لرموز النص).
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - image_embeds (
torch.Tensorمن الشكل(batch_size, latent_query_num, hidden_size)، اختياري) — تسلسل من حالات الإخفاء (hidden-states) عند مخرجKosmos2ImageToTextProjection. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة من اليسار إلى اليمين (توقع الكلمة التالية). يجب أن تكون الفهارس ضمن[-100, 0, ..., config.vocab_size](انظرinput_idsdocstring). يتم تجاهل الرموز (tokens) التي فهارسها مضبوطة على-100(قناعها)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size] - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - logits_to_keep (
Union[int, torch.Tensor]، اختياري، القيمة الافتراضية0) — إذا كانint، يتم حساب logits لآخرlogits_to_keepرموز. إذا كانت القيمة0، يتم حساب logits لجميعinput_ids(حالة خاصة). لا يُحتاج إلى logits إلا للرمز الأخير في عملية التوليد، ويمكن أن يوفر حسابها لذلك الرمز وحده ذاكرة كبيرة، وهو أمر مهم بشكل ملحوظ للتسلسلات الطويلة أو حجم المفردات الكبير. إذا كانtorch.Tensor، يجب أن يكون بعدًا واحدًا (1D) ويتوافق مع الفهارس التي يجب الاحتفاظ بها في بُعد طول التسلسل. يكون هذا مفيدًا عند استخدام تنسيق المصفوفات المعبأة (packed tensor format) (بعد واحد لكل من الدفعة وطول التسلسل).
يعيد
Kosmos2ForConditionalGenerationModelOutput أو tuple(torch.Tensor)
Kosmos2ForConditionalGenerationModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر
مختلفة اعتمادًا على الإعداد (Kosmos2Config) والمدخلات.
تُعيد طريقة Kosmos2ForConditionalGeneration الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).past_key_values (
~cache_utils.Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عندconfig.use_cache=True) — إنه كائن من Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
image_embeds (
torch.Tensorمن الشكل(batch_size, latent_query_num, hidden_size)، اختياري) — تسلسل من حالات الإخفاء (hidden-states) عند مخرجKosmos2ImageToTextProjection.projection_attentions (
tuple(torch.Tensor)، اختياري) — مجموعة منtorch.Tensor(واحدة لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه التي يمنحها
Kosmos2ImageToTextProjection، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.vision_model_output (
BaseModelOutputWithPooling، اختياري) — مخرجاتKosmos2VisionModel.
أمثلة:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Kosmos2ForConditionalGeneration

>>> model = Kosmos2ForConditionalGeneration.from_pretrained("microsoft/kosmos-2-patch14-224")
>>> processor = AutoProcessor.from_pretrained("microsoft/kosmos-2-patch14-224")

>>> url = "https://huggingface.co/microsoft/kosmos-2-patch14-224/resolve/main/snowman.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> prompt = "<grounding> An image of"

>>> inputs = processor(text=prompt, images=image, return_tensors="pt")

>>> generated_ids = model.generate(
...     pixel_values=inputs["pixel_values"],
...     input_ids=inputs["input_ids"],
...     attention_mask=inputs["attention_mask"],
...     image_embeds=None,
...     image_embeds_position_mask=inputs["image_embeds_position_mask"],
...     use_cache=True,
...     max_new_tokens=64,
... )
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> processed_text = processor.post_process_generation(generated_text, cleanup_and_extract=False)
>>> processed_text
'<grounding> An image of<phrase> a snowman</phrase><object><patch_index_0044><patch_index_0863></object> warming himself by<phrase> a fire</phrase><object><patch_index_0005><patch_index_0911></object>.'

>>> caption, entities = processor.post_process_generation(generated_text)
>>> caption
'An image of a snowman warming himself by a fire.'

>>> entities
[('a snowman', (12, 21), [(0.390625, 0.046875, 0.984375, 0.828125)]), ('a fire', (41, 47), [(0.171875, 0.015625, 0.484375, 0.890625)])]