
Transformers documentation
BEiT
نُشر هذا النموذج في أوراق HF في 15 يونيو 2021، وسُهم به إلى مكتبة Hugging Face Transformers في 4 أغسطس 2021.
BEiT

نظرة عامة
قُدِّم نموذج BEiT في BEiT: BERT Pre-Training of Image Transformers بواسطة Hangbo Bao و Li Dong و Furu Wei. مستوحىً من BERT، يُعد BEiT أول ورقة بحثية تجعل التدريب المسبق غير المُشرَّب ذاتياً لنماذج Vision Transformers (ViTs) يتفوق على التدريب المسبق المُشرَّب. بدلاً من تدريب النموذج مسبقاً للتنبؤ بفئة الصورة (كما تم في ورقة ViT الأصلية)، تُدرَّب نماذج BEiT مسبقاً لتنبؤ بالرموز البصرية من دفتر رموز نموذج DALL-E الخاص بـ OpenAI، وذلك بناءً على رقعات مقنّعة.
المستخلص من الورقة البحثية هو كالتالي:
نقدّم نموذج تمثيل بصري ذاتي الإشراف باسم BEiT، وهو اختصار لـ Bidirectional Encoder representation from Image Transformers. متّبعين نهج BERT المطوَّر في مجال معالجة اللغة الطبيعية، نقترح مهمة نمذجة الصور المقنّعة (masked image modeling) لتدريب مسبق لتحويلات الرؤية (vision Transformers). تحديداً، لكل صورة في تدريبنا المسبق عرضان، وهما: رقعات الصورة (image patches، مثل 16x16 بكسل)، ورموز بصرية (visual tokens، أي رموز منفصلة). أولاً، نقوم بـ «ترميز» الصورة الأصلية إلى رموز بصرية. ثم نقنّع عشوائياً بعض رقعات الصورة ونمررها إلى المحوّل الأساسي (backbone Transformer). هدف التدريب المسبق هو استعادة الرموز البصرية الأصلية بناءً على رقعات الصورة التالفة. بعد التدريب المسبق لـ BEiT، نضبط النموذج مباشرةً على المهام التالية (downstream tasks) عن طريق إضافة طبقات المهمة فوق المُشفِّر المُدرَّب مسبقاً. تُظهر النتائج التجريبية على تصنيف الصور والتجزئة الدلالية (semantic segmentation) أن نموذجنا يحقق نتائج تنافسية مع طرق التدريب المسبق السابقة. على سبيل المثال، يحقق BEiT بحجم الأساس (base-size) دقة 83.2% في التصنيف الأول (top-1) على ImageNet-1K، متفوقاً بشكل كبير على تدريب DeiT من الصفر (81.8%) مع نفس الإعداد. علاوة على ذلك، يحصل BEiT بحجم كبير (large-size) على 86.3% باستخدام ImageNet-1K فقط، متفوقاً حتى على ViT-L مع التدريب المسبق المُشرَف عليه على ImageNet-22K (85.2%).
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- نماذج BEiT هي محولات رؤية (Vision Transformers) عادية، لكنها مُدرَّبة مسبقاً بطريقة ذاتية الإشراف بدلاً من الإشراف. تتفوق هذه النماذج على كل من النموذج الأصلي (ViT) ومحولات الصور الموفرة للبيانات (DeiT) عند ضبطها الدقيق على ImageNet-1K وCIFAR-100. يمكنك الاطلاع على دفاتر ملاحظات تجريبية تتعلق بالاستدلال (inference) وكذلك الضبط الدقيق على بيانات مخصصة هنا (يمكنك ببساطة استبدال ViTImageProcessor بـ BeitImageProcessor وViTForImageClassification بـ BeitForImageClassification).
- يتوفر أيضاً دفتر ملاحظات تجريبي يوضح كيفية دمج مُرمِّز الصور الخاص بـ DALL-E مع BEiT لأداء نمذجة الصور المقنّعة. يمكنك العثور عليه هنا.
- بما أن نماذج BEiT تتوقع أن تكون جميع الصور بنفس الحجم (الدقة)، يمكن استخدام BeitImageProcessor لتغيير حجم الصور (أو إعادة تحجيمها) وتطبيعها للنموذج.
- تُنعكس كلٌّ من دقة البقعة ودقة الصورة المستخدمتين أثناء التدريب المسبق أو الضبط الدقيق في اسم كل نقطة تفتيش. على سبيل المثال، يشير
microsoft/beit-base-patch16-224إلى بنية ذات حجم أساسي مع دقة بقعة 16x16 ودقة ضبط دقيق 224x224. يمكن العثور على جميع نقاط التفتيش على المركز. - النقاط المحفوظة المتاحة إما (1) مُدرَّبة مسبقًا على ImageNet-22k (مجموعة من 14 مليون صورة و22 ألف فئة) فقط، أو (2) مُدرَّبة مسبقًا على ImageNet-22k ثم مُعدَّلة عليها، أو (3) مُدرَّبة مسبقًا على ImageNet-22k ثم مُعدَّلة على ImageNet-1k (المعروف أيضًا باسم ILSVRC 2012، وهو مجموعة من 1.3 مليون صورة و1,000 فئة).
- يستخدم BEiT تضمينات مواقع نسبية، مستوحاة من نموذج T5. خلال التدريب المسبق، شارك المؤلفون انحياز الموقع النسبي بين طبقات الانتباه الذاتي المتعددة. أثناء الضبط الدقيق، يتم تهيئة انحياز الموقع النسبي لكل طبقة باستخدام انحياز الموقع النسبي المشترك الذي تم الحصول عليه بعد التدريب المسبق. يُرجى ملاحظة أنه إذا أراد المرء تدريب نموذج مسبقاً من الصفر، فيجب عليه إما تعيين
use_relative_position_biasأو خاصيةuse_relative_position_biasالخاصة بـ BeitConfig إلىTrueمن أجل إضافة تضمينات المواقع.
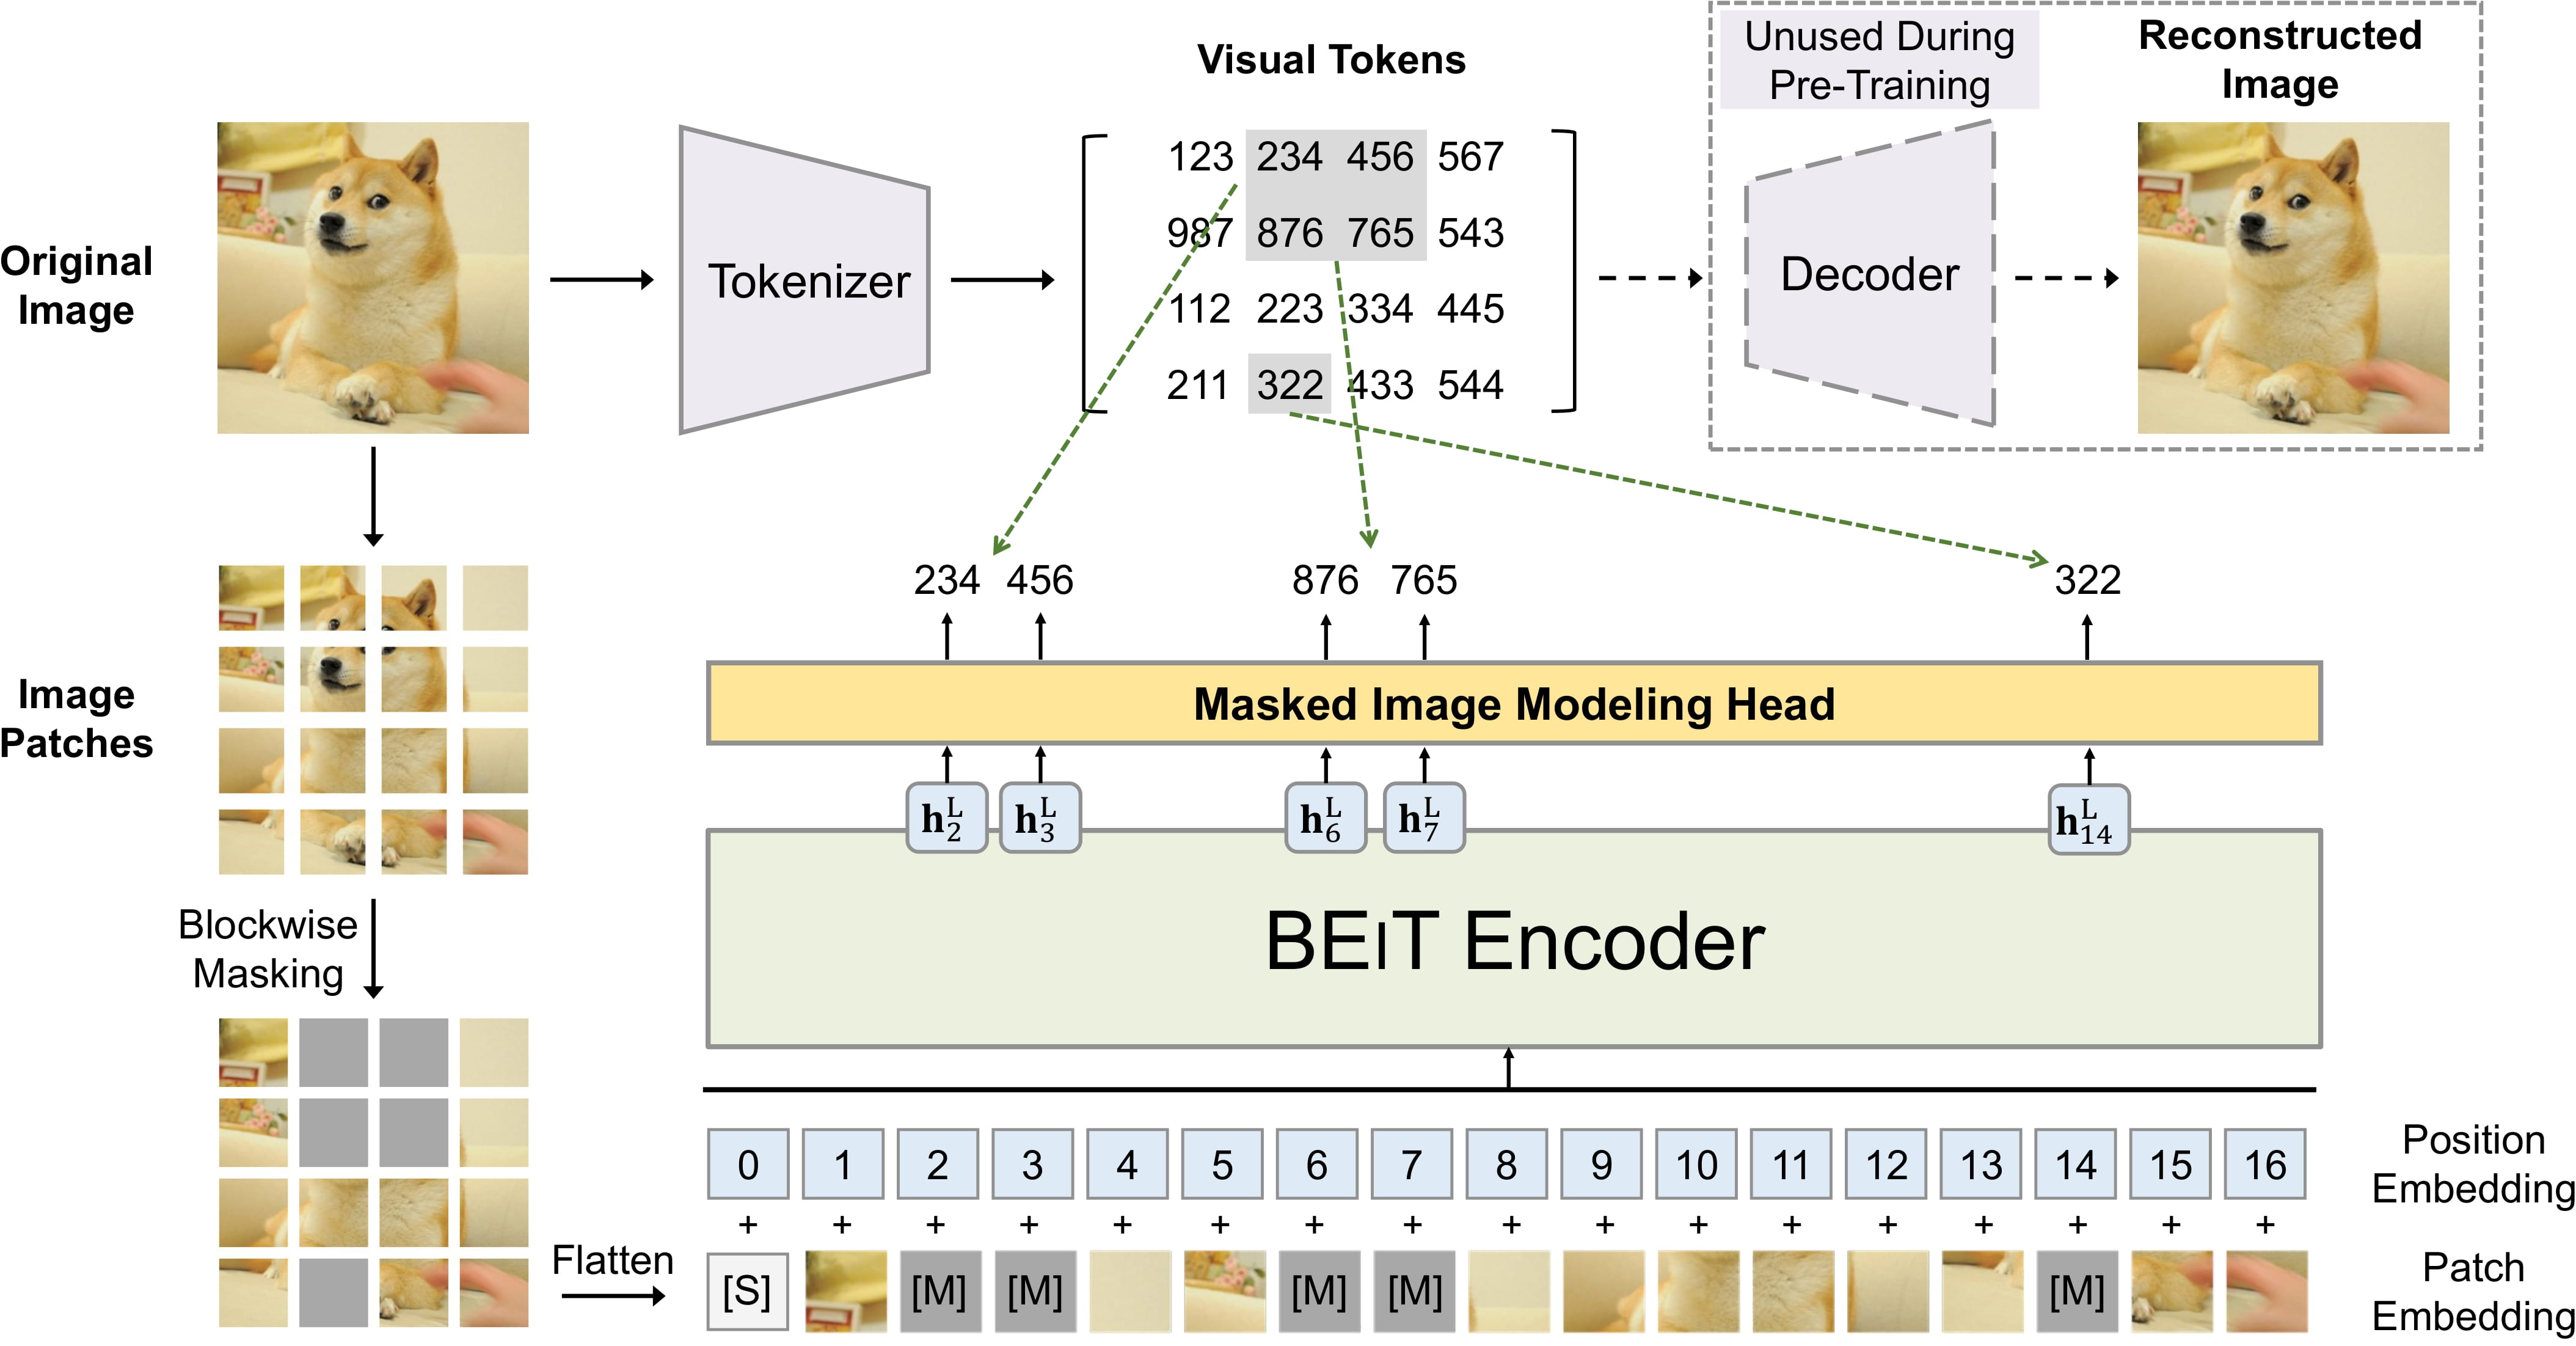 BEiT pre-training. Taken from the original paper.
استخدام الانتباه القياسي بنقطة منتج
يتضمن PyTorch مُشغّلًا أصليًا للانتباه بنقطة جدولية مُقيّمة (SDPA) كجزء من torch.nn.functional. تشمل هذه الدالة عدة تطبيقات يمكن تطبيقها اعتمادًا على المدخلات والعتاد المستخدم. راجع التوثيق الرسمي أو صفحة GPU Inference لمزيد من المعلومات.
يُستخدم SDPA افتراضيًا لـ torch>=2.1.1 عندما تكون هناك نسخة تنفيذية متاحة، لكن يمكنك أيضًا تعيين attn_implementation="sdpa" في from_pretrained() لطلب استخدام SDPA بشكل صريح.
from transformers import BeitForImageClassification


model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
للحصول على أفضل تسارعات، ننصح بتحميل النموذج بدقة نصفية (مثل torch.float16 أو torch.bfloat16).
في معيار محلي (NVIDIA GeForce RTX 2060-8GB، PyTorch 2.5.1، نظام التشغيل Ubuntu 20.04) باستخدام float16 ونموذج microsoft/beit-base-patch16-224، لاحظنا التحسينات التالية أثناء التدريب والاستدلال:
التدريب
| num_training_steps | batch_size | image_size | is_cuda | الوقت لكل دفعة (eager - ث) | الزمن لكل دفعة (sdpa - ث) | السرعة (%) | ذروة الذاكرة العاجلة (ميغابايت) | ذروة ذاكرة SDPA (ميغابايت) | توفير الذاكرة (%) |
|---|---|---|---|---|---|---|---|---|---|
| 50 | 2 | (1048, 640) | صحيح | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
الاستدلال
| حجم دفعة الصور | مباشر (ثانية/تكرار) | CI الفوري، % | الذاكرة العاجلة (ميغابايت) | SDPA (ثانية/تكرار) | CI لـ SDPA، % | ذاكرة SDPA (ميغابايت) | تسريع SDPA | الذاكرة المحفوظة بواسطة SDPA (٪) |
|---|---|---|---|---|---|---|---|---|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
الموارد
قائمة بالموارد الرسمية من Hugging Face وموارد المجتمع (المشار إليها بـ 🌎) لمساعدتك على البدء باستخدام BEiT.
- يُؤمَّن دعم BeitForImageClassification من خلال هذا دفتر ملاحظات.
- انظر أيضاً: دليل مهمة تصنيف الصور
التجزئة الدلالية
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
المخرجات الخاصة بـ BEiT
فئة transformers.models.beit.modeling_beit.BeitModelOutputWithPooling
< source >( last_hidden_state: typing.Optional[torch.Tensor] = Nonepooler_output: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor, ...] | None = Noneattentions: tuple[torch.Tensor, ...] | None = None )
المعاملات
- last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات الخفاء عند مخرجات الطبقة الأخيرة من النموذج. - pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — متوسط حالات الإخفاء للطبقة الأخيرة لرموز الباتش (باستثناء رمز [CLS]) إذا تم تعيين config.use_mean_pooling إلى True. إذا تم تعيينه إلى False، فسيتم إرجاع حالة الإخفاء النهائية لرمز [CLS]. - hidden_states (
tuple(torch.Tensor), اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple(torch.Tensor), اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
فئة لمخرجات BeitModel.
BeitConfig
فئة transformers.BeitConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 8192hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0initializer_range: float = 0.02layer_norm_eps: float = 1e-12image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3use_mask_token: bool = Falseuse_absolute_position_embeddings: bool = Falseuse_relative_position_bias: bool = Falseuse_shared_relative_position_bias: bool = Falselayer_scale_init_value: float = 0.1drop_path_rate: float | int = 0.1use_mean_pooling: bool = Truepool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6)use_auxiliary_head: bool = Trueauxiliary_loss_weight: float = 0.4auxiliary_channels: int = 256auxiliary_num_convs: int = 1auxiliary_concat_input: bool = Falsesemantic_loss_ignore_index: int = 255_out_features: list[str] | None = None_out_indices: list[int] | None = Noneadd_fpn: bool = Falsereshape_hidden_states: bool = True )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية8192) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - use_mask_token (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام رمز قناع لنمذجة الصور المقنّعة. - use_absolute_position_embeddings (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام تضمينات الموضع المطلق. - use_relative_position_bias (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام تضمينات الموضع النسبي بنمط T5 في طبقات الانتباه الذاتي. - use_shared_relative_position_bias (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام تضمينات الموضع النسبي نفسها عبر جميع طبقات الانتباه الذاتي في نموذج Transformers. - layer_scale_init_value (
float, اختياري، القيمة الافتراضية0.1) — المعامل المُستخدَم في طبقات الانتباه الذاتي. القيمة 0.1 للنماذج الأساسية، و1e-6 للنماذج الكبيرة. اضبط القيمة على 0 لتعطيل معامل الطبقة. - drop_path_rate (
Union[float, int], اختياري، القيمة الافتراضية0.1) — معدل إسقاط المسار (Drop path) لدمج البقع (patch fusion). - use_mean_pooling (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب استخدام متوسط تجميع الحالات المخفية النهائية للرقع بدلاً من استخدام الحالة المخفية النهائية لرمز CLS، قبل تطبيق رأس التصنيف. - pool_scales (
tuple[int]، اختياري، القيمة الافتراضية[1, 2, 3, 6]) — مقاييس التجميع المستخدمة في وحدة هرم التجميع المطبقة على خريطة الميزات الأخيرة. - use_auxiliary_head (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام رأس مساعد أثناء التدريب. - auxiliary_loss_weight (
float، اختياري، القيمة الافتراضية 0.4) — وزن دالة الخسارة المتقاطعة (cross-entropy loss) للرأس المساعد. - auxiliary_channels (
int، اختياري، القيمة الافتراضية 256) — عدد القنوات المستخدمة في الرأس المساعد. - auxiliary_num_convs (
int، اختياري، القيمة الافتراضية 1) — عدد طبقات الالتفاف المستخدمة في الرأس المساعد. - auxiliary_concat_input (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب دمج مخرج الرأس المساعد مع المدخل قبل طبقة التصنيف. - semantic_loss_ignore_index (
int، اختياري، القيمة الافتراضية255) — المؤشر الذي تتجاهله دالة الخسارة في نموذج التقسيم الدلالي. - add_fpn (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة FPN كجزء من الهيكل العظمي (backbone). ينطبق هذا فقط علىBeitBackbone. - reshape_hidden_states (
bool، اختياري، القيمة الافتراضيةTrue) — هل يُعاد تشكيل خرائط الميزات إلى متجهات رباعية الأبعاد من الشكل(batch_size, hidden_size, height, width)في حالة استخدام النموذج كهيكل أساسي. إذا كانت القيمةFalse، فستكون خرائط الميزات متجهات ثلاثية الأبعاد من الشكل(batch_size, seq_len, hidden_size). ينطبق هذا فقط علىBeitBackbone.
هذه فئة الإعدادات المخزنة لإعدادات BeitModel. تُستخدم لاستنساخ نموذج Beit وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/beit-base-patch16-224-pt22k
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import BeitConfig, BeitModel

>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()

>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BeitImageProcessor
فئة transformers.BeitImageProcessor
< source >( **kwargs: *<class 'transformers.models.beit.image_processing_beit.BeitImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية3) — مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enumPILImageResampling. لا يؤثر إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
ينشئ معالج صور من نوع BeitImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.beit.image_processing_beit.BeitImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقسيم المراد معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
المعاملات
- outputs (BeitForSemanticSegmentation) — المخرجات الخام للنموذج.
- target_sizes (
list[Tuple]بطولbatch_size، اختياري) — قائمة من الأ_tuples المقابلة للحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا لم يتم ضبطه، فلن يتم تغيير حجم التنبؤات. - return_segmentation_scores (
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع درجات التقسيم (segmentation scores) إلى جانب خريطة التقسيم. عند تعيينTrue، يكون كل عنصر من القائمة المُرجعة من نوعSemanticSegmentationPostProcessorOutputويحتوي على الحقولsegmentation(معرّفات الفئات، الشكل(height, width)) وsegmentation_scores(الشكل(num_classes, height, width)).
يعيد
list[torch.Tensor] أو list[SemanticSegmentationPostProcessorOutput]
عندما يكون return_segmentation_scores=False (الافتراضي)، تكون النتيجة قائمة بطول batch_size حيث يكون كل عنصر منها خريطة تجزئة (segmentation map) بأبعاد (height, width) تحتوي على معرّفات الفئات. أما عندما يكون return_segmentation_scores=True، فتكون النتيجة قائمة من SemanticSegmentationPostProcessorOutput تحتوي على الحقول segmentation (معرّفات الفئات، بأبعاد (height, width)) وsegmentation_scores (بأبعاد (num_classes, height, width)). في الحالتين، يمثل (height, width) الحجم المستهدف (إذا تم تحديد target_sizes).
يحوّل مخرجات BeitForSemanticSegmentation إلى خرائط تجزئة دلالية.
BeitImageProcessorPil
فئة transformers.BeitImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.beit.image_processing_pil_beit.BeitImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية3) — مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enumPILImageResampling. لا يؤثر إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
ينشئ معالج صور من نوع BeitImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.beit.image_processing_pil_beit.BeitImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقسيم المراد معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
المعاملات
- outputs (BeitForSemanticSegmentation) — المخرجات الخام للنموذج.
- target_sizes (
list[Tuple]بطولbatch_size، اختياري) — قائمة من الأ_tuples المقابلة للحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا لم يتم ضبطه، فلن يتم تغيير حجم التنبؤات. - return_segmentation_scores (
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع درجات التقسيم (segmentation scores) إلى جانب خريطة التقسيم. عند تعيينTrue، يكون كل عنصر من القائمة المُرجعة من نوعSemanticSegmentationPostProcessorOutputويحتوي على الحقولsegmentation(معرّفات الفئات، الشكل(height, width)) وsegmentation_scores(الشكل(num_classes, height, width)).
يعيد
list[torch.Tensor] أو list[SemanticSegmentationPostProcessorOutput]
عندما يكون return_segmentation_scores=False (الافتراضي)، تكون النتيجة قائمة بطول batch_size حيث يكون كل عنصر منها خريطة تجزئة (segmentation map) بأبعاد (height, width) تحتوي على معرّفات الفئات. أما عندما يكون return_segmentation_scores=True، فتكون النتيجة قائمة من SemanticSegmentationPostProcessorOutput تحتوي على الحقول segmentation (معرّفات الفئات، بأبعاد (height, width)) وsegmentation_scores (بأبعاد (num_classes, height, width)). في الحالتين، يمثل (height, width) الحجم المستهدف (إذا تم تحديد target_sizes).
يحوّل مخرجات BeitForSemanticSegmentation إلى خرائط تجزئة دلالية.
BeitModel
فئة transformers.BeitModel
< source >( config: BeitConfigadd_pooling_layer: bool = True )
المعاملات
- config (BeitConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
- add_pooling_layer (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة طبقة تجميع
نموذج Beit العاري الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorbool_masked_pos: typing.Optional[torch.BoolTensor] = Noneinterpolate_pos_encoding: bool = Falseattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BeitModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BeitImageProcessor. راجع BeitImageProcessor.call() للتفاصيل (يستخدمprocessor_classBeitImageProcessor لمعالجة الصور). - bool_masked_pos (
torch.BoolTensorof shape(batch_size, num_patches), اختياري) — المواضع المقنّعة (Boolean). يحدد البقع المقنّعة (1) والتي ليست كذلك (0). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
BeitModelOutputWithPooling أو tuple(torch.Tensor)
BeitModelOutputWithPooling أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (BeitConfig) والمدخلات.
تتجاوز طريقة BeitModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — متوسط حالات الإخفاء للطبقة الأخيرة لرموز الباتش (باستثناء رمز [CLS]) إذا كان config.use_mean_pooling مضبوطاً على True. إذا كان مضبوطاً على False، فسيتم إرجاع حالة الإخفاء النهائية لرمز [CLS].hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
BeitForMaskedImageModeling
فئة transformers.BeitForMaskedImageModeling
< source >( config: BeitConfig )
المعاملات
- config (BeitConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
محوّل نموذج Beit مع رأس نمذجة «لغة» في الأعلى. يقوم BEiT بنمذجة الصور المقنّعة من خلال التنبؤ بالرموز البصرية لمحوّل الترميز المتغيّر الكمي (VQ-VAE)، بينما تتنبأ نماذج الرؤية الأخرى مثل ViT وDeiT بقيم بكسل RGB. ونتيجةً لذلك، فإن هذه الفئة غير متوافقة مع AutoModelForMaskedImageModeling، لذا ستحتاج إلى استخدام BeitForMaskedImageModeling مباشرةً إذا كنت ترغب في إجراء نمذجة الصور المقنّعة باستخدام BEiT.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonebool_masked_pos: typing.Optional[torch.BoolTensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = Falseattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MaskedLMOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (من نوع
torch.Tensorبأبعاد(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BeitImageProcessor. راجع BeitImageProcessor.call() للتفاصيل (حيث يستخدمprocessor_classBeitImageProcessor لمعالجة الصور). - bool_masked_pos (
torch.BoolTensorمن الشكل(batch_size, num_patches)) — المواضع المقنّعة من نوع منطقي. تُظهر أيّ البقع مقنّعة (1) وأيّها غير مقنّع (0). - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
MaskedLMOutput أو tuple(torch.Tensor)
MaskedLMOutput أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (BeitConfig) والمدخلات.
تتجاوز طريقة BeitForMaskedImageModeling الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة المقنّعة (MLM).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")

>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()

>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
BeitForImageClassification
فئة transformers.BeitForImageClassification
< source >( config: BeitConfig )
المعاملات
- config (BeitConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Beit محوّل (Transformer) مع رأس تصنيف صور في الأعلى (طبقة خطية فوق متوسط الحالات المخفية النهائية لرموز الباتش) مثل ImageNet.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ImageClassifierOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (من نوع
torch.Tensorبأبعاد(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BeitImageProcessor. راجع BeitImageProcessor.call() للتفاصيل (حيث يستخدمprocessor_classBeitImageProcessor لمعالجة الصور). - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
ImageClassifierOutput أو tuple(torch.Tensor)
ImageClassifierOutput أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (BeitConfig) والمدخلات.
تتجاوز طريقة BeitForImageClassification الخاصة بالتقديم الأمامي الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل مرحلة) من الشكل(batch_size, sequence_length, hidden_size). حالات مخفية (تُسمى أيضًا خرائط الميزات) للنموذج عند إخراج كل مرحلة.attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
BeitForSemanticSegmentation
فئة transformers.BeitForSemanticSegmentation
< source >( config: BeitConfig )
المعاملات
- config (BeitConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Beit مع رأس تقسيم دلالي في الأعلى، على سبيل المثال لـ ADE20K وCityScapes.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SemanticSegmenterOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (من نوع
torch.Tensorبأبعاد(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام BeitImageProcessor. راجع BeitImageProcessor.call() للتفاصيل (حيث يستخدمprocessor_classBeitImageProcessor لمعالجة الصور). - labels (
torch.LongTensorمن الشكل(batch_size, height, width)، اختياري) — خرائط التقسيم الدلالي الصحيحة (Ground truth) لحساب الخسارة. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels > 1، يتم حساب خسارة التصنيف (Cross-Entropy). - interpolate_pos_encoding (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
يعيد
SemanticSegmenterOutput أو tuple(torch.Tensor)
SemanticSegmenterOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (BeitConfig) والمدخلات.
تتجاوز طريقة BeitForSemanticSegmentation الخاصة بالتقديم الأمامي الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels, logits_height, logits_width)) — درجات التصنيف لكل بكسل.The logits returned do not necessarily have the same size as the
pixel_valuespassed as inputs. This is to avoid doing two interpolations and lose some quality when a user needs to resize the logits to the original image size as post-processing. You should always check your logits shape and resize as needed.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, patch_size, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits