
Transformers documentation
MaskFormer
نُشر هذا النموذج في أوراق HF في 13 يوليو 2021، وأُضيف إلى مكتبة Hugging Face Transformers في 2 مارس 2022.
MaskFormer
هذا نموذج تم تقديمه مؤخرًا، لذا لم يتم اختبار واجهة برمجة التطبيقات (API) على نطاق واسع. قد تكون هناك بعض الأخطاء أو تغييرات طفيفة كاسرة يجب معالجتها في المستقبل. إذا لاحظت شيئًا غير معتاد، فقم بفتح قضية على Github.
نظرة عامة
The MaskFormer model was proposed in Per-Pixel Classification is Not All You Need for Semantic Segmentation by Bowen Cheng, Alexander G. Schwing, Alexander Kirillov. MaskFormer addresses semantic segmentation with a mask classification paradigm instead of performing classic pixel-level classification.
المستخلص من الورقة البحثية هو كالتالي:
تُصيغ الأساليب الحديثة عادةً تقسيم الدلالات (semantic segmentation) كمهمة تصنيف لكل بكسل، بينما يُعالج التقسيم على مستوى الكائنات (instance-level segmentation) باستخدام تصنيف قناع بديل. رؤيتنا الأساسية: تصنيف القناع عام بما يكفي لحل مهام التقسيم على مستوى الدلالات ومستوى الكائنات معًا بطريقة موحدة باستخدام النموذج نفسه تمامًا، ودالة الخسارة، وإجراء التدريب. بناءً على هذه الملاحظة، نقترح MaskFormer، وهو نموذج بسيط لتصنيف الأقنعة يتنبأ بمجموعة من الأقنعة الثنائية، يرتبط كل منها بتنبؤ واحد لوسم فئة عام. بشكل عام، تُبسّط الطريقة المقترحة القائمة على تصنيف الأقنعة المشهد الخاص بالأساليب الفعّالة لمهام تقسيم الدلالات والتقسيم الشامل (panoptic segmentation)، وتُظهر نتائج تجريبية ممتازة. على وجه الخصوص، نلاحظ أن MaskFormer يتفوق على خطوط الأساس القائمة على التصنيف لكل بكسل عندما يكون عدد الفئات كبيرًا. تتفوق طريقتنا القائمة على تصنيف الأقنعة على كل من أحدث نماذج تقسيم الدلالات (55.6 mIoU على ADE20K) ونماذج التقسيم الشامل (52.7 PQ على COCO) الحالية.
يوضح الشكل أدناه بنية MaskFormer. مأخوذة من الورقة الأصلية.
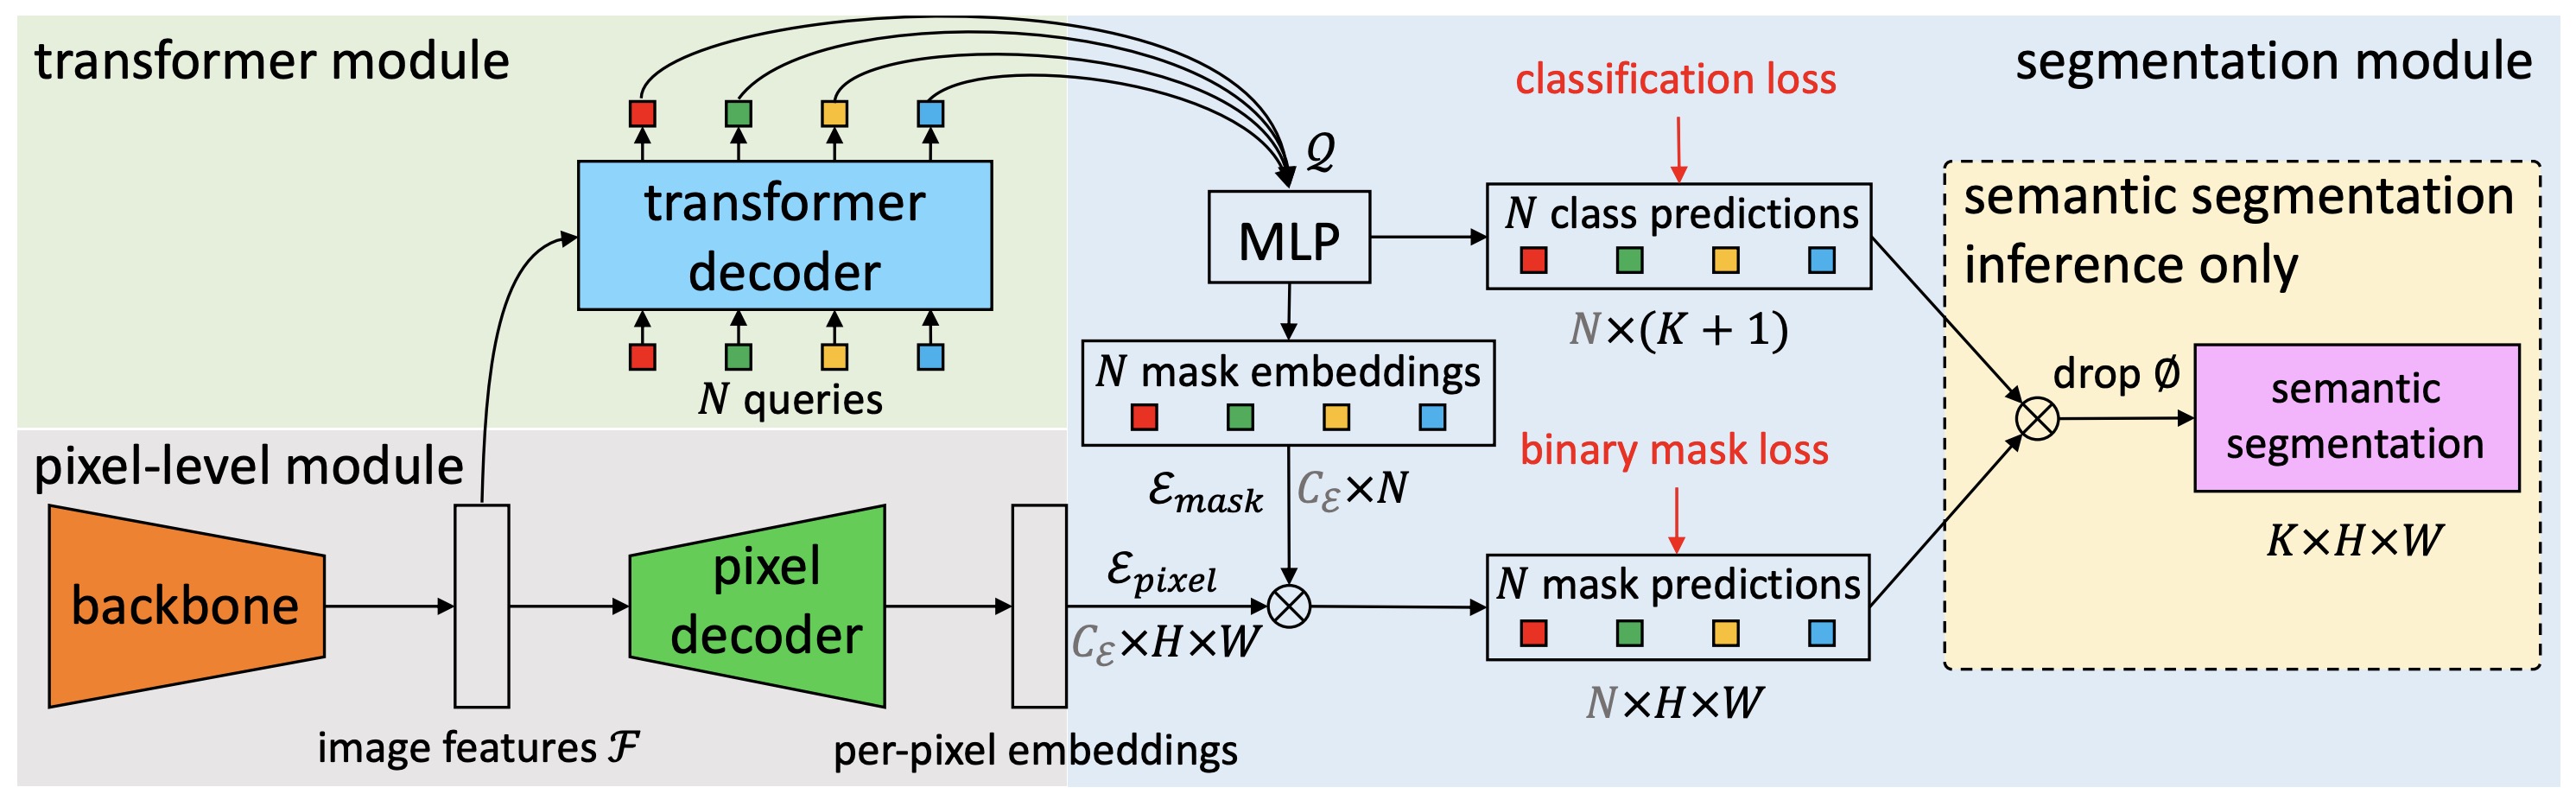
تمت مساهمة هذا النموذج من قِبل francesco. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- مفكّك Transformer في MaskFormer مطابق تمامًا لمفكّك DETR. أثناء التدريب، وجد مؤلفو DETR أن استخدام الخسائر المساعدة في المفكّك مفيد، لا سيما لمساعدة النموذج على إخراج العدد الصحيح من الكائنات لكل فئة. إذا قمت بإعداد المعامل
use_auxiliary_lossالخاص بـ MaskFormerConfig إلىTrue، فسيتم إضافة شبكات عصبية أمامية للتنبؤ وخسائر المجرّ (Hungarian) بعد كل طبقة من طبقات المفكّك (مع مشاركة المعاملات بين الشبكات العصبية الأمامية). - إذا كنت ترغب في تدريب النموذج في بيئة موزعة عبر عدة عقد، فيجب تحديث الدالة
get_num_masksداخل فئةMaskFormerLossفي الملفmodeling_maskformer.py. عند التدريب على عدة عقد، يجب ضبط هذه القيمة على متوسط عدد أقنعة الأهداف عبر جميع العقد، كما هو موضح في التنفيذ الأصلي هنا. - يمكن استخدام MaskFormerImageProcessor لتحضير الصور للنموذج والأهداف الاختيارية للنموذج.
- للحصول على التقطيع النهائي، يمكنك، اعتماداً على المهمة، استدعاء post_process_semantic_segmentation() أو post_process_panoptic_segmentation(). يمكن حل كلا المهمتين باستخدام مخرجات MaskFormerForInstanceSegmentation، ويقبل التقطيع البانورامي الحجة الاختيارية
label_ids_to_fuseلدمج كائنات الهدف (مثل السماء) معاً.
الموارد
- يمكن العثور على جميع الدفاتر التي توضح الاستدلال وكذلك الضبط الدقيق على بيانات مخصصة باستخدام MaskFormer هنا.
المخرجات الخاصة بـ MaskFormer
فئة transformers.models.maskformer.modeling_maskformer.MaskFormerModelOutput
< source >( encoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonepixel_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonetransformer_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: tuple[torch.Tensor] | None = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = None )
المعاملات
- encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج المُشفِّر (الهيكل الأساسي). - pixel_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحص البكسل (FPN). - transformer_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — حالات الإخفاء الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحم التحوّل. - encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) لنموذج المُشفِّر عند إخراج كل مرحلة. - pixel_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) بأبعاد(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) لنموذج فك ترميز البكسلات عند إخراج كل مرحلة. - transformer_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, sequence_length, hidden_size). حالات المخفية (المعروفة أيضًا باسم خرائط الميزات) لمفكك التحويل عند إخراج كل مرحلة. - hidden_states
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عندconfig.output_hidden_states=True) — مجموعة منtorch.Tensorتحتوي علىencoder_hidden_statesوpixel_decoder_hidden_statesوdecoder_hidden_states - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
فئة لمخرجات MaskFormerModel. تُعيد هذه الفئة جميع حالات الإخفاء (hidden states) اللازمة لحساب القيم اللوجستية (logits).
فئة transformers.models.maskformer.modeling_maskformer.MaskFormerForInstanceSegmentationOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneclass_queries_logits: typing.Optional[torch.Tensor] = Nonemasks_queries_logits: typing.Optional[torch.Tensor] = Noneauxiliary_logits: typing.Optional[torch.Tensor] = Noneencoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonepixel_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Nonetransformer_decoder_last_hidden_state: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: tuple[torch.Tensor] | None = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = None )
المعاملات
- loss (
torch.Tensor، اختياري) — الخسارة المحسوبة، تُعاد عند وجود التسميات. - class_queries_logits (
torch.Tensor، اختياري) — مصفوفة (Tensor) بأبعاد(batch_size, num_queries, num_labels + 1)تمثل الفئات المقترحة لكل استعلام. لاحظ أن+ 1ضرورية لأننا ندمج الفئة الفارغة (null class). - masks_queries_logits (
torch.Tensor، اختياري) — مصفوفة (Tensor) بأبعاد(batch_size, num_queries, height, width)تمثل الأقنعة المقترحة لكل استعلام. - auxiliary_logits (
Dict[str, torch.Tensor]، اختياري، يُعاد عندoutput_auxiliary_logits=True) — قاموس يحتوي على التنبؤات المساعدة لكل طبقة من طبقات المُفكِّك (decoder) عند تمكين الخسائر المساعدة. - encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج المُشفِّر (الهيكل الأساسي). - pixel_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحص البكسل (FPN). - transformer_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — حالات الإخفاء الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحم التحوّل. - encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) لنموذج المُشفِّر عند إخراج كل مرحلة. - pixel_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) بأبعاد(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) لنموذج فك ترميز البكسلات عند إخراج كل مرحلة. - transformer_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, sequence_length, hidden_size). حالات المخفية لمفكك التحويل عند إخراج كل مرحلة. - hidden_states
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عندconfig.output_hidden_states=True) — مجموعة منtorch.Tensorتحتوي علىencoder_hidden_statesوpixel_decoder_hidden_statesوdecoder_hidden_states. - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
فئة لمخرجات MaskFormerForInstanceSegmentation.
يمكن تمرير هذا المخرَج مباشرةً إلى post_process_semantic_segmentation() أو post_process_instance_segmentation() أو post_process_panoptic_segmentation() اعتماداً على المهمة. يرجى الاطلاع على [`~MaskFormerImageProcessor] للحصول على تفاصيل حول الاستخدام.
MaskFormerDetrConfig
فئة transformers.MaskFormerDetrConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_channels: int = 3num_queries: int = 100encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8encoder_layerdrop: float | int = 0.0decoder_layerdrop: float | int = 0.0activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0init_std: float = 0.02init_xavier_std: float = 1.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'dilation: bool = Falseclass_cost: int = 1bbox_cost: int = 5giou_cost: int = 2mask_loss_coefficient: int = 1dice_loss_coefficient: int = 1bbox_loss_coefficient: int = 5giou_loss_coefficient: int = 2eos_coefficient: float = 0.1 )
المعاملات
- is_encoder_decoder (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - num_queries (
int، اختياري، القيمة الافتراضية 100) — عدد استعلامات الكائنات، أي فتحات الكشف. هذا هو الحد الأقصى لعدد الكائنات التي يمكن لنموذج ConditionalDetrModel اكتشافها في صورة واحدة. بالنسبة إلى COCO، نوصي باستخدام 100 استعلام. - encoder_layers (
int, اختياري، القيمة الافتراضية6) — عدد الطبقات المخفية في مُشفِّر Transformer. سيستخدم القيمة نفسها لـnum_layersإذا لم يتم ضبطه. - encoder_ffn_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد طبقة "الوسط" (التي تُسمّى غالبًا بطبقة التغذية الأمامية) في المُشفِّر. - encoder_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُشفِّر Transformer. - decoder_layers (
int, اختياري، القيمة الافتراضية6) — عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمةnum_layersإذا لم يتم تعيينه. - decoder_ffn_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد طبقة "الوسط" (التي تُسمّى غالباً بطبقة التغذية الأمامية) في المُفكِّك. - decoder_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - encoder_layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمال LayerDrop للمُشفِّر. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - decoder_layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمال LayerDrop الخاص بفك الترميز. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - activation_function (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - d_model (
int، اختياري، القيمة الافتراضية256) — حجم طبقات المُشفِّر وطبقة المُجمِّع. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — النسبة لجميع طبقات dropout. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - activation_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة dropout للتفعيلات داخل الطبقة المتصلة بالكامل. - init_std (
float، اختياري، القيمة الافتراضية0.02) — انحراف معياري لمُهيّئ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - init_xavier_std (
float، اختياري، القيمة الافتراضية1.0) — عامل التدرّج المستخدم في تهيئة Xavier لأوزان الانتباه المتقاطع. - auxiliary_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام خسائر فك الترميز المساعدة (الخسائر في كل طبقة من طبقات فك الترميز). - position_embedding_type (
str، اختياري، القيمة الافتراضية"sine") — نوع تضمينات الموضع المستخدمة فوق ميزات الصورة. إما"sine"أو"learned". - dilation (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب استبدال الخطوة (stride) بالتوسيع (dilation) في كتلة الالتفاف الأخيرة (DC5). يُدعم هذا الخيار فقط عندما يكونuse_timm_backbone=True. - class_cost (
int، اختياري، القيمة الافتراضية1) — الوزن النسبي لخطأ التصنيف في تكلفة المطابقة الهنغارية. - bbox_cost (
int، اختياري، القيمة الافتراضية5) — الوزن النسبي لخطأ صندوق الحدود L1 في تكلفة المطابقة الهنغارية. - giou_cost (
int، اختياري، القيمة الافتراضية2) — الوزن النسبي لخسارة IoU المعممة في تكلفة المطابقة الهنغارية. - mask_loss_coefficient (
int, اختياري، القيمة الافتراضية1) — الوزن النسبي لخسارة التركيز (focal loss) في خسارة التقطيع البانورامي (panoptic segmentation). - dice_loss_coefficient (
int, اختياري، القيمة الافتراضية1) — الوزن النسبي لخسارة دايس (dice loss) في خسارة التقطيع البانورامي (panoptic segmentation). - bbox_loss_coefficient (
int، اختياري، القيمة الافتراضية5) — الوزن النسبي لخسارة صندوق الحدود L1 في خسارة التقطيع البانورامي. - giou_loss_coefficient (
int, اختياري، القيمة الافتراضية2) — الوزن النسبي لخسارة IoU المعممة في خسارة التقطيع البانورامي. - eos_coefficient (
float، اختياري، القيمة الافتراضية0.1) — الوزن النسبي للتصنيف لفئة «لا يوجد كائن» في دالة خسارة كشف الكائنات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج MaskFormerModel. تُستخدم لتوليد نموذج Maskformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/maskformer-swin-base-ade
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import MaskFormerDetrConfig, MaskFormerDetrModel

>>> # Initializing a MASK_FORMER_DETR facebook/mask_former_detr-resnet-50 style configuration
>>> configuration = MaskFormerDetrConfig()

>>> # Initializing a model (with random weights) from the facebook/mask_former_detr-resnet-50 style configuration
>>> model = MaskFormerDetrModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MaskFormerConfig
فئة transformers.MaskFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonefpn_feature_size: int = 256mask_feature_size: int = 256no_object_weight: float = 0.1use_auxiliary_loss: bool = Falsebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonedecoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinit_std: float = 0.02init_xavier_std: float = 1.0dice_weight: float = 1.0cross_entropy_weight: float = 1.0mask_weight: float = 20.0output_auxiliary_logits: bool | None = None )
المعاملات
- fpn_feature_size (
int, اختياري، القيمة الافتراضية 256) — حجم ميزات شبكة هرم الميزات (Feature Pyramid Network). - mask_feature_size (
int, اختياري، القيمة الافتراضية 256) — حجم ميزات الأقنعة، وسيُستخدم هذا القيمة أيضاً لتحديد حجم ميزات شبكة هرم الميزات (Feature Pyramid Network). - no_object_weight (
float، اختياري، القيمة الافتراضية0.1) — الوزن التصنيفي النسبي لفئة "لا يوجد كائن" في دالة خسارة كشف الكائنات. - use_auxiliary_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم حساب الخسارة باستخدام التنبؤات الوسيطة من مُفكِّك التحوّل (transformer decoder). - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - decoder_config (
Dict، اختياري) — إعدادات النموذج المُمرَّرة إلى مُفكِّك التحوّلات (transformer decoder)، وإذا لم تُضبط فسيتم استخدام الإعداد الأساسي لـdetr-resnet-50. - init_std (
float، اختياري، القيمة الافتراضية0.02) — انحراف معياري لمُهيّئ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - init_xavier_std (
float، اختياري، القيمة الافتراضية1.0) — عامل التدرّج المستخدم في تهيئة Xavier لأوزان الانتباه المتقاطع. - dice_weight (
float، اختياري، القيمة الافتراضية1.0) — الوزن النسبي لخسارة الداي (dice loss) في خسارة التقطيع البانورامي (panoptic segmentation). - cross_entropy_weight (
float, اختياري، القيمة الافتراضية 1.0) — الوزن الخاص بخسارة الانتروبيا المتقاطعة. - mask_weight (
float، اختياري، القيمة الافتراضية20.0) — الوزن النسبي لخسارة التركيز (focal loss) في خسارة التقطيع الشامل (panoptic segmentation). - output_auxiliary_logits (
bool، اختياري) — هل يجب على النموذج إخراجauxiliary_logitsأم لا.
يرفع
ValueError
ValueError— تُستدعى إذا كان نوع نموذج الهيكل الأساسي المحدد غير موجود في["swin"]أو إذا كان نوع نموذج فك الترميز المحدد غير موجود في["detr"]
هذه فئة الإعدادات المخزنة لإعدادات نموذج MaskFormerModel. تُستخدم لتوليد نموذج Maskformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/maskformer-swin-base-ade
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import MaskFormerConfig, MaskFormerModel

>>> # Initializing a MaskFormer facebook/maskformer-swin-base-ade configuration
>>> configuration = MaskFormerConfig()

>>> # Initializing a model (with random weights) from the facebook/maskformer-swin-base-ade style configuration
>>> model = MaskFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
MaskFormerImageProcessor
فئة transformers.MaskFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.maskformer.image_processing_maskformer.MaskFormerImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 800, 'longest_edge': 1333}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
SizeDict، kwargs، اختياري) — الحجم الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - ignore_index (
int، kwargs، اختياري) — التسمية التي تُسند إلى بكسلات الخلفية في خرائط التقسيم. إذا تم تقديمه، فسيتم استبدال بكسلات خريطة التقسيم المُشار إليها بـ 0 (الخلفية) بـignore_index. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إنقاص جميع قيم التسميات في خرائط التقسيم بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بـignore_index. - num_labels (
int، kwargs، اختياري) — عدد التسميات في خريطة التقطيع. - size_divisor (
int، kwargs، اختياري، القيمة الافتراضية32) — تتطلب بعض الهياكات الأساسية أن تكون الصور قابلة للقسمة على عدد معين. إذا لم يتم تمريرها، فإن القيمة الافتراضية هي القيمة المستخدمة في Swin Transformer.
ينشئ معالج صور MaskFormerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.maskformer.image_processing_maskformer.MaskFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقطيع. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], اختياري) — تعيين من معرّفات الكيانات إلى المعرّفات الدلالية. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
SizeDict، kwargs، اختياري) — الحجم الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - ignore_index (
int، kwargs، اختياري) — التسمية التي تُسند إلى بكسلات الخلفية في خرائط التقسيم. إذا تم تقديمه، فسيتم استبدال بكسلات خريطة التقسيم المُشار إليها بـ 0 (الخلفية) بـignore_index. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إنقاص جميع قيم التسميات في خرائط التقسيم بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بـignore_index. - num_labels (
int، kwargs، اختياري) — عدد التسميات في خريطة التقطيع. - size_divisor (
int، kwargs، اختياري، القيمة الافتراضية32) — تتطلب بعض الهياكات الأساسية أن تكون الصور قابلة للقسمة على عدد معين. إذا لم يتم تمريرها، فإن القيمة الافتراضية هي القيمة المستخدمة في Swin Transformer.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
المعاملات
- outputs (MaskFormerForInstanceSegmentation) — المخرجات الخام للنموذج.
- target_sizes (
list[tuple[int, int]], اختياري) — قائمة بطول (batch_size)، حيث يتوافق كل عنصر في القائمة (tuple[int, int]]) مع الحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات. - return_segmentation_scores (
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع درجات التقسيم (segmentation scores) إلى جانب خريطة التقسيم. عند تعيينTrue، يكون كل عنصر من القائمة المُرجعة من نوعSemanticSegmentationPostProcessorOutputويحتوي على الحقولsegmentation(معرّفات الفئات، الشكل(height, width)) وsegmentation_scores(الشكل(num_classes, height, width)).
يعيد
list[torch.Tensor] أو list[SemanticSegmentationPostProcessorOutput]
عندما يكون return_segmentation_scores=False (الافتراضي)، تكون النتيجة قائمة بطول batch_size حيث يكون كل عنصر منها خريطة تجزئة (segmentation map) بأبعاد (height, width) تحتوي على معرّفات الفئات. أما عندما يكون return_segmentation_scores=True، فتكون النتيجة قائمة من SemanticSegmentationPostProcessorOutput تحتوي على الحقول segmentation (معرّفات الفئات، بأبعاد (height, width)) وsegmentation_scores (بأبعاد (num_classes, height, width)). في الحالتين، يمثل (height, width) الحجم المستهدف (إذا تم تحديد target_sizes).
يحوّل مخرجات MaskFormerForInstanceSegmentation إلى خرائط تجزئة دلالية. يدعم PyTorch فقط.
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = Falsereturn_binary_maps: bool | None = False ) → list[Dict]
المعاملات
- outputs (MaskFormerForInstanceSegmentation) — المخرجات الخام للنموذج.
- threshold (
float، اختياري، القيمة الافتراضية 0.5) — حدّ درجة الاحتمال الذي يُحتفظ به لأقنعة الأمثلة المتنبأ بها. - mask_threshold (
float، اختياري، القيمة الافتراضية 0.5) — العتبة المستخدمة عند تحويل الأقنعة المتوقعة إلى قيم ثنائية. - overlap_mask_area_threshold (
float، اختياري، القيمة الافتراضية 0.8) — حدّ منطقة قناع التداخل لدمج الأجزاء المنفصلة الصغيرة أو التخلص منها داخل كل قناع مثيل ثنائي. - target_sizes (
list[Tuple]، اختياري) — قائمة بطول (batch_size)، حيث يتوافق كل عنصر في القائمة (tuple[int, int]]) مع الحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات. - return_coco_annotation (
bool، اختياري، القيمة الافتراضيةFalse) — إذا تم ضبطه علىTrue، تُعاد خرائط التقسيم بصيغة ترميز COCO بطول المسار (RLE). - return_binary_maps (
bool، اختياري، القيمة الافتراضيةFalse) — إذا تم ضبطه علىTrue، تُعاد خرائط التقسيم كمتجه مُدمج من خرائط التقسيم الثنائية (خريطة واحدة لكل حالة مكتشفة).
يعيد
list[Dict]
قائمة من القواميس، قواميس واحدة لكل صورة، يحتوي كل قاموس على مفتاحين:
- segmentation — متجه (Tensor) بأبعاد
(height, width)حيث يمثل كل بكسلsegment_id، أوlist[List]ترميز طول التكرار (RLE) لخريطة التقسيم إذا تم ضبط return_coco_annotation علىTrue، أو متجه بأبعاد(num_instances, height, width)إذا تم ضبط return_binary_maps علىTrue. يتم ضبطه علىNoneإذا لم يتم العثور على قناع أعلى منthreshold. - segments_info — قاموس يحتوي على معلومات إضافية حول كل مقطع.
- id — عدد صحيح يمثل
segment_id. - label_id — عدد صحيح يمثل معرّف التسمية/الفئة الدلالية المقابلة لـ
segment_id. - score — درجة التنبؤ للمقطع ذي
segment_id.
- id — عدد صحيح يمثل
يحوّل مخرجات MaskFormerForInstanceSegmentationOutput إلى تنبؤات تجزئة الكائنات. يدعم PyTorch فقط. إذا كان من الممكن أن تتداخل الكائنات، فعيّن إما return_coco_annotation أو return_binary_maps إلى True للحصول على نتيجة تجزئة صحيحة.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
المعاملات
- outputs (
MaskFormerForInstanceSegmentationOutput) — المخرجات من MaskFormerForInstanceSegmentation. - threshold (
float، اختياري، القيمة الافتراضية 0.5) — حدّ درجة الاحتمال الذي يُحتفظ به لأقنعة الأمثلة المتنبأ بها. - mask_threshold (
float، اختياري، القيمة الافتراضية 0.5) — العتبة المستخدمة عند تحويل الأقنعة المتوقعة إلى قيم ثنائية. - overlap_mask_area_threshold (
float، اختياري، القيمة الافتراضية 0.8) — حدّ منطقة قناع التداخل لدمج الأجزاء المنفصلة الصغيرة أو التخلص منها داخل كل قناع مثيل ثنائي. - label_ids_to_fuse (
Set[int]، اختياري) — ستتم دمج جميع الأمثلة الخاصة بالتسميات في هذه الحالة معًا. على سبيل المثال، يمكن القول إنه لا يمكن أن يوجد سوى سماء واحدة في صورة، بينما يمكن أن يوجد عدة أشخاص، لذا فإن معرّف التسمية الخاص بالسماء سيكون ضمن ذلك المجموع، بينما لن يكون معرّف التسمية الخاص بالشخص كذلك. - target_sizes (
list[Tuple], اختياري) — قائمة بطول (batch_size)، حيث يقابل كل عنصر في القائمة (tuple[int, int]]) الحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ في الدفعة. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات.
يعيد
list[Dict]
قائمة من القواميس، قواميس واحدة لكل صورة، يحتوي كل قاموس على مفتاحين:
- segmentation — متجه (tensor) بأبعاد
(height, width)حيث يمثل كل بكسلsegment_id، ويُعيَّن إلىNoneإذا لم يُعثر على قناع (mask) أعلى منthreshold. إذا تم تحديدtarget_sizes، يتم تغيير حجم segmentation إلى القيمة المقابلة فيtarget_sizes. - segments_info — قاموس يحتوي على معلومات إضافية حول كل مقطع.
- id — عدد صحيح يمثل
segment_id. - label_id — عدد صحيح يمثل معرّف التسمية/الفئة الدلالية المقابلة لـ
segment_id. - was_fused — قيمة منطقية، تكون
Trueإذا كانlabel_idضمنlabel_ids_to_fuse، وإلا تكونFalse. تم دمج عدة حالات من نفس الفئة / التسمية وتم إسنادsegment_idواحد إليها. - score — درجة التنبؤ للمقطع ذي
segment_id.
- id — عدد صحيح يمثل
يحوّل مخرجات MaskFormerForInstanceSegmentationOutput إلى تنبؤات تقسيم بانورامي للصور. يدعم PyTorch فقط.
MaskFormerImageProcessorPil
فئة transformers.MaskFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.maskformer.image_processing_pil_maskformer.MaskFormerImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 800, 'longest_edge': 1333}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
SizeDict، kwargs، اختياري) — الحجم الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - ignore_index (
int، kwargs، اختياري) — التسمية التي تُسند إلى بكسلات الخلفية في خرائط التقسيم. إذا تم تقديمه، فسيتم استبدال بكسلات خريطة التقسيم المُشار إليها بـ 0 (الخلفية) بـignore_index. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إنقاص جميع قيم التسميات في خرائط التقسيم بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بـignore_index. - num_labels (
int، kwargs، اختياري) — عدد التسميات في خريطة التقطيع. - size_divisor (
int، kwargs، اختياري، القيمة الافتراضية32) — تتطلب بعض الهياكات الأساسية أن تكون الصور قابلة للقسمة على عدد معين. إذا لم يتم تمريرها، فإن القيمة الافتراضية هي القيمة المستخدمة في Swin Transformer.
ينشئ معالج صور MaskFormerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.maskformer.image_processing_pil_maskformer.MaskFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقطيع. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], اختياري) — تعيين من معرّفات الكيانات إلى المعرّفات الدلالية. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
SizeDict، kwargs، اختياري) — الحجم الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - ignore_index (
int، kwargs، اختياري) — التسمية التي تُسند إلى بكسلات الخلفية في خرائط التقسيم. إذا تم تقديمه، فسيتم استبدال بكسلات خريطة التقسيم المُشار إليها بـ 0 (الخلفية) بـignore_index. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إنقاص جميع قيم التسميات في خرائط التقسيم بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بـignore_index. - num_labels (
int، kwargs، اختياري) — عدد التسميات في خريطة التقطيع. - size_divisor (
int، kwargs، اختياري، القيمة الافتراضية32) — تتطلب بعض الهياكات الأساسية أن تكون الصور قابلة للقسمة على عدد معين. إذا لم يتم تمريرها، فإن القيمة الافتراضية هي القيمة المستخدمة في Swin Transformer.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
المعاملات
- outputs (MaskFormerForInstanceSegmentation) — المخرجات الخام للنموذج.
- target_sizes (
list[tuple[int, int]], اختياري) — قائمة بطول (batch_size)، حيث يتوافق كل عنصر في القائمة (tuple[int, int]]) مع الحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات. - return_segmentation_scores (
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع درجات التقسيم (segmentation scores) إلى جانب خريطة التقسيم. عند تعيينTrue، يكون كل عنصر من القائمة المُرجعة من نوعSemanticSegmentationPostProcessorOutputويحتوي على الحقولsegmentation(معرّفات الفئات، الشكل(height, width)) وsegmentation_scores(الشكل(num_classes, height, width)).
يعيد
list[torch.Tensor] أو list[SemanticSegmentationPostProcessorOutput]
عندما يكون return_segmentation_scores=False (الافتراضي)، تكون النتيجة قائمة بطول batch_size حيث يكون كل عنصر منها خريطة تجزئة (segmentation map) بأبعاد (height, width) تحتوي على معرّفات الفئات. أما عندما يكون return_segmentation_scores=True، فتكون النتيجة قائمة من SemanticSegmentationPostProcessorOutput تحتوي على الحقول segmentation (معرّفات الفئات، بأبعاد (height, width)) وsegmentation_scores (بأبعاد (num_classes, height, width)). في الحالتين، يمثل (height, width) الحجم المستهدف (إذا تم تحديد target_sizes).
يحوّل مخرجات MaskFormerForInstanceSegmentation إلى خرائط تجزئة دلالية. يدعم PyTorch فقط.
post_process_instance_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = Falsereturn_binary_maps: bool | None = False ) → list[Dict]
المعاملات
- outputs (MaskFormerForInstanceSegmentation) — المخرجات الخام للنموذج.
- threshold (
float، اختياري، القيمة الافتراضية 0.5) — حدّ درجة الاحتمال الذي يُحتفظ به لأقنعة الأمثلة المتنبأ بها. - mask_threshold (
float، اختياري، القيمة الافتراضية 0.5) — العتبة المستخدمة عند تحويل الأقنعة المتوقعة إلى قيم ثنائية. - overlap_mask_area_threshold (
float، اختياري، القيمة الافتراضية 0.8) — حدّ منطقة قناع التداخل لدمج الأجزاء المنفصلة الصغيرة أو التخلص منها داخل كل قناع مثيل ثنائي. - target_sizes (
list[Tuple]، اختياري) — قائمة بطول (batch_size)، حيث يتوافق كل عنصر في القائمة (tuple[int, int]]) مع الحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات. - return_coco_annotation (
bool، اختياري، القيمة الافتراضيةFalse) — إذا تم ضبطه علىTrue، تُعاد خرائط التقسيم بصيغة ترميز COCO بطول المسار (RLE). - return_binary_maps (
bool، اختياري، القيمة الافتراضيةFalse) — إذا تم ضبطه علىTrue، تُعاد خرائط التقسيم كمتجه مُدمج من خرائط التقسيم الثنائية (خريطة واحدة لكل حالة مكتشفة).
يعيد
list[Dict]
قائمة من القواميس، قواميس واحدة لكل صورة، يحتوي كل قاموس على مفتاحين:
- segmentation — متجه (Tensor) بأبعاد
(height, width)حيث يمثل كل بكسلsegment_id، أوlist[List]ترميز طول التكرار (RLE) لخريطة التقسيم إذا تم ضبط return_coco_annotation علىTrue، أو متجه بأبعاد(num_instances, height, width)إذا تم ضبط return_binary_maps علىTrue. يتم ضبطه علىNoneإذا لم يتم العثور على قناع أعلى منthreshold. - segments_info — قاموس يحتوي على معلومات إضافية حول كل مقطع.
- id — عدد صحيح يمثل
segment_id. - label_id — عدد صحيح يمثل معرّف التسمية/الفئة الدلالية المقابلة لـ
segment_id. - score — درجة التنبؤ للمقطع ذي
segment_id.
- id — عدد صحيح يمثل
يحوّل مخرجات MaskFormerForInstanceSegmentationOutput إلى تنبؤات تجزئة الكائنات. يدعم PyTorch فقط. إذا كان من الممكن أن تتداخل الكائنات، فعيّن إما return_coco_annotation أو return_binary_maps إلى True للحصول على نتيجة تجزئة صحيحة.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
المعاملات
- outputs (
MaskFormerForInstanceSegmentationOutput) — المخرجات من MaskFormerForInstanceSegmentation. - threshold (
float، اختياري، القيمة الافتراضية 0.5) — حدّ درجة الاحتمال الذي يُحتفظ به لأقنعة الأمثلة المتنبأ بها. - mask_threshold (
float، اختياري، القيمة الافتراضية 0.5) — العتبة المستخدمة عند تحويل الأقنعة المتوقعة إلى قيم ثنائية. - overlap_mask_area_threshold (
float، اختياري، القيمة الافتراضية 0.8) — حدّ منطقة قناع التداخل لدمج الأجزاء المنفصلة الصغيرة أو التخلص منها داخل كل قناع مثيل ثنائي. - label_ids_to_fuse (
Set[int]، اختياري) — ستتم دمج جميع الأمثلة الخاصة بالتسميات في هذه الحالة معًا. على سبيل المثال، يمكن القول إنه لا يمكن أن يوجد سوى سماء واحدة في صورة، بينما يمكن أن يوجد عدة أشخاص، لذا فإن معرّف التسمية الخاص بالسماء سيكون ضمن ذلك المجموع، بينما لن يكون معرّف التسمية الخاص بالشخص كذلك. - target_sizes (
list[Tuple], اختياري) — قائمة بطول (batch_size)، حيث يقابل كل عنصر في القائمة (tuple[int, int]]) الحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ في الدفعة. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات.
يعيد
list[Dict]
قائمة من القواميس، قواميس واحدة لكل صورة، يحتوي كل قاموس على مفتاحين:
- segmentation — متجه (tensor) بأبعاد
(height, width)حيث يمثل كل بكسلsegment_id، ويُعيَّن إلىNoneإذا لم يُعثر على قناع (mask) أعلى منthreshold. إذا تم تحديدtarget_sizes، يتم تغيير حجم segmentation إلى القيمة المقابلة فيtarget_sizes. - segments_info — قاموس يحتوي على معلومات إضافية حول كل مقطع.
- id — عدد صحيح يمثل
segment_id. - label_id — عدد صحيح يمثل معرّف التسمية/الفئة الدلالية المقابلة لـ
segment_id. - was_fused — قيمة منطقية، تكون
Trueإذا كانlabel_idضمنlabel_ids_to_fuse، وإلا تكونFalse. تم دمج عدة حالات من نفس الفئة / التسمية وتم إسنادsegment_idواحد إليها. - score — درجة التنبؤ للمقطع ذي
segment_id.
- id — عدد صحيح يمثل
يحوّل مخرجات MaskFormerForInstanceSegmentationOutput إلى تنبؤات تقسيم بانورامي للصور. يدعم PyTorch فقط.
MaskFormerModel
فئة transformers.MaskFormerModel
< source >( config: MaskFormerConfig )
المعاملات
- config (MaskFormerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Maskformer الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskFormerModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام MaskFormerImageProcessor. راجع MaskFormerImageProcessor.call() للتفاصيل (processor_classيستخدم MaskFormerImageProcessor لمعالجة الصور). - pixel_mask (
torch.Tensorبشكل(batch_size, height, width), اختياري) — قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة من[0, 1]:- 1 للبيكسلات الحقيقية (أي غير المقنّعة)،
- 0 للبيكسلات التي تمثل حشواً (أي مقنّعة).
- output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MaskFormerModelOutput أو tuple(torch.Tensor)
MaskFormerModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (MaskFormerConfig) والمدخلات.
تتجاوز طريقة MaskFormerModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج المُشفِّر (الهيكل الأساسي).pixel_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحص البكسل (FPN).transformer_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحص التحوّل.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات المخفية (المعروفة أيضًا باسم خرائط الميزات) لنموذج المُشفِّر عند إخراج كل مرحلة.pixel_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) لنموذج فك ترميز البكسلات عند إخراج كل مرحلة.transformer_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, sequence_length, hidden_size). حالات المخفية (المعروفة أيضًا باسم خرائط الميزات) لمفكك التحويل عند إخراج كل مرحلة. hidden_statestuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True): مجموعة منtorch.Tensorتحتوي علىencoder_hidden_statesوpixel_decoder_hidden_statesوdecoder_hidden_stateshidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, MaskFormerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on ADE20k semantic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-ade")
>>> model = MaskFormerModel.from_pretrained("facebook/maskformer-swin-base-ade")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = image_processor(image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # the decoder of MaskFormer outputs hidden states of shape (batch_size, num_queries, hidden_size)
>>> transformer_decoder_last_hidden_state = outputs.transformer_decoder_last_hidden_state
>>> list(transformer_decoder_last_hidden_state.shape)
[1, 100, 256]
MaskFormerForInstanceSegmentation
forward
< source >( pixel_values: Tensormask_labels: list[torch.Tensor] | None = Noneclass_labels: list[torch.Tensor] | None = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_auxiliary_logits: bool | None = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskFormerForInstanceSegmentationOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام MaskFormerImageProcessor. راجع MaskFormerImageProcessor.call() للتفاصيل (processor_classيستخدم MaskFormerImageProcessor لمعالجة الصور). - mask_labels (
list[torch.Tensor]، اختياري) — قائمة بتسميات الأقنعة ذات الشكل(num_labels, height, width)لتغذية النموذج - class_labels (
list[torch.LongTensor], اختياري) — قائمة بتسميات الفئات المستهدفة ذات الأبعاد(num_labels, height, width)لتغذية النموذج. تحدد هذه القائمة تسمياتmask_labels، على سبيل المثال تسميةmask_labels[i][j]إذا كانتclass_labels[i][j]. - pixel_mask (
torch.Tensorبشكل(batch_size, height, width), اختياري) — قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة من[0, 1]:- 1 للبيكسلات الحقيقية (أي غير المقنّعة)،
- 0 للبيكسلات التي تمثل حشواً (أي مقنّعة).
- output_auxiliary_logits (
bool, اختياري) — ما إذا كان يجب إخراج قيم logits المساعدة أم لا. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MaskFormerForInstanceSegmentationOutput أو tuple(torch.Tensor)
MaskFormerForInstanceSegmentationOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (MaskFormerConfig) والمدخلات.
تتجاوز طريقة MaskFormerForInstanceSegmentation الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensor، اختياري) — الخسارة المحسوبة، تُعاد عند وجود التسميات.class_queries_logits (
torch.Tensor، اختياري) — متجه (Tensor) على شكل(batch_size, num_queries, num_labels + 1)يمثل الفئات المقترحة لكل استعلام. لاحظ أن+ 1ضروري لأننا ندمج فئة فارغة (null class).masks_queries_logits (
torch.Tensor، اختياري) — متجه ذو شكل(batch_size, num_queries, height, width)يمثل الأقنعة المقترحة لكل استعلام.auxiliary_logits (
Dict[str, torch.Tensor]، اختياري، يُعاد عندoutput_auxiliary_logits=True) — قاموس يحتوي على التنبؤات المساعدة لكل طبقة من طبقات المُفكِّك (decoder) عند تفعيل الخسائر المساعدة.encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج المُشفِّر (الهيكل الأساسي).pixel_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحص البكسل (FPN).transformer_decoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — حالات المخفية الأخيرة (خريطة الميزات النهائية) للمرحلة الأخيرة من نموذج فاحص التحوّل.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات المخفية (المعروفة أيضًا باسم خرائط الميزات) لنموذج المُشفِّر عند إخراج كل مرحلة.pixel_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) لنموذج فك ترميز البكسلات عند إخراج كل مرحلة.transformer_decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, sequence_length, hidden_size). حالات المخفية لمفكك التحويل عند إخراج كل مرحلة. hidden_statestuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True): مجموعة منtorch.Tensorتحتوي علىencoder_hidden_statesوpixel_decoder_hidden_statesوdecoder_hidden_states.hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
مثال على التقسيم الدلالي:
>>> from transformers import AutoImageProcessor, MaskFormerForInstanceSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on ADE20k semantic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-ade")
>>> model = MaskFormerForInstanceSegmentation.from_pretrained("facebook/maskformer-swin-base-ade")

>>> url = (
...     "https://huggingface.co/datasets/hf-internal-testing/fixtures_ade20k/resolve/main/ADE_val_00000001.jpg"
... )
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to image_processor for postprocessing
>>> predicted_semantic_map = image_processor.post_process_semantic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]

>>> # we refer to the demo notebooks for visualization (see "Resources" section in the MaskFormer docs)
>>> list(predicted_semantic_map.shape)
[512, 683]
مثال على التقطيع البانورامي:
>>> from transformers import AutoImageProcessor, MaskFormerForInstanceSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # load MaskFormer fine-tuned on COCO panoptic segmentation
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/maskformer-swin-base-coco")
>>> model = MaskFormerForInstanceSegmentation.from_pretrained("facebook/maskformer-swin-base-coco")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to image_processor for postprocessing
>>> result = image_processor.post_process_panoptic_segmentation(outputs, target_sizes=[(image.height, image.width)])[0]

>>> # we refer to the demo notebooks for visualization (see "Resources" section in the MaskFormer docs)
>>> predicted_panoptic_map = result["segmentation"]
>>> list(predicted_panoptic_map.shape)
[480, 640]