
Transformers documentation
ResNet
نُشر هذا النموذج في أوراق HF في 10-12-2015، وأُضيف إلى مكتبة Hugging Face Transformers في 14-03-2022.
ResNet
نظرة عامة
قُدِّم نموذج ResNet في Deep Residual Learning for Image Recognition بواسطة Kaiming He وXiangyu Zhang وShaoqing Ren وJian Sun. تتبع تنفيعتنا التعديلات الصغيرة التي أجراها Nvidia، حيث نطبّق stride=2 لعملية تقليل الحجم في طبقة الالتفاف 3x3 الخاصة بـ bottleneck وليس في طبقة 1x1 الأولى. ويُعرف هذا النهج بشكل عام باسم “ResNet v1.5”.
قدّم ResNet اتصالات متبقية، تتيح تدريب شبكات بعدد غير مسبوق من الطبقات (حتى 1000). فاز ResNet بمسابقة ILSVRC & COCO لعام 2015، وهو إنجاز مهم في مجال الرؤية الحاسوبية العميقة.
المستخلص من الورقة البحثية هو كالتالي:
تُعد الشبكات العصبية الأعمق أكثر صعوبة في التدريب. نقدم إطارًا للتعلم المتبقي لتسهيل تدريب الشبكات التي تكون أعمق بكثير من تلك المستخدمة سابقًا. نعيد صياغة الطبقات صراحةً على أنها تتعلم دوالًا متبقية مع الإشارة إلى مدخلات الطبقة، بدلاً من تعلم دوال غير مرجعية. نقدم أدلة تجريبية شاملة تُظهر أن هذه الشبكات المتبقية أسهل في التحسين، ويمكنها تحقيق دقة أعلى من خلال زيادة كبيرة في العمق. على مجموعة بيانات ImageNet، نقيّم الشبكات المتبقية بعمق يصل إلى 152 طبقة، أي أعمق بثمانية أضعاف من شبكات VGG ومع ذلك تعقيد أقل. يحقق تجميع من هذه الشبكات المتبقية خطأً بنسبة 3.57% على مجموعة اختبار ImageNet. فاز هذا النتيجة بالمركز الأول في مهمة التصنيف في ILSVRC 2015. كما نقدم تحليلًا على CIFAR-10 باستخدام 100 و1000 طبقة. يُعد عمق التمثيلات ذا أهمية مركزية للعديد من مهام التعرف البصري. بفضل تمثيلاتنا العميقة للغاية فقط، نحقق تحسينًا نسبيًا بنسبة 28% على مجموعة بيانات COCO للكشف عن الكائنات. تُعد الشبكات المتبقية العميقة أساسًا لمشاركاتنا في مسابقات ILSVRC & COCO 2015، حيث فزنا أيضًا بالمراكز الأولى في مهام كشف ImageNet، وتحديد موقع ImageNet، وكشف COCO، وتجزئة COCO.
يوضح الشكل أدناه بنية ResNet. مأخوذة من الورقة الأصلية.
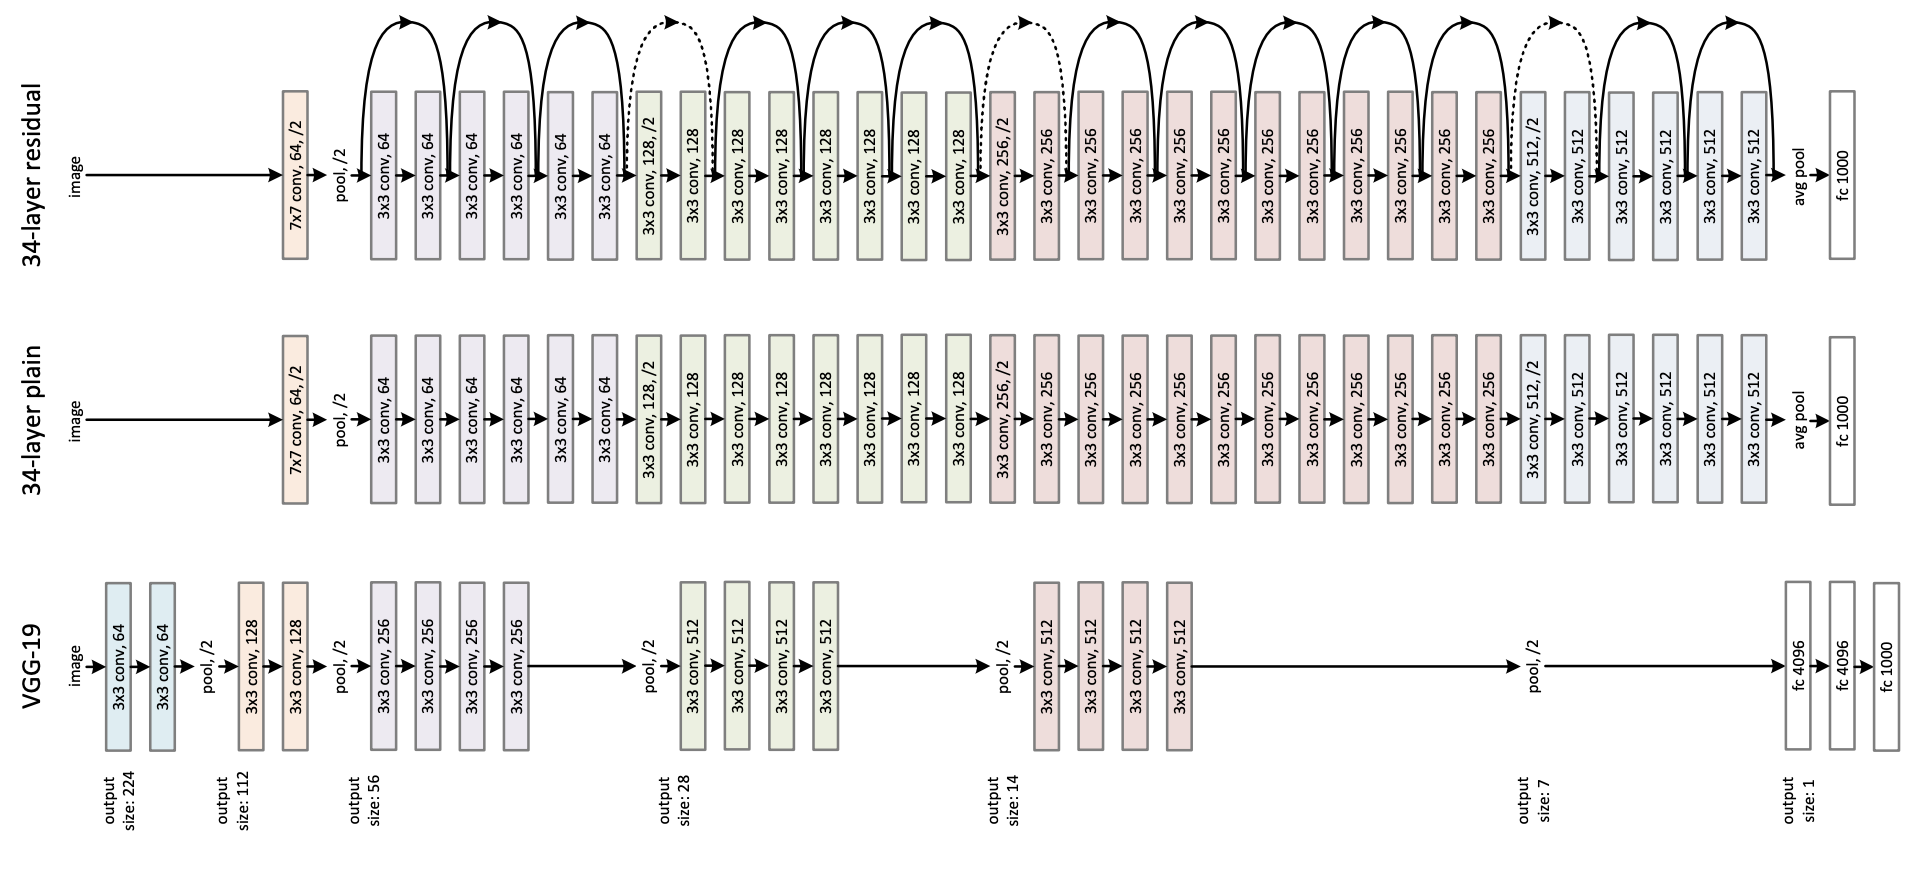
تمت مساهمة هذا النموذج من قِبل Francesco. يمكن العثور على الكود الأصلي هنا.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء مع ResNet.
- يُؤمّن ResNetForImageClassification دعمًا لهذا دفتر الملاحظات.
- انظر أيضاً: دليل مهمة تصنيف الصور
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
ResNetConfig
فئة transformers.ResNetConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3embedding_size: int = 64hidden_sizes: list[int] | tuple[int, ...] | None = (256, 512, 1024, 2048)depths: list[int] | tuple[int, ...] | None = (3, 4, 6, 3)layer_type: str = 'bottleneck'hidden_act: str = 'relu'downsample_in_first_stage: bool = Falsedownsample_in_bottleneck: bool = False )
المعاملات
- num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - embedding_size (
int، اختياري، القيمة الافتراضية64) — أبعاد التضمينات والحالات المخفية. - hidden_sizes (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(256, 512, 1024, 2048)) — البُعد (حجم الطبقة المخفية) في كل مرحلة من مراحل النموذج. - depths (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(3, 4, 6, 3)) — عمق كل طبقة في Transformer. - layer_type (
str، اختياري، القيمة الافتراضية"bottleneck") — الطبقة المستخدمة، ويمكن أن تكون إما"basic"(تُستخدم للنماذج الأصغر، مثل resnet-18 أو resnet-34) أو"bottleneck"(تُستخدم للنماذج الأكبر مثل resnet-50 وما فوق). - hidden_act (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - downsample_in_first_stage (
bool، اختياري، القيمة الافتراضيةFalse) — إذا كانتTrue، فسيقوم المرحل الأول بتقليل حجم المدخلات باستخدامstrideبقيمة 2. - downsample_in_bottleneck (
bool، اختياري، القيمة الافتراضيةFalse) — إذا كانتTrue، فإن طبقة التمرير الأولى 1x1 في ResNetBottleNeckLayer ستقوم بتقليل حجم المدخلات باستخدامstrideبقيمة 2.
هذه فئة الإعدادات المخزنة لإعدادات نموذج ResNetModel. تُستخدم لاستحداث نموذج Resnet وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/resnet-50
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import ResNetConfig, ResNetModel

>>> # Initializing a ResNet resnet-50 style configuration
>>> configuration = ResNetConfig()

>>> # Initializing a model (with random weights) from the resnet-50 style configuration
>>> model = ResNetModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.configتحقق من أن layer_types معرّفة بشكل صحيح.
ResNetModel
فئة transformers.ResNetModel
< source >( config: ResNetConfig )
المعاملات
- config (ResNetConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Resnet الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensoroutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithPoolingAndNoAttention or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ConvNextImageProcessor. راجع ConvNextImageProcessor.call() للتفاصيل (يستخدمprocessor_classConvNextImageProcessor لمعالجة الصور). - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
BaseModelOutputWithPoolingAndNoAttention أو tuple(torch.Tensor)
BaseModelOutputWithPoolingAndNoAttention أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (ResNetConfig) والمدخلات.
تتجاوز طريقة ResNetModel الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — تسلسل من حالات الإخفاء عند مخرجات الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة بعد عملية تجميع على الأبعاد المكانية.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, num_channels, height, width).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
ResNetForImageClassification
فئة transformers.ResNetForImageClassification
< source >( config: ResNetConfig )
المعاملات
- config (ResNetConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج ResNet مع رأس تصنيف الصور في الأعلى (طبقة خطية فوق الميزات المجمّعة)، على سبيل المثال لـ ImageNet.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام ConvNextImageProcessor. راجع ConvNextImageProcessor.call() للتفاصيل (processor_classيستخدم ConvNextImageProcessor لمعالجة الصور). - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (Cross-Entropy). - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
ImageClassifierOutputWithNoAttention أو tuple(torch.Tensor)
ImageClassifierOutputWithNoAttention أو مجموعة (tuple) من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (ResNetConfig) والمدخلات.
تتجاوز طريقة ResNetForImageClassification الخاصة بالتقديم الأمامي الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1). - logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax). - hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) للنموذج عند إخراج كل مرحلة.
مثال:
>>> from transformers import AutoImageProcessor, ResNetForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/resnet-50")
>>> model = ResNetForImageClassification.from_pretrained("microsoft/resnet-50")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...