
Transformers documentation
SegFormer
نُشر هذا النموذج في أوراق HF في 31 مايو 2021، وأُضيف إلى مكتبة Hugging Face Transformers في 28 أكتوبر 2021.
SegFormer
SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers is a semantic segmentation model that combines a hierarchical Transformer encoder (Mix Transformer, MiT) with a lightweight all-MLP decoder. It avoids positional encodings and complex decoders and achieves state-of-the-art performance on benchmarks like ADE20K and Cityscapes. This simple and lightweight design is more efficient and scalable.
يوضح الشكل أدناه بنية SegFormer.
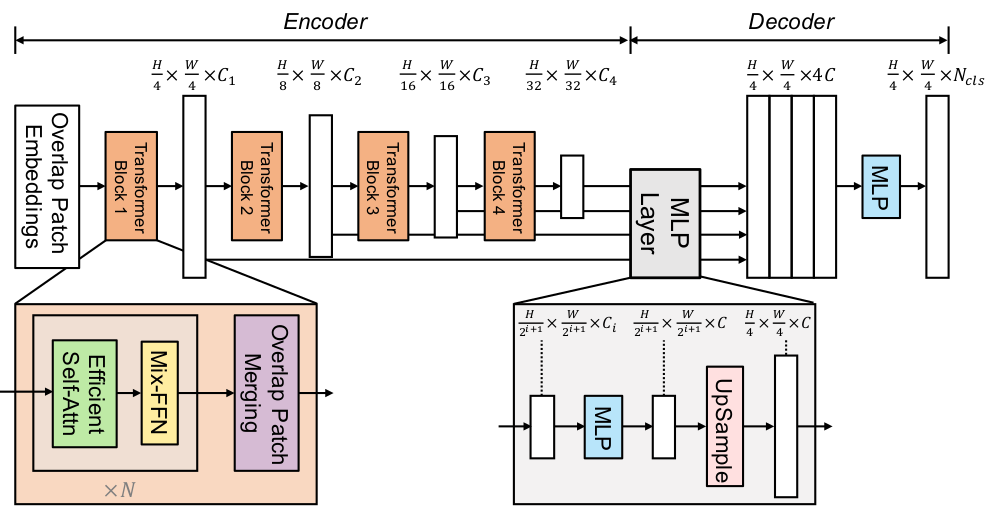
يمكنك العثور على جميع نقاط التفتيش الأصلية لنموذج SegFormer تحت منظمة NVIDIA.
تمت مساهمة هذا النموذج من قِبل nielsr.
انقر على نماذج SegFormer في الشريط الجانبي الأيمن لمزيد من الأمثلة حول كيفية تطبيق SegFormer على مهام الرؤية المختلفة.
يُوضّح المثال أدناه التقسيم الدلالي باستخدام Pipeline أو فئة AutoModel.
from transformers import pipeline


pipeline = pipeline(task="image-segmentation", model="nvidia/segformer-b0-finetuned-ade-512-512")
pipeline("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg")import requests
from PIL import Image
from transformers import AutoModelForSemanticSegmentation, AutoProcessor
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = AutoProcessor.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512")
model = AutoModelForSemanticSegmentation.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512", device_map="auto")
inputs = processor(images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
logits = outputs.logits # shape [batch, num_labels, height, width]ملاحظات
يعمل SegFormer مع أي حجم إدخال، حيث يقوم بتعبئة المدخلات بحيث تكون قابلة للقسمة على
config.patch_sizes.أهم خطوة في المعالجة المسبقة هي قصّ جميع الصور عشوائياً وتعبئتها حتى تصبح بنفس الحجم (مثل 512x512 أو 640x640) ثم تطبيعها بعد ذلك.
تستخدم بعض مجموعات البيانات (ADE20k) الفهرس
0في التقطيع المُعلَّم كخلفية، لكنها لا تتضمن فئة "الخلفية" في تسمياتها. يُستخدم الحُجّةdo_reduce_labelsفيSegformerForImageProcessorلتقليل جميع التسميات بمقدار1. ولضمان عدم حساب أي خسارة لفئة الخلفية، يستبدل0في خرائط التعلُّم بـ255، وهو قيمةignore_indexفي دالة الخسارة.قد تتضمن مجموعات بيانات أخرى فئة خلفية وتسمية، وفي هذه الحالة يجب أن يكون
do_reduce_labelsبقيمةFalse.
from transformers import SegformerImageProcessor


processor = SegformerImageProcessor(do_reduce_labels=True)
الموارد
- Original SegFormer code (NVlabs)
- منشور مدونة حول الضبط الدقيق
- دفاتر التعليم (نييلز روجي)
- مساحة عرض Hugging Face
SegformerConfig
فئة transformers.SegformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3num_encoder_blocks: int = 4depths: list[int] | tuple[int, ...] = (2, 2, 2, 2)sr_ratios: list[int] | tuple[int, ...] = (8, 4, 2, 1)hidden_sizes: list[int] | tuple[int, ...] = (32, 64, 160, 256)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)num_attention_heads: list[int] | tuple[int, ...] = (1, 2, 5, 8)mlp_ratios: list[int] | tuple[int, ...] = (4, 4, 4, 4)hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0classifier_dropout_prob: float | int = 0.1initializer_range: float = 0.02drop_path_rate: float | int = 0.1layer_norm_eps: float = 1e-06decoder_hidden_size: int = 256semantic_loss_ignore_index: int = 255reshape_last_stage: bool = True )
المعاملات
- num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - num_encoder_blocks (
int، اختياري، القيمة الافتراضية 4) — عدد كتل المُشفِّر (أي المراحل في مُشفِّر Mix Transformer). - depths (
list[int]، اختياري، القيمة الافتراضية[2, 2, 2, 2]) — عدد الطبقات في كل كتلة من كُتل المُشفِّر. - sr_ratios (
list[int]، اختياري، القيمة الافتراضية[8, 4, 2, 1]) — نسب اختزال التسلسل في كل كتلة من وحدات الترميز. - hidden_sizes (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(32, 64, 160, 256)) — البُعد (حجم الطبقة المخفية) في كل مرحلة من مراحل النموذج. - patch_sizes (
list[int]، اختياري، القيمة الافتراضية[7, 3, 3, 3]) — حجم الباتش قبل كل كتلة من مشفّرات الترميز. - strides (
list[int]، اختياري، القيمة الافتراضية[4, 2, 2, 2]) — الخطوة قبل كل كتلة من مشفّرات (encoder) - num_attention_heads (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(1, 2, 5, 8)) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - mlp_ratios (
list[int]، اختياري، القيمة الافتراضية[4, 4, 4, 4]) — نسبة حجم الطبقة المخفية إلى حجم طبقة الإدخال في وحدات Mix FFNs داخل كتل المُشفِّر. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - classifier_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة dropout الخاصة بتصنيفي. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - drop_path_rate (
Union[float, int], اختياري، القيمة الافتراضية0.1) — معدل إسقاط المسار (Drop path) لدمج البقع (patch fusion). - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - decoder_hidden_size (
int, اختياري، القيمة الافتراضية256) — أبعاد التمثيلات المخفية. - semantic_loss_ignore_index (
int، اختياري، القيمة الافتراضية255) — المؤشر الذي تتجاهله دالة الخسارة في نموذج التقسيم الدلالي. - reshape_last_stage (
bool، اختياري، القيمة الافتراضية True) — ما إذا كان يجب إعادة تشكيل مخرجات المرحلة الأخيرة
هذه فئة الإعدادات المخزنة لإعدادات نموذج SegformerModel. تُستخدم لاستحداث نموذج Segformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ ByteDance-Seed/Seed-OSS-36B-Instruct
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import SegformerModel, SegformerConfig

>>> # Initializing a SegFormer nvidia/segformer-b0-finetuned-ade-512-512 style configuration
>>> configuration = SegformerConfig()

>>> # Initializing a model from the nvidia/segformer-b0-finetuned-ade-512-512 style configuration
>>> model = SegformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SegformerImageProcessor
فئة transformers.SegformerImageProcessor
< source >( **kwargs: *<class 'transformers.models.segformer.image_processing_segformer.SegformerImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 512, 'width': 512}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs، القيمة الافتراضيةNone) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةNone) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
ينشئ معالج صور SegformerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.segformer.image_processing_segformer.SegformerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقسيم المراد معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
المعاملات
- outputs (SegformerForSemanticSegmentation) — المخرجات الخام للنموذج.
- target_sizes (
list[Tuple]بطولbatch_size، اختياري) — قائمة من الأ_tuples المقابلة للحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا لم يتم ضبطه، فلن يتم تغيير حجم التنبؤات. - return_segmentation_scores (
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع درجات التقسيم (segmentation scores) إلى جانب خريطة التقسيم. عند تعيينTrue، يكون كل عنصر من القائمة المُرجعة من نوعSemanticSegmentationPostProcessorOutputويحتوي على الحقولsegmentation(معرّفات الفئات، الشكل(height, width)) وsegmentation_scores(الشكل(num_classes, height, width)).
يعيد
list[torch.Tensor] أو list[SemanticSegmentationPostProcessorOutput]
عندما يكون return_segmentation_scores=False (الافتراضي)، تكون النتيجة قائمة بطول batch_size حيث يكون كل عنصر منها خريطة تجزئة (segmentation map) بأبعاد (height, width) تحتوي على معرّفات الفئات. أما عندما يكون return_segmentation_scores=True، فتكون النتيجة قائمة من SemanticSegmentationPostProcessorOutput تحتوي على الحقول segmentation (معرّفات الفئات، بأبعاد (height, width)) وsegmentation_scores (بأبعاد (num_classes, height, width)). في الحالتين، يمثل (height, width) الحجم المستهدف (إذا تم تحديد target_sizes).
يحوّل مخرجات SegformerForSemanticSegmentation إلى خرائط تجزئة دلالية.
SegformerImageProcessorPil
فئة transformers.SegformerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.segformer.image_processing_pil_segformer.SegformerImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 512, 'width': 512}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs، القيمة الافتراضيةNone) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةNone) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
ينشئ معالج صور SegformerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.segformer.image_processing_pil_segformer.SegformerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، اختياري) — خرائط التقسيم المراد معالجتها مسبقًا. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - do_reduce_labels (
bool، kwargs، اختياري، القيمة الافتراضيةself.do_reduce_labels) — ما إذا كان سيتم تقليل جميع قيم التسميات في خرائط التقسيم (segmentation maps) بمقدار 1. يُستخدم عادةً في مجموعات البيانات التي يُستخدم فيها الرقم 0 للخلفية، ولا تكون الخلفية نفسها مدرجة ضمن جميع فئات مجموعة البيانات (مثل ADE20k). سيتم استبدال تسمية الخلفية بالرقم 255.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
المعاملات
- outputs (SegformerForSemanticSegmentation) — المخرجات الخام للنموذج.
- target_sizes (
list[Tuple]بطولbatch_size، اختياري) — قائمة من الأ_tuples المقابلة للحجم النهائي المطلوب (الارتفاع، العرض) لكل تنبؤ. إذا لم يتم ضبطه، فلن يتم تغيير حجم التنبؤات. - return_segmentation_scores (
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع درجات التقسيم (segmentation scores) إلى جانب خريطة التقسيم. عند تعيينTrue، يكون كل عنصر من القائمة المُرجعة من نوعSemanticSegmentationPostProcessorOutputويحتوي على الحقولsegmentation(معرّفات الفئات، الشكل(height, width)) وsegmentation_scores(الشكل(num_classes, height, width)).
يعيد
list[torch.Tensor] أو list[SemanticSegmentationPostProcessorOutput]
عندما يكون return_segmentation_scores=False (الافتراضي)، تكون النتيجة قائمة بطول batch_size حيث يكون كل عنصر منها خريطة تجزئة (segmentation map) بأبعاد (height, width) تحتوي على معرّفات الفئات. أما عندما يكون return_segmentation_scores=True، فتكون النتيجة قائمة من SemanticSegmentationPostProcessorOutput تحتوي على الحقول segmentation (معرّفات الفئات، بأبعاد (height, width)) وsegmentation_scores (بأبعاد (num_classes, height, width)). في الحالتين، يمثل (height, width) الحجم المستهدف (إذا تم تحديد target_sizes).
يحوّل مخرجات SegformerForSemanticSegmentation إلى خرائط تجزئة دلالية.
SegformerModel
فئة transformers.SegformerModel
< source >( config: SegformerConfig )
المعاملات
- config (SegformerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Segformer الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensor**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام SegformerImageProcessor. راجع SegformerImageProcessor.call() للتفاصيل (processor_classيستخدم SegformerImageProcessor لمعالجة الصور).
يعيد
BaseModelOutput أو tuple(torch.Tensor)
BaseModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (SegformerConfig) والمدخلات.
تتجاوز طريقة SegformerModel الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
SegformerDecodeHead
SegformerForImageClassification
فئة transformers.SegformerForImageClassification
< source >( config: SegformerConfig )
المعاملات
- config (SegformerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج SegFormer وهو نموذج transformer مع رأس تصنيف صور في الأعلى (طبقة خطية فوق الحالات المخفية النهائية) على سبيل المثال لـ ImageNet.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SegFormerImageClassifierOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام SegformerImageProcessor. راجع SegformerImageProcessor.call() للتفاصيل (يستخدمprocessor_classSegformerImageProcessor لمعالجة الصور). - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
يعيد
SegFormerImageClassifierOutput أو tuple(torch.Tensor)
SegFormerImageClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعدادات (SegformerConfig) والمدخلات.
تتجاوز طريقة SegformerForImageClassification الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) للنموذج عند إخراج كل مرحلة.attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoImageProcessor, SegformerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("ByteDance-Seed/Seed-OSS-36B-Instruct")
>>> model = SegformerForImageClassification.from_pretrained("ByteDance-Seed/Seed-OSS-36B-Instruct")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
SegformerForSemanticSegmentation
فئة transformers.SegformerForSemanticSegmentation
< source >( config: SegformerConfig )
المعاملات
- config (SegformerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج SegFormer وهو نموذج تحويلي (Transformer) مزوّد برأس فكّ ترميز (decode head) يعتمد بالكامل على شبكات متعددة الطبقات (MLP) في قمته، ويُستخدم على سبيل المثال في مهام ADE20k وCityScapes.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorlabels: typing.Optional[torch.LongTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SemanticSegmenterOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام SegformerImageProcessor. راجع SegformerImageProcessor.call() للتفاصيل (processor_classيستخدم SegformerImageProcessor لمعالجة الصور). - labels (
torch.LongTensorمن الشكل(batch_size, height, width)، اختياري) — خرائط التقسيم الدلالي الصحيحة (Ground truth) لحساب الخسارة. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels > 1، يتم حساب خسارة التصنيف (Cross-Entropy).
يعيد
SemanticSegmenterOutput أو tuple(torch.Tensor)
SemanticSegmenterOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (SegformerConfig) والمدخلات.
تتجاوز طريقة SegformerForSemanticSegmentation الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels, logits_height, logits_width)) — درجات التصنيف لكل بكسل.The logits returned do not necessarily have the same size as the
pixel_valuespassed as inputs. This is to avoid doing two interpolations and lose some quality when a user needs to resize the logits to the original image size as post-processing. You should always check your logits shape and resize as needed.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, patch_size, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, SegformerForSemanticSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> image_processor = AutoImageProcessor.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512")
>>> model = SegformerForSemanticSegmentation.from_pretrained("nvidia/segformer-b0-finetuned-ade-512-512")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits  # shape (batch_size, num_labels, height/4, width/4)
>>> list(logits.shape)
[1, 150, 128, 128]