
Transformers documentation
محوّل الانتباه الجواري المتوسّع
نُشر هذا النموذج في أوراق HF في 29 سبتمبر 2022، وأُضيف إلى مكتبة Hugging Face Transformers في 18 نوفمبر 2022.
محوّل الانتباه الجواري المتوسّع
نظرة عامة
قُدم نموذج DiNAT في Dilated Neighborhood Attention Transformer من قِبل Ali Hassani و Humphrey Shi.
يوسّع NAT من خلال إضافة نمط انتباه الجوار المتوسع (Dilated Neighborhood Attention) لالتقاط السياق العام، ويظهر تحسّنات أداء كبيرة مقارنة به.
المستخلص من الورقة البحثية هو كالتالي:
أصبحت نماذج Transformers بسرعة واحدة من أكثر معماريات التعلم العميق تطبيقاً عبر الأنماط والمجالات والمهام. في مجال الرؤية، إلى جانب الجهود المستمرة نحو استخدام المحولات البسيطة (plain transformers)، حظيت المحولات الهرمية (hierarchical transformers) باهتمام كبير بفضل أدائها وسهولة دمجها في الأطر الحالية. تعتمد هذه النماذج عادةً على آليات انتباه محلية (localized attention mechanisms)، مثل الانتباه الجار المتحرك (sliding-window Neighborhood Attention - NA) أو الانتباه الذاتي النافذ المزاح (Shifted Window Self Attention) في Swin Transformer. وعلى الرغم من فعاليتها في تقليل التعقيد التربيعي للانتباه الذاتي، فإن الانتباه المحلي يضعف اثنين من أكثر خصائص الانتباه الذاتي رغبةً: نمذجة الاعتماديات طويلة المدى، والمجال الاستقبالي الشامل. في هذه الورقة، نقدم الانتباه الجار المتباعد (Dilated Neighborhood Attention - DiNA)، وهو امتداد طبيعي ومرن وفعال لـ NA يمكنه التقاط سياق أكثر شمولا وتوسيع المجالات الاستقبالية بشكل أسي دون أي تكلفة إضافية. يكمل الانتباه المحلي في NA الانتباه الشامل المتناثر في DiNA، ولذلك نقدم محول الانتباه الجار المتباعد (Dilated Neighborhood Attention Transformer - DiNAT)، وهو محول رؤية هرمي جديد مبني على كليهما. تتمتع نسخ DiNAT بتحسينات كبيرة مقارنة بخطوط الأساس القوية مثل NAT وSwin وConvNeXt. نموذجنا الكبير أسرع ويتفوق على نظيره من Swin بنسبة 1.5% في box AP في كشف الكائنات في COCO، و1.3% في mask AP في تجزئة الكائنات في COCO، و1.1% في mIoU في التجزئة الدلالية في ADE20K. عند اقترانه بأطر جديدة، يُعدّ نموذجنا الكبير الجديد نموذج التجزئة البانوبتيك (panoptic segmentation) الأكثر تقدماً في COCO (58.2 PQ) وADE20K (48.5 PQ)، ونموذج التجزئة الكائنية (instance segmentation) في Cityscapes (44.5 AP) وADE20K (35.4 AP) (بدون بيانات إضافية). كما يطابق نماذج التجزئة الدلالية المتخصصة الأكثر تقدماً في ADE20K (58.2 mIoU)، ويحتل المرتبة الثانية في Cityscapes (84.5 mIoU) (بدون بيانات إضافية).
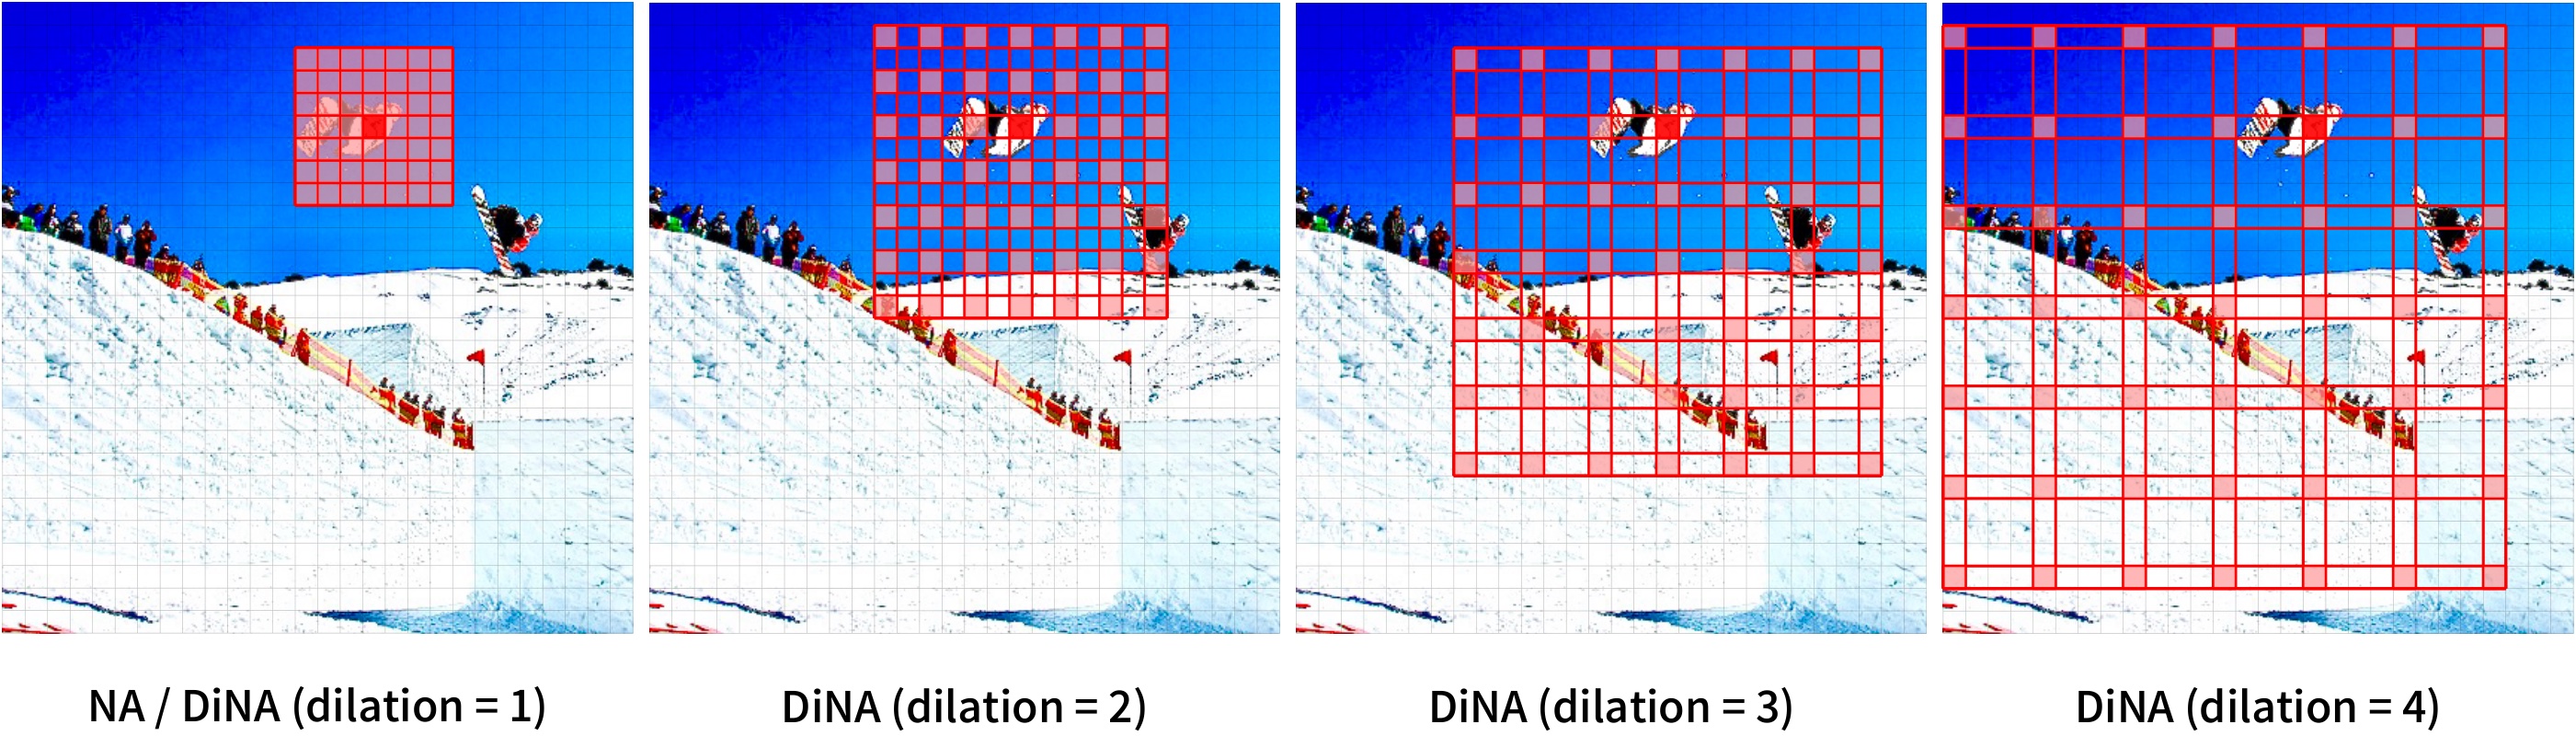 Neighborhood Attention with different dilation values.
Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل Ali Hassani. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
يمكن استخدام DiNAT كـ هيكل أساسي. عند تعيين output_hidden_states = True،
سيُخرج كلًا من hidden_states وreshaped_hidden_states. وتتميز reshaped_hidden_states بشكل (batch, num_channels, height, width) بدلاً من (batch_size, height, width, num_channels).
ملاحظات:
- يعتمد DiNAT على تنفيذ NATTEN لانتباه الجوار وانتباه الجوار المتباعد.
يمكنك تثبيته باستخدام عجلات مبنية مسبقًا لنظام Linux بالرجوع إلى shi-labs.com/natten، أو ببنائه على نظامك عبر تشغيل
pip install natten. يُرجى ملاحظة أن الخيار الأخير سيستغرق على الأرجح وقتًا طويلاً للتجميع. ولا يدعم NATTEN أجهزة Windows بعد. - حالياً، يُدعم حجم رقعة (Patch) يساوي 4 فقط.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء مع DiNAT.
- يُؤمَّن دعم DinatForImageClassification من خلال هذا دفتر ملاحظات.
- انظر أيضاً: دليل مهمة تصنيف الصور
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
DinatConfig
فئة transformers.DinatConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonepatch_size: int | list[int] | tuple[int, int] = 4num_channels: int = 3embed_dim: int = 64depths: list[int] | tuple[int, ...] = (3, 4, 6, 5)num_heads: list[int] | tuple[int, ...] = (2, 4, 8, 16)kernel_size: int = 7dilations: list | tuple | None = Nonemlp_ratio: float = 3.0qkv_bias: bool = Truehidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0drop_path_rate: float | int = 0.1hidden_act: str = 'gelu'initializer_range: float = 0.02layer_norm_eps: float = 1e-05layer_scale_init_value: float = 0.0_out_features: list[str] | None = None_out_indices: list[int] | None = None )
المعاملات
- patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية4) — حجم (دقة) كل رقعة. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - embed_dim (
int، اختياري، القيمة الافتراضية64) — أبعاد التضمينات والحالات المخفية. - depths (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(3, 4, 6, 5)) — عمق كل طبقة في Transformer. - num_heads (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(2, 4, 8, 16)) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - kernel_size (
int، اختياري، القيمة الافتراضية7) — حجم نواة الالتفاف. - dilations (
list[list[int]]، اختياري، القيمة الافتراضية[[1, 8, 1], [1, 4, 1, 4], [1, 2, 1, 2, 1, 2], [1, 1, 1, 1, 1]]) — قيمة التمدد (Dilation) لكل طبقة NA في مُشفِّر Transformer. - mlp_ratio (
float، اختياري، القيمة الافتراضية3.0) — نسبة بُعد مخفي MLP إلى بُعد التضمين. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - drop_path_rate (
Union[float, int], اختياري، القيمة الافتراضية0.1) — معدل إسقاط المسار (Drop path) لدمج البقع (patch fusion). - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - layer_scale_init_value (
float, اختياري، القيمة الافتراضية0.0) — المقياس المستخدم في طبقات الانتباه الذاتي. 0.1 للنموذج الأساسي، و1e-6 للنماذج الكبيرة. اضبط القيمة على 0 لتعطيل مقياس الطبقة.
هذه فئة الإعدادات المخزنة لإعدادات نموذج DinatModel. تُستخدم لاستحداث نموذج Dinat وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ shi-labs/dinat-mini-in1k-224
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import DinatConfig, DinatModel

>>> # Initializing a Dinat shi-labs/dinat-mini-in1k-224 style configuration
>>> configuration = DinatConfig()

>>> # Initializing a model (with random weights) from the shi-labs/dinat-mini-in1k-224 style configuration
>>> model = DinatModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
DinatModel
فئة transformers.DinatModel
< source >( config: DinatConfigadd_pooling_layer = True )
المعاملات
- config (DinatConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
- add_pooling_layer (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة طبقة تجميع
نموذج Dinat الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DinatModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ViTImageProcessor. راجع ViTImageProcessor.call() للتفاصيل (يستخدمprocessor_classViTImageProcessor لمعالجة الصور). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
DinatModelOutput أو tuple(torch.Tensor)
DinatModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (DinatConfig) والمدخلات.
تُعيد طريقة DinatModel الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)، اختياري، يُعاد عند تمريرadd_pooling_layer=True) — متوسط تجميع (Average pooling) لحالة الإخفاء (hidden-state) للطبقة الأخيرة.hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
reshaped_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, hidden_size, height, width).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي المُعاد تشكيلها لتضمين الأبعاد المكانية.
DinatForImageClassification
فئة transformers.DinatForImageClassification
< source >( config: DinatConfig )
المعاملات
- config (DinatConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Dinat transformer مع رأس تصنيف الصور في الأعلى (طبقة خطية فوق الحالة المخفية النهائية لرمز [CLS])، على سبيل المثال لـ ImageNet.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DinatImageClassifierOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ViTImageProcessor. راجع ViTImageProcessor.call() للتفاصيل (يستخدمprocessor_classViTImageProcessor لمعالجة الصور). - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
DinatImageClassifierOutput أو tuple(torch.Tensor)
DinatImageClassifierOutput أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (DinatConfig) والمدخلات.
تُعيد طريقة DinatForImageClassification الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
reshaped_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل مرحلة) من الشكل(batch_size, hidden_size, height, width).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي المُعاد تشكيلها لتضمين الأبعاد المكانية.
مثال:
>>> from transformers import AutoImageProcessor, DinatForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("shi-labs/dinat-mini-in1k-224")
>>> model = DinatForImageClassification.from_pretrained("shi-labs/dinat-mini-in1k-224")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...