
Transformers documentation
PoolFormer
نُشر هذا النموذج في أوراق HF في 22 نوفمبر 2021، وأُضيف إلى مكتبة Hugging Face Transformers في 17 فبراير 2022.
PoolFormer
نظرة عامة
The PoolFormer model was proposed in MetaFormer is Actually What You Need for Vision by Sea AI Labs. Instead of designing complicated token mixer to achieve SOTA performance, the target of this work is to demonstrate the competence of transformer models largely stem from the general architecture MetaFormer.
المستخلص من الورقة البحثية هو كالتالي:
أظهرت نماذج Transformers إمكانات كبيرة في مهام الرؤية الحاسوبية. يُعتقد عادةً أن وحدة مزج الرموز المعتمدة على الانتباه (attention-based token mixer) هي المساهم الأكبر في كفاءة هذه النماذج. ومع ذلك، تُظهر أعمال حديثة أن وحدة الانتباه في نماذج Transformers يمكن استبدالها بوظائف MLP مكانية (spatial MLPs)، وأن النماذج الناتجة تحافظ على أداء جيد. بناءً على هذه الملاحظة، نفترض أن البنية العامة لنماذج Transformers، وليس وحدة مزج الرموز المحددة، هي الأهم لأداء النموذج. للتحقق من ذلك، استبدلنا عمدًا وحدة الانتباه في نماذج Transformers بمشغّل تجميع مكاني (spatial pooling) بسيط للغاية، بحيث يُنفَّذ مزج الرموز الأساسي فقط. وبالمفاجأة، لاحظنا أن النموذج المشتق، الذي سُمّي PoolFormer، يحقق أداءً تنافسيًا في مهام رؤية حاسوبية متعددة. على سبيل المثال، على مجموعة بيانات ImageNet-1K، يحقق PoolFormer دقة top-1 تبلغ 82.1%، متفوقًا على خط الأساس المُحسَّن جيدًا DeiT-B/ResMLP-B24 (التي تشبه نماذج الرؤية التحويلية/MLP) بفارق 0.3%/1.1% في الدقة، مع تقليل عدد المعاملات بنسبة 35%/52% وتقليل عدد عمليات الضرب والإضافة (MACs) بنسبة 48%/60%. إن فعالية PoolFormer تؤكد فرضيتنا وتدفعنا إلى إطلاق مفهوم "MetaFormer"، وهو بنية عامة مُستخلصة من نماذج Transformers دون تحديد مزج الرموز. بناءً على التجارب الواسعة، نجادل بأن MetaFormer هو العنصر الأساسي في تحقيق نتائج متفوقة للنماذج التحويلية الحديثة ونماذج MLP المماثلة في مهام الرؤية. وتُطالب هذه الدراسة بإجراء مزيد من الأبحاث المستقبلية المخصصة لتحسين MetaFormer بدلاً من التركيز على وحدات مزج الرموز. بالإضافة إلى ذلك، يمكن أن يعمل PoolFormer الذي اقترحناه كخط أساس أولي لتصميم بنية MetaFormer المستقبلية.
يوضح الشكل أدناه بنية PoolFormer. مأخوذة من الورقة الأصلية.
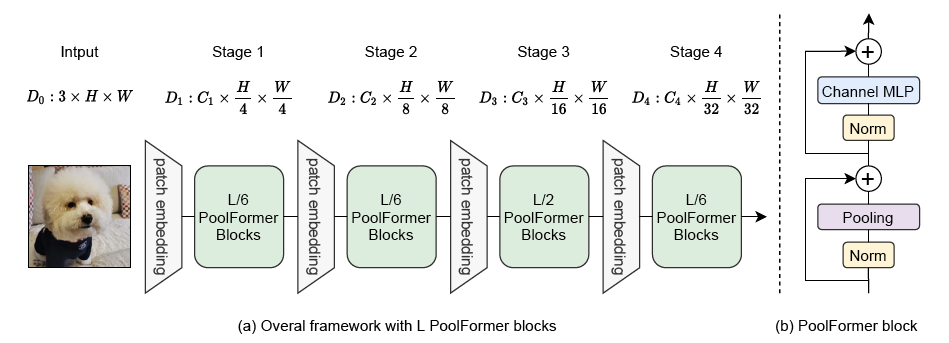
تمت مساهمة هذا النموذج من قِبل heytanay. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- يتميز PoolFormer ببنية هرمية، حيث يحلّ طبقة متوسط التجميع البسيطة محلّ الانتباه. يمكن العثور على جميع نقاط التفتيش الخاصة بالنموذج على المركز.
- يمكن استخدام PoolFormerImageProcessor لتحضير الصور للنموذج.
- كما هو الحال مع معظم النماذج، يتوفر PoolFormer بأحجام مختلفة، ويمكن العثور على تفاصيلها في الجدول أدناه.
| نموذج متغير | العمق | حجم المخفي | المعاملات (مليون) | أفضل نتيجة 1 في ImageNet-1k |
|---|---|---|---|---|
| s12 | [2, 2, 6, 2] | [64, 128, 320, 512] | 12 | 77.2 |
| s24 | [4, 4, 12, 4] | [64, 128, 320, 512] | 21 | 80.3 |
| s36 | [6, 6, 18, 6] | [64, 128, 320, 512] | 31 | 81.4 |
| m36 | [6, 6, 18, 6] | [96, 192, 384, 768] | 56 | 82.1 |
| m48 | [8, 8, 24, 8] | [96, 192, 384, 768] | 73 | 82.5 |
الموارد
قائمة بموارد رسمية من Hugging Face وموارد من المجتمع (المشار إليها بـ 🌎) لمساعدتك على البدء باستخدام PoolFormer.
- يُؤمَّن دعم PoolFormerForImageClassification من خلال هذا دفتر ملاحظات.
- انظر أيضاً: دليل مهمة تصنيف الصور
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
PoolFormerConfig
فئة transformers.PoolFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16stride: int = 16pool_size: int = 3mlp_ratio: float = 4.0depths: list[int] | tuple[int, ...] = (2, 2, 6, 2)hidden_sizes: list[int] | tuple[int, ...] = (64, 128, 320, 512)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)padding: list[int] | tuple[int, ...] = (2, 1, 1, 1)num_encoder_blocks: int = 4drop_path_rate: float | int = 0.0hidden_act: str = 'gelu'use_layer_scale: bool = Truelayer_scale_init_value: float = 1e-05initializer_range: float = 0.02 )
المعاملات
- num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - stride (
int، اختياري، القيمة الافتراضية 16) — خطوة البقعة المدخلة. - pool_size (
int، اختياري، القيمة الافتراضية 3) — حجم نافذة التجميع. - mlp_ratio (
float، اختياري، القيمة الافتراضية4.0) — نسبة بُعد مخفي MLP إلى بُعد التضمين. - depths (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(2, 2, 6, 2)) — عمق كل طبقة في Transformer. - hidden_sizes (
Union[list[int], tuple[int, ...]]، اختياري، القيمة الافتراضية(64, 128, 320, 512)) — البُعد (حجم الطبقة المخفية) في كل مرحلة من مراحل النموذج. - patch_sizes (
list، اختياري، القيمة الافتراضية[7, 3, 3, 3]) — حجم الباتش المدخل لكل كتلة مُشفِّر. - strides (
list، اختياري، القيمة الافتراضية[4, 2, 2, 2]) — خطوة البقعة المدخلة لكل كتلة من وحدات الترميز. - padding (
list، اختياري، القيمة الافتراضية[2, 1, 1, 1]) — الحشو (Padding) للرقعة المدخلة لكل كتلة مُشفِّر (encoder block). - num_encoder_blocks (
int، اختياري، القيمة الافتراضية 4) — عدد كتل المُشفِّر. - drop_path_rate (
Union[float, int], اختياري، القيمة الافتراضية0.0) — معدل إسقاط المسار (Drop path) لدمج البقع (patch fusion). - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - use_layer_scale (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام مقياس الطبقة. - layer_scale_init_value (
float, اختياري، القيمة الافتراضية1e-05) — المقياس المستخدم في طبقات الانتباه الذاتي. 0.1 للنموذج الأساسي، و1e-6 للنموذج الكبير. اضبط القيمة على 0 لتعطيل مقياس الطبقة. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات نموذج PoolFormerModel. تُستخدم لتوليد نموذج Poolformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ sail/poolformer_s12
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import PoolFormerConfig, PoolFormerModel

>>> # Initializing a PoolFormer sail/poolformer_s12 style configuration
>>> configuration = PoolFormerConfig()

>>> # Initializing a model (with random weights) from the sail/poolformer_s12 style configuration
>>> model = PoolFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PoolFormerImageProcessor
فئة transformers.PoolFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_poolformer.PoolFormerImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري، القيمة الافتراضيةNone) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية3) — مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enumPILImageResampling. لا يؤثر إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - crop_pct (
float، kwargs، اختياري، القيمة الافتراضيةself.crop_pct) — النسبة المئوية من الصورة التي سيتم اقتطاعها. لا يكون له تأثير إلا إذا تم ضبطdo_resizeعلىTrue.
ينشئ معالج صور من نوع PoolFormerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - image_like_kwargs (
dict[str, Any], اختياري) — علامة مخصّصة للمطوّرين لإدخال مدخلات إضافية مشابهة للصور ستخضع أيضاً للمعالجة المسبقة. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجج اسمية (kwargs). على سبيل المثال،preprocess(images, masks=masks)هو الخيار المفضّل، لكنه قد يسبّب مشاكل في أولوية الحُجج لبعض النماذج. في تلك الحالات يمكن استخدامpreprocess(images, image_like_inputs={"masks": masks})بدلاً منه. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
PoolFormerImageProcessorPil
فئة transformers.PoolFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_pil_poolformer.PoolFormerImageProcessorKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري، القيمة الافتراضيةNone) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية3) — مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enumPILImageResampling. لا يؤثر إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.485, 0.456, 0.406]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.229, 0.224, 0.225]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. - crop_pct (
float، kwargs، اختياري، القيمة الافتراضيةself.crop_pct) — النسبة المئوية من الصورة التي سيتم اقتطاعها. لا يكون له تأثير إلا إذا تم تعيينdo_resizeإلىTrue.
ينشئ معالج صور من نوع PoolFormerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — الصورة التي سيتم معالجتها مسبقاً. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صوراً بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - image_like_kwargs (
dict[str, Any], اختياري) — علامة مخصّصة للمطوّرين لإدخال مدخلات إضافية مشابهة للصور ستخضع أيضاً للمعالجة المسبقة. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجج اسمية (kwargs). على سبيل المثال،preprocess(images, masks=masks)هو الخيار المفضّل، لكنه قد يسبّب مشاكل في أولوية الحُجج لبعض النماذج. في تلك الحالات يمكن استخدامpreprocess(images, image_like_inputs={"masks": masks})بدلاً منه. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
PoolFormerModel
فئة transformers.PoolFormerModel
< source >( config: PoolFormerConfig )
المعاملات
- config (PoolFormerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Poolformer الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithNoAttention or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام PoolFormerImageProcessor. راجع PoolFormerImageProcessor.call() للتفاصيل (processor_classيستخدم PoolFormerImageProcessor لمعالجة الصور). - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
BaseModelOutputWithNoAttention أو tuple(torch.Tensor)
BaseModelOutputWithNoAttention أو مجموعة (tuple) من
torch.Tensor (في حال تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعدادات (PoolFormerConfig) والمدخلات.
تتجاوز طريقة PoolFormerModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, num_channels, height, width)) — تسلسل من حالات الإخفاء عند مخرجات الطبقة الأخيرة من النموذج.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, num_channels, height, width).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
PoolFormerForImageClassification
فئة transformers.PoolFormerForImageClassification
< source >( config: PoolFormerConfig )
المعاملات
- config (PoolFormerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج PoolFormer محوّل مع رأس تصنيف صور في الأعلى
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام PoolFormerImageProcessor. راجع PoolFormerImageProcessor.call() للتفاصيل (processor_classيستخدم PoolFormerImageProcessor لمعالجة الصور). - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
ImageClassifierOutputWithNoAttention أو tuple(torch.Tensor)
ImageClassifierOutputWithNoAttention أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (PoolFormerConfig) والمدخلات.
تتجاوز طريقة PoolFormerForImageClassification الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1). - logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax). - hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل مرحلة) من الشكل(batch_size, num_channels, height, width). حالات مخفية (تُسمى أيضًا خرائط الميزات) للنموذج عند إخراج كل مرحلة.
مثال:
>>> from transformers import AutoImageProcessor, PoolFormerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("sail/poolformer_s12")
>>> model = PoolFormerForImageClassification.from_pretrained("sail/poolformer_s12")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...