
Transformers documentation
SAM-HQ
نُشر هذا النموذج في أوراق HF في 2023-06-02 وسُهم به في Hugging Face Transformers في 2025-04-28.
SAM-HQ
نظرة عامة
قُدِّم نموذج SAM-HQ (نموذج Segment Anything عالي الجودة) في Segment Anything in High Quality بواسطة Lei Ke وMingqiao Ye وMartin Danelljan وYifan Liu وYu-Wing Tai وChi-Keung Tang وFisher Yu.
يُعدّ النموذج تحسينًا للنموذج الأصلي SAM، إذ ينتج أقنعة تجزئة بجودة أعلى بكثير مع الحفاظ على التصميم الأصلي القابل للتوجيه في SAM، وكفاءته، وقدرته على التعميم دون تدريب مسبق.
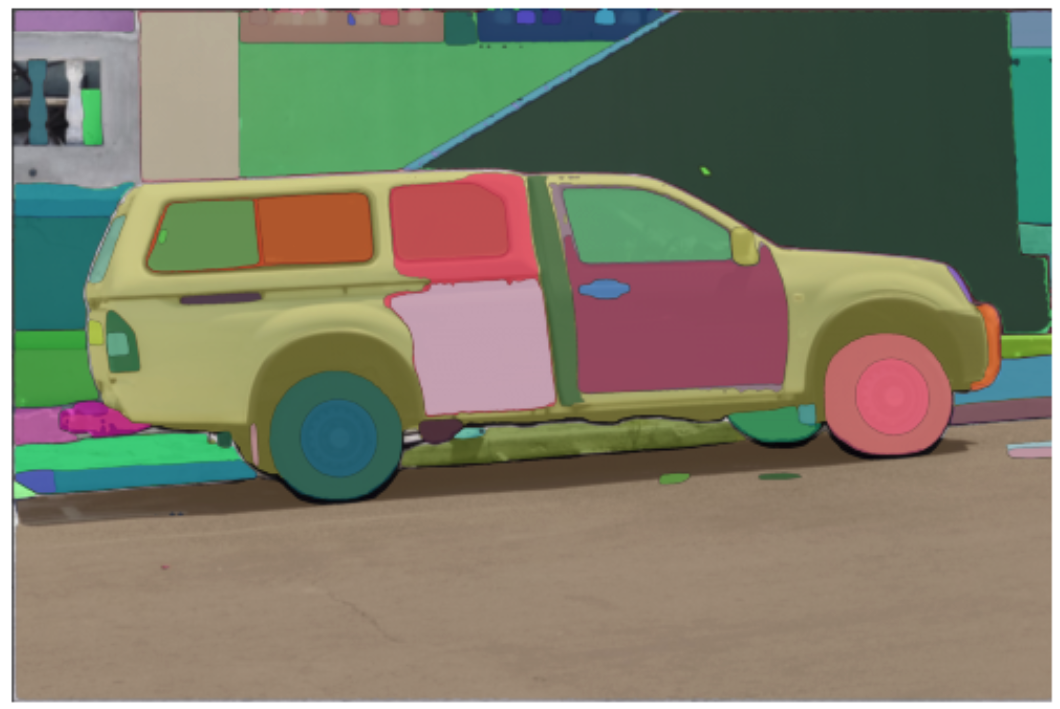
يُقدّم SAM-HQ عدة تحسينات رئيسية مقارنةً بنموذج SAM الأصلي:
- رمز مخرجات عالي الجودة: رمز قابل للتعلّم يُحقن في مُفكّك الأقنعة في SAM للحصول على تنبؤات أقنعة بجودة أعلى
- دمج الميزات المحلية والعالمية: يجمع بين الميزات من مراحل مختلفة من النموذج لتحسين تفاصيل الأقنعة
- بيانات التدريب: يستخدم مجموعة بيانات مُنتقاة بعناية تتكون من 44 ألف قناع عالي الجودة بدلاً من SA-1B
- الكفاءة: يضيف 0.5% فقط من المعاملات الإضافية مع تحسين كبير لجودة الأقنعة
- قدرة بدون تدريب مسبق: يحافظ على الأداء القوي لـ SAM في المهام بدون تدريب مسبق مع تحسين الدقة
المستخلص من الورقة البحثية هو كالتالي:
يمثّل نموذج Segment Anything Model (SAM) الحديث قفزة كبيرة في توسيع نطاق نماذج التقطيع، مما يتيح قدرات قوية بدون تدريب مسبق (zero-shot) وتوجيهًا مرنًا. وعلى الرغم من تدريب SAM باستخدام 1.1 مليار قناع، فإن جودة تنبؤاته بالأقنعة لا تزال غير كافية في كثير من الحالات، لا سيما عند التعامل مع كائنات ذات هياكل معقدة. نقترح HQ-SAM، الذي يجهّز SAM بالقدرة على تقطيع أي كائن بدقة، مع الحفاظ على التصميم الأصلي القابل للتوجيه في SAM وكفاءته وقابليته للتعميم بدون تدريب مسبق. يعيد تصميمنا الدقيق استخدام أوزان النموذج المُدرَّب مسبقًا في SAM والحفاظ عليها، مع إدخال معاملات وحسابات إضافية ضئيلة فقط. صممنا رمزًا قابلًا للتعلم للمخرجات عالية الجودة (High-Quality Output Token)، يُحقن في مُفكِّك الأقنعة (mask decoder) في SAM، وهو المسؤول عن التنبؤ بالقناع عالي الجودة. وبدلًا من تطبيقه على ميزات مُفكِّك الأقنعة فقط، ندمجها أولًا مع ميزات ViT المبكرة والنهائية لتحسين تفاصيل القناع. ولتدريب المعاملات القابلة للتعلم التي قدمناها، أنشأنا مجموعة بيانات تضم 44 ألف قناع دقيق من مصادر متعددة. يُدرَّب HQ-SAM فقط على مجموعة البيانات المقدمة المكوّنة من 44 ألف قناع، ويستغرق ذلك 4 ساعات فقط على 8 وحدات معالجة رسومية (GPU).
نصائح:
- ينتج SAM-HQ أقنعة بجودة أعلى من نموذج SAM الأصلي، لا سيما في حالة الكائنات ذات الهياكل المعقدة والتفاصيل الدقيقة
- يتنبأ النموذج بأقنعة ثنائية ذات حدود أكثر دقة ومعالجة أفضل للبنى الدقيقة
- كما هو الحال مع SAM، يؤدي النموذج أداءً أفضل عند استخدام نقاط ثنائية الأبعاد كمدخلات و/أو صناديق تحديد كمدخلات
- يمكنك إدخال عدة نقاط لنفس الصورة والتنبؤ بقناع واحد عالي الجودة
- يحافظ النموذج على قدرات SAM في التعميم بدون تدريب مسبق
- يضيف SAM-HQ حوالي 0.5% من المعاملات الإضافية مقارنةً بـ SAM
- لا يُدعَم ضبط النموذج الدقيق بعد
تمت مساهمة هذا النموذج من قِبل sushmanth. يمكن العثور على الكود الأصلي هنا.
فيما يلي مثال على كيفية تشغيل توليد الأقنعة بناءً على صورة ونقطة ثنائية الأبعاد:
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
يمكنك أيضًا معالجة أقنعتك الخاصة جنبًا إلى جنب مع الصور المدخلة في المعالج لتُمرَّر إلى النموذج:
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
الموارد
قائمة بموارد رسمية من Hugging Face وموارد من المجتمع (مشار إليها بـ 🌎) لمساعدتك على البدء مع SAM-HQ:
- دفتر ملاحظات تجريبي لاستخدام النموذج (قريباً)
- تنفيذ الورقة والكود: مستودع SAM-HQ على GitHub
SamHQConfig
فئة transformers.SamHQConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
المعاملات
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — كائن الإعدادات أو قاموس العمود الفقري البصري. - prompt_encoder_config (Union[
dict,SamHQPromptEncoderConfig], اختياري) — قائمة خيارات الإعدادات المستخدمة لتبويب SamHQPromptEncoderConfig. - mask_decoder_config (Union[
dict,SamHQMaskDecoderConfig], اختياري) — قائمة خيارات الإعدادات المستخدمة لتبويب SamHQMaskDecoderConfig. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamHQModel. تُستخدم لاستحداث نموذج Sam Hq وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ syscv-community/sam-hq-vit-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
SamHQVisionConfig
فئة transformers.SamHQVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - output_channels (
int، اختياري، القيمة الافتراضية 256) — أبعاد قنوات الإخراج في Patch Encoder. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية1024) — حجم (دقة) كل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية1e-10) — انحراف معياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم. - mlp_ratio (
float، اختياري، القيمة الافتراضية4.0) — نسبة بُعد مخفي MLP إلى بُعد التضمين. - use_abs_pos (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام تضمينات الموضع المطلق. - use_rel_pos (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام تضمين الموضع النسبي. - window_size (
int، اختياري، القيمة الافتراضية 14) — حجم النافذة للموضع النسبي. - global_attn_indexes (
list[int]، اختياري، القيمة الافتراضية[2, 5, 8, 11]) — فهارس طبقات الانتباه الشامل. - num_pos_feats (
int، اختياري، القيمة الافتراضية 128) — أبعاد تضمين الموقع. - mlp_dim (
int, اختياري) — أبعاد طبقة MLP في مُشفِّر Transformer. إذا كانتNone، فإن القيمة الافتراضية هيmlp_ratio * hidden_size.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamHQModel. تُستخدم لاستحداث نموذج Sam Hq وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ syscv-community/sam-hq-vit-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     SamHQVisionConfig,
...     SamHQVisionModel,
... )

>>> # Initializing a SamHQVisionConfig with `"facebook/sam_hq-vit-huge"` style configuration
>>> configuration = SamHQVisionConfig()

>>> # Initializing a SamHQVisionModel (with random weights) from the `"facebook/sam_hq-vit-huge"` style configuration
>>> model = SamHQVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamHQMaskDecoderConfig
فئة transformers.SamHQMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06vit_dim: int = 768 )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية256) — أبعاد التمثيلات المخفية. - hidden_act (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - mlp_dim (
int، اختياري، القيمة الافتراضية 2048) — أبعاد طبقة «الوسط» (أي طبقة التغذية الأمامية) في مُشفِّر Transformer. - num_hidden_layers (
int، اختياري، القيمة الافتراضية2) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - attention_downsample_rate (
int، اختياري، القيمة الافتراضية 2) — معدل تخفيض عينة طبقة الانتباه. - num_multimask_outputs (
int، اختياري، القيمة الافتراضية 3) — عدد المخرجات من وحدةSamMaskDecoder. في ورقة Segment Anything، يتم ضبط هذه القيمة على 3. - iou_head_depth (
int، اختياري، القيمة الافتراضية 3) — عدد الطبقات في وحدة رأس IoU. - iou_head_hidden_dim (
int, اختياري، القيمة الافتراضية 256) — أبعاد الحالات المخفية في وحدة رأس IoU. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - vit_dim (
int، اختياري، القيمة الافتراضية 768) — أبعاد Vision Transformer (ViT) المستخدمة في وحدةSamHQMaskDecoder.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamHQModel. تُستخدم لاستحداث نموذج Sam Hq وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ syscv-community/sam-hq-vit-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
SamHQPromptEncoderConfig
فئة transformers.SamHQPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية256) — أبعاد التمثيلات المخفية. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية1024) — حجم (دقة) كل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - mask_input_channels (
int، اختياري، القيمة الافتراضية 16) — عدد القنوات التي تُمرَّر إلى وحدةMaskDecoder. - num_point_embeddings (
int، اختياري، القيمة الافتراضية 4) — عدد تضمينات النقاط التي سيتم استخدامها. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-06) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
هذه فئة الإعدادات المخزنة لإعدادات نموذج SamHQModel. تُستخدم لاستحداث نموذج Sam Hq وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ syscv-community/sam-hq-vit-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
SamHQProcessor
فئة transformers.SamHQProcessor
< source >( image_processor )
ينشئ SamHQProcessor الذي يغلّف معالج الصور في معالج واحد.
يوفر SamHQProcessor جميع وظائف SamImageProcessor. راجع ~SamImageProcessor لمزيد من المعلومات.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam_hq.processing_sam_hq.SamHQProcessorKwargs'> ) → ~feature_extraction_utils.BatchFeature
المعاملات
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - segmentation_maps (
ImageInput، kwargs، اختياري) — خرائط التقطيع الصحيحة (Ground truth) التي تتم معالجتها بالتوازي مع الصور المدخلة. تُستخدم هذه الخرائط لأغراض التدريب أو التقييم، وتُعاد تحجيمها وتطبيعها لتتطابق مع أبعاد الصورة المعالجة. - input_points (
NestedList، kwargs، اختياري) — نقاط الإدخال للتجزئة القائمة على الأوامر النصية. يجب أن تكون قائمة متداخلة ذات بنية[image_level, object_level, point_level, [x, y]]حيث يُحدَّد كل نقطة بإحداثيات[x, y]في فضاء الصورة الأصلي. تُطبَّع النقاط إلى حجم الصورة المستهدفة قبل تمريرها إلى النموذج. - input_labels (
NestedList، kwargs، اختياري) — التسميات لنقاط الإدخال، تُظهر ما إذا كانت كل نقطة من نقاط المقدمة (1) أو الخلفية (0). يجب أن تكون قائمة متداخلة بهيكل[image_level, object_level, point_level]. يجب أن يكون لها نفس الهيكل مثلinput_points(باستبعاد بُعد الإحداثيات). - input_boxes (
NestedList، kwargs، اختياري) — صناديق الحدود للتجزئة القائمة على الأوامر. يجب أن تكون قائمة متداخلة ذات بنية[image_level, box_level, [x1, y1, x2, y2]]حيث يُحدد كل صندوق بإحداثيات[x1, y1, x2, y2]في مساحة الصورة الأصلية. يتم تطبيع الصناديق إلى حجم الصورة المستهدفة قبل تمريرها إلى النموذج. - point_pad_value (
int، kwargs، اختياري، القيمة الافتراضيةNone) — القيمة المستخدمة لحشو نقاط الإدخال عند تجميع تسلسلات ذات أطوال مختلفة. تُشير هذه القيمة إلى المواضع المحشوة وتُحافظ عليها أثناء تطبيع الإحداثيات للتمييز بين النقاط الحقيقية والحشو. إذا كانتNone، تُستخدم قيمة الحشو الافتراضية من إعدادات المعالج. - mask_size (
dict[str, *kwargs*, int]، اختياري) — قاموس يحدد حجم القناع المستهدف بالمفاتيح"height"و"width". يحدد هذا دقة أقنعة التقطيع الناتجة التي يولدها النموذج. - mask_pad_size (
dict[str, *kwargs*, int], اختياري) — قاموس يحدد حجم الحشو للقناع، بمفاتيح"height"و"width". يُستخدم هذا عند تجميع أقنعة بأحجام مختلفة لضمان أبعاد متسقة. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
يعيد
~feature_extraction_utils.BatchFeature
- data (
dict، اختياري) — قاموس من القوائم/المصفوفات/الموترات التي تُعاد بواسطة طريقتي call/pad (مثل ‘input_values’، ‘attention_mask’، وما إلى ذلك). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة. - skip_tensor_conversion (
list[str]أوset[str]، اختياري) — قائمة أو مجموعة من المفاتيح التي يجب ألا تُحوَّل إلى متجهات، حتى لو تم تحديدtensor_type.
SamHQVisionModel
فئة transformers.SamHQVisionModel
< source >( config: SamHQVisionConfig )
المعاملات
- config (SamHQVisionConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج الرؤية من SamHQ دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamHQVisionEncoderOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام SamImageProcessor. راجع SamImageProcessor.call() للتفاصيل (SamHQProcessor يستخدم SamImageProcessor لمعالجة الصور).
يعيد
SamHQVisionEncoderOutput أو tuple(torch.Tensor)
أُكْجَاز SamHQVisionEncoderOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (SamHQConfig) والمدخلات.
تتجاوز طريقة SamHQVisionModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
image_embeds (
torch.Tensorمن الشكل(batch_size, output_dim)اختياري يُعاد عند تهيئة النموذج معwith_projection=True) — تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على pooler_output.last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.hidden_states (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor, ...]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
intermediate_embeddings (
list(torch.Tensor)، اختياري) — قائمة بتضمينات وسيطة تم جمعها من بعض الكتل داخل النموذج، وعادةً ما تكون تلك التي لا تستخدم الانتباه النافذي (windowed attention). كل عنصر في القائمة له الشكل(batch_size, sequence_length, hidden_size). هذا الأمر خاص بـ SAM-HQ وغير موجود في SAM الأساسي.
SamHQModel
فئة transformers.SamHQModel
< source >( config: SamHQConfig )
المعاملات
- config (SamHQConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Segment Anything Model HQ (SAM-HQ) لتوليد الأقنعة، بناءً على صورة مدخلة ومواقع ثنائية الأبعاد اختيارية ومربعات محيطة.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Truehq_token_only: bool = Falseattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = Noneintermediate_embeddings: list[torch.Tensor] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> )
المعاملات
- pixel_values (
torch.Tensorof shape(batch_size, num_channels, image_size, image_size), اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام SamImageProcessor. راجع SamImageProcessor.call() للتفاصيل (SamHQProcessor يستخدم SamImageProcessor لمعالجة الصور). - input_points (
torch.Tensorمن الشكل(batch_size, num_points, 2)) — نقاط مكانية ثنائية الأبعاد مدخلة، تُستخدم بواسطة مُشفِّر الموجه (prompt encoder) لتشفير الموجه. عادةً ما يؤدي ذلك إلى نتائج أفضل بكثير. يمكن الحصول على النقاط عن طريق تمرير قائمة من قوائم القوائم إلى المُعالِج (processor) الذي سيُنشئtorchtensors المقابلة من البُعد الرابع. البُعد الأول هو حجم دفعة الصور (image batch size)، والبُعد الثاني هو حجم دفعة النقاط (point batch size) (أي عدد أقنعة التقطيع (segmentation masks) التي نريد من النموذج أن يتنبأ بها لكل نقطة مدخلة)، والبُعد الثالث هو عدد النقاط لكل قناع تقطيع (من الممكن تمرير عدة نقاط لقناع واحد)، وآخر بُعد هو إحداثيات x (العمودية) و y (الأفقية) للنقطة. إذا تم تمرير عدد مختلف من النقاط إما لكل صورة، أو لكل قناع، فسيقوم المُعالِج بإنشاء نقاط “PAD” ستُطابق إحداثي (0, 0)، وسيتم تخطي حساب التضمين (embedding) لهذه النقاط باستخدام التسميات (labels). - input_labels (
torch.LongTensorبشكل(batch_size, point_batch_size, num_points)) — التسميات المدخلة للنقاط، تُستخدم هذه التسميات من قِبل مُشفِّر المُوجِّه (prompt encoder) لتشفير المُوجِّه. وفقًا للتنفيذ الرسمي، توجد ثلاثة أنواع من التسميات1: النقطة هي نقطة تحتوي على الكائن محل الاهتمام0: النقطة هي نقطة لا تحتوي على الكائن محل الاهتمام-1: النقطة المقابلة للخلفية
أضفنا التسمية:
-10: النقطة هي نقطة حشو، وبالتالي يجب تجاهلها من قِبل مُشفِّر المُوجِّه
يجب أن يتم ملء التسميات تلقائيًا بواسطة المعالج.
- input_boxes (
torch.Tensorبشكل(batch_size, num_boxes, 4)) — صناديق الإدخال للنقاط، تُستخدم هذه الصناديق بواسطة مُشفِّر المُوجِّه (prompt encoder) لتشفير المُوجِّه. بشكل عام، يؤدي ذلك إلى أقنعة (masks) مولَّدة أفضل بكثير. يمكن الحصول على الصناديق عن طريق تمرير قائمة من قوائم القوائم إلى المُعالِج (processor)، والذي سيولّدtorchمُتغيِّرًا (tensor)، حيث يتوافق كل بُعد على التوالي مع حجم دفعة الصور (batch size)، وعدد الصناديق لكل صورة، وإحداثيات النقطة العلوية اليسرى والنقطة السفلية اليمنى للصندوق. بالترتيب (x1,y1,x2,y2):x1: إحداثي x للنقطة العلوية اليسرى من الصندوق المدخلy1: إحداثي y للنقطة العلوية اليسرى من مربع الإدخالx2: إحداثي x للنقطة السفلية اليمنى من مربع الإدخالy2: إحداثي y للنقطة السفلية اليمنى من مربع الإدخال
- input_masks (
torch.Tensorمن الشكل(batch_size, image_size, image_size)) — يقبل نموذج SAM_HQ أيضًا أقنعة التقسيم كمدخلات. سيتم تضمين القناع بواسطة مُشفِّر المُوجِّه لتوليد تضمين مقابل، يُغذَّى لاحقًا إلى مُفكِّك الأقنعة. يجب على المستخدم إدخال هذه الأقنعة يدويًا، ويجب أن يكون شكلها (batch_size،image_size،image_size). - image_embeddings (
torch.Tensorمن الشكل(batch_size, output_channels, window_size, window_size)) — تضمينات الصور، تُستخدم من قِبَل فكّ الترميز للقناع لتوليد الأقنعة ودرجات iou. لحساب أكثر كفاءةً في استخدام الذاكرة، يمكن للمستخدمين أولاً استرجاع تضمينات الصور باستخدام طريقةget_image_embeddings، ثم تمريرها إلى طريقةforwardبدلاً من تمريرpixel_values. - multimask_output (
bool، اختياري) — في التنفيذ الأصلي والورقة البحثية، يُخرج النموذج دائمًا 3 أقنعة لكل صورة (أو لكل نقطة / لكل مربع محدد إذا كان ذلك ذا صلة). ومع ذلك، يمكن إخراج قناع واحد فقط، يقابل القناع «الأفضل»، عن طريق تحديدmultimask_output=False. - hq_token_only (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام مسار رمز HQ فقط لتوليد الأقنعة. عند تعيينه إلى False، يتم دمج المسارين القياسي وHQ معًا. هذا الأمر خاص ببنية SAM-HQ. - attention_similarity (
torch.Tensor، اختياري) — مصفوفة تشابه الانتباه، التي يجب تقديمها إلى فاحص الأقنعة (mask decoder) للانتباه الموجَّه بالهدف في حال استخدام النموذج للتخصيص كما تم تقديمه في PerSAM. - target_embedding (
torch.Tensor، اختياري) — تضمين المفهوم المستهدف، ليُقدَّم إلى فكّ الترميز القناعي (mask decoder) للتلميح الدلالي المستهدف في حال استخدام النموذج للتخصيص كما أُدخل في PerSAM. - intermediate_embeddings (
List[torch.Tensor]، اختياري) — تمثيلات وسيطة من الكتل غير النافذية في مُشفِّر الرؤية، تُستخدم في SAM-HQ لتحسين جودة الأقنعة. مطلوب عند تقديم image_embeddings محسوبة مسبقًا بدلاً من pixel_values.
تتجاوز طريقة SamHQModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
مثال:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("sushmanth/sam_hq_vit_b")
>>> processor = AutoProcessor.from_pretrained("sushmanth/sam_hq_vit_b")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=image, input_points=input_points, return_tensors="pt")

>>> # Get high-quality segmentation mask
>>> outputs = model(**inputs)

>>> # For high-quality mask only
>>> outputs = model(**inputs, hq_token_only=True)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )