
Transformers documentation
Depth Anything V2
نُشر هذا النموذج في أوراق HF في 13 يونيو 2024، وأُضيف إلى مكتبة Hugging Face Transformers في 5 يوليو 2024.
Depth Anything V2
نظرة عامة
تم تقديم Depth Anything V2 في الورقة البحثية التي تحمل الاسم نفسه بواسطة ليه يانغ وآخرون. يستخدم نفس البنية المعمارية مثل نموذج Depth Anything الأصلي، لكنه يستخدم بيانات اصطناعية ونموذج معلم أكبر سعة لتحقيق تنبؤات أعمق أدق وأكثر متانة بكثير.
المستخلص من الورقة البحثية هو كالتالي:
تقدّم هذه الدراسة Depth Anything V2. وبدلًا من السعي وراء تقنيات معقّدة، نهدف إلى الكشف عن نتائج جوهرية تمهّد الطريق لبناء نموذج قوي لتقدير العمق أحادي العين. ومن الجدير بالذكر أنه، مقارنةً بالإصدار الأول، ينتج هذا الإصدار تنبؤات عمق أدق وأكثر متانة من خلال ثلاث ممارسات رئيسية: 1) استبدال جميع الصور الحقيقية الموسومة بصور اصطناعية، 2) توسيع سعة نموذج المعلم لدينا، و3) تعليم نماذج الطالب عبر جسر من الصور الحقيقية الموسومة بشكل زائف على نطاق واسع. مقارنةً بأحدث النماذج المبنية على Stable Diffusion، تكون نماذجنا أكثر كفاءة بشكل كبير (أسرع بأكثر من 10 أضعاف) وأكثر دقة. نقدّم نماذج بمقاييس مختلفة (تتراوح من 25 مليون إلى 1.3 مليار معامل) لدعم سيناريوهات واسعة النطاق. ومن خلال الاستفادة من قدرتها القوية على التعميم، نضبطها بدقة باستخدام تسميات عمق مقننة للحصول على نماذج العمق المقنن لدينا. بالإضافة إلى نماذجنا، ونظرًا إلى محدودية التنوع والوجود المتكرر للضوضاء في مجموعات الاختبار الحالية، نبني معيار تقييم متعدد الاستخدامات مع تسميات دقيقة ومشاهد متنوعة لتسهيل الأبحاث المستقبلية.
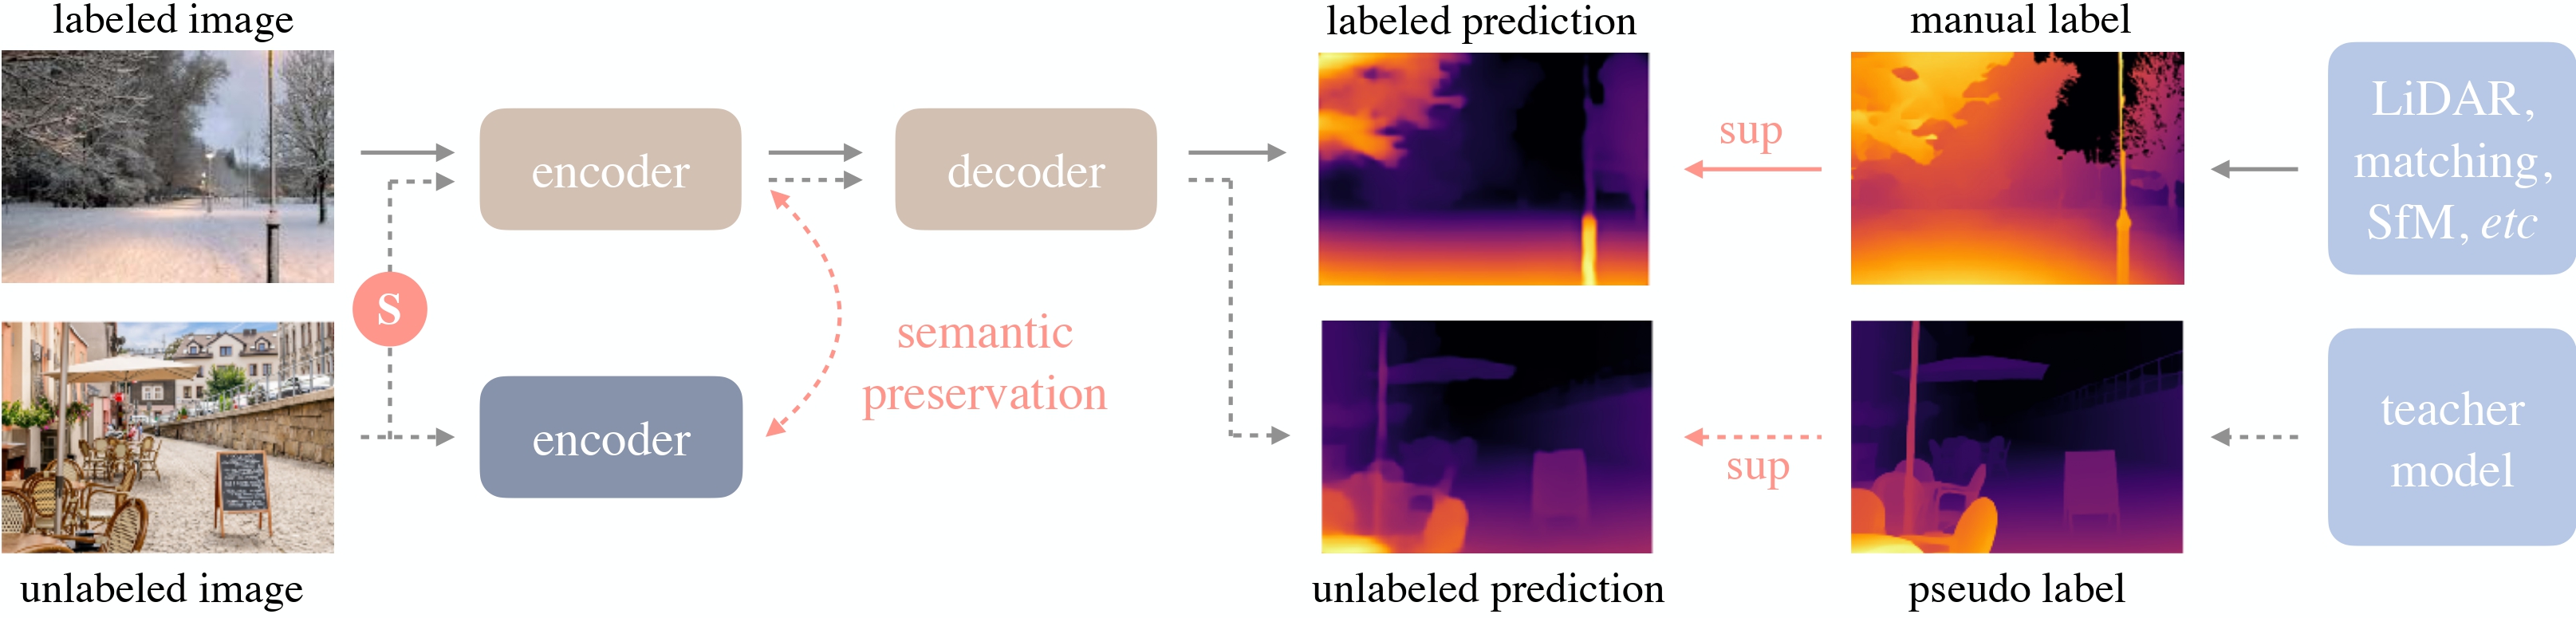 Depth Anything overview. Taken from the original paper.
تمت مساهمة نماذج Depth Anything من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
مثال على الاستخدام
توجد طريقتان رئيسيتان لاستخدام Depth Anything V2: إما باستخدام واجهة برمجة التطبيقات الخاصة بالخطوط الأنابيب (pipeline API)، والتي تختصر عليك كل التعقيدات، أو من خلال استخدام فئة DepthAnythingForDepthEstimation بنفسك.
واجهة برمجة التطبيقات الخاصة بخط المعالجة
يتيح خط المعالجة استخدام النموذج في بضع أسطر من الكود:
import requests
from PIL import Image

from transformers import pipeline


# load pipe
pipe = pipeline(task="depth-estimation", model="depth-anything/Depth-Anything-V2-Small-hf")

# load image
url = 'http://images.cocodataset.org/val2017/000000039769.jpg'
image = Image.open(requests.get(url, stream=True).raw)

# inference
depth = pipe(image)["depth"]
استخدام النموذج بنفسك
إذا كنت ترغب في تنفيذ المعالجة المسبقة والمعالجة اللاحقة بنفسك، فإليك الطريقة:
import requests
import torch
from PIL import Image

from transformers import AutoImageProcessor, AutoModelForDepthEstimation


url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)

image_processor = AutoImageProcessor.from_pretrained("depth-anything/Depth-Anything-V2-Small-hf")
model = AutoModelForDepthEstimation.from_pretrained("depth-anything/Depth-Anything-V2-Small-hf", device_map="auto")

# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

# interpolate to original size and visualize the prediction
post_processed_output = image_processor.post_process_depth_estimation(
    outputs,
    target_sizes=[(image.height, image.width)],
)

predicted_depth = post_processed_output[0]["predicted_depth"]
depth = (predicted_depth - predicted_depth.min()) / (predicted_depth.max() - predicted_depth.min())
depth = depth.detach().cpu().numpy() * 255
depth = Image.fromarray(depth.astype("uint8"))
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء مع Depth Anything.
- دليل مهمة تقدير العمق أحادي العين
- عرض عمق أي شيء V2.
- يمكن العثور على دفتر ملاحظات يعرض الاستدلال باستخدام DepthAnythingForDepthEstimation هنا. 🌎
- تحويل
smallإلى Core ML للاستخدام على Apple Silicon.
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
DepthAnythingConfig
فئة transformers.DepthAnythingConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonepatch_size: int | list[int] | tuple[int, int] = 14initializer_range: float = 0.02reassemble_hidden_size: int = 384reassemble_factors: list[int | float] | tuple[int | float, ...] = (4, 2, 1, 0.5)neck_hidden_sizes: list[int] | tuple[int, ...] = (48, 96, 192, 384)fusion_hidden_size: int = 64head_in_index: int = -1head_hidden_size: int = 32depth_estimation_type: str = 'relative'max_depth: int | None = 1 )
المعاملات
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية14) — حجم (دقة) كل رقعة. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - reassemble_hidden_size (
int، اختياري، القيمة الافتراضية 384) — عدد قنوات الإدخال لطبقات إعادة التجميع. - reassemble_factors (
list[int]، اختياري، القيمة الافتراضية[4, 2, 1, 0.5]) — معاملات التوسيع/التصغير لطبقات إعادة التجميع. - neck_hidden_sizes (
list[str]، اختياري، القيمة الافتراضية[48, 96, 192, 384]) — حجم الطبقات المخفية التي تُستخدَم لإسقاط خرائط الميزات الخاصة بالهيكل العظمي. - fusion_hidden_size (
int, اختياري، القيمة الافتراضية 64) — عدد القنوات قبل الدمج. - head_in_index (
int، اختياري، القيمة الافتراضية -1) — مؤشر الميزات المستخدمة في رأس تقدير العمق. - head_hidden_size (
int، اختياري، القيمة الافتراضية 32) — عدد قنوات الإخراج في الالتفافة الثانية لرأس تقدير العمق. - depth_estimation_type (
str، اختياري، القيمة الافتراضية"relative") — نوع تقدير العمق المستخدم. يمكن أن يكون أحد القيم["relative", "metric"]. - max_depth (
float, اختياري) — العمق الأقصى الذي يجب استخدامه لرأس تقدير العمق "metric". يُنصح باستخدام القيمة 20 للنماذج الداخلية و80 للنماذج الخارجية. أما في حالة تقدير العمق "relative"، فتُتجاهل هذه القيمة.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Depth AnythingModel. تُستخدم لاستحداث نموذج Depth Anything وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ LiheYoung/depth-anything-small-hf
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import DepthAnythingConfig, DepthAnythingForDepthEstimation

>>> # Initializing a DepthAnything small style configuration
>>> configuration = DepthAnythingConfig()

>>> # Initializing a model from the DepthAnything small style configuration
>>> model = DepthAnythingForDepthEstimation(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
DepthAnythingForDepthEstimation
فئة transformers.DepthAnythingForDepthEstimation
< source >( config: DepthAnythingConfig )
المعاملات
- config (DepthAnythingConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Depth Anything مع رأس لتقدير العمق في الأعلى (يتكون من 3 طبقات تلافيفية) على سبيل المثال لـ KITTI وNYUv2.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorlabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → DepthEstimatorOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام DPTImageProcessor. راجع DPTImageProcessor.call() للتفاصيل (يستخدمprocessor_classDPTImageProcessor لمعالجة الصور). - labels (
torch.LongTensorمن الشكل(batch_size, height, width)، اختياري) — خرائط تقدير العمق الصحيحة (Ground truth) لحساب الخسارة. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
DepthEstimatorOutput أو tuple(torch.Tensor)
DepthEstimatorOutput أو مجموعة (tuple) من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (DepthAnythingConfig) والمدخلات.
تتجاوز طريقة DepthAnythingForDepthEstimation الخاصة بالتقدم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).predicted_depth (
torch.Tensorمن الشكل(batch_size, height, width)) — العمق المتوقع لكل بكسل.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, num_channels, height, width).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, AutoModelForDepthEstimation
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("LiheYoung/depth-anything-small-hf")
>>> model = AutoModelForDepthEstimation.from_pretrained("LiheYoung/depth-anything-small-hf")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> # interpolate to original size
>>> post_processed_output = image_processor.post_process_depth_estimation(
...     outputs,
...     target_sizes=[(image.height, image.width)],
... )

>>> # visualize the prediction
>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = predicted_depth * 255 / predicted_depth.max()
>>> depth = depth.detach().cpu().numpy()
>>> depth = Image.fromarray(depth.astype("uint8"))